对希望理解 AI 能力边界的初学者,世界模型回答的是「系统是否知道动作会带来什么后果」,而不是「系统是否会写流畅答案」。后文覆盖定义、闭环机制、三条技术路线、世界模型 vs 大语言模型的任务选型边界、以及视频生成差异、场景与评估边界;相邻概念可对照 超级智能(ASI) 与 Private AI。
核心要点
- 世界模型的核心能力是动作条件预测:给定状态与动作,输出下一状态(或下一表征),用于规划与控制。
- 三条常见路线:模型基强化学习(MBRL)/ 想象训练、生成式可交互模拟、JEPA 类预测表征。
- 大语言模型擅长下一词预测,视频生成擅长外观连贯;二者都不自动等于可规划的世界模型。
- 评估须盯虚假物理、长时程漂移、分布外失效、评测难,以及与手写仿真器的边界。
世界模型是什么?它要解决什么问题?
世界模型要解决的问题是:智能体在采取动作之前,能否可靠预估「接下来会发生什么」。没有这一能力,系统只能靠真实试错学习,成本高、风险大,也难以离线规划。
在机器人、自动驾驶、游戏智能体与仿真训练中——尤其是虚拟或物理环境中的具身智能体——环境反馈往往昂贵或危险;例如糟糕的驾驶策略可能在学会正确行为前就造成真实事故。世界模型把「试动作」搬进内部动态:先在潜空间或观测空间滚动预测,再把更好的策略带回真实环境。这一目标与只复述知识的对话系统不同,更接近可交互环境中的因果预感。
NVIDIA Glossary: World Models 将其概括为帮助 AI 理解并预测物理世界如何演化的内部表示;Yann LeCun 在 A Path Towards Autonomous Machine Intelligence 中把可预测世界的内部模型放在通向更自主智能的关键路径上;David Ha 2018 年的 World Models 工作则帮助奠定了现代「数据学习动态」的路径。智能体通常只能获得部分观测,完整状态并不直接可见。上述视角都强调:预测是为了支撑决策。
世界模型如何运作?状态、动作与预测闭环
判定一条系统是不是「世界模型取向」,最稳的轴是动作条件预测(action-conditioned prediction):输入是否显式包含动作(或控制信号),输出是否是条件于该动作的下一状态 / 下一表征。
闭环通常压成三步:编码观测得到状态;给定候选动作;预测下一状态——动作执行后环境变化并返回新观测——并可把预测状态当作新起点继续滚动。策略或规划器在多条想象轨迹中比较回报、风险或约束后执行动作;真实执行后,新观测进入下一轮编码。
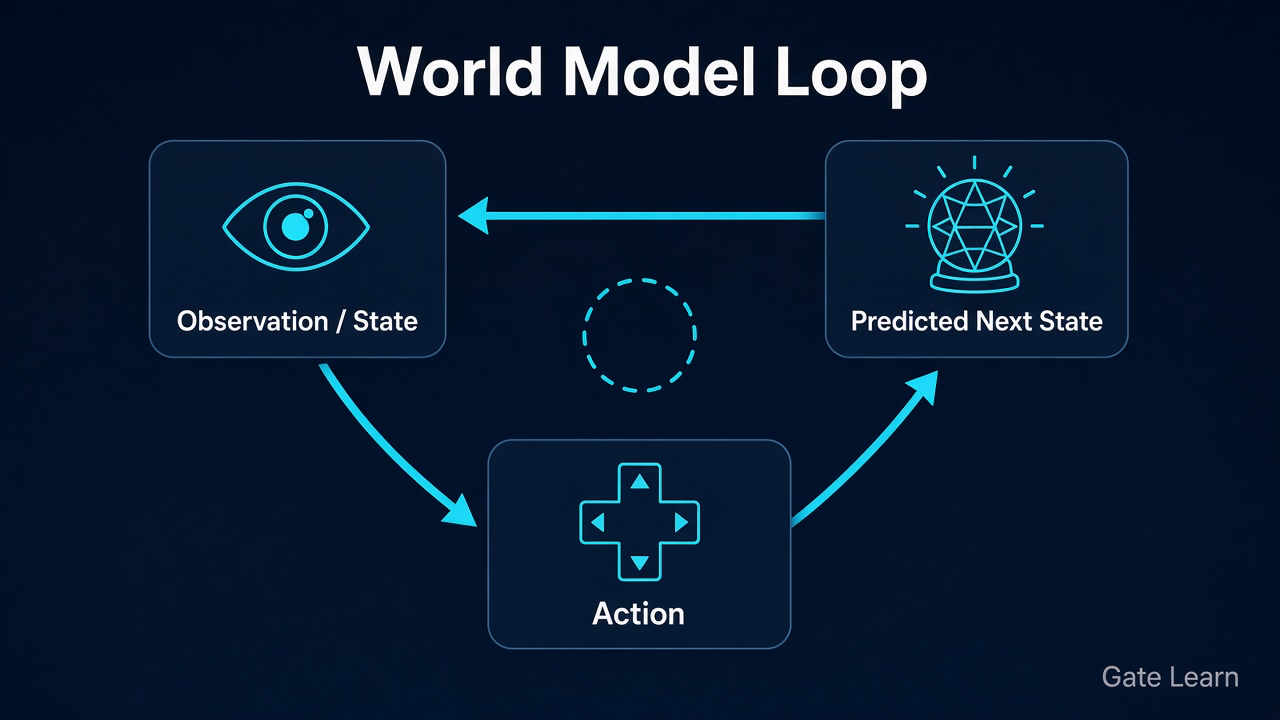
图 1. 世界模型闭环:观测/状态经动作条件预测得到下一状态,并反馈进入下一轮。
许多实用系统并不在原始像素上做长时程预测,而是学习潜动态(latent dynamics):先把高维视觉数据压成紧凑状态,再在潜空间里滚动。这可降低噪声干扰、让想象训练更可行;潜空间是否忠于真实物理,仍须用下游任务与分布外测试验证,尤其因为物理环境往往只被部分观测,须通过反馈推断。
世界模型有哪些主要技术路线?
世界模型不是单一算法名,而是一组共享「可预测后果」目标的技术族。选型时先问任务要的是可控策略、可交互像素模拟,还是可迁移的抽象表征。
| 技术路线 | 代表思路 | 更适合什么任务 | 主要代价 |
|---|---|---|---|
| MBRL / 想象训练 | 学动态后在模型内滚动轨迹练策略(Dreamer) | 控制、游戏、样本效率敏感 RL | 模型误差污染策略;易漂移 |
| 生成式可交互模拟 | 学可生成下一帧/观测的交互环境 | 数据扩增、交互视频世界 | 外观 ≠ 物理正确;评测贵 |
| JEPA 预测表征 | 在嵌入空间预测未来/掩码表征(I-JEPA) | 表征学习、规划前置抽象预测 | 不输出像素;需衔接控制 |
一条路线可能以预测未来帧的视频模型为中心,另一条则瞄准可规划的潜动态,而不追求完整视觉重建。
三条路线可并存:Dreamer 类强调「在想象中练策略」;生成式视频世界模型强调「可交互外观模拟」;Meta AI 的 I-JEPA 示范了在联合嵌入空间做预测、而非重建全部像素。不同系统也会按输入—输出对、控制滚动或预测嵌入,选择不同训练配方。选型地图先对齐任务目标,再谈模型名字。
世界模型和大语言模型、视频生成有何不同?
三者都「会预测」,但在生成式 AI 里预测对象与是否动作条件化不同:大语言模型预测下一词元,视频生成预测下一帧外观,世界模型取向系统则预测动作之后的状态演化。
| 维度 | 世界模型 | 大语言模型(LLM) | 视频生成 |
|---|---|---|---|
| 核心预测对象 | 下一状态 / 潜动态(常条件于动作) | 下一词元 / 文本结构 | 下一帧或片段外观 |
| 与动作的关系 | 动作条件预测是判定轴 | 通常不建模物理控制闭环 | 可条件于文本/首帧,未必可执行 |
| 典型用途 | 规划、控制、具身智能 | 语言、写作、工具编排 | 内容生成、预览、交互模拟 |
| 常见误解 | 能聊天=有世界模型 | 会写物理=会物理 | 画面逼真=动力学正确 |
因此,Sora 一类视频生成可呈现高视觉保真甚至表面空间一致的连贯画面,并可能被称作「视频世界模型」,但这些特质本身并不能证明物理理解。若缺少稳定的动作接口、可验证状态转移与规划闭环,更准确的定位仍是生成式视频。更强的系统还应能评估动作序列以支持规划与决策,而不是只被动渲染看似合理的画面。LLM 可以描述「推一下杯子会怎样」,却不自动具备可滚动、可评估的环境动态。
世界模型常用在哪些场景?
具身智能(embodied AI)是高频场景:机械臂与移动机器人需要空间智能——对布局、运动与物理变化的推理——并在接触物体前预估接触与位移,因为许多交互一旦发生就难以逆转。动作条件预测让系统先在仿真或潜空间筛掉失败轨迹,再减少真实碰撞代价;演示数据可初始化行为,但不能替代基于交互的学习。
游戏与模型基强化学习是另一主战场。Dreamer 类方法用学到的世界模型在想象轨迹上改进策略,目标是用更少真实交互达到可用控制。同类思路也可迁移到手写仿真器不足、但有大量观测日志的工业控制任务,因为模型正试图从历史中捕捉系统动态。
自动驾驶、仓储调度与多代理仿真也会嵌入世界模型组件:不是替代整套规划栈,而是提供短时程后果预感。虚拟测试与整理后的视频数据,常被用来在真实部署前跨场景训练与评估这些组件。凡需要「先想后做」的控制系统,都可能嵌入某种世界模型模块。
理解或评估世界模型有哪些优势、风险与局限?
优势在于样本效率与安全试错:能在模型内想象,就可能减少危险探索;能条件于动作预测,就可能把规划建立在可检查的动态上。局限与风险往往来自「看起来对、实际不可信」——漂亮的内部表示,不等于部署后仍可靠的行为。
| 机制 | 表现 | 为何难发现 | 检查问题 |
|---|---|---|---|
| 虚假物理 | 轨迹好看但违反守恒/接触 | 视觉易被流畅性说服 | 关键量守恒吗?能否穿透? |
| 长时程漂移 | 短步尚可,多步后失真 | Demo 常只展示短片段 | 误差如何随步数累积?有重规划吗? |
| 分布外失效 | 新物体、光照、动作幅度下崩溃 | 同分布测试分数虚高 | 有 OOD 协议吗?失败模式公开吗? |
| 评测困难 | 缺少统一「世界理解」分数 | 指标被任务成功率绑架 | 除任务分外有预测误差指标吗? |
| 与手写仿真器边界 | 学到的模型被当成已验证引擎 | 营销混用 simulator / world model | 哪些约束硬编码?哪些只是拟合? |
迁移到现实很难,因为存在仿真到现实(sim-to-real)差距。好的测试应追问:模型能否在动作条件下预测可控结果,而不只是看起来合理的画面。
可读上表作核对清单:先确认动作条件接口,再看长时程与 OOD 证据,最后分清「生成好看」与「动态可规划」。证据不足时,更稳妥的说法是「具备世界模型组件或研究目标」,而非「已具备完备世界模型」。智能体能力有限时,评估应聚焦目标相关状态,而不是复现整幅场景。
总结
世界模型把 AI 能力从「会说 / 会画」推进到「能预估动作后果」,例如预测机器人走错路径会不会撞倒杯子。工作内核是状态、动作与预测的闭环,并以动作条件预测作为最清晰的判定轴。
三条技术路线——MBRL/想象训练、生成式可交互模拟、JEPA 预测表征——服务不同目标,不可互相替代。与大语言模型、视频生成对比时应看预测对象与动作接口;评估时优先识别虚假物理、漂移、分布外、评测与仿真器边界。
FAQ
什么是世界模型?
世界模型是学习到的内部动态模型:根据当前状态(或观测)与动作,预测环境下一步如何变化。世界在任一时刻都比智能体直接看到的更丰富,因此模型会概括对规划有用的变量——例如机器人左转后会停在何处。目标是支持在想象中规划与试错,而非只生成文本或视频外观。
世界模型和大语言模型有什么区别?
大语言模型主要预测下一词元,擅长语言与知识编排;世界模型主要预测动作之后的状态演化,服务于控制与规划。LLM 可以谈论物理,但不自动具备可滚动、可评估的环境动态。
世界模型如何工作?
典型闭环是:编码观测得到状态 → 输入候选动作 → 预测该动作后的下一状态,并可在潜空间多步滚动。规划器比较想象轨迹后选择动作,真实执行后再用新观测更新状态。
Sora/视频生成算世界模型吗?
不一定。若系统主要生成外观连贯的视频,却缺少稳定的动作条件接口、可验证状态转移与规划用途,更准确的定位是视频生成模型。动作条件预测与可规划闭环被证实后,才更接近世界模型。
世界模型和传统仿真器有什么区别?
传统仿真器通常由工程师手写物理规则与约束;数据驱动的世界模型往往用神经网络从数据学习。学到的模型可能更灵活、更贴合传感器噪声,但也更易出现虚假物理与长时程漂移,不能默认等同已验证物理引擎。
* 投资有风险,入市须谨慎。本文不作为 Gate 提供的投资理财建议或其他任何类型的建议。
* 在未提及 Gate 的情况下,复制、传播或抄袭本文将违反《版权法》,Gate 有权追究其法律责任。


相关文章
GateClaw 与 AI Skills:Web3 AI Agent 的能力体系解析
GateClaw 的核心功能:Web3 AI Agent 工作站能力解析
一文盘点 Top 10 AI Agents
什么是 TAO?Bittensor 代币经济学、供应模型与激励机制详解
解读 Vana 的野心:实现数据货币化,构建由用户主导的 AI 开发生态