与面向广泛并行计算任务的 GPU 不同,Groq LPU 采用强调片上 SRAM、编译器静态调度和确定性执行的架构,试图减少推理过程中的数据传输和运行时调度开销,为实时 AI 应用提供更具针对性的计算能力。
随着大语言模型逐渐应用于智能客服、语音交互、AI Agent 和企业自动化服务,推理计算的需求正在从单纯追求处理速度,扩展至响应延迟、服务稳定性和单位计算成本等多个维度。Groq LPU 所代表的专用加速器路线,为 AI 基础设施提供了不同于传统通用计算架构的技术选择。本文将深入介绍 Groq LPU 的工作机制,分析 SRAM、确定性执行和编译器如何影响推理性能,并讨论其适用场景与技术限制。
核心要点
-
Groq LPU 是面向 AI 推理工作负载设计的专用处理器,强调低延迟、可预测执行和高效数据传输。
-
大语言模型推理通常包括 Prefill 和 Decode 两个阶段,不同阶段对计算能力与内存带宽的要求有所区别。
-
Groq LPU 使用片上 SRAM 缩短部分数据访问路径,但较小的片上存储容量也带来了模型部署和多芯片扩展要求。
-
确定性执行和编译器静态调度能够减少部分运行时调度开销,但并不意味着所有请求的响应时间完全相同。
-
LPU 在实时文本生成、语音交互等低延迟应用中具有潜在优势,其实际表现仍取决于模型、负载、系统配置和服务定价。
Groq LPU 是什么?与传统 AI 加速器有何不同?
Groq LPU 是 Groq 设计的专用 AI 推理处理器。LPU 的全称为 Language Processing Unit,其设计目标是针对语言模型推理中的数据移动、计算执行和延迟控制进行优化,而不是提供覆盖所有计算任务的通用处理能力。
理解 LPU 的技术定位,需要先认识 AI 加速器的不同设计思路。GPU 最初主要用于图形处理,随后凭借大规模并行计算能力和成熟的软件生态,广泛应用于深度学习训练与推理。TPU 等专用加速器则通过针对机器学习运算进行优化,提高特定计算任务的执行效率。
Groq LPU 进一步强调编译器与硬件之间的协同关系。其架构希望在模型执行前规划计算和数据传输过程,使芯片能够按照预定安排完成任务,从而减少部分动态调度产生的开销。
这种设计思路与 Groq 早期提出的 Tensor Streaming Processor(TSP)技术路线密切相关。处理器通过组织计算资源、片上存储和数据传输路径,使模型运算能够按照编译器安排的顺序执行。
需要注意的是,LPU 并不是所有语言模型处理器的统一行业分类,而是 Groq 使用的技术名称。不同厂商可能采用不同的芯片设计方式,也可能通过 GPU、ASIC 或其他专用加速器实现低延迟推理。
因此,判断 Groq LPU 的技术价值,不能仅凭处理器名称,而需要分析它如何处理推理任务中的数据访问、计算调度和多芯片通信问题。
为什么大语言模型推理需要低延迟计算?
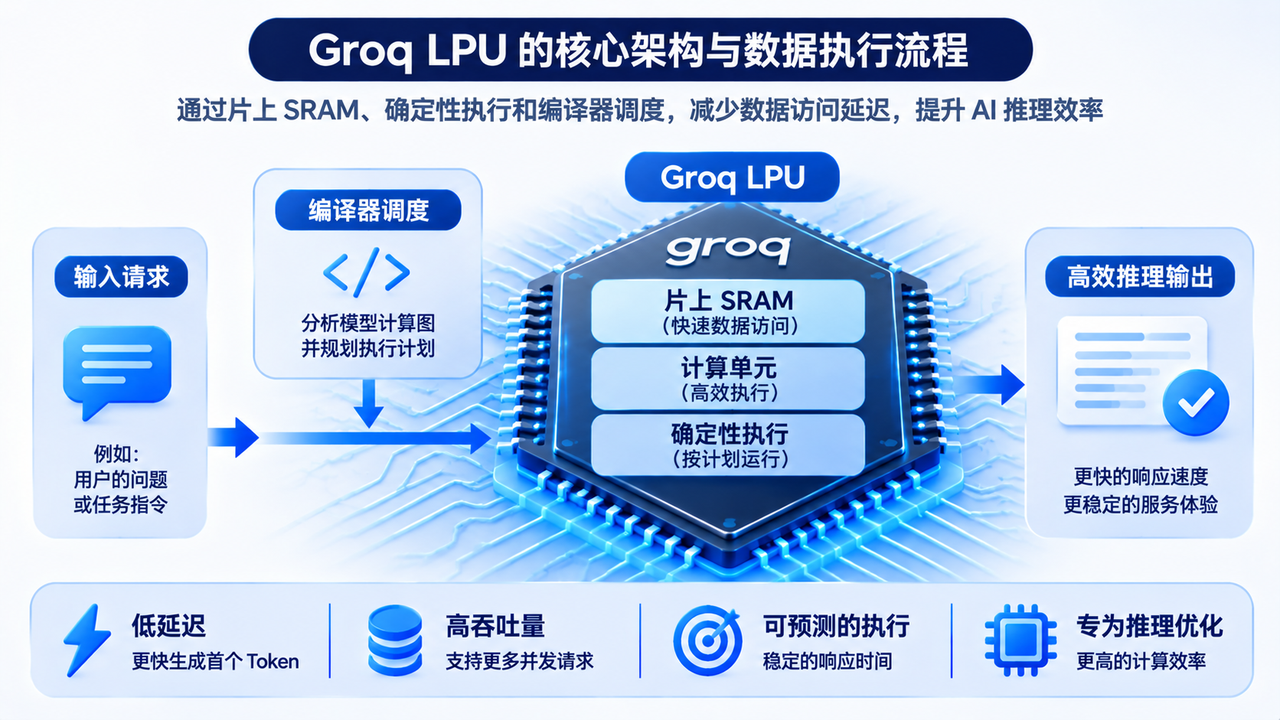
大语言模型推理是指模型接收输入后,利用已经训练完成的参数生成输出的过程。对于常见的自回归语言模型,推理通常包括 Prefill 和 Decode 两个阶段。Prefill 阶段主要负责处理用户输入的提示词,并建立后续生成所需的计算状态。由于这一阶段能够同时处理多个输入 Token,通常具有较强的并行计算特征。
Decode 阶段则负责逐步生成输出 Token。模型通常需要根据已有输入和已经生成的内容预测下一个 Token,因此多个生成步骤之间存在依赖关系,难以像某些训练计算那样完全并行执行。
这一区别使推理性能不能只用一个指标衡量。
首 Token 延迟(Time to First Token,TTFT) 衡量从请求开始到生成首个输出 Token 所需的时间,主要影响用户等待响应的感受。
Token 生成速度 衡量模型开始输出后,单位时间内能够生成多少 Token,直接影响文本持续生成的流畅程度。吞吐量(Throughput) 则关注系统在一定时间内能够处理多少请求或 Token,反映推理服务在较高并发负载下的整体处理能力。
例如,两个推理平台都能够运行同一个语言模型,但平台 A 可能在单个用户请求下具有更快的 Token 生成速度,平台 B 则可能在同时处理数百个请求时具有更高的总体吞吐量。
这意味着,低延迟与高吞吐量并不是完全相同的性能目标。针对单用户实时交互优化的系统,不一定在所有批处理或高并发场景中都具有相同优势。
对于语音助手、实时翻译和交互式 AI 应用,首 Token 延迟和连续生成速度尤为重要。用户通常希望系统能够迅速开始回应,并持续输出自然流畅的内容。
对于离线文档分析、批量数据处理等任务,单个请求的即时响应可能没有那么重要,企业反而更关注总体吞吐量和单位处理成本。
Groq LPU 的设计重点之一,就是针对对响应时间敏感的推理工作负载优化执行效率。
Groq LPU 如何利用 SRAM 提高数据访问效率?
现代 AI 处理器的性能不仅取决于计算单元能够执行多少运算,还取决于数据能否及时到达计算单元。
在大语言模型推理过程中,处理器需要反复读取模型权重、访问中间计算结果,并维护与上下文相关的数据。如果数据读取速度不足,即使芯片拥有较高的理论计算能力,也可能因为等待数据而无法充分发挥性能。
这一问题通常被称为内存瓶颈。
Groq LPU 的重要架构特点之一,是强调使用片上 SRAM(Static Random-Access Memory,静态随机存取存储器)进行数据存储和访问。
SRAM 通常具有较低的访问延迟,能够直接集成在处理器芯片内部。与需要通过外部内存接口访问的数据相比,片上存储有机会缩短数据传输路径,并减少部分访问开销。
为了理解这一设计,可以比较 SRAM 与高带宽内存(HBM)的基本特点。
| 对比维度 | SRAM | HBM |
|---|---|---|
| 常见位置 | 处理器芯片内部 | 处理器封装内的独立内存堆栈 |
| 主要优势 | 低访问延迟、便于紧密集成 | 较大容量、高聚合带宽 |
| 主要限制 | 面积成本高、容量有限 | 数据访问仍需经过内存接口 |
| 典型用途 | 缓存、片上工作存储 | 模型权重、激活值等大规模数据 |
| 对推理的意义 | 优化部分数据访问路径 | 支持更大模型和计算状态 |
但不能简单认为 SRAM 在所有情况下都比 HBM 更快,或者使用 SRAM 就能消除内存瓶颈。实际性能还取决于数据布局、并行访问方式、内存带宽和模型结构。
SRAM 的主要限制在于存储密度和芯片面积成本。对于参数规模较大的语言模型,单颗处理器上的 SRAM 通常不足以容纳全部模型权重及运行状态。
因此,Groq 需要通过多芯片协同和系统级数据分配,使模型能够在更大的计算系统上运行。这意味着 LPU 的优势并不完全来自单颗芯片的 SRAM,而是来自片上存储、计算流水线、芯片互联和编译器之间的整体设计。
确定性执行与编译器调度如何影响推理性能?
确定性执行(Deterministic Execution)是理解 Groq LPU 架构的另一个关键概念。其核心思想是尽可能在程序运行之前确定计算操作的执行顺序、数据传输路径和资源分配方式,减少运行过程中临时作出调度决策的需求。
在传统的通用计算架构中,处理器需要适应不同类型的程序和工作负载。为了提高资源利用率,系统通常包含动态任务调度、缓存管理和其他运行时机制。这些设计能够提供较强的灵活性,但也可能引入额外的调度开销。
Groq LPU 采用不同的设计思路。编译器在模型执行之前分析计算图,并为计算操作和数据移动安排相应的执行计划。处理器随后按照这一计划运行,使数据能够在不同计算单元之间有序传递。例如,一个语言模型需要连续执行矩阵运算、激活函数和其他计算操作。编译器可以提前安排这些任务在不同计算资源上的执行时机,并协调所需的数据传输。
这种方式类似于提前规划生产线上的每一道工序,使不同环节能够按照预定节奏协同运行。
对于 AI 推理而言,确定性执行主要具有两方面意义。
-
它能够降低部分运行时调度开销。处理器不必在每个计算阶段重新决定所有任务的执行顺序,有助于提高特定工作负载的执行效率。
-
它有利于提高计算执行时间的可预测性。对于实时 AI 服务而言,稳定的响应表现与较低的平均延迟同样重要。确定性执行不代表实际 API 请求的响应时间完全固定。用户输入长度、输出 Token 数量、请求排队、网络传输和服务负载仍然可能造成端到端延迟差异。
-
静态调度也可能降低部分计算任务的灵活性。如果模型存在复杂的动态控制流,或者计算过程需要根据实时结果频繁改变执行路径,编译器可能需要采用额外的处理策略。
因此,确定性执行的价值并不是消除所有不确定性,而是在适合的计算任务中,以更明确的执行安排提高硬件资源的使用效率。
Groq LPU 为什么适合低延迟 AI 推理?
Groq LPU 的低延迟设计并非依赖某一项单独技术,而是片上 SRAM、确定性执行、编译器优化和系统级互联共同作用的结果。在大语言模型生成过程中,模型需要连续执行计算操作,并根据已有结果生成后续 Token。如果处理器能够减少部分数据读取等待和运行时调度开销,就有机会缩短连续生成步骤所需的时间。
这对于 Decode 阶段尤其具有意义。由于自回归模型通常需要逐步生成 Token,单个生成步骤的延迟会不断累积,最终影响用户感受到的文本输出速度。不过,不同推理任务的性能瓶颈并不完全相同。长提示词处理可能更依赖大规模并行计算能力,而连续生成过程则可能更加受到内存访问和逐步执行延迟的影响。
因此,Groq LPU 的实际表现需要结合模型类型、输入长度、输出长度和并发请求数量进行评估。
从应用场景来看,以下几类服务尤其关注低延迟推理。
实时语音交互。 语音助手需要将用户语音转换为文本、调用语言模型生成回答,再通过语音合成输出结果。如果语言模型生成速度较慢,整个对话就可能出现明显停顿。
交互式 AI Agent。 AI Agent 在执行任务时,可能需要多次调用语言模型决定下一步操作。每一次推理延迟都会影响整体任务完成时间,因此降低单次推理等待时间可能改善用户体验。
智能客服与实时应用。 面向大量用户的在线服务不仅需要快速响应,还需要控制请求之间的延迟波动,以维持稳定的服务质量。
不过,低延迟并不一定意味着单位计算成本最低。例如,某个推理平台能够以较高速度处理单个请求,但如果硬件采购成本较高,或者在低负载时存在大量闲置资源,其每百万 Token 的实际服务成本仍可能高于其他方案。相反,另一种平台虽然单个请求的生成速度较慢,但能够通过批处理同时服务大量用户,最终实现较低的平均成本。
因此,企业选择推理平台时,需要在延迟、吞吐量、成本和模型兼容性之间进行权衡,而不能仅根据每秒 Token 数作出判断。
Groq LPU 的技术限制有哪些?
虽然 Groq LPU 针对 AI 推理进行了专门优化,但专用架构并不意味着能够在所有计算任务中取得优势。其技术限制主要涉及内存容量、多芯片扩展、模型兼容性和系统成本。
片上 SRAM 的容量限制。由于 SRAM 的存储密度相对较低,单颗芯片能够提供的片上存储容量有限。当模型参数和运行状态超出单芯片容量时,就需要通过多芯片系统分配计算和数据。
例如,一个大型语言模型可能需要数十 GB 甚至更多的存储空间,仅依靠单颗芯片的片上 SRAM 通常难以容纳全部数据。此时,系统必须将模型划分至多个处理器,并通过芯片互联完成必要的数据交换。
这种方式能够扩大可部署模型的规模,但也增加了系统设计的复杂度。
多芯片通信开销。即使单颗 LPU 能够快速执行计算,如果模型运行过程中需要频繁跨芯片传输数据,整体推理速度仍可能受到互联带宽、通信延迟和数据分配策略影响。对于大规模推理系统而言,性能不再只是单颗处理器的计算能力,而是整个芯片集群协同运行的结果。
模型兼容性问题。Groq LPU 依赖编译器将模型计算映射至专用硬件,因此需要相应的软件支持。当新的 AI 模型引入不同的计算算子、注意力机制或动态执行方式时,平台可能需要更新编译器和运行环境。与拥有广泛软件生态的通用 GPU 相比,专用推理处理器需要持续投入软件研发,才能适应快速变化的模型技术。
基础设施与商业成本。LPU 的性能优势需要通过完整计算系统才能实现。实际部署仍然涉及芯片制造、服务器、网络、电力和冷却设施等成本。对于云端推理服务商而言,设备利用率和客户需求同样决定着投资回报。
因此,评价 Groq LPU 时,需要将芯片架构与实际部署条件结合起来。某项测试中的高 Token 生成速度,并不能直接证明其在所有模型和商业场景中都具有更高的成本效率。
Groq LPU 对未来 AI 推理基础设施意味着什么?
Groq LPU 的发展反映出 AI 计算市场正在进一步细分。随着生成式 AI 应用规模扩大,企业开始根据不同工作负载选择更加专业化的计算架构,而不再只关注单一处理器的理论峰值性能。
在模型训练领域,大规模并行计算、内存容量和多设备通信仍然具有重要意义。而在推理领域,首 Token 延迟、连续生成速度、并发吞吐量和单位 Token 成本则成为更加直接的商业指标。
不同计算任务的需求差异,为专用推理芯片提供了发展空间。与此同时,专用处理器与 GPU 之间也不一定是完全替代关系。2026 年 3 月,NVIDIA 介绍了将 Groq 3 LPX 与 Vera Rubin 平台结合的推理架构,探索由不同类型的计算设备承担适合自身特点的推理任务。
这一方向体现了异构计算(Heterogeneous Computing)的发展趋势。未来 AI 数据中心可能同时部署 GPU、专用推理加速器和其他计算设备,再通过软件系统协调不同任务的执行。
例如,对于需要大规模并行处理的工作负载,可以使用适合的 GPU 资源;对于某些对延迟高度敏感的生成任务,则可以探索专用推理处理器的优势。但异构计算并不意味着简单增加芯片类型就能够提高效率。系统还需要解决跨设备通信、任务调度、软件兼容性和基础设施成本等问题。
对于 AI 芯片行业而言,这意味着竞争正在从单一硬件性能,延伸至完整计算系统的效率。处理器架构、编译器、内存系统、互联技术和云服务运营能力,都可能成为决定最终性能和商业价值的因素。
Groq LPU 所代表的技术路线,为这一变化提供了具体案例。其长期价值并不只取决于某一代芯片的推理速度,而是能否持续适应模型演进,并将技术性能转化为稳定、可扩展的计算服务。
总结
Groq LPU 是面向 AI 推理设计的专用处理器,通过片上 SRAM、确定性执行和编译器静态调度等技术,优化部分大语言模型工作负载中的数据访问和计算执行过程。
与通用 GPU 相比,Groq LPU 更加关注特定推理任务中的低延迟和执行可预测性。这种设计适合探索实时文本生成、语音交互和 AI Agent 等应用的性能优化,但并不意味着它能够在所有模型和计算场景中取代 GPU。
与此同时,SRAM 容量、多芯片通信、模型适配和基础设施成本,仍然是专用推理架构需要解决的重要问题。
随着 AI 产业从模型研发扩展至规模化应用,推理计算的竞争重点正在从单纯追求算力规模,转向延迟、吞吐量、成本和系统效率的综合优化。Groq LPU 的发展说明,专用加速器可能在未来 AI 基础设施中发挥更重要的作用,但其实际价值仍需要通过具体工作负载和商业部署结果进行验证。
FAQ
Groq LPU 是什么?
Groq LPU 是 Groq 设计的专用 AI 推理处理器,主要通过片上 SRAM、确定性执行和编译器调度等技术优化特定语言模型推理任务。
LPU 与 GPU 的主要区别是什么?
LPU 更强调针对特定推理任务优化执行和数据传输,而 GPU 具有较广泛的并行计算能力和软件生态。两者的性能差异取决于具体模型和运行环境。
为什么 Groq LPU 使用 SRAM?
SRAM 能够提供较低延迟的片上数据访问,有助于减少部分推理任务中的数据读取开销。但 SRAM 容量有限,部署大型模型通常需要多芯片协同。
确定性执行是什么意思?
确定性执行是指尽可能在程序运行前规划计算顺序、数据传输和资源分配,减少部分运行时调度开销,提高计算执行的可预测性。
Groq LPU 可以用于 AI 模型训练吗?
Groq LPU 主要面向推理工作负载设计,并非以通用大规模模型训练为主要目标。实际支持能力取决于硬件架构和软件工具链。
Groq LPU 的推理速度一定比 NVIDIA GPU 快吗?
不一定。不同模型、输入长度、输出长度、并发规模和测试环境都会影响结果。单用户 Token 生成速度较高,也不意味着总体吞吐量或单位 Token 成本必然更优。
Groq LPU 为什么适合 AI Agent?
AI Agent 可能需要连续执行多次模型推理。降低单次请求的响应延迟,有机会缩短整个任务的执行时间,但最终效果还取决于工具调用、网络传输和其他处理环节。
* 投资有风险,入市须谨慎。本文不作为 Gate 提供的投资理财建议或其他任何类型的建议。
* 在未提及 Gate 的情况下,复制、传播或抄袭本文将违反《版权法》,Gate 有权追究其法律责任。
分享
目录


相关文章
GateClaw 与 AI Skills:Web3 AI Agent 的能力体系解析
GateClaw 的核心功能:Web3 AI Agent 工作站能力解析
一文盘点 Top 10 AI Agents
什么是 TAO?Bittensor 代币经济学、供应模型与激励机制详解
解读 Vana 的野心:实现数据货币化,构建由用户主导的 AI 开发生态