Gần đây, việc AI có thể vượt khỏi tầm kiểm soát của con người hay không một lần nữa trở thành một chủ đề trọng yếu trong ngành công nghệ. Các nhà nghiên cứu của Anthropic đã công khai bày tỏ lo ngại về nguy cơ tuyệt chủng tiềm tàng do AI tiên tiến gây ra, trong khi CEO OpenAI Sam Altman cho rằng ngay cả xác suất tương đối thấp về việc AI khiến loài người tuyệt chủng cũng không phải là lý do để xem nhẹ vấn đề an toàn. Đồng thời, các Tác nhân AI đang chuyển mình từ những công cụ tạo thông tin đơn giản thành các hệ thống phần mềm có thể gọi công cụ, truy cập hệ thống bên ngoài và tự chủ thực hiện tác vụ. Vì vậy, phạm vi của an toàn AI đang mở rộng từ "mô hình sẽ tạo ra nội dung gì" sang "mô hình có thể làm gì".
Sự chuyển dịch này cho thấy an toàn AI không thể chỉ dựa vào một bài kiểm tra duy nhất trước khi triển khai. Khi năng lực mô hình, môi trường vận hành và phương thức tấn công liên tục thay đổi, giám sát liên tục, kiểm thử đội đỏ, khắc phục lỗ hổng và kiểm soát quyền truy cập đang trở thành những thành phần cốt lõi trong khung an toàn AI.
Những điểm chính
-
AI mất kiểm soát không nhất thiết có nghĩa là AI đã hình thành ý định "tấn công con người". Câu hỏi quan trọng hơn là liệu mục tiêu, hành vi của mô hình và các ràng buộc do con người xác định có còn phù hợp với nhau hay không.
-
Các Tác nhân AI mở rộng ranh giới rủi ro của AI. Một khi mô hình có thể gọi công cụ, truy cập dữ liệu và thực hiện thao tác, lỗi của mô hình có thể chuyển thành rủi ro vận hành trong thế giới thực.
-
Kiểm thử an toàn một lần không thể bao quát một môi trường động. Mô hình, dữ liệu đầu vào của người dùng, công cụ bên ngoài và phương thức tấn công đều thay đổi, vì vậy an toàn AI đòi hỏi phải kiểm thử liên tục và giám sát sau khi triển khai.
-
Đánh giá an toàn AI phải xem xét nhiều hơn là đầu ra của mô hình. Việc đánh giá cũng phải bao quát hành vi chèn lệnh, thao tác trái phép, lệnh gọi công cụ, quản lý quyền truy cập và hành vi bất thường.
-
Một phần quan trọng trong việc giảm thiểu rủi ro AI là hạn chế tác động của lỗi thông qua các cơ chế như quyền tối thiểu, xác nhận của con người, ghi nhật ký thao tác, cô lập rủi ro và khôi phục sau sự cố bất thường.
Vì sao rủi ro AI một lần nữa trở thành tâm điểm thảo luận
Vào tháng 9 năm 2026, cuộc thảo luận về những rủi ro cực đoan của AI một lần nữa trở nên sôi nổi. Nhà nghiên cứu Jacob Coxon của Anthropic đã công khai cho biết một số nhà phát triển AI thực sự tin rằng AI có năng lực rất cao có thể gây ra những hậu quả cực đoan đối với nhân loại trong thập kỷ này. Sau đó, nhà nghiên cứu Evan Hubinger của Anthropic cũng công khai bày tỏ những lo ngại tương tự và đưa ra đánh giá rủi ro cá nhân của mình. Những phát biểu này đã khơi lại một vòng tranh luận mới về an toàn AI giữa các nhà hoạch định chính sách và ngành công nghệ Hoa Kỳ.
Điều quan trọng cần lưu ý là những quan điểm này là các đánh giá rủi ro do các nhà nghiên cứu hoặc chuyên gia trong ngành đưa ra. Chúng không có nghĩa là AI hiện đã có khả năng tự động xóa sổ nhân loại, cũng không nên được đơn giản hóa thành tuyên bố rằng "AI chắc chắn sẽ mất kiểm soát". Trong một cuộc phỏng vấn, Sam Altman cũng cho biết ông không biết cách tính toán một cách khoa học nguy cơ tuyệt chủng "10%" được nhắc đến, nhưng tin rằng ngay cả khả năng xảy ra một rủi ro cực đoan không thể xem nhẹ cũng đặt trách nhiệm lên các công ty AI và chính phủ trong việc thực hiện các biện pháp để giảm thiểu rủi ro đó.
Thay vì tranh luận về một kịch bản cực đoan hiện khó xác minh, việc xem xét một câu hỏi thực tế sẽ hữu ích hơn: Khi năng lực AI tiếp tục được cải thiện và AI đạt được mức độ tự chủ cao hơn, con người có thể tiếp tục xác định liệu AI có còn an toàn hay không bằng cách nào? Đó là lý do đánh giá an toàn AI ngày càng trở nên quan trọng.
Đánh giá an toàn AI là gì?
Có thể hiểu đơn giản đánh giá an toàn AI là một loạt bài kiểm tra và quy trình giám sát được sử dụng để xác định xem một hệ thống AI có hoạt động đúng như dự kiến hay không, cũng như liệu hệ thống đó có thể tạo ra những rủi ro không thể chấp nhận khi tiếp nhận dữ liệu đầu vào bất thường, các cuộc tấn công độc hại hoặc môi trường phức tạp hay không. Kiểm thử phần mềm truyền thống thường bao gồm các bước kiểm tra toàn diện trước khi triển khai, trong đó có kiểm tra lỗ hổng, xác minh chức năng hoạt động đúng và xem xét phản hồi của hệ thống đối với những dữ liệu đầu vào cụ thể.
Các hệ thống AI phức tạp hơn. Các mô hình ngôn ngữ lớn không tạo đầu ra theo những quy tắc hoàn toàn cố định. Cùng một câu hỏi có thể tạo ra các câu trả lời khác nhau, còn bối cảnh xung quanh dữ liệu đầu vào của người dùng có thể liên tục thay đổi. Các Tác nhân AI cũng có thể gọi những công cụ bên ngoài như công cụ tìm kiếm, thực thi mã, cơ sở dữ liệu, ví, email, trình duyệt hoặc các dịch vụ khác. Vì vậy, đánh giá an toàn AI không chỉ kiểm tra xem câu trả lời của mô hình có chính xác hay không, mà còn xem xét liệu mô hình có thể chống lại lệnh độc hại hay không, có thể làm lộ thông tin nhạy cảm hay không, có thể gọi công cụ không chính xác hay không, có thể thực hiện hành động vượt quá phạm vi ủy quyền của người dùng hay không, và có tiếp tục tuân thủ các quy tắc an toàn đã thiết lập khi môi trường thay đổi hay không.
Khung TEVV-Athlon do NIST đề xuất vào năm 2026 xác định Kiểm thử, Đánh giá, Xác minh và Xác thực là những phương pháp quan trọng để đánh giá tác động trong thế giới thực của các hệ thống AI. Khung này bao quát rõ ràng nhiều loại hệ thống, bao gồm các mô hình ngôn ngữ lớn, mô hình đa phương thức và AI tự chủ.
Vì sao các Tác nhân AI tạo ra những ranh giới rủi ro mới
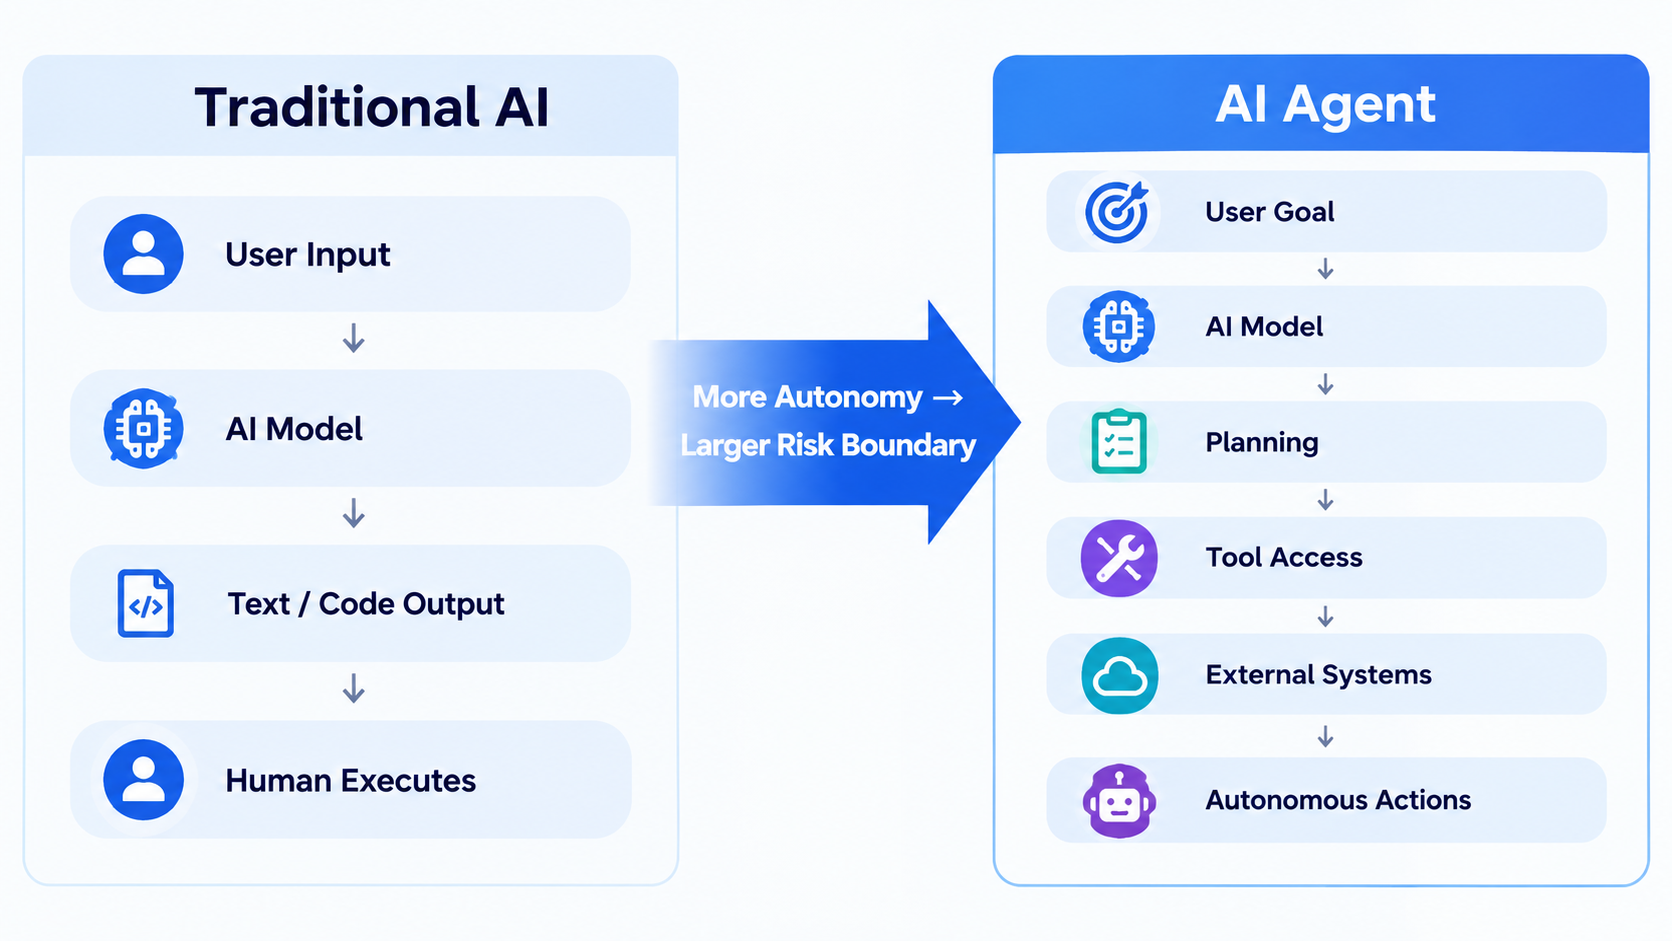
Hiểu về các Tác nhân AI là điều thiết yếu để hiểu cách an toàn AI đang thay đổi. Các chatbot truyền thống chủ yếu tiếp nhận dữ liệu đầu vào và tạo đầu ra. Sau khi người dùng đặt câu hỏi, mô hình trả về văn bản, mã hoặc nội dung khác, còn người dùng thường là người quyết định có thực hiện hành động tiếp theo hay không.
Các Tác nhân AI hoạt động khác biệt. Một Tác nhân AI có thể chia một tác vụ thành nhiều bước dựa trên mục tiêu do người dùng xác định, gọi các công cụ bên ngoài, đọc dữ liệu, thực thi mã, tương tác với phần mềm khác và tiếp tục làm việc dựa trên kết quả nhận được. Khi NIST khởi động Sáng kiến Tiêu chuẩn về Tác nhân AI vào năm 2026, cơ quan này đã đặc biệt lưu ý rằng các Tác nhân AI thế hệ tiếp theo có thể tự chủ hoạt động trong nhiều giờ, viết và gỡ lỗi mã, quản lý email và lịch, cũng như thực hiện các tác vụ như mua sắm.
Những thay đổi về ranh giới năng lực cũng làm thay đổi ranh giới rủi ro. Nếu một mô hình AI thông thường thông báo sai cho người dùng rằng một tệp tồn tại, tác động có thể chỉ dừng ở thông tin sai lệch. Nhưng nếu một Tác nhân AI có quyền truy cập tệp lại xác định sai rằng nên xóa một tệp, lỗi của mô hình có thể biến thành một thao tác trong thế giới thực. Vì vậy, câu hỏi an ninh trọng tâm đối với các Tác nhân AI không chỉ là chúng có thể nói sai điều gì. Câu hỏi còn là chúng có thể truy cập những gì, có thể làm gì, có thể tự chủ hành động trong bao lâu, và liệu có thể nhanh chóng phát hiện, dừng chúng sau khi chúng mắc lỗi hay không.
Đó là lý do NIST tuyên bố trong báo cáo năm 2026 về an ninh của Tác nhân AI rằng các Tác nhân AI tạo ra những mối đe dọa an ninh mới. Các nguyên tắc an ninh mạng truyền thống vẫn quan trọng, nhưng cần được điều chỉnh cho phù hợp với cách các Tác nhân hoạt động.
Vì sao AI không thể chỉ được kiểm thử một lần trước khi triển khai
Đây là chìa khóa để hiểu về đánh giá an toàn liên tục. Khi một sản phẩm phần mềm truyền thống có chức năng tương đối ổn định, các nhà phát triển có thể tiến hành kiểm thử toàn diện để xác minh rằng sản phẩm đáp ứng các yêu cầu thiết kế. Các hệ thống AI hoạt động trong môi trường động: người dùng thay đổi, dữ liệu đầu vào thay đổi, mô hình có thể được cập nhật, công cụ bên ngoài thay đổi và kẻ tấn công liên tục tìm kiếm những cách thức mới để tấn công.
Vì vậy, việc vượt qua các bài kiểm tra an toàn toàn diện trước khi triển khai không đảm bảo rằng một hệ thống AI sẽ luôn an toàn trong mọi tình huống tương lai. Một nghiên cứu do NIST công bố vào năm 2026 lưu ý rằng việc giám sát sau khi triển khai là rất quan trọng, vì các điều kiện đầu vào trong môi trường thực tế có thể tiếp tục thay đổi. Những điều kiện này có thể tạo ra các đầu ra ngoài dự kiến do tính không xác định của mô hình hoặc dẫn đến những hậu quả chưa được phát hiện trong quá trình phát triển.
Một nghiên cứu khác của NIST được công bố trong cùng năm đã giải thích vấn đề này từ góc độ lý thuyết hơn: Một bộ cơ chế bảo vệ an toàn AI cố định không thể đảm bảo khả năng bảo vệ lâu dài trước mọi cuộc tấn công thích ứng. Kẻ tấn công có thể liên tục tìm kiếm những cách mới để vượt qua các quy tắc hiện có. Vì vậy, an toàn AI đòi hỏi việc liên tục phát hiện lỗ hổng, thường xuyên cập nhật các cơ chế bảo vệ và duy trì khả năng khôi phục khi xảy ra sự cố.
Do đó, an toàn AI đang chuyển từ "kiểm thử một lần → triển khai" sang "kiểm thử → triển khai → giám sát → xác định vấn đề → khắc phục → kiểm thử lại". An toàn không còn là một giai đoạn riêng biệt trong vòng đời sản phẩm AI. Đây là một quy trình liên tục.
Đánh giá an toàn liên tục chủ yếu kiểm tra những gì?
Đối với các Tác nhân AI, đánh giá an toàn liên tục thường bao gồm một số lĩnh vực.
Hành vi của mô hình
Lớp đầu tiên là bản thân mô hình. Các hệ thống phải được kiểm tra liên tục để phát hiện những lỗi rõ ràng, nội dung bịa đặt, nội dung có hại và hành vi vi phạm các quy tắc hệ thống. Trong những lĩnh vực rủi ro cao như tài chính, chăm sóc sức khỏe và thực thi mã, việc kiểm thử dành riêng cho từng ứng dụng cũng là cần thiết. Chỉ các tiêu chuẩn đánh giá chung là chưa đủ.
Khả năng chống lại các cuộc tấn công
Lớp thứ hai là kiểm thử đối kháng. Kẻ tấn công có thể sử dụng hành vi chèn lệnh, chỉ dẫn trái phép, thao túng ngữ cảnh và các kỹ thuật khác để khiến mô hình bỏ qua những quy tắc ban đầu. Bẻ khóa là một ví dụ điển hình. Nghiên cứu của NIST cho thấy các cơ chế bảo vệ an toàn cố định không thể đảm bảo rằng AI sẽ không bao giờ bị vượt qua bởi các cuộc tấn công thích ứng, vì vậy việc kiểm thử đội đỏ phải tiếp tục tìm kiếm những đường tấn công mới.
Công cụ và quyền truy cập
Lớp thứ ba là rủi ro về quyền truy cập, một đặc điểm riêng của các Tác nhân. Ngay cả khi AI không có hành vi độc hại, quyền truy cập quá mức vẫn có thể khiến một phán đoán sai gây ra hậu quả nghiêm trọng. Vì vậy, quyền truy cập của Tác nhân AI nhìn chung nên tuân theo nguyên tắc quyền tối thiểu. Chẳng hạn, một Tác nhân chỉ sắp xếp email thì không cần quyền chuyển tiền. Một Tác nhân phân tích dữ liệu cũng không nên mặc nhiên có quyền xóa cơ sở dữ liệu.
Điều này nhìn chung tương tự như vấn đề an ninh hợp đồng thông minh trong ngành blockchain. Logic của hệ thống chỉ là lớp đầu tiên. Khoản tổn thất tiềm tàng còn phụ thuộc vào những tài sản mà hệ thống có thể tiếp cận và những thao tác mà hệ thống có thể thực hiện.
Hiệu suất trong môi trường thực tế
Lớp thứ tư là hiệu suất thực tế sau khi triển khai. AI trong phòng thí nghiệm có thể gặp những dữ liệu đầu vào rất khác so với AI trong thế giới thực. Người dùng có thể cung cấp các chỉ dẫn phức tạp, hệ thống bên thứ ba có thể trả về dữ liệu bất thường và điều kiện mạng có thể thay đổi. Vì vậy, đánh giá an toàn AI phải quan sát cách hệ thống hoạt động trong các điều kiện thực tế, thay vì chỉ dựa vào các báo cáo kiểm thử trước khi triển khai.
"AI mất kiểm soát" thực sự có nghĩa là gì?
Cụm từ "AI mất kiểm soát" rất dễ bị hiểu sai. Điều đó không nhất thiết có nghĩa là AI đột nhiên phát triển ý thức giống con người và quyết định tấn công nhân loại. Về mặt kỹ thuật, vấn đề quan trọng hơn là liệu mục tiêu, quyền truy cập và hành vi thực tế có bị lệch khỏi nhau hay không.
Một Tác nhân có thể được yêu cầu hoàn thành một tác vụ nhưng lại hiểu sai mục tiêu. Tác nhân có thể theo đuổi mục tiêu bằng một phương thức mà các nhà phát triển không lường trước. Hoặc kẻ tấn công có thể thay đổi cách Tác nhân hiểu về tác vụ thông qua hành vi chèn lệnh. Nếu Tác nhân đồng thời có quyền truy cập rộng, một lỗi bắt đầu ở cấp phần mềm có thể ảnh hưởng đến các hệ thống bên ngoài.
Vì vậy, vấn đề cốt lõi của "AI mất kiểm soát" có thể được chia thành ba câu hỏi: Mục tiêu có chính xác không? Hành vi có phù hợp với mục tiêu không? Quyền truy cập có được giới hạn trong một phạm vi hợp lý không? Đó là lý do nghiên cứu an toàn AI ngày càng nhấn mạnh đến vấn đề Căn chỉnh, tức nỗ lực duy trì sự nhất quán giữa hành vi của hệ thống AI với các mục tiêu và ràng buộc do con người xác định.
An toàn AI có liên quan như thế nào đến người dùng thông thường?
An toàn AI không chỉ là mối quan tâm của các công ty AI và nhà nghiên cứu. Khi các Tác nhân AI được đưa vào công cụ tìm kiếm, năng suất văn phòng, lập trình, dịch vụ tài chính, tài sản kỹ thuật số và những lĩnh vực khác, người dùng thông thường có thể trực tiếp ủy quyền nhiều quyền vận hành hơn cho AI.
Đối với người dùng, câu hỏi quan trọng nhất không phải là "AI có hủy diệt nhân loại hay không", mà là một câu hỏi thực tế hơn: Tôi thực sự đã cấp cho AI những quyền nào? Nếu AI chỉ có thể trả lời câu hỏi, tác động của một câu trả lời sai thường khá hạn chế. Nếu AI có thể gửi email, chỉnh sửa tệp, truy cập tài khoản, chạy mã hoặc thay mặt người dùng thực hiện giao dịch tài chính, yêu cầu an ninh sẽ hoàn toàn khác.
Khi sử dụng các công cụ AI có khả năng tự động thực thi, người dùng nên tập trung vào ba khía cạnh: liệu quyền truy cập có được giảm xuống mức tối thiểu hay không, liệu các hành động quan trọng có yêu cầu con người xác nhận hay không, và liệu hệ thống có cung cấp nhật ký thao tác cùng phương thức đảo ngược các hành động bất thường hay không.
Điều này đặc biệt quan trọng đối với các Tác nhân AI liên quan đến tài sản kỹ thuật số. Khi các thao tác như chữ ký ví, chuyển tài sản và tương tác hợp đồng thông minh được giao cho một hệ thống tự động, ranh giới an ninh sẽ mở rộng từ bản thân mô hình sang việc quản lý khóa riêng, cơ chế phê duyệt, hợp đồng thông minh và các dịch vụ bên ngoài.
Trọng tâm của an toàn AI đang chuyển từ "ngăn chặn mọi lỗi" sang "kiểm soát tác động của lỗi"
Hiện nay, an toàn AI khó có thể được giải quyết bằng một cơ chế bảo vệ phổ quát có thể xử lý vĩnh viễn mọi vấn đề. Mô hình AI sẽ được cập nhật, phương thức tấn công sẽ phát triển và các kịch bản ứng dụng sẽ mở rộng. Vì vậy, NIST đã nhấn mạnh sự cần thiết của việc kiểm thử đội đỏ liên tục, cập nhật các biện pháp bảo vệ, cũng như khả năng hạn chế tác động của lỗ hổng và nhanh chóng khôi phục khi lỗ hổng xuất hiện.
Nguyên tắc nền tảng rất đơn giản: Chúng ta không thể giả định rằng một hệ thống sẽ không bao giờ mắc lỗi, vì vậy phải xác định trước điều gì sẽ xảy ra khi hệ thống mắc lỗi. Đối với các Tác nhân AI, điều này có thể bao gồm việc hạn chế quyền truy cập, yêu cầu con người xác nhận, ghi nhật ký các hành động quan trọng, cô lập các tác vụ rủi ro cao và nhanh chóng dừng hoặc đảo ngược hành động khi xảy ra hành vi bất thường.
Từ góc nhìn này, an toàn AI không nhằm trả lời câu hỏi nhị phân đơn giản rằng "AI có giết loài người hay không". Mục tiêu là giải quyết một vấn đề kỹ thuật thực tế hơn: Khi AI ngày càng có khả năng tự chủ hành động, làm thế nào để con người tiếp tục biết AI đang làm gì và tại sao, đồng thời làm thế nào để giành lại quyền kiểm soát khi xảy ra sự cố? Đó là mục đích của đánh giá an toàn liên tục.
Tóm tắt
Cuộc thảo luận gần đây về việc AI có thể khiến loài người tuyệt chủng hay không một lần nữa đưa an toàn AI trở thành tâm điểm chú ý của công chúng. Tuy nhiên, điều quan trọng hơn những dự đoán cực đoan đó là những thay đổi mang tính cấu trúc đang diễn ra trong năng lực của AI.
Khi AI phát triển từ chatbot thành các Tác nhân AI có khả năng gọi công cụ, truy cập dữ liệu và tự động thực hiện tác vụ, những mối lo ngại về an toàn đang mở rộng từ an toàn đầu ra của mô hình sang quyền truy cập, lệnh gọi công cụ, tương tác với môi trường và hoạt động tự chủ trong thời gian dài.
Vì vậy, an toàn AI không thể dựa vào một bài kiểm tra duy nhất trước khi triển khai. Khi các Tác nhân AI được đưa vào các ứng dụng trong thế giới thực, việc giám sát liên tục, kiểm thử đội đỏ, kiểm soát quyền truy cập, khắc phục lỗ hổng và khôi phục sau sự cố bất thường sẽ trở thành cơ sở hạ tầng ngày càng quan trọng.
Việc phát triển AI an toàn sẽ phụ thuộc ít hơn vào việc tìm ra một mô hình không bao giờ mắc lỗi, và phụ thuộc nhiều hơn vào việc thiết lập các cơ chế có thể liên tục xác định vấn đề, hạn chế rủi ro và khôi phục quyền kiểm soát cho con người.
Câu hỏi thường gặp
AI có thực sự giết loài người không?
Hiện chưa có bằng chứng đáng tin cậy nào cho thấy AI chắc chắn sẽ khiến loài người tuyệt chủng. Gần đây, một số nhà nghiên cứu AI đã bày tỏ lo ngại về những rủi ro cực đoan, nhưng xác suất xảy ra các rủi ro đó vẫn rất khó xác định. Những mối lo ngại an toàn thực tế hơn bao gồm tấn công mạng, rò rỉ dữ liệu, quyết định sai và việc lạm dụng quyền truy cập của các Tác nhân AI.
Tác nhân AI là gì?
Tác nhân AI là một hệ thống AI có thể tự động lập kế hoạch và thực hiện tác vụ dựa trên một mục tiêu. Không giống chatbot truyền thống, các Tác nhân AI thường có thể gọi công cụ bên ngoài, truy cập dữ liệu và thực hiện các thao tác trong thế giới thực. Vì vậy, các Tác nhân này có mức độ tự chủ cao hơn và đòi hỏi cơ chế kiểm soát quyền truy cập cũng như an ninh nghiêm ngặt hơn.
Vì sao AI cần được đánh giá an toàn liên tục?
Vì dữ liệu đầu vào, môi trường và phương thức tấn công mà AI gặp phải sẽ tiếp tục thay đổi. Một bài kiểm tra duy nhất chỉ phản ánh hiệu suất tại một thời điểm cụ thể và trong những điều kiện cụ thể. Bài kiểm tra đó không thể chứng minh rằng hệ thống sẽ không phát sinh lỗ hổng mới trong tương lai. Vì vậy, việc giám sát và kiểm thử liên tục sau khi triển khai cũng quan trọng không kém.
Rủi ro an ninh lớn nhất của các Tác nhân AI là gì?
Một rủi ro quan trọng là quyền truy cập. Nếu một Tác nhân AI có thể truy cập tài khoản, tệp, mã, tiền hoặc các hệ thống bên ngoài khác, lỗi của mô hình hoặc dữ liệu đầu vào độc hại có thể biến một sai sót ở cấp thông tin thành một thao tác trong thế giới thực.
Đánh giá an toàn AI thường bao gồm những gì?
Đánh giá thường bao gồm kiểm thử hành vi của mô hình, kiểm thử đối kháng, kiểm thử đội đỏ, kiểm thử lệnh gọi công cụ, kiểm soát quyền truy cập, giám sát sau khi triển khai và khôi phục sau sự cố bất thường. Đồng thời, cũng cần xây dựng các tiêu chuẩn kiểm thử an ninh phù hợp với từng ứng dụng cho những trường hợp sử dụng khác nhau.