Dành cho người mới bắt đầu tìm hiểu các giới hạn năng lực AI, mô hình thế giới trả lời liệu một hệ thống có thể dự đoán hệ quả của hành động hay không, chứ không phải liệu hệ thống đó có thể tạo ra các câu trả lời trôi chảy hay không. Các phần dưới đây đề cập đến định nghĩa, vòng lặp dự đoán, ba hướng kỹ thuật, lựa chọn tác vụ giữa Mô hình thế giới và LLM, sự khác biệt với công nghệ tạo video, các trường hợp sử dụng và giới hạn đánh giá; các khái niệm liên quan được trình bày trong các bài giải thích của Gate Learn về Siêu trí tuệ (ASI) và AI riêng tư.
Những điểm chính
- Năng lực cốt lõi là dự đoán có điều kiện theo hành động: với một trạng thái và một hành động, hệ thống tạo ra trạng thái tiếp theo (hoặc biểu diễn tiếp theo) phục vụ việc lập kế hoạch và điều khiển.
- Ba hướng phổ biến gồm: RL dựa trên mô hình (MBRL) / huấn luyện bằng tưởng tượng, mô phỏng tương tác tạo sinh và biểu diễn dự đoán theo phong cách JEPA.
- Mô hình ngôn ngữ lớn xuất sắc trong việc dự đoán token tiếp theo, còn trình tạo video xuất sắc trong việc duy trì tính liên tục về hình ảnh; không mô hình nào tự động trở thành một mô hình thế giới có thể lập kế hoạch.
- Khi đánh giá, cần theo dõi vật lý giả, sai lệch trong dài hạn, thất bại ngoài phân phối, các chỉ số khó và ranh giới với các trình mô phỏng được viết thủ công.
Mô hình thế giới là gì và giải quyết vấn đề nào?
Mô hình thế giới giải quyết một câu hỏi thực tế: trước khi tác nhân hành động, liệu tác nhân có thể ước tính đáng tin cậy điều gì sẽ xảy ra tiếp theo hay không? Nếu không có kỹ năng này, quá trình học phụ thuộc vào thử và sai trong thực tế, thường tốn kém, chậm hoặc không an toàn, đồng thời việc lập kế hoạch ngoại tuyến cũng trở nên khó khăn.
Trong robot học, lái xe tự động, tác nhân trò chơi và huấn luyện mô phỏng, đặc biệt là với các tác nhân hiện thân trong môi trường ảo hoặc vật lý, phản hồi thường tốn kém hoặc tiềm ẩn rủi ro; chẳng hạn, một chính sách lái xe kém có thể gây ra va chạm thực tế trước khi nó kịp học hỏi. Mô hình thế giới chuyển việc “thử hành động” sang các động lực đã học: mô phỏng tiến về phía trước trong không gian tiềm ẩn hoặc không gian quan sát, sau đó đưa một chính sách mạnh hơn trở lại thế giới thực. Mục tiêu này khác với các hệ thống hội thoại vốn chủ yếu diễn đạt lại kiến thức; nó gần hơn với khả năng dự báo nhân quả trong một môi trường tương tác.
Mục từ về mô hình thế giới trong Bảng thuật ngữ NVIDIA mô tả chúng là các biểu diễn nội bộ giúp AI hiểu và dự đoán cách thế giới vật lý phát triển; bài viết A Path Towards Autonomous Machine Intelligence của Yann LeCun đặt các mô hình thế giới dự đoán trên con đường hướng tới trí tuệ tự chủ hơn; và công trình “World Models” năm 2018 của David Ha đã góp phần định hình phương pháp học dựa trên mô hình hiện đại. Một tác nhân thường chỉ quan sát được một phần, nên trạng thái đầy đủ không sẵn có trực tiếp. Trong mọi cách tiếp cận này, dự đoán tồn tại để hỗ trợ việc ra quyết định.
Mô hình thế giới hoạt động như thế nào? Trạng thái, hành động và vòng lặp dự đoán
Tiêu chí ổn định nhất để kiểm tra một hệ thống định hướng theo mô hình thế giới là dự đoán có điều kiện theo hành động: liệu đầu vào có bao gồm rõ ràng hành động của tác nhân, hoặc tín hiệu điều khiển, hay không; và liệu đầu ra có phải là trạng thái tiếp theo hoặc biểu diễn tiếp theo được điều kiện hóa theo hành động đó hay không.
Vòng lặp này thường được rút gọn thành ba bước: mã hóa các quan sát thành một trạng thái; điều kiện hóa theo một hành động ứng viên; dự đoán trạng thái tiếp theo, trong đó môi trường thay đổi sau hành động đó và trả về các quan sát mới, đồng thời có thể tiếp tục mô phỏng dự đoán này như một điểm khởi đầu mới. Một chính sách hoặc bộ lập kế hoạch sẽ so sánh các quỹ đạo tưởng tượng theo phần thưởng, rủi ro hoặc các ràng buộc, rồi thực thi hành động; một quan sát mới sẽ khởi động lại quá trình mã hóa.
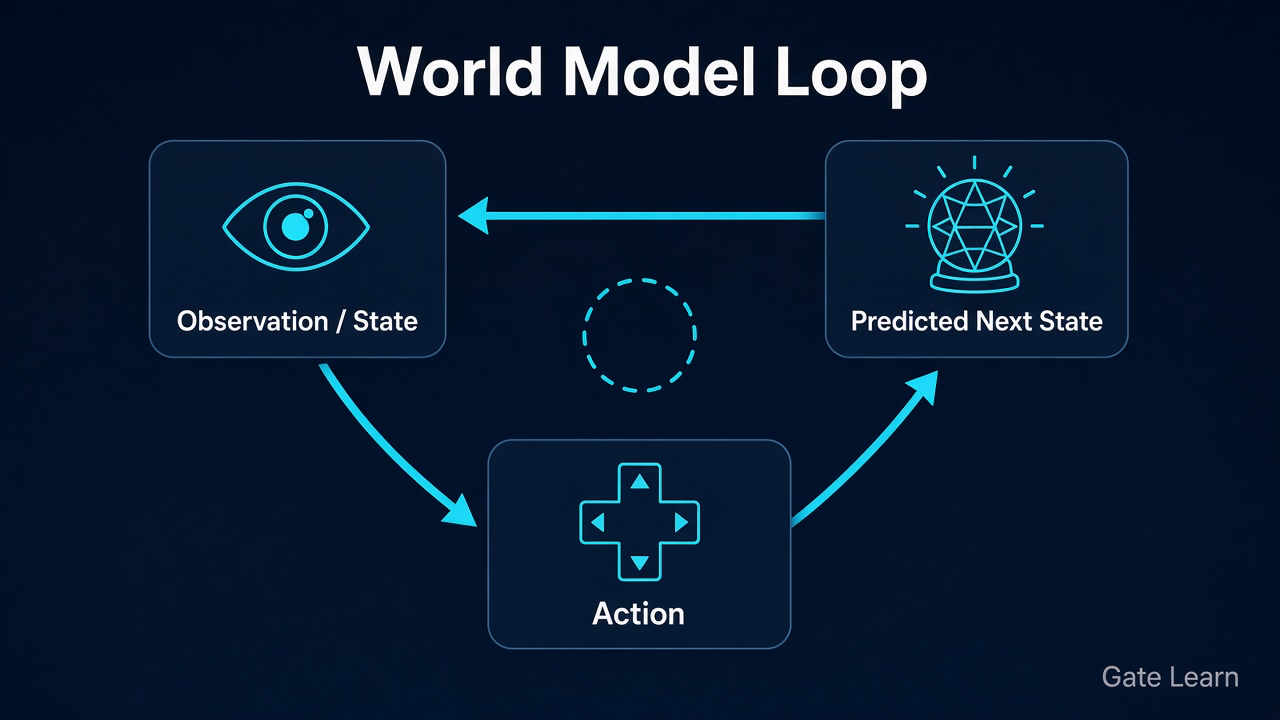
Hình 1. Vòng lặp mô hình thế giới: quan sát/trạng thái cùng với hành động tạo ra trạng thái tiếp theo được dự đoán, từ đó cung cấp đầu vào cho chu kỳ tiếp theo.
Nhiều hệ thống thực tế tránh dự đoán dài hạn bằng pixel thô mà thay vào đó học các động lực tiềm ẩn: nén dữ liệu hình ảnh có chiều cao thành một trạng thái gọn hơn, sau đó mô phỏng tiến về phía trước trong không gian đó. Các lần mô phỏng trong không gian tiềm ẩn giúp giảm nhiễu hình ảnh và làm cho việc huấn luyện bằng tưởng tượng tiết kiệm hơn; việc trạng thái tiềm ẩn có còn trung thực với vật lý thực hay không vẫn cần được kiểm tra thông qua các tác vụ hạ nguồn và các bài kiểm tra ngoài phân phối, đặc biệt vì môi trường vật lý chỉ được quan sát một phần và cần được suy luận thông qua phản hồi.
Các hướng kỹ thuật chính của mô hình thế giới là gì?
“Mô hình thế giới” là một nhãn rộng bao gồm nhiều nhóm kỹ thuật, không phải tên của một thuật toán duy nhất. Việc lựa chọn bắt đầu từ mục tiêu: chính sách có thể điều khiển, mô phỏng pixel tương tác hoặc biểu diễn trừu tượng có khả năng chuyển giao.
| Hướng |
Ý tưởng cốt lõi |
Phù hợp nhất |
Chi phí chính |
| MBRL / huấn luyện bằng tưởng tượng |
Học động lực, sau đó huấn luyện chính sách dựa trên các lần mô phỏng của mô hình (Dreamer) |
Điều khiển, trò chơi, RL tiết kiệm mẫu |
Lỗi mô hình làm suy giảm chính sách; sai lệch |
| Mô phỏng tương tác tạo sinh |
Học một môi trường tương tác tạo ra các khung hình/quy sát tiếp theo |
Tăng cường dữ liệu, thế giới video tương tác |
Hình thức ≠ vật lý; đánh giá tốn kém |
| Biểu diễn dự đoán JEPA |
Dự đoán embedding tương lai/được che trong không gian biểu diễn (I-JEPA) |
Học biểu diễn, dự đoán trừu tượng phục vụ lập kế hoạch |
Không có pixel; cần một ngăn xếp điều khiển |
Một hướng có thể tập trung vào mô hình video dự đoán các khung hình tương lai, trong khi hướng khác nhắm đến các động lực tiềm ẩn sẵn sàng cho việc lập kế hoạch thay vì tái tạo đầy đủ hình ảnh.
Ba hướng này có thể cùng tồn tại: các phương pháp theo phong cách Dreamer nhấn mạnh việc huấn luyện chính sách trong môi trường tưởng tượng; các mô hình thế giới video tạo sinh nhấn mạnh mô phỏng hình thức tương tác; I-JEPA của Meta AI thể hiện việc dự đoán trong không gian embedding chung thay vì tái tạo từng pixel. Các hệ thống khác nhau cũng lựa chọn công thức huấn luyện khác nhau, tùy thuộc vào việc chúng học từ các cặp đầu vào – đầu ra, các lần mô phỏng điều khiển hay các embedding dự đoán. Hãy căn chỉnh tác vụ trước, rồi mới tranh luận về tên gọi.
Mô hình thế giới khác với LLM và công nghệ tạo video như thế nào?
Cả ba đều “dự đoán”, nhưng trong AI tạo sinh, chúng dự đoán các đối tượng khác nhau và khác nhau ở điều kiện hóa theo hành động: LLM dự đoán token tiếp theo, trình tạo video dự đoán hình thức của khung hình tiếp theo, còn các hệ thống định hướng theo mô hình thế giới dự đoán cách trạng thái thay đổi sau một hành động.
| Khía cạnh |
Mô hình thế giới |
Mô hình ngôn ngữ lớn (LLM) |
Tạo video |
| Mục tiêu dự đoán cốt lõi |
Trạng thái tiếp theo / động lực tiềm ẩn, thường có điều kiện theo hành động |
Token tiếp theo / cấu trúc văn bản |
Hình thức của khung hình hoặc đoạn video tiếp theo |
| Liên kết với hành động |
Dự đoán có điều kiện theo hành động là trục quyết định |
Thường không có vòng lặp điều khiển vật lý |
Có thể điều kiện hóa theo văn bản/khung hình đầu tiên, nhưng không thể thực thi |
| Mục đích sử dụng điển hình |
Lập kế hoạch, điều khiển, AI hiện thân |
Ngôn ngữ, viết nội dung, điều phối công cụ |
Tạo nội dung, xem trước, mô phỏng tương tác |
| Nhầm lẫn phổ biến |
Khả năng trò chuyện = mô hình thế giới |
Viết về vật lý = kỹ năng vật lý |
Khung hình chân thực = động lực chính xác |
Do đó, một trình tạo video tương tự Sora có thể hiển thị các khung hình mạch lạc với độ trung thực hình ảnh cao và thậm chí tính nhất quán không gian rõ ràng, đồng thời có thể được gọi là “mô hình thế giới video”, nhưng riêng các đặc tính đó không chứng minh khả năng hiểu biết vật lý. Nếu thiếu một giao diện hành động ổn định, các chuyển đổi trạng thái có thể xác minh và một vòng lặp lập kế hoạch, thì phân loại chính xác vẫn là video tạo sinh. Một hệ thống mạnh hơn cũng có thể đánh giá các chuỗi hành động để hỗ trợ lập kế hoạch và ra quyết định, thay vì chỉ hiển thị thụ động các góc nhìn có khả năng xảy ra. Một LLM có thể mô tả “điều gì xảy ra nếu bạn đẩy nhẹ chiếc cốc”, nhưng điều đó không tạo ra các động lực môi trường có thể mô phỏng và đánh giá.
Mô hình thế giới thường được sử dụng ở đâu?
AI hiện thân là một bối cảnh sử dụng phổ biến: cánh tay robot và robot di động cần trí thông minh không gian, tức khả năng suy luận về bố cục, chuyển động và thay đổi trong thế giới vật lý, cùng với dự báo về tiếp xúc và dịch chuyển trước khi chạm vào vật thể, vì nhiều tương tác rất khó đảo ngược khi chuyển động đã bắt đầu. Dự đoán có điều kiện theo hành động cho phép hệ thống loại bỏ các quỹ đạo không hiệu quả trong môi phỏng hoặc không gian tiềm ẩn trước khi phải chịu chi phí của các va chạm thực tế; các ví dụ trình diễn có thể khởi tạo hành vi nhưng không thay thế được việc học dựa trên tương tác.
Trò chơi và học tăng cường dựa trên mô hình là một lĩnh vực cốt lõi khác. Các phương pháp theo phong cách Dreamer cải thiện chính sách dựa trên các quỹ đạo tưởng tượng, nhờ đó khả năng điều khiển có thể sử dụng được hình thành với ít tương tác thực tế hơn. Các ý tưởng tương tự có thể chuyển sang nhật ký điều khiển công nghiệp, nơi một trình mô phỏng viết thủ công chưa hoàn chỉnh nhưng lịch sử quan sát lại phong phú, bởi mô hình đang cố gắng nắm bắt động lực của hệ thống từ lịch sử đó.
Lái xe tự động, lập lịch kho hàng và mô phỏng đa tác nhân cũng tích hợp các thành phần mô hình thế giới, không phải để thay thế hoàn toàn các ngăn xếp lập kế hoạch mà để làm lớp dự đoán hệ quả ngắn hạn. Kiểm thử ảo và dữ liệu video được tuyển chọn thường được sử dụng để huấn luyện và đánh giá các thành phần này trong nhiều kịch bản trước khi triển khai thực tế. Bất kỳ hệ thống điều khiển nào cần “suy nghĩ trước khi hành động” đều có thể tích hợp một mô-đun mô hình thế giới.
Những lợi ích, rủi ro và giới hạn nào quan trọng khi đánh giá mô hình thế giới?
Lợi ích là hiệu quả mẫu và quá trình thử và sai an toàn hơn: việc tưởng tượng bên trong mô hình có thể giảm hoạt động khám phá nguy hiểm, còn các dự báo có điều kiện theo hành động có thể đặt việc lập kế hoạch trên các động lực có thể kiểm tra. Các giới hạn và rủi ro thường xuất hiện khi một mô hình trông có vẻ đúng nhưng không đáng tin cậy, bởi một biểu diễn nội bộ được hoàn thiện tốt không đồng nghĩa với hành vi có thể hoạt động khi triển khai.
| Cơ chế |
Biểu hiện |
Lý do bị che khuất |
Câu hỏi kiểm tra |
| Vật lý giả |
Quỹ đạo mượt mà nhưng vi phạm bảo toàn/tiếp xúc |
Hình ảnh tạo cảm giác trôi chảy đáng tin |
Các đại lượng quan trọng có được bảo toàn không? Vật thể có thể xuyên qua nhau không? |
| Sai lệch trong dài hạn |
Các lần mô phỏng ngắn ổn; các lần dài bị sụp đổ |
Bản trình diễn ưu tiên các đoạn ngắn |
Lỗi tăng thế nào theo số bước? Có lập kế hoạch lại không? |
| Thất bại ngoài phân phối |
Hỏng với vật thể, ánh sáng hoặc phạm vi hành động mới |
Điểm số trong phân phối trông mạnh |
Có giao thức OOD không? Các dạng thất bại có được công khai không? |
| Đánh giá khó |
Không có điểm số chung cho “hiểu biết thế giới” |
Thành công tác vụ che lấp chỉ số |
Ngoài điểm tác vụ, có báo cáo lỗi dự đoán không? |
| Ranh giới với trình mô phỏng viết thủ công |
Mô hình đã học được xem như động cơ đã xác minh |
Hoạt động tiếp thị trộn lẫn trình mô phỏng / mô hình thế giới |
Những ràng buộc nào được mã hóa cứng? Những yếu tố nào chỉ là sự khớp dữ liệu? |
Việc chuyển giao vào thực tế là khó khăn do khoảng cách từ mô phỏng đến thực tế. Các bài kiểm tra tốt nên hỏi liệu mô hình có dự đoán được các kết quả có thể điều khiển dưới tác động của hành động hay không, thay vì chỉ tạo ra hình ảnh hợp lý.
Hãy sử dụng bảng này như một danh sách kiểm tra cho các tuyên bố: xác nhận giao diện có điều kiện theo hành động, sau đó yêu cầu bằng chứng về dài hạn và OOD, cuối cùng phân biệt “trông đẹp” với “động lực có thể lập kế hoạch”. Nếu không có bằng chứng đó, cách diễn đạt an toàn hơn là “bao gồm các thành phần mô hình thế giới hoặc mục tiêu nghiên cứu”, thay vì “có một mô hình thế giới hoàn chỉnh”. Vì tác nhân có năng lực hạn chế, việc đánh giá nên tập trung vào trạng thái liên quan đến mục tiêu thay vì tái tạo toàn bộ cảnh.
Tóm tắt
Mô hình thế giới đưa AI từ “có thể trò chuyện / có thể vẽ” sang “có thể dự đoán hệ quả của hành động”, chẳng hạn dự đoán rằng robot sẽ làm đổ cốc nếu đi sai đường. Cốt lõi hoạt động là một vòng lặp khép kín gồm trạng thái, hành động và dự đoán, trong đó dự đoán có điều kiện theo hành động là trục quyết định rõ ràng nhất.
Ba hướng, gồm MBRL/huấn luyện bằng tưởng tượng, mô phỏng tương tác tạo sinh và biểu diễn dự đoán JEPA, phục vụ các mục tiêu khác nhau và không thể thay thế cho nhau. So với LLM và trình tạo video, hãy so sánh mục tiêu dự đoán và giao diện hành động; khi đánh giá, hãy ưu tiên vật lý giả, sai lệch, thất bại OOD, các chỉ số khó và ranh giới với trình mô phỏng.
Câu hỏi thường gặp
Mô hình thế giới là gì?
Mô hình thế giới là một mô hình động lực nội bộ đã học, biểu diễn cách môi trường có thể thay đổi dựa trên trạng thái hiện tại, hoặc quan sát hiện tại, và một hành động. Thế giới tại bất kỳ thời điểm nào cũng phong phú hơn những gì tác nhân có thể quan sát trực tiếp, nên mô hình sẽ tóm tắt các biến quan trọng cho việc lập kế hoạch, chẳng hạn vị trí robot sẽ đến sau khi rẽ trái. Mục đích của mô hình là hỗ trợ lập kế hoạch và thử – sai trong môi trường tưởng tượng, không chỉ tạo ra văn bản hoặc hình thức video.
Mô hình thế giới khác với mô hình ngôn ngữ lớn như thế nào?
Mô hình ngôn ngữ lớn chủ yếu dự đoán token tiếp theo và xuất sắc trong ngôn ngữ cũng như điều phối kiến thức; mô hình thế giới chủ yếu dự đoán cách trạng thái thay đổi sau các hành động để phục vụ điều khiển và lập kế hoạch. LLM có thể thảo luận về vật lý mà không cung cấp các động lực môi trường có thể mô phỏng và đánh giá.
Mô hình thế giới hoạt động như thế nào?
Một vòng lặp điển hình mã hóa các quan sát thành trạng thái, điều kiện hóa theo một hành động ứng viên, dự đoán trạng thái tiếp theo sau hành động đó và có thể tiếp tục mô phỏng trong không gian tiềm ẩn. Bộ lập kế hoạch so sánh các lần mô phỏng tưởng tượng, thực thi một hành động, sau đó cập nhật trạng thái từ một quan sát mới.
Sora hoặc công nghệ tạo video có được xem là mô hình thế giới không?
Không tự động. Nếu một hệ thống chủ yếu tạo ra video nhất quán về mặt hình thức nhưng không có giao diện ổn định có điều kiện theo hành động, các chuyển đổi trạng thái có thể xác minh và khả năng sử dụng cho việc lập kế hoạch, thì nên mô tả hệ thống đó là một trình tạo video. Hệ thống chỉ trở nên gần với mô hình thế giới hơn khi dự đoán có điều kiện theo hành động và một vòng lặp có thể lập kế hoạch được chứng minh.
Mô hình thế giới khác với trình mô phỏng truyền thống như thế nào?
Các trình mô phỏng truyền thống thường mã hóa các quy tắc và ràng buộc vật lý được viết thủ công, trong khi các mô hình thế giới dựa trên dữ liệu thường được học bằng mạng nơ-ron. Các mô hình đã học có thể linh hoạt hơn và gần với nhiễu cảm biến hơn, nhưng cũng dễ gặp vật lý giả và sai lệch trong dài hạn hơn, do đó không nên được mặc định xem là tương đương với một động cơ vật lý đã được xác minh.