Для читателей, выбирающих по задаче, ключевой вопрос не в том, «какая сторона сильнее», а в том, что принесёт больший ущерб при сбое: связный бессмысленный текст или отклонение динамики от реальности. В разделах ниже сравниваются модель мира и LLM по целям прогнозирования, данным и оценке, подходящим задачам, правилам комбинирования и типичным ошибочным представлениям. Пределы возможностей рассматриваются рядом с суперинтеллектом (ASI), а границы внедрения — рядом с частным ИИ.
Ключевые выводы
- Модели мира оптимизируют динамику следующего состояния или скрытого представления с учётом действий; LLM оптимизируют следующий токен и структуру текста.
- Для планирования и управления в физической среде предпочтительнее модели мира; для написания текстов, Q&A с дополненным поиском и вызова инструментов — LLM.
- Если задаче нужны и языковой интерфейс, и моделируемая динамика среды, объединяйте их, а не рассматривайте как взаимозаменяемые решения.
- Режимы отказа различаются: LLM часто ошибаются через языковые галлюцинации, а модели мира — через дрейф динамики и нереалистичную физику.
Что такое модель мира?
Модель мира — это обученная система динамики. Получая текущее состояние или наблюдение и возможное действие, она прогнозирует изменение среды, чтобы агент мог мысленно проверить действия перед планированием. Главный критерий выбора — прогнозирование с учётом действий, а не качество диалога.
В отличие от систем, которые создают только текст или визуальный результат, решения, ориентированные на модели мира, связывают прогнозы с циклами планирования, управления или обучения через воображение. Распространённые подходы включают обучение с подкреплением на основе модели, например Dreamer, генеративное интерактивное моделирование и прогнозирование представлений в стиле JEPA. Их цели различаются, поэтому названия не взаимозаменяемы.
Что такое большая языковая модель?
Большая языковая модель (LLM) — это генеративная модель, обученная на крупных текстовых корпусах, где основной целью является прогнозирование следующего токена. LLM хорошо справляется с пониманием языка, составлением кратких изложений, переводом, помощью в программировании и многошаговой текстовой оркестрацией через промпты и интерфейсы инструментов.
LLM может описать физический мир или написать последовательность действий для сценария «что произойдёт, если толкнуть чашку», но описание не является моделируемой и оцениваемой динамикой среды. Без интерфейса действий и состояний и проверок в замкнутом контуре использование LLM в качестве контроллера или физического движка — это ошибка выбора, а не проблема «слишком маленькой модели».
Чем различаются цели прогнозирования?
Ключевое различие заключается в объекте прогнозирования: модель мира предсказывает следующее состояние или скрытую динамику после действия, а LLM — следующий токен и структуру текста. Обе модели «прогнозируют», но критерии успеха у них различаются.
| Характеристика |
Модель мира |
LLM |
| Цель прогнозирования |
Следующее состояние / скрытая динамика, часто с учётом действий |
Следующий токен / текст и следование инструкциям |
| Связь с действием |
Прогнозирование с учётом действий — ключевой критерий |
Обычно не моделирует физический контур управления |
| Форма вывода |
Состояния, представления, траектории или интерактивные наблюдения |
Текст, код, аргументы вызова инструментов |
| Критерии успеха |
Проверяемые последствия, возможность планирования, отслеживаемая ошибка |
Семантическая корректность, пригодный формат, проверяемые источники |
| Типичный сбой |
Дрейф динамики, нереалистичная физика |
Языковые галлюцинации, вымышленные источники |
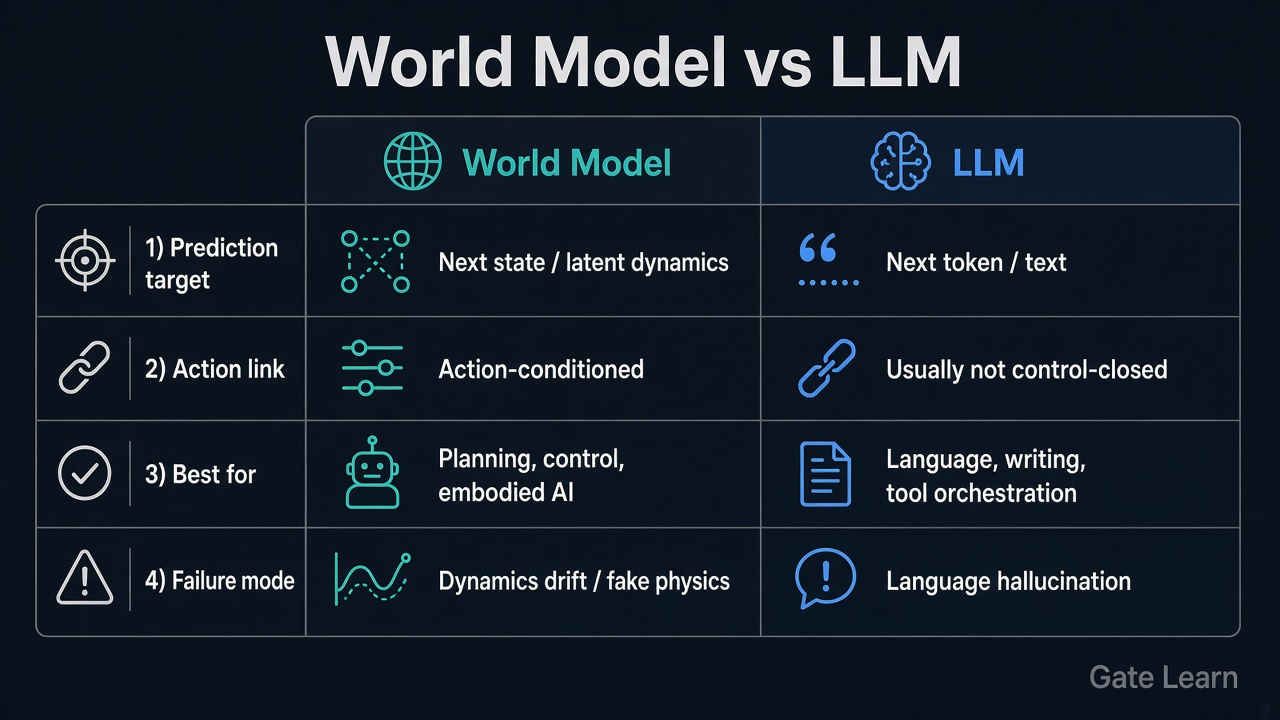
Рисунок 1. Сравнение моделей мира и LLM по четырём параметрам: цель прогнозирования, связь с действием, наиболее подходящие задачи и режим отказа.
JEPA и LLM часто смешивают. JEPA, например I-JEPA от Meta AI, прогнозирует абстрактные будущие представления в пространстве совместных эмбеддингов и ориентирована на модели мира. LLM остаются системами языкового моделирования. Похожие названия не означают взаимозаменяемость. См. глоссарий NVIDIA: модели мира и обсуждение подхода Лекуна (A Path Towards Autonomous Machine Intelligence).
Чем различаются данные, результаты и оценка?
Данные и оценка следуют из цели прогнозирования: модели мира опираются на интерактивные траектории, переходы состояний, управляющие сигналы и иногда видео; LLM — на корпуса текстов, данные инструкций и, при необходимости, журналы инструментов. Метрики ошибок определяются тем, как результаты используются в дальнейшем.
| Параметр |
Модель мира |
Большая языковая модель |
| Типичные данные |
Траектории «наблюдение — действие — следующее наблюдение / награда», иногда включая видео |
Текст, диалоги, код, следы использования инструментов |
| Основные результаты |
Следующее состояние, скрытая динамика, воображаемые траектории |
Текст, структурированные ответы, вызовы функций |
| Фокус оценки |
Ошибка на нескольких шагах, успешность задачи, устойчивость к OOD-данным |
Корректность, достоверность, формат и безопасность |
| Сложно выявляемые проблемы |
Правдоподобная на вид нереалистичная физика, накопление ошибки на длинном горизонте |
Связные галлюцинации, источники, не проходящие проверку |
Использование критерия «написать корректный абзац о физике» для сертификации модели мира или критерия «видео выглядит хорошо» для оценки контура управления LLM подменяет ось оценки. Сначала определите проверяемый результат, затем выбирайте семейство моделей.
Какие задачи лучше подходят моделям мира, а какие — LLM?
Начните с того, где возникает цена ошибки: в физике и управлении или в семантике и коммуникации. Для первого предпочтительнее модели мира, для второго — LLM. Если нужны оба свойства, используйте вариант «необходимо объединить», а не пытайтесь выбрать одного победителя.
| Условие задачи |
Предпочтительнее модель мира |
Предпочтительнее LLM |
Когда требуется объединение |
| Нужно явное прогнозирование «действие → следующее состояние» |
Да |
Нет |
— |
| Нужны интерфейс на естественном языке, генерация документации или кода |
Нет |
Да |
— |
| Планирование в физической среде, фильтрация неудачных траекторий до контакта, как в автономном вождении |
Да |
Нет, LLM может только объяснять |
LLM для инструкций, модель мира для моделируемой динамики |
| Q&A с дополненным поиском, написание текстов, оркестрация инструментов |
Нет |
Да |
— |
| Обучение политики в воображении (MBRL) |
Да |
Нет |
LLM может подготовить текст задачи, но для динамики всё равно нужна модель мира |
| Диалог для определения целей плюс исполняемый контур управления |
Одной модели недостаточно |
Одной модели недостаточно |
Необходимо объединить: LLM разбирает цели → модель мира / планировщик выполняет |
Вариант «необходимо объединить» соответствует распространённой схеме: LLM отвечает за намерение и интерфейс, а модель мира или симулятор с обученной динамикой — за прогнозирование последствий и фильтрацию траекторий. Исключение любой из сторон часто приводит к режиму отказа другой стороны.
Когда следует объединять оба подхода?
Объединяйте их, когда задача включает и цель на языковом уровне, и последствия на уровне среды. Не рассматривайте их как взаимозаменяемые решения. Типичная цепочка выглядит так: LLM преобразует цели в подцели или ограничения; модель мира моделирует возможные действия; планировщик выбирает траекторию с учётом затрат и безопасности; выполнение возвращает новое наблюдение, которое обновляет состояние.
Объединение — это не «соединение двух промптов». Интерфейсы должны быть явными: какие структурированные цели выдаёт LLM, какие действия принимает модель мира и как многошаговая ошибка запускает перепланирование или переход к консервативному варианту. Без такого соглашения системы выглядят как «связная речь, нарушенное движение» или «красивые траектории, несоответствующие инструкции».
Жёсткое объединение также плохо подходит, если для простого Q&A по документам модель мира почти не нужна или если низкоуровневое сервоприводное управление уже использует надёжную динамику и не нуждается в универсальной LLM. Ценность объединения определяется разделением задач, а не количеством моделей.
Какие ошибочные суждения и риски возникают при выборе?
Наиболее распространённые ошибки — считать, что «может говорить о физике» означает «может выполнять физическое моделирование», а «красивые кадры или траектории» означают «динамику, пригодную для планирования». Эти семейства моделей отказывают по-разному, а смешение критериев приёмки повышает риск при внедрении.
| Режим отказа |
Чаще встречается у |
Как проявляется |
Риск выбора |
Как выявить |
| Языковая галлюцинация |
LLM |
Связные, но неверные факты или источники |
Единственный источник знаний или «руководство» по управлению |
Требуйте происхождение данных, проверку инструментами и отклоняйте неподтверждённые утверждения |
| Дрейф динамики |
Модель мира |
Короткие шаги корректны, но длинные траектории искажаются |
Доверие к разомкнутому контуру на длинных горизонтах |
Постройте график ошибки в зависимости от горизонта, проверьте перепланирование |
| Нереалистичная физика |
Модель мира |
Плавные траектории, нарушающие контакт или законы сохранения |
Использование визуальных демонстраций в качестве физической приёмки |
Проверьте проникновение объектов, энергию и ограничения контакта |
| Использование LLM как симулятора |
Несоответствие выбора |
Текстовое описание заменяет переходы состояний |
Задачи в физической среде без контура с учётом действий |
Запросите интерфейс действий и моделируемое состояние |
| Использование модели мира как чат-движка |
Несоответствие выбора |
Принудительное применение прогнозирования состояния к Q&A поддержки |
Высокая стоимость, слабый языковой UX |
Уточните, является ли качество текста основной задачей |
Проверки рисков должны быть привязаны к условиям запуска: если задача в основном требует семантической корректности, сначала контролируйте галлюцинации; если она главным образом связана с последствиями управления, сначала контролируйте дрейф и нереалистичную физику. Описания возможностей не заменяют проверки приёмки.
Итоги
Модели мира и большие языковые модели решают разные задачи прогнозирования: первые ориентированы на последствия действий и динамику, пригодную для планирования, вторые — на язык и оркестрацию инструментов. При выборе определите, какая сторона несёт цену ошибки, затем используйте таблицу условий для отдельного применения или объединения.
Прогнозирование представлений в стиле JEPA ориентировано на модели мира и не является LLM. При приёмке отдельно проверяйте языковые галлюцинации и дрейф динамики / нереалистичную физику, чтобы одна демонстрация не скрывала другой режим отказа.
Часто задаваемые вопросы
В чём разница между моделью мира и большой языковой моделью?
Модель мира в основном прогнозирует следующее состояние или скрытую динамику после действия для планирования и управления, тогда как LLM в основном прогнозирует следующий токен для понимания и генерации языка, а также оркестрации инструментов. Обе модели могут «генерировать», но успех для них означает соответственно проверяемые последствия или пригодные семантику и формат.
Может ли модель мира заменить большую языковую модель?
Обычно нет. Модель мира не предоставляет естественным образом сильный языковой интерфейс или масштабную оркестрацию текста, а LLM не предоставляет естественным образом моделируемую динамику с учётом действий. Используйте LLM для языковых задач и добавляйте компоненты модели мира, когда задаче нужны последствия в среде.
Когда следует использовать модель мира?
Используйте систему, ориентированную на модель мира, когда задача должна прогнозировать следующее состояние по состоянию и действию, а затем планировать, управлять или мысленно проверять действия. Типичные случаи включают планирование в физической среде, обучение с подкреплением на основе модели и прогнозирование последствий на коротком горизонте. Для простого написания текстов или Q&A по документам это обычно не основной вариант.
Как связаны JEPA и LLM?
JEPA (Joint Embedding Predictive Architecture) прогнозирует будущие или замаскированные представления в пространстве эмбеддингов и относится к обучению представлений, связанному с моделями мира. LLM сосредоточены на прогнозировании следующего токена. Обе могут входить в стек агента, но их цели и метрики различаются: JEPA — не «ещё одна LLM».
Можно ли использовать оба подхода вместе?
Да. Для задач, сочетающих инструкции на естественном языке с выполнением действий в среде, объединение часто необходимо: LLM разбирает цели и ограничения, а модель мира или планировщик прогнозирует последствия и фильтрует траектории. Главное — чёткий интерфейс и условия запуска перепланирования, а не объединение обеих моделей в одном промпте.