Em 3 de novembro de 2026, a Binance divulgou uma Declaração de investigação preliminar sobre o incidente de segurança de 29 de outubro. A declaração revelou que os atacantes comprometeram os dispositivos de engenheiros com malware e utilizaram ferramentas internas de IA para expandir ainda mais o seu acesso. Segundo a declaração, o ataque envolveu, em última instância, o acesso não autorizado ao serviço interno de assinatura de carteiras, afetando aproximadamente 6,34 mil milhões de dólares em ativos digitais. No entanto, a declaração não revelou a arquitetura completa das ferramentas internas de IA, nem confirmou que o ataque explorou vulnerabilidades num modelo de linguagem de grande escala ou envolveu injeção de prompts.
Este incidente levanta uma questão importante de segurança empresarial: quando um Agente de IA pode aceder a mais ferramentas internas e sistemas sensíveis, como devem as empresas distinguir entre permissões de processamento de informações e permissões operacionais efetivas? Partindo da forma como os Agentes de IA chamam ferramentas, este artigo explica os limites de permissões, a injeção de prompts, a gestão de credenciais e os riscos de movimentação lateral, além de analisar os controlos de segurança que as empresas podem adotar.
Principais conclusões
-
Os Agentes de IA podem fazer mais do que gerar texto. Podem também executar código, ler ficheiros, aceder a API ou operar sistemas empresariais internos através de chamadas de ferramentas.
-
A declaração de investigação preliminar da Binance, divulgada em 3 de novembro de 2026, afirmou que os atacantes utilizaram dispositivos comprometidos de engenheiros e ferramentas internas de IA para obter mais acesso a dispositivos e permissões de outros engenheiros.
-
Um dos principais riscos de segurança dos Agentes de IA é converter informações provenientes de ambientes externos ou de baixa confiança em ações com privilégios de execução efetivos.
-
A injeção de prompts, os resultados maliciosos de ferramentas, as permissões excessivas e as fugas de credenciais podem agravar-se mutuamente. No entanto, nem todos os ataques que envolvem ferramentas de IA são ataques de injeção de prompts.
-
As empresas devem tratar os Agentes de IA como entidades de execução de software com identidades e permissões específicas, e controlar os riscos através do princípio do menor privilégio, do isolamento de ferramentas, da aprovação de operações e de mecanismos de auditoria.
Em que diferem os Agentes de IA dos chatbots de IA tradicionais?
Os chatbots de IA tradicionais realizam principalmente tarefas ao receber dados introduzidos pelo utilizador e gerar respostas de texto. Mesmo que um modelo possa fornecer código, analisar ficheiros ou explicar passos operacionais, em geral não consegue modificar diretamente uma base de dados empresarial, implementar uma aplicação ou chamar um serviço interno sem estar ligado a um ambiente de execução efetivo.
A diferença dos Agentes de IA é que conseguem ligar decisões geradas por modelos a ferramentas externas. Por exemplo, os programadores podem configurar um Agente com ferramentas de pesquisa de código, execução de terminal, consulta de bases de dados e gestão de repositórios Git. Quando um utilizador submete uma tarefa, o Agente pode primeiro obter ficheiros relevantes, chamar ferramentas para obter informações e, em seguida, decidir o que fazer com base nos resultados. Com as permissões adequadas, um Agente pode até criar commits de código, acionar testes ou executar processos de implementação.
Este modelo transforma um Agente de IA, de uma simples ferramenta de geração de informações, num sistema de software com determinadas capacidades operacionais. O próprio Agente pode não ter privilégios de administrador independentes, mas pode obter a capacidade de aceder a sistemas externos através da autorização do utilizador, de contas de serviço, de Tokens de API ou de outras credenciais de identidade.
Por conseguinte, a segurança dos Agentes de IA não pode ser avaliada apenas com base na exatidão das respostas do modelo. Mesmo que o conteúdo gerado pelo modelo não contenha erros evidentes, o Agente pode ainda realizar operações além das expectativas do utilizador se as permissões das suas ferramentas estiverem configuradas de forma inadequada. As empresas devem concentrar-se não só no que a IA gera, mas também no que a IA pode ler, no que pode chamar e nas operações que podem efetivamente alterar o estado do sistema.
Como chamam os Agentes de IA as ferramentas?
A chamada de ferramentas é um mecanismo importante através do qual os Agentes de IA interagem com sistemas externos. Normalmente, os programadores fornecem ao modelo os nomes, as descrições funcionais e as estruturas de parâmetros das ferramentas disponíveis. O modelo determina então se deve chamar uma determinada ferramenta com base na tarefa atual. A execução efetiva é geralmente realizada pelo ambiente de execução ou pela aplicação do Agente, após o que os resultados da ferramenta são fornecidos ao modelo para processamento adicional.
Por exemplo, um Agente interno de desenvolvimento empresarial pode conseguir ler repositórios de código, consultar registos de erros e executar testes. Quando um utilizador pede que investigue um problema num serviço, o Agente pode chamar uma ferramenta de consulta de registos para localizar o problema, ler o código relevante e gerar recomendações de alteração. Se a empresa também conceder permissões de escrita de código ou de implementação, o Agente pode passar de fornecer assistência analítica para realizar operações efetivas.
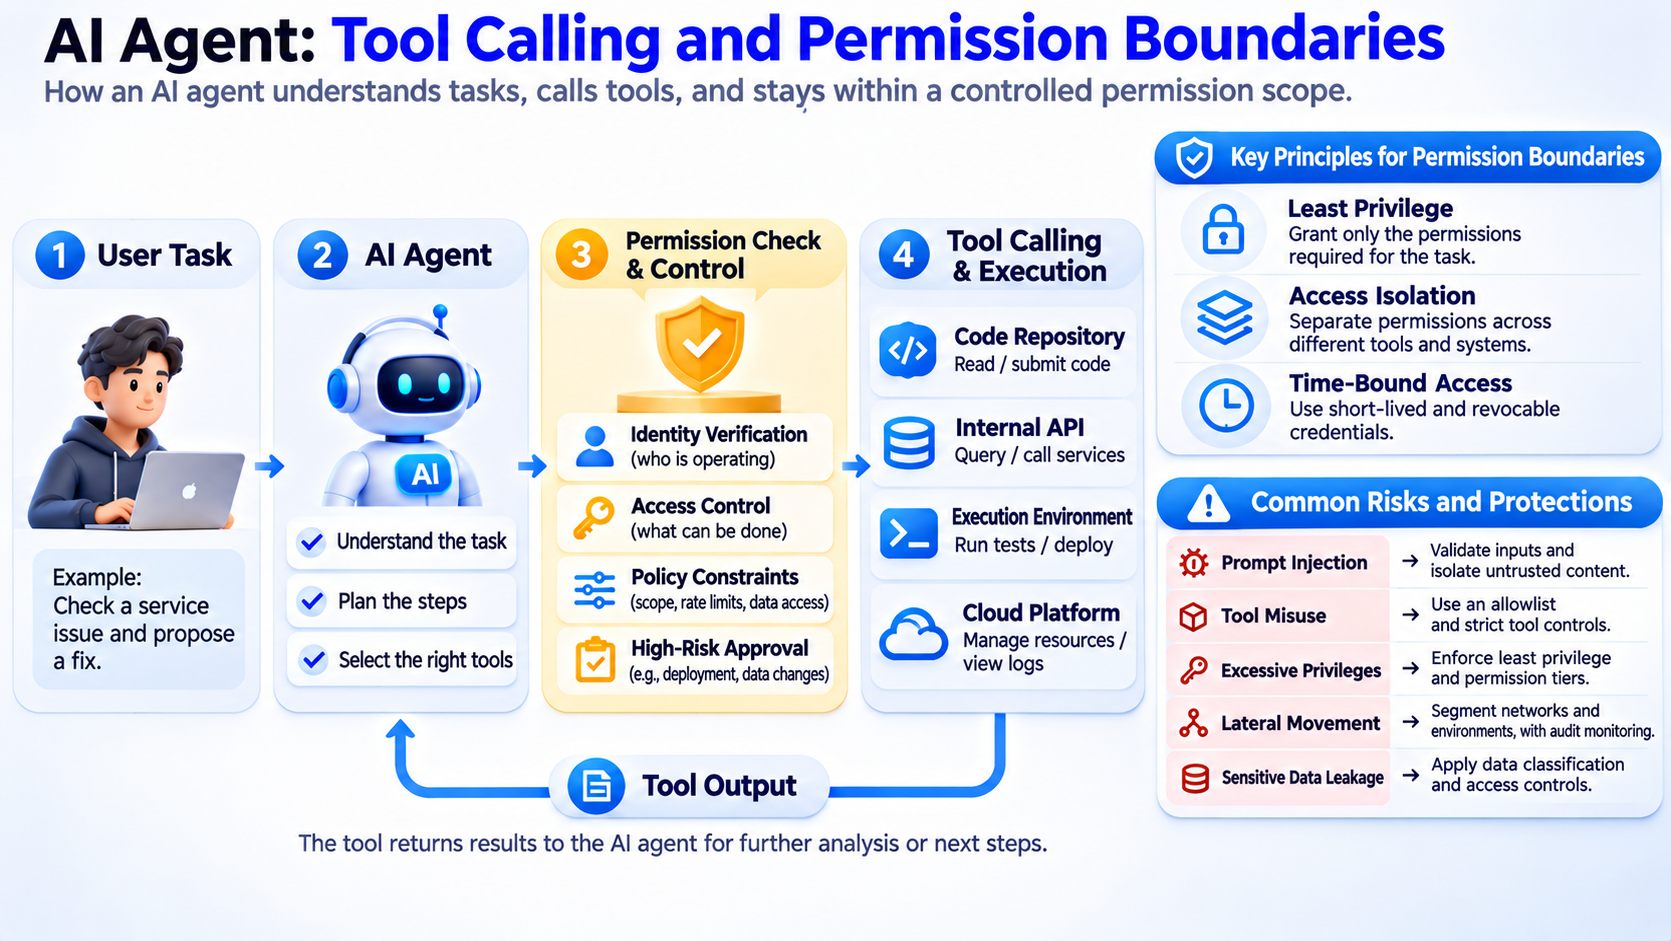
Os riscos das chamadas de ferramentas provêm principalmente de duas áreas.
-
O Agente pode receber permissões de execução excessivas. Por exemplo, pode necessitar apenas de ler registos, mas também ter a capacidade de modificar configurações do ambiente de produção.
-
O Agente pode processar conteúdo não fidedigno proveniente de páginas Web externas, comentários de código, e-mails ou resultados de ferramentas. Se o sistema não distinguir adequadamente este conteúdo da autorização efetiva do utilizador, as informações externas podem influenciar chamadas de ferramentas subsequentes.
Isto significa que as empresas não podem simplesmente tratar as chamadas de ferramentas geradas pelo modelo como operações fidedignas. Todas as chamadas de ferramentas que envolvam dados sensíveis ou alterações ao sistema exigem uma verificação independente de permissões. O modelo pode submeter um pedido de execução, mas a decisão sobre se o pedido é permitido deve ser determinada por políticas de segurança explícitas.
Porque podem os Agentes de IA expandir a superfície de ataque de uma empresa?
Os sistemas de segurança empresariais tradicionais estabelecem geralmente controlos de acesso em torno das identidades dos funcionários, servidores, aplicações e limites de rede. Diferentes funcionários têm diferentes permissões de sistema, enquanto os serviços críticos podem restringir o acesso através de credenciais e regras de rede separadas. Quando os Agentes de IA se ligam a sistemas empresariais, criam efetivamente novos percursos de acesso automatizado.
Por exemplo, um Agente de desenvolvimento pode ligar-se simultaneamente a um repositório Git, a uma base de conhecimentos interna, a uma plataforma de cloud e a um sistema de gestão de tarefas. Para concluir tarefas entre sistemas, os programadores podem configurar vários Tokens de API ou contas de serviço. Se estas credenciais não forem rigorosamente restringidas, um atacante que obtenha controlo do ambiente de execução do Agente ou da identidade relacionada poderá utilizar estas capacidades de acesso para chegar a mais sistemas.
Outra questão é a velocidade operacional. Os funcionários normalmente precisam de iniciar sessão manualmente em várias plataformas para concluir uma série de operações, enquanto um Agente de IA pode chamar ferramentas continuamente num curto período. A automatização não é inerentemente insegura. No entanto, sem limites de taxa, deteção de anomalias e aprovação para operações de alto risco, instruções erradas ou maliciosas podem ser executadas rapidamente.
Por conseguinte, os Agentes de IA expandem não só o número de interfaces de software, mas também as relações de permissões que ligam diferentes sistemas. As empresas precisam de avaliar a que recursos cada Agente pode aceder, se pode atravessar diferentes domínios de segurança e se existem percursos de ferramentas de baixo risco para sistemas de alto risco.
Porque pode a injeção de prompts afetar as chamadas de ferramentas dos Agentes de IA?
A injeção de prompts refere-se a um ataque em que um atacante introduz conteúdo semelhante a instruções em dados que um modelo pode ler, tentando alterar a tarefa que o modelo deve executar. Para chatbots comuns, estes ataques podem resultar em respostas incorretas ou divulgação de informações. Para Agentes de IA com capacidades de chamada de ferramentas, também podem afetar operações efetivas.
Por exemplo, uma empresa pode utilizar um Agente de IA para organizar automaticamente relatórios de problemas num repositório de código. Se um atacante puder controlar o conteúdo de um relatório, poderá inserir instruções disfarçadas de requisitos de manutenção do sistema, induzindo o Agente a ler ficheiros adicionais ou a chamar ferramentas não relacionadas. O risco real não reside no facto de o Agente ler o relatório, mas em saber se trata o conteúdo não fidedigno do relatório como uma instrução com autoridade de execução.
Estes ataques são geralmente conhecidos como injeção indireta de prompts. Um atacante não precisa de enviar comandos diretamente ao utilizador do Agente. Em vez disso, pode influenciar o Agente através de páginas Web, documentos, comentários de código, resultados de pesquisa ou resultados de ferramentas. A OWASP enumera a injeção de prompts, o abuso de ferramentas, a escalada de privilégios e a divulgação de informações sensíveis como riscos de segurança importantes para os Agentes de IA.
No entanto, a injeção de prompts deve ser distinguida dos ataques tradicionais de malware. Se um atacante já tiver assumido o controlo do computador de um engenheiro através de código malicioso e utilizar depois credenciais existentes para aceder a sistemas internos, o facto de o percurso de ataque ter envolvido uma ferramenta de IA não significa necessariamente que ocorreu injeção de prompts. Os dois mecanismos podem surgir em conjunto, mas são tecnicamente diferentes.
Que riscos relativos às ferramentas de IA e à gestão de permissões revela o incidente de segurança da Binance?
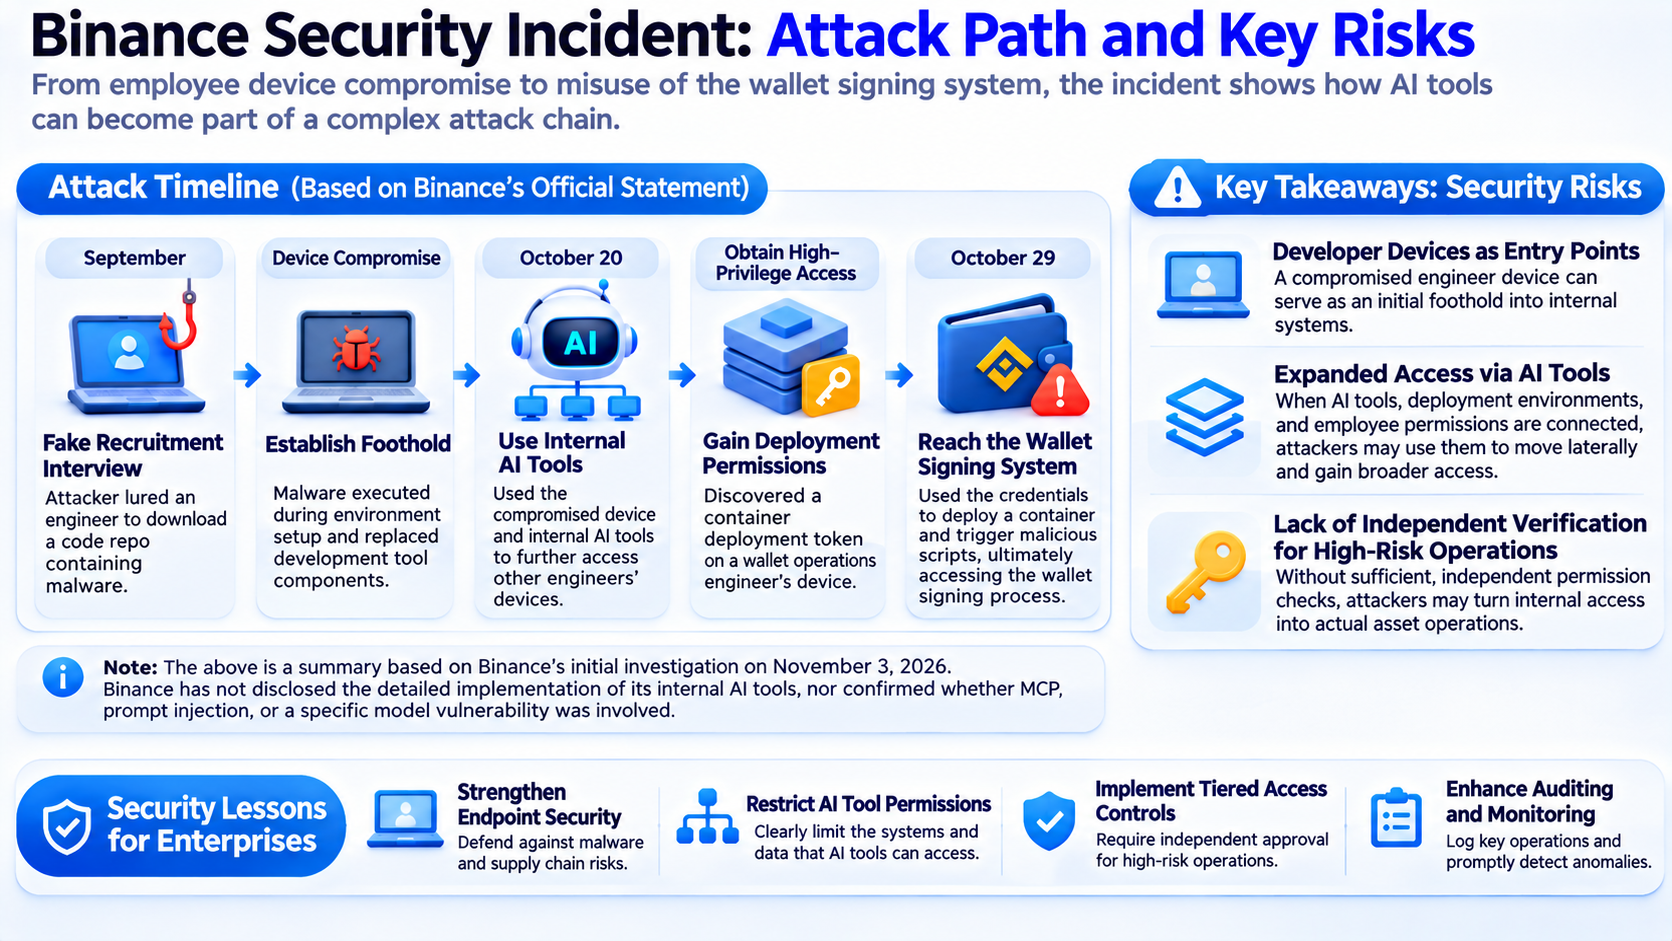
Na sua declaração de investigação preliminar divulgada em 3 de novembro de 2026, a Binance revelou um ataque em várias fases que progrediu desde o comprometimento de um dispositivo de funcionário até ao abuso do sistema interno de assinatura de carteiras. Segundo a declaração, em setembro, os atacantes induziram um engenheiro de software a descarregar um repositório com código malicioso através de uma falsa entrevista de emprego. O código malicioso foi executado durante a configuração do ambiente e estabeleceu canais de comunicação controlados pelos atacantes ao substituir componentes de ferramentas de desenvolvimento e utilizar outros métodos.
Em 20 de outubro, os atacantes utilizaram o computador de um engenheiro comprometido e ferramentas internas de IA para assumir o controlo dos dispositivos de engenheiros adicionais. Descobriram também um Token de permissão de implementação de contentores no dispositivo de um engenheiro de operações de carteiras. Em 29 de outubro, os atacantes utilizaram as credenciais relevantes para implementar contentores e acionar scripts maliciosos, chegando, por fim, ao processo de operação de assinatura de carteiras.
Numa perspetiva de arquitetura de segurança, este incidente reflete pelo menos três questões que merecem estudo. Em primeiro lugar, os dispositivos dos programadores podem tornar-se pontos de entrada em sistemas internos de elevado valor. Em segundo lugar, quando ferramentas internas de IA, ambientes de implementação e permissões de funcionários estão ligados, os atacantes podem explorar estas ligações para expandir o seu acesso. Por último, se as operações de alto risco não dispuserem de verificação independente de permissões suficiente, os atacantes podem converter as permissões internas que obtêm na capacidade de realizar operações efetivas sobre ativos.
É importante salientar que a Binance não revelou a implementação específica das suas ferramentas internas de IA. Por conseguinte, é impossível confirmar se as ferramentas eram Agentes de IA com capacidades de planeamento autónomo ou concluir que o ataque envolveu MCP, injeção de prompts ou uma vulnerabilidade num modelo específico. O incidente mostra que as ferramentas de IA podem fazer parte de um percurso de ataque complexo, mas não prova, por si só, que um Agente de IA tenha sido a causa principal do ataque.
Qual é o limite de permissões de um Agente de IA? Porque é o princípio do menor privilégio tão importante?
Um limite de permissões define a que recursos uma entidade de software pode aceder, que operações pode realizar e em que condições pode obter permissões adicionais. Para um Agente de IA, o limite de permissões envolve não só o próprio modelo, mas também o ambiente de execução do Agente, as interfaces de ferramentas, a identidade do utilizador, as contas de serviço e os sistemas externos.
O princípio do menor privilégio exige que um sistema conceda apenas as permissões necessárias para concluir a tarefa atual. Por exemplo, um Agente responsável por analisar registos de servidores normalmente necessita apenas de acesso a dados de registo específicos. Não deve poder eliminar automaticamente bases de dados, modificar ambientes de produção ou transferir ativos digitais. Se uma tarefa exigir efetivamente uma operação de alto risco, o Agente deve obter uma permissão temporária através de um mecanismo de autorização independente.
A OWASP enumera a autonomia excessiva como um risco importante em aplicações de modelos de linguagem de grande escala. A questão central não é o facto de o modelo ter capacidades de chamada de ferramentas, mas sim o sistema ter atribuído ao modelo funções desnecessárias, permissões excessivas ou capacidades autónomas de operação sem restrições. Quando o modelo é influenciado por dados introduzidos incorretos, injeção de prompts ou resultados maliciosos de ferramentas, estas permissões podem aumentar os danos potenciais.
Por conseguinte, as empresas precisam de colocar as verificações de permissões num ambiente de execução fidedigno, em vez de apenas dizer ao Agente através de um prompt de sistema para não realizar operações perigosas. Mesmo que um modelo peça incorretamente acesso a uma ferramenta sensível, o serviço de backend deve conseguir rejeitar o pedido não autorizado com base na identidade, no âmbito do recurso e no tipo de operação.
Que novos desafios de segurança podem criar protocolos de ligação de ferramentas como o MCP?
O Model Context Protocol (MCP) é um protocolo aberto para ligar aplicações de IA a ferramentas externas e recursos de dados. Através do MCP, os programadores podem ligar Agentes de IA a sistemas de ficheiros, bases de dados, repositórios de código e outros serviços sem terem de conceber um método de integração totalmente diferente para cada ferramenta.
Este método de ligação normalizado pode melhorar a eficiência de desenvolvimento, mas também significa que os Agentes podem aceder mais facilmente a vários sistemas externos. Se uma empresa não gerir os Servidores MCP, as definições de ferramentas e as permissões de acesso, poderá enfrentar problemas como permissões de ferramentas excessivas, descrições de ferramentas maliciosas, serviços de terceiros comprometidos ou exposição acidental de informações sensíveis.
Por exemplo, um Agente de desenvolvimento pode precisar de ler um repositório de código, mas não necessita de aceder ao sistema de pagamentos da empresa. Se ambos os tipos de ferramentas estiverem configurados no mesmo ambiente de execução e utilizarem credenciais partilhadas com permissões de alto nível, um Agente originalmente destinado a ajudar no desenvolvimento pode obter capacidades operacionais não relacionadas com a sua tarefa.
A OWASP recomenda estabelecer um mecanismo de auditoria para os Servidores MCP ligados a ferramentas de programação de IA, restringir as ferramentas que podem ser chamadas e verificar se as definições das ferramentas contêm instruções maliciosas. Os Agentes que executam código devem também utilizar medidas como sandboxing, restrições de acesso à rede e gestão independente de credenciais.
O MCP, por si só, não constitui uma vulnerabilidade de segurança. O que deve ser avaliado é a implementação das ferramentas, a autenticação, a configuração das permissões e a forma como o conteúdo externo afeta o comportamento do Agente após a ligação do protocolo.
Como devem as empresas proteger as identidades e as permissões de acesso dos Agentes de IA?
As empresas devem começar por estabelecer um sistema de identidade identificável e auditável para os Agentes de IA. As aplicações tradicionais utilizam normalmente contas de serviço ou Chaves de API para aceder a outros sistemas. No entanto, as operações dos Agentes de IA podem envolver simultaneamente autorização de utilizadores, tarefas automatizadas e várias ferramentas. Por conseguinte, as empresas precisam de distinguir claramente entre a identidade do utilizador, a identidade do Agente e as permissões de execução efetivas.
Por exemplo, o facto de um funcionário pedir a um Agente para obter um relatório interno não significa que o Agente possa utilizar a sua conta de serviço para ler outros ficheiros aos quais o funcionário não está autorizado a aceder. Uma conceção de autorização adequada deve verificar tanto se o utilizador que efetua o pedido está autorizado a aceder ao recurso-alvo como se o Agente tem permissão para realizar a operação correspondente. Isto ajuda a impedir que o Agente contorne os controlos de acesso existentes porque o seu serviço de proxy tem privilégios mais elevados.
Em fevereiro de 2026, o National Cybersecurity Center of Excellence (NCCoE), integrado no National Institute of Standards and Technology (NIST), publicou um documento conceptual sobre a identidade e autorização de software e Agentes de IA. O documento abordou questões como o reconhecimento da identidade do Agente, a autenticação, a autorização, as credenciais temporárias, as permissões delegadas e a auditoria. Isto reflete a forma como a segurança dos Agentes de IA está a expandir-se dos controlos de saída do modelo para um quadro completo de gestão de identidades e acessos.
Em implementações efetivas, as empresas podem utilizar credenciais de acesso de curta duração e restringir as permissões a tarefas, recursos e períodos específicos. Também devem ser exigidas aprovação independente e verificação secundária para atividades de alto risco, como implementações em produção, operações financeiras e alterações de permissões. Desta forma, mesmo que o ambiente de execução do Agente seja comprometido, um atacante poderá não conseguir obter diretamente credenciais de longa duração e com privilégios elevados.
Como podem as empresas reduzir os riscos de segurança das chamadas de ferramentas dos Agentes de IA?
As empresas podem estabelecer salvaguardas em quatro áreas: permissões de ferramentas, ambientes de execução, operações sensíveis e monitorização de comportamentos.
-
As empresas devem restringir as ferramentas que um Agente pode utilizar com base nos requisitos empresariais. Um Agente que apenas obtém informações não necessita de capacidades arbitrárias de execução de código, e um Agente utilizado para revisão de código não deve receber automaticamente permissões de implementação em produção. Para ferramentas com capacidades de escrita, as empresas podem restringir adicionalmente os caminhos de ficheiros, as tabelas de bases de dados, os tipos de operação de API e os âmbitos de acesso.
-
As ferramentas de alto risco devem ser executadas em ambientes isolados. A execução de código, a instalação de pacotes de terceiros e o processamento de páginas Web externas podem introduzir conteúdo não fidedigno. Por conseguinte, as empresas podem utilizar contentores ou outras tecnologias de sandbox para restringir o acesso a sistemas de ficheiros, redes e recursos de sistema. O isolamento reduz a probabilidade de um ataque a uma única ferramenta afetar outros sistemas.
-
As empresas devem exigir aprovação humana para operações irreversíveis. Operações como eliminar dados importantes, modificar permissões, implementar serviços de produção ou transferir ativos não devem ser concluídas automaticamente apenas porque o Agente determina que a tarefa é razoável. As orientações de segurança do Agent Framework da Microsoft também recomendam determinar se é necessária confirmação humana com base no impacto, na sensibilidade dos dados e na reversibilidade da operação.
-
Por último, as empresas precisam de estabelecer mecanismos de auditoria contínua que registem quais as ferramentas utilizadas pelo Agente, a que recursos acedeu, se ocorreram pedidos de permissões anómalos e se os resultados efetivos da execução corresponderam à tarefa autorizada. Para chamadas de ferramentas repetidamente falhadas, acesso anómalo a dados e um grande número de operações num curto período, as empresas podem combinar deteção baseada em regras com análise comportamental para identificar riscos potenciais.
| Medida de segurança |
Função principal |
| Menor privilégio |
Restringir as ferramentas e os recursos a que o Agente pode aceder |
| Aprovações de chamadas de ferramentas |
Impedir a realização de operações de alto risco sem confirmação |
| Isolamento por sandbox |
Reduzir o impacto de código malicioso ou abuso de ferramentas |
| Credenciais de acesso temporárias |
Reduzir o risco de exposição de credenciais a longo prazo |
| Validação de entradas e saídas |
Reduzir o risco de conteúdo malicioso afetar a execução de ferramentas |
| Auditoria comportamental |
Detetar chamadas anómalas e utilização de permissões |
Estas medidas não conseguem garantir a eliminação completa dos riscos de segurança dos Agentes de IA. No entanto, podem reduzir o âmbito do impacto após um ataque bem-sucedido e aumentar a probabilidade de os comportamentos anómalos serem detetados e resolvidos.
Porque está a segurança dos Agentes de IA a tornar-se uma questão importante para a infraestrutura Web3?
A combinação de Agentes de IA e infraestrutura de blockchain atribui implicações mais diretas à chamada de ferramentas e à gestão de permissões para a segurança dos ativos. Em cenários empresariais tradicionais, um Agente pode executar código, enviar e-mails ou modificar uma base de dados. Em cenários Web3, um Agente pode também ligar-se a carteiras, consultar ativos on-chain, chamar contratos inteligentes ou iniciar pedidos de transação.
Por exemplo, um Agente utilizado para gerir automaticamente ativos on-chain pode necessitar de consultar saldos, analisar o mercado e fornecer recomendações de negociação com base nas definições do utilizador. Se também receber capacidades de assinatura de transações ou de chamada de contratos inteligentes, as empresas devem definir claramente quais as operações que podem ser executadas automaticamente, quais exigem confirmação do utilizador e como limitar o montante por transação, o âmbito dos ativos e o período de validade da autorização.
Neste processo, as Chaves de sessão, as contas inteligentes e os mecanismos de autorização granulares podem fornecer diferentes formas de gestão de permissões. No entanto, a sua segurança específica depende da forma como são implementados. As Chaves de sessão podem limitar determinadas permissões operacionais a um período ou âmbito específico, enquanto as contas inteligentes podem restringir o comportamento das transações através de regras de contrato. Ainda assim, podem surgir riscos de segurança se as condições de autorização forem demasiado amplas, a lógica de validação contiver falhas ou o ambiente de execução for comprometido.
Por conseguinte, o desenvolvimento de Agentes de IA Web3 não pode concentrar-se apenas na eficiência da negociação automatizada ou dos pagamentos on-chain. Deve também abordar a verificação de identidade, a delegação de permissões, as aprovações de transações e a revogação de autorizações. Para sistemas de IA ligados a ativos reais, o limite de segurança deve abranger todo o processo, desde as decisões do modelo até às chamadas de ferramentas, à construção de transações, à verificação de assinaturas e à execução on-chain.
Conclusão
Os Agentes de IA estão a mudar a forma como as empresas utilizam a inteligência artificial. À medida que os modelos se ligam a repositórios de código, API internas, bases de dados e ferramentas de automatização, os sistemas de IA deixam de ser meros pontos de entrada para o processamento de informações. Estão a tornar-se cada vez mais entidades de execução de software com capacidades operacionais efetivas.
A investigação preliminar da Binance sobre o incidente de segurança divulgada em 3 de novembro de 2026 indica que ferramentas internas de IA podem ter surgido num percurso de ataque complexo. No entanto, as informações disponíveis são insuficientes para provar que o incidente foi diretamente causado por uma vulnerabilidade de um Agente de IA ou por injeção de prompts. A lição mais importante é que as empresas precisam de reavaliar as relações de acesso entre ambientes de desenvolvimento, ferramentas de automatização e sistemas com privilégios elevados.
No futuro, a segurança dos Agentes de IA dependerá não só de os modelos conseguirem identificar instruções maliciosas, mas também de as empresas conseguirem estabelecer mecanismos fiáveis de autenticação de identidade, menor privilégio, isolamento de ferramentas e aprovação independente. Só separando adequadamente as capacidades de tomada de decisão da IA das permissões de execução efetivas poderão as empresas controlar os riscos potenciais enquanto melhoram a eficiência da automatização.
Perguntas frequentes
Porque têm os Agentes de IA mais riscos de segurança do que os chatbots comuns?
Os Agentes de IA podem aceder a dados empresariais, executar código ou modificar sistemas através de chamadas de ferramentas. Em comparação com os chatbots que apenas geram texto, os seus erros ou comportamentos manipulados podem ter consequências operacionais reais.
O que é a chamada de ferramentas de um Agente de IA?
A chamada de ferramentas refere-se ao pedido de um Agente de IA para que um programa ou serviço externo realize uma operação com base nos requisitos de uma tarefa, como consultar uma base de dados, ler um ficheiro, chamar uma API ou executar código.
A injeção de prompts consegue sempre controlar um Agente de IA?
Não necessariamente. O êxito da injeção de prompts depende da conceção do sistema, do comportamento do modelo e dos controlos de segurança. Mesmo que um atacante influencie a saída do modelo, a verificação independente de permissões pode impedir operações de ferramentas não autorizadas.
O incidente de segurança da Binance prova que os Agentes de IA têm vulnerabilidades?
Não. A investigação preliminar da Binance confirmou que o percurso de ataque envolveu ferramentas internas de IA, mas não revelou provas técnicas suficientes para estabelecer a existência de uma vulnerabilidade de um Agente de IA ou de injeção de prompts.
O MCP aumenta os riscos de segurança dos Agentes de IA?
O MCP pode ajudar as aplicações de IA a ligarem-se a ferramentas externas, mas os principais riscos de segurança provêm da implementação das ferramentas, das permissões de acesso e do tratamento de conteúdo não fidedigno. Uma autenticação adequada, a auditoria de ferramentas e as restrições de permissões podem reduzir estes riscos.
Como devem as empresas restringir as permissões dos Agentes de IA?
As empresas podem utilizar o princípio do menor privilégio, credenciais temporárias específicas para tarefas, aprovações independentes de operações, isolamento por sandbox e auditoria de chamadas de ferramentas para garantir que os Agentes só conseguem realizar operações explicitamente autorizadas.







