Introduction
Au cours des dernières années, la trajectoire de l’industrie de l’IA s’est imposée avec évidence : des modèles plus grands, un entraînement plus rapide et des capacités plus puissantes, se traduisant finalement par des applications produits plus larges.
Mais à mesure que les modèles investissent le raisonnement complexe, le développement de code, les opérations web et les workflows d’Agent, l’industrie se trouve confrontée à une nouvelle question, jusqu’ici moins présente : Le développement de l’IA doit-il toujours aller plus vite ?
Il ne s’agit pas simplement de « soutenir l’IA » ou de « s’opposer à l’IA ». Ce qui change, c’est la nature du risque.
Les problèmes associés aux débuts de l’IA se concentraient principalement au niveau des résultats : hallucinations, erreurs factuelles, biais et réponses inexactes. Une fois l’erreur identifiée, les utilisateurs pouvaient généralement reformuler leur demande, vérifier manuellement la réponse ou l’ignorer. Mais lorsque l’IA peut appeler des outils, modifier du code, accéder à des systèmes externes ou exécuter en continu des tâches complexes, les erreurs ne restent plus confinées à une fenêtre de discussion. Elles peuvent se traduire par des actions concrètes dans le monde réel.
OpenAI a déclaré publiquement en août 2026 qu’à mesure que les capacités des modèles progressent, les risques associés à leur développement et à leurs tests internes augmentent eux aussi. L’entreprise a donc temporairement ralenti l’extension de certaines capacités de pointe, tout en renforçant la surveillance, l’alignement et les mesures de confinement. L’évaluation ultérieure d’Astra par OpenAI a également conclu que ses capacités en cybersécurité avaient atteint le seuil critique dans le cadre interne de préparation de l’entreprise. Des mesures de protection renforcées étaient donc nécessaires avant sa commercialisation.
Parallèlement, le dernier rapport de renseignement sur les menaces d’Anthropic illustre une évolution encore plus concrète : l’IA est utilisée à mauvais escient pour mener des cyberattaques, effectuer de la surveillance, commettre des fraudes, conduire des opérations d’influence et assister la recherche biologique. À mesure que les capacités des modèles progressent, les attaquants augmentent la vitesse, l’ampleur et la sophistication de leur recours à l’IA.
C’est pourquoi la prudence en matière d’IA ne peut plus se résumer à l’ajout de quelques invites de sécurité à un modèle. Nous devons repenser l’ensemble du cycle de vie de l’IA, de l’entraînement au déploiement.
Points clés à retenir
-
Plus l’IA devient performante, plus les erreurs et les utilisations abusives sont susceptibles de passer de problèmes liés aux résultats à des risques d’actions concrètes
-
Le développement des modèles de pointe ne se limite plus à la vitesse d’entraînement : il intègre désormais l’évaluation, la surveillance, l’isolation et les seuils de sécurité
-
L’émergence des Agents fait évoluer le risque lié à l’IA : il ne s’agit plus seulement de « fournir une mauvaise réponse », mais de « prendre une mauvaise décision »
-
Ce que les entreprises doivent réellement contrôler, ce n’est pas le fait d’utiliser ou non l’IA, mais les autorisations qui lui sont accordées, les systèmes auxquels elle peut accéder et les moments où elle peut agir de manière autonome
-
Un développement plus prudent ne signifie pas mettre fin à l’innovation ; il s’agit d’aligner la croissance des capacités sur celle des capacités de sécurité
-
La prochaine phase de la compétition dans l’IA pourrait dépendre non seulement des capacités des modèles, mais aussi de l’acteur capable de construire les systèmes les plus stables en matière de contrôle, d’évaluation et de gouvernance
La question du développement de l’IA passe de « Est-ce possible ? » à « Quand faut-il le faire ? »
Aux débuts de l’industrie de l’IA, la question centrale était de savoir si un modèle pouvait accomplir une tâche donnée. Pouvait-il écrire du code, réussir un examen, résumer un document, comprendre une image ou effectuer un raisonnement mathématique complexe ? Les principaux critères étaient la précision, les performances aux benchmarks et les taux de réalisation des tâches.
Mais à mesure que les modèles de pointe sont entrés dans une phase plus complexe, ces critères ont commencé à montrer leurs limites.
La capacité d’un modèle à accomplir une tâche ne signifie pas qu’il doit être déployé immédiatement dans un environnement réel. Les systèmes réels impliquent des autorisations complexes, des dépendances externes et des conséquences irréversibles. Un modèle peut être limité dans un sandbox lorsqu’il accomplit une tâche en laboratoire. Mais une fois déployé au sein d’un système d’entreprise, il peut accéder à de véritables bases de données, interfaces de paiement, référentiels de code et informations internes.
Le développement de l’IA entre donc dans une nouvelle phase : les capacités du modèle doivent être dissociées des conditions de déploiement.
Cette évolution se reflète également dans les documents de sécurité récemment publiés par OpenAI. L’entreprise évalue non seulement « ce qu’un modèle peut faire », mais aussi s’il a atteint certains seuils de capacités à haut risque et si des mesures de protection suffisantes existent pour les contrôler. Dans son explication publique consacrée à Astra, OpenAI identifie explicitement les capacités en cybersécurité comme une capacité critique nécessitant un niveau de protection supérieur.
Le rythme du développement de l’IA n’est donc plus seulement une question d’ingénierie. C’est aussi un enjeu d’ingénierie de la sécurité, de gouvernance et de capacité organisationnelle.
Que se passe-t-il lorsque l’IA passe de la réponse aux questions à l’exécution de tâches ?
C’est le point essentiel pour comprendre le débat actuel sur la prudence en matière d’IA.
Lorsqu’un modèle de discussion classique fournit une réponse incorrecte, les utilisateurs peuvent généralement encore identifier le problème.
Mais si un Agent a accès à un navigateur, à un environnement d’exécution de code, à une base de données, à un système de messagerie électronique ou à une plateforme cloud, il peut effectuer plusieurs étapes sans confirmation supplémentaire.
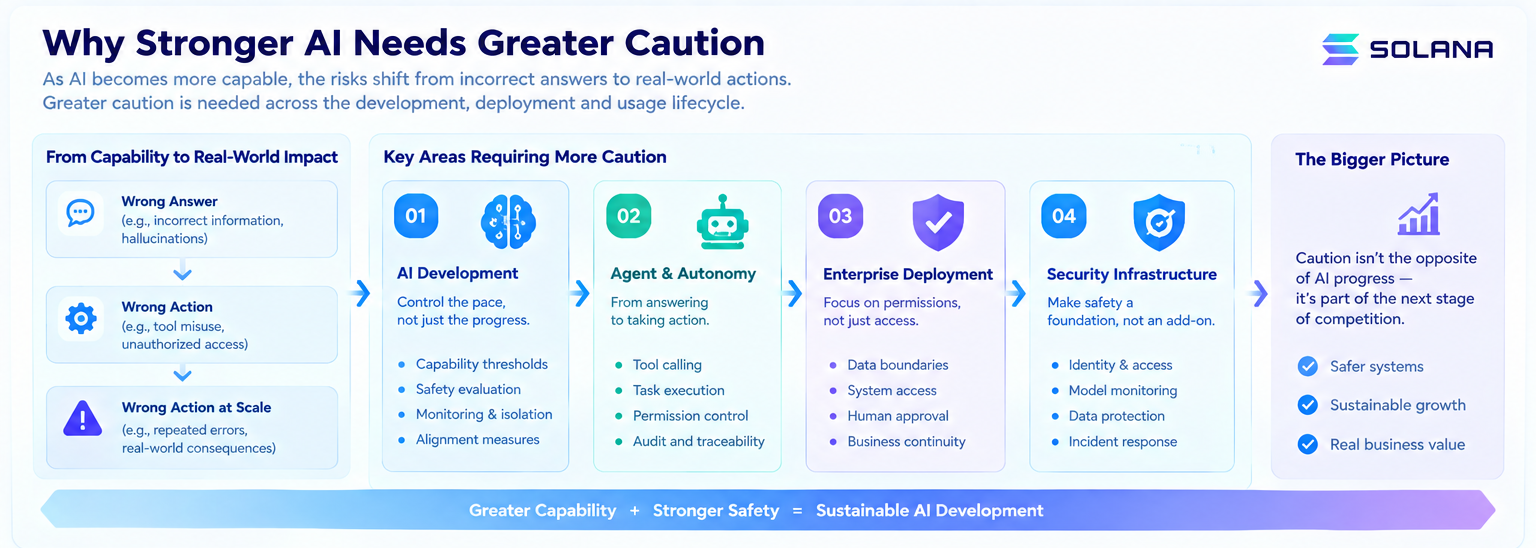
La portée d’une erreur change donc :
-
Auparavant : Mauvaise réponse
-
Aujourd’hui, elle peut devenir : Mauvaise action
-
Elle peut même devenir : Mauvaise action à grande échelle
Cette évolution est cruciale.
Dans les systèmes réels, le scénario le plus dangereux n’est pas nécessairement celui où un modèle commet une seule erreur. C’est celui où il peut répéter la même erreur de nombreuses fois en peu de temps.
L’analyse menée par OpenAI sur de récents incidents de sécurité liés aux modèles a souligné qu’à mesure que les systèmes d’IA deviennent plus autonomes, un comportement mal aligné peut entraîner un accès non autorisé à de véritables systèmes tiers ainsi que d’autres conséquences dans le monde réel.
Le dernier rapport d’Anthropic fournit des exemples plus précis : des attaquants ont utilisé Claude pour développer des outils cyber, construire des systèmes de surveillance, développer des logiciels malveillants et mener d’autres activités à haut risque. Ils ont également tenté de contourner les mesures de protection en divisant les tâches, en utilisant des services proxy et en combinant plusieurs modèles.
L’attention portée à la sécurité de l’IA se déplacera donc de plus en plus de « ce que dit le modèle » vers « ce que le modèle peut faire ».
L’importance de la gestion des autorisations, des appels d’outils, de l’audit des activités, des limites de tâches, de la confirmation humaine et de la surveillance en temps réel augmentera en conséquence.
Pourquoi un « développement plus rapide » ne signifie pas nécessairement une « progression plus rapide de l’IA »
À première vue, la compétition dans l’industrie de l’IA semble suivre une trajectoire unique : celui qui entraîne ses modèles le plus rapidement peut lancer plus tôt un modèle plus puissant.
Mais la véritable vitesse de R&D doit être envisagée selon deux variables : vitesse d’évolution des capacités + vitesse d’évolution de la sécurité
Autrement dit : la vitesse de croissance des capacités + la vitesse de croissance des capacités de sécurité
Si la croissance des capacités continue de s’accélérer sans augmentation correspondante des capacités de sécurité, les entreprises pourraient finalement devoir rattraper leur retard à un stade beaucoup plus avancé.
Par exemple, un modèle peut déjà disposer de puissantes capacités cyber alors que son système de surveillance ne sait identifier que des attaques simples. Un Agent peut être capable d’exécuter des dizaines d’étapes alors que son système d’autorisations repose encore sur la logique d’un chatbot classique. Un modèle peut déjà posséder de solides capacités de raisonnement scientifique alors que son système d’évaluation repose encore principalement sur des benchmarks traditionnels de questions-réponses.
Dans de telles circonstances, l’augmentation des capacités d’un modèle ne signifie pas nécessairement que le système est prêt à être déployé dans un environnement réel plus vaste.
La déclaration publique d’OpenAI en août en constitue un exemple typique. Alors que les risques de sécurité associés à Astra augmentaient, l’entreprise a indiqué qu’elle devait temporairement ralentir son expansion afin de se donner le temps de renforcer ses capacités de surveillance, d’alignement et de sécurité.
Ralentir ne traduit donc pas nécessairement un échec technique.
Dans certains cas, cela peut même signaler qu’un système de R&D entre dans une phase plus mature : les équipes de développement commencent à reconnaître que la croissance des capacités ne peut pas remplacer une infrastructure de sécurité.
Ce que l’utilisation de l’IA doit réellement contrôler, ce sont les « autorisations », et non l’« accès »
Lorsqu’elles déploient l’IA, les entreprises se demandent le plus souvent si elles doivent l’utiliser.
Mais cette question est trop générale. Des questions plus pertinentes sont notamment les suivantes :
Ces questions définissent les limites des autorisations accordées à l’IA.
L’étude menée cette année par IBM sur l’utilisation de l’IA en entreprise montre qu’à mesure qu’elles étendent leurs déploiements d’IA, les entreprises rencontrent des problèmes de plus en plus importants liés au contrôle et à la dépendance. Dans le cadre de l’enquête, 71 % des dirigeants ont déclaré qu’il serait actuellement difficile de remplacer leur principal fournisseur ou modèle d’IA, tandis que 91 % des répondants ont indiqué que leurs entreprises ne comprenaient toujours pas pleinement leur dépendance à l’égard de différents fournisseurs, modèles et infrastructures d’IA.
Cela montre que la prudence dans l’utilisation de l’IA ne relève pas uniquement des équipes de sécurité.
Elle est étroitement liée à l’architecture d’entreprise, à la dépendance vis-à-vis des fournisseurs, à la souveraineté des données, à la continuité des activités et à la capacité d’une organisation à conserver le contrôle.
Une entreprise peut utiliser l’IA de manière ambitieuse tout en lui accordant des autorisations de façon prudente.
Par exemple, l’IA peut générer automatiquement du code sans être autorisée à le déployer directement dans un environnement de production. Elle peut analyser les données clients sans être autorisée à modifier les comptes principaux. Elle peut générer des recommandations d’approvisionnement sans être autorisée à exécuter automatiquement des paiements importants.
Ce type d’autonomie limitée pourrait devenir la principale voie de déploiement des Agents en entreprise.
Plus l’IA est puissante, plus la « confirmation humaine » peut devenir importante
Certains estiment que si l’IA devient suffisamment puissante, elle devrait finir par être entièrement automatisée.
En pratique, l’inverse pourrait être vrai. Plus l’IA se rapproche des décisions à forte valeur, plus les entreprises sont susceptibles d’exiger une confirmation humaine aux étapes critiques. Ce n’est pas nécessairement parce que les humains sont plus précis que l’IA, mais parce que la structure de responsabilité qui leur incombe est différente.
Les entreprises ont besoin de plus qu’une réponse correcte. Elles doivent également savoir qui a approuvé une action, pourquoi elle l’a été, sur quelles données elle reposait et comment la responsabilité sera attribuée en cas de problème.
Le principe de l’humain dans la boucle ne doit donc pas être considéré comme une solution temporaire, applicable uniquement pendant une période où les capacités de l’IA seraient insuffisantes.
Dans la finance, la santé, la cybersécurité, l’informatique d’entreprise et d’autres secteurs à haut risque, il pourrait devenir un composant architectural essentiel des systèmes d’IA matures. Pour les systèmes d’Agent en particulier, une conception véritablement mature pourrait ne pas reposer sur une IA entièrement autonome, mais plutôt sur le principe suivant : IA autonome dans un cadre défini — l’IA peut fonctionner de manière autonome dans des paramètres prédéfinis, tandis que des limites claires encadrent les autorisations, les montants, le périmètre des données et les opérations à haut risque.
La sécurité de l’IA passe d’un « ajout complémentaire » à une infrastructure
Si l’on se penche sur l’évolution passée de l’industrie logicielle, la sécurité était souvent considérée comme une couche supplémentaire à ajouter une fois le développement terminé. Mais avec l’essor du cloud computing, l’identité, les autorisations, le chiffrement, les journaux, la surveillance et la gestion des vulnérabilités sont progressivement devenus une infrastructure.
L’IA pourrait connaître une transition similaire. À l’avenir, une plateforme d’IA véritablement mature aura besoin de bien plus que de capacités de modèle. Elle nécessitera également des systèmes d’identité, des contrôles d’autorisation, l’évaluation des modèles, la surveillance des comportements, l’isolation des outils, des limites de données, des journaux d’audit et des capacités de réponse aux incidents.
L’explication récemment publiée par OpenAI sur la sécurité d’Astra reflète déjà cette tendance. Elle inclut notamment la surveillance de traces d’exécution complètes, une isolation interne plus stricte et des évaluations d’alignement avant sa commercialisation.
Les travaux publics d’Anthropic sur la sécurité accordent également une importance croissante à l’observation des attaques réelles impliquant l’utilisation de modèles et à l’exploitation de ces observations pour améliorer les mesures de protection.
La sécurité de l’IA elle-même pourrait donc devenir une nouvelle couche d’infrastructure.
Les capacités des modèles continueront de progresser verticalement, tandis que l’infrastructure de sécurité s’étendra horizontalement à l’ensemble du développement, des tests, du déploiement, de l’utilisation et des audits postérieurs aux incidents.
La prudence n’est pas l’opposé du développement de l’IA ; elle pourrait constituer le prochain avantage concurrentiel
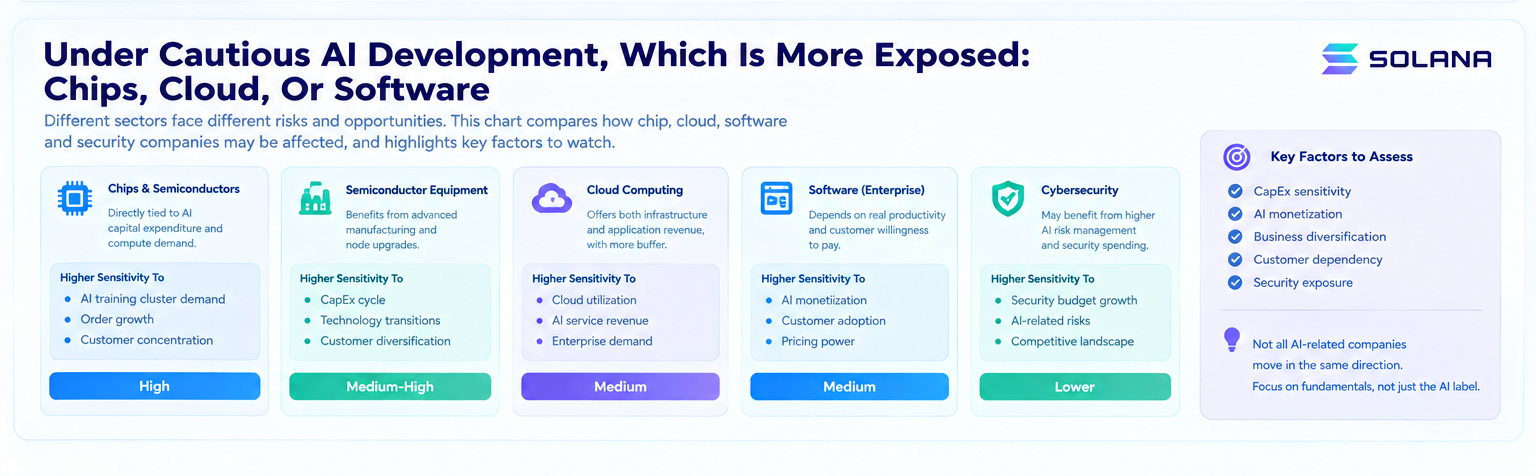
Si l’industrie de l’IA entre finalement dans une phase plus mature, les critères utilisés pour comparer les acteurs du marché pourraient évoluer.
Aux débuts de l’industrie, les comparaisons portaient sur le nombre de paramètres de chaque modèle, les performances aux benchmarks et la vitesse de lancement des produits.
La prochaine phase pourrait soulever des questions telles que :
-
Qui peut réaliser le plus rapidement des évaluations de capacités à haut risque ?
-
Qui peut mettre en place des contrôles d’autorisation au coût le plus faible ?
-
Qui peut identifier le plus précisément les comportements anormaux des modèles ?
-
Qui peut le mieux répondre aux exigences de conformité des entreprises ?
-
Qui peut réduire les incidents liés à l’IA sans sacrifier l’efficacité en production ?
La sécurité elle-même pourrait ainsi devenir une capacité produit.
Les recherches menées par IBM auprès des entreprises montrent que les organisations disposant de capacités de contrôle de l’IA plus solides sont mieux protégées contre les chocs liés aux risques de l’IA.
La prudence ne signifie donc pas ramener l’IA à une phase où ses capacités seraient moindres.
L’objectif véritablement mature devrait être le suivant : maintenir le rythme de croissance des capacités de l’IA aussi proche que possible du rythme auquel les humains peuvent comprendre, contrôler et assumer la responsabilité de ses conséquences.
C’est peut-être la question à laquelle le développement de l’IA de pointe devra réellement répondre à mesure qu’il entrera dans sa prochaine phase.
FAQ
Pourquoi le développement ralentit-il à mesure que l’IA devient plus puissante ?
Parce que plus un modèle devient performant, plus l’ampleur potentielle de son impact augmente. Lorsqu’un modèle acquiert des capacités d’appel d’outils et d’exécution autonome, les erreurs peuvent ne plus rester cantonnées au niveau des résultats et se transformer en actions concrètes dans le monde réel. La vitesse de développement doit donc progresser parallèlement aux capacités d’évaluation et de sécurité.
Utiliser l’IA avec prudence signifie-t-il que les entreprises devraient moins l’utiliser ?
Non. Une approche plus efficace consiste à étendre le champ d’utilisation de l’IA tout en contrôlant l’étendue de ses autorisations. Les entreprises peuvent permettre à l’IA de gérer une grande quantité de tâches tout en réservant les opérations à haut risque à l’approbation humaine.
Pourquoi les Agents rendent-ils les enjeux de sécurité de l’IA plus importants ?
Parce que les Agents ne se contentent pas de générer du contenu : ils peuvent appeler en continu des outils pour exécuter des tâches. À mesure que les chaînes d’exécution s’allongent et que les autorisations augmentent, une seule erreur peut entraîner des conséquences plus graves dans le monde réel.
La sécurité de l’IA pourrait-elle devenir une nouvelle barrière concurrentielle ?
Très probablement. À mesure que les capacités des modèles deviennent de plus en plus similaires, les capacités d’évaluation, de surveillance, de contrôle des autorisations et de gouvernance d’entreprise pourraient devenir des facteurs importants influençant le rythme de la commercialisation.