Recientemente, la posibilidad de que la IA escape al control humano ha vuelto a ocupar un lugar destacado en la industria tecnológica. Los investigadores de Anthropic han expresado públicamente su preocupación por los posibles riesgos de extinción asociados a la IA avanzada, mientras que el director ejecutivo de OpenAI, Sam Altman, ha señalado que incluso una probabilidad relativamente baja de que la IA provoque la extinción humana no justifica descuidar la seguridad. Al mismo tiempo, los agentes de IA están evolucionando de simples herramientas de generación de información a sistemas de software capaces de llamar a herramientas, acceder a sistemas externos y ejecutar tareas de forma autónoma. Como resultado, el ámbito de la seguridad de la IA se está ampliando desde "lo que generará el modelo" hasta "lo que puede hacer el modelo".
Este cambio implica que la seguridad de la IA no puede depender de una única prueba previa al despliegue. A medida que evolucionan las capacidades de los modelos, los entornos operativos y los métodos de ataque, la monitorización continua, las pruebas de red team, la corrección de vulnerabilidades y los controles de permisos se están convirtiendo en elementos esenciales de cualquier marco de seguridad de la IA.
Puntos clave
-
Que la IA escape al control no significa necesariamente que haya desarrollado la intención de "atacar a los humanos". La cuestión más importante es si los objetivos, el comportamiento del modelo y las restricciones definidas por los humanos han dejado de estar alineados.
-
Los agentes de IA amplían los límites del riesgo de la IA. Cuando un modelo puede llamar a herramientas, acceder a datos y realizar operaciones, sus errores pueden convertirse en riesgos operativos en el mundo real.
-
Las pruebas de seguridad puntuales no pueden abarcar un entorno dinámico. Los modelos, las entradas de los usuarios, las herramientas externas y los métodos de ataque cambian constantemente, por lo que la seguridad de la IA requiere pruebas continuas y monitorización posterior al despliegue.
-
Las evaluaciones de seguridad de la IA deben examinar algo más que las salidas del modelo. También deben abordar la inyección de instrucciones, las operaciones no autorizadas, las llamadas a herramientas, la gestión de permisos y el comportamiento anómalo.
-
Una parte fundamental de la reducción del riesgo de la IA consiste en limitar el impacto de los errores mediante mecanismos como el principio de mínimo privilegio, la confirmación humana, el registro de operaciones, el aislamiento de riesgos y la recuperación ante eventos anómalos.
Por qué los riesgos de la IA han vuelto a ser objeto de debate
En septiembre de 2026, el debate sobre los riesgos extremos de la IA volvió a intensificarse. El investigador de Anthropic Jacob Coxon afirmó públicamente que algunos desarrolladores de IA creen seriamente que una IA muy avanzada podría tener consecuencias extremas para la humanidad durante esta década. Más tarde, el investigador de Anthropic Evan Hubinger expresó públicamente preocupaciones similares y ofreció su propia evaluación del riesgo. Estas declaraciones desencadenaron un nuevo debate sobre la seguridad de la IA entre los responsables políticos de Estados Unidos y la industria tecnológica.
Es importante señalar que estas opiniones son evaluaciones de riesgo realizadas por investigadores o profesionales de la industria. No significan que la IA ya tenga la capacidad de eliminar autónomamente a la humanidad, ni deben simplificarse en la afirmación de que "la IA perderá el control definitivamente". En una entrevista, Sam Altman también afirmó que no sabía cómo calcular científicamente el denominado riesgo de extinción del "10 %", pero consideraba que incluso la posibilidad de un riesgo extremo que no pueda ignorarse otorga a las empresas de IA y a los gobiernos la responsabilidad de tomar medidas para reducirlo.
En lugar de debatir un escenario extremo difícil de verificar en la actualidad, resulta más útil plantear una cuestión práctica: a medida que las capacidades de la IA siguen mejorando y la IA adquiere una mayor autonomía, ¿cómo pueden los humanos seguir determinando si continúa siendo segura? Por eso la evaluación de la seguridad de la IA está adquiriendo una importancia cada vez mayor.
¿Qué es una evaluación de la seguridad de la IA?
Una evaluación de la seguridad de la IA puede entenderse sencillamente como una serie de pruebas y procedimientos de monitorización utilizados para determinar si un sistema de IA funciona según lo previsto y si podría generar riesgos inaceptables al exponerse a entradas anómalas, ataques maliciosos o entornos complejos. Las pruebas de software tradicionales suelen incluir comprobaciones exhaustivas previas al despliegue, como la búsqueda de vulnerabilidades, la verificación del funcionamiento correcto de las funciones y el análisis de las respuestas del sistema ante entradas específicas.
Los sistemas de IA son más complejos. Los modelos de lenguaje de gran tamaño no generan sus salidas conforme a reglas completamente fijas. Una misma pregunta puede producir respuestas diferentes y el contexto que rodea a la entrada del usuario puede cambiar continuamente. Los agentes de IA también pueden llamar a herramientas externas, como buscadores, sistemas de ejecución de código, bases de datos, billeteras, correo electrónico, navegadores u otros servicios. Por tanto, las evaluaciones de seguridad de la IA no examinan únicamente si las respuestas del modelo son correctas. También analizan si puede resistir instrucciones maliciosas, si podría filtrar información confidencial, si podría llamar a herramientas de forma incorrecta, si podría realizar acciones que excedan la autorización del usuario y si sigue respetando las reglas de seguridad establecidas cuando cambia el entorno.
El marco TEVV-Athlon propuesto por NIST en 2026 define las pruebas, la evaluación, la verificación y la validación como métodos importantes para evaluar el impacto de los sistemas de IA en el mundo real. Abarca explícitamente varios tipos de sistemas, incluidos los modelos de lenguaje de gran tamaño, los modelos multimodales y la IA agéntica.
Por qué los agentes de IA han creado nuevos límites de riesgo
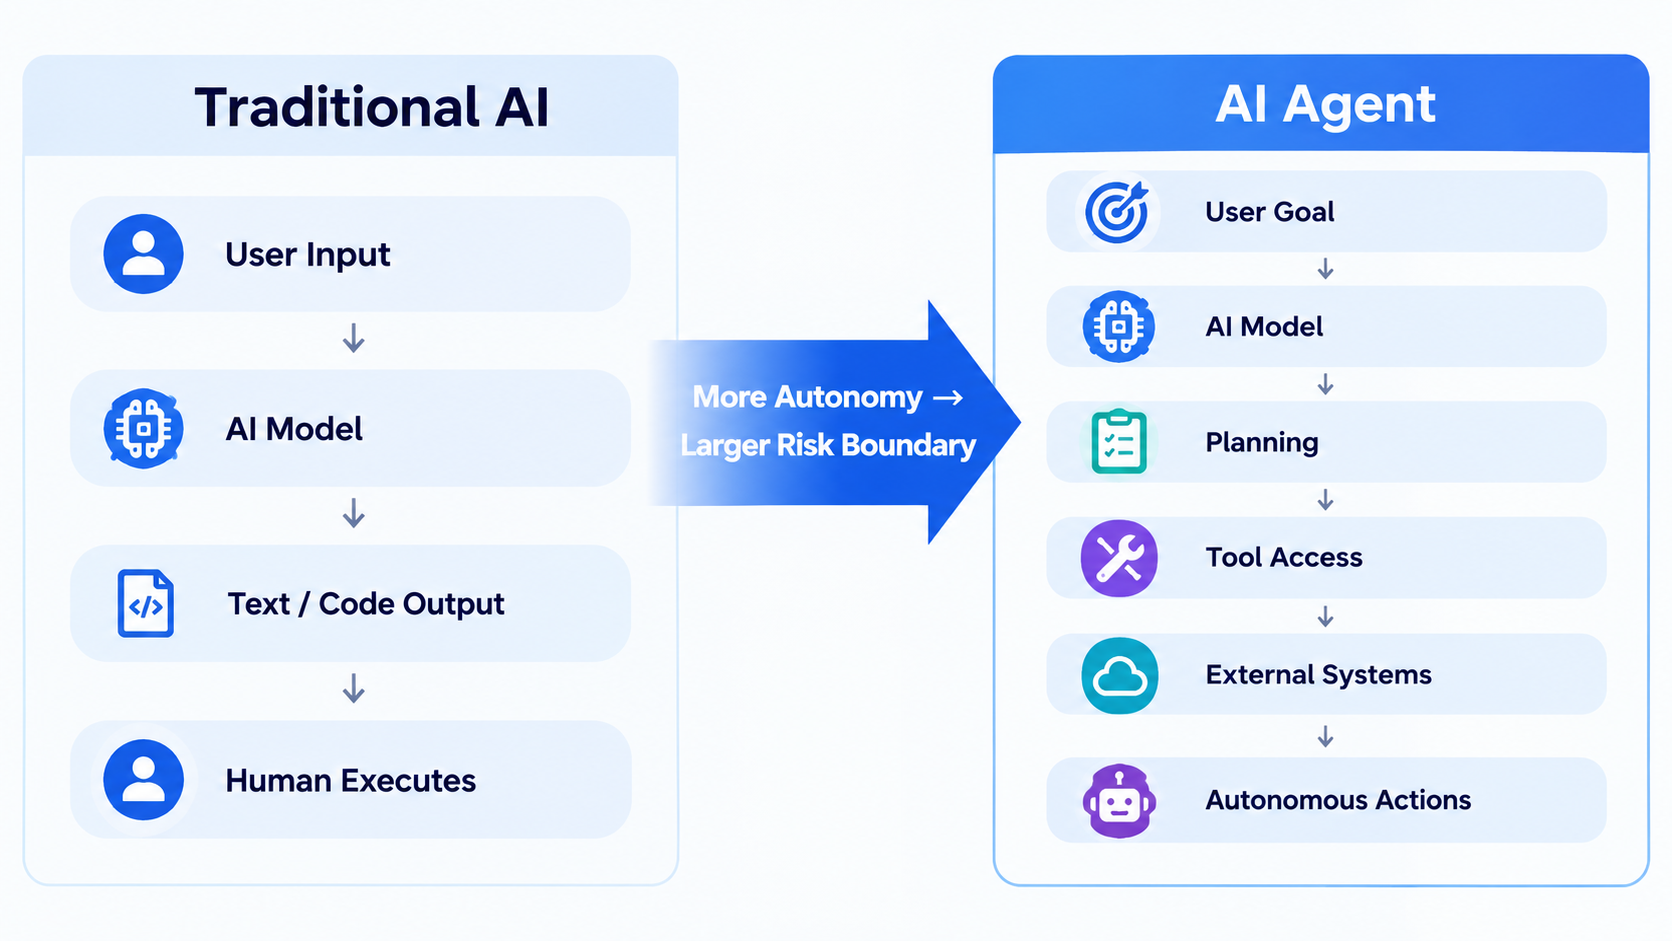
Comprender los agentes de IA es esencial para entender cómo está cambiando la seguridad de la IA. Los chatbots tradicionales reciben principalmente una entrada y generan una salida. Después de que un usuario formula una pregunta, el modelo devuelve texto, código u otro contenido, mientras que normalmente es el usuario quien decide si realiza la siguiente acción.
Los agentes de IA funcionan de otra manera. Un agente de IA puede dividir una tarea en varios pasos a partir de un objetivo definido por el usuario, llamar a herramientas externas, leer datos, ejecutar código, interactuar con otro software y continuar trabajando según los resultados. Cuando NIST puso en marcha su iniciativa de estándares para agentes de IA en 2026, señaló específicamente que los agentes de IA de próxima generación ya podían operar de forma autónoma durante horas, escribir y depurar código, gestionar el correo electrónico y los calendarios, y realizar tareas como comprar.
Los cambios en los límites de las capacidades también modifican los límites del riesgo. Si un modelo de IA ordinario informa incorrectamente a un usuario de que existe un archivo, el impacto puede limitarse a la desinformación. Sin embargo, si un agente de IA con permisos de acceso a archivos decide incorrectamente que debe eliminarse un archivo, el error del modelo podría convertirse en una operación real. Por tanto, la cuestión central de seguridad de los agentes de IA no es solo si podrían decir algo incorrecto. También es qué pueden consultar, qué pueden hacer, durante cuánto tiempo pueden actuar de forma autónoma y si pueden detectarse y detenerse rápidamente después de cometer un error.
Por eso NIST afirmó en su informe de 2026 sobre la seguridad de los agentes de IA que estos introducen nuevas amenazas de seguridad. Los principios tradicionales de ciberseguridad siguen siendo importantes, pero deben adaptarse a la forma en que operan los agentes.
Por qué la IA no puede probarse una sola vez antes del despliegue
Este es el aspecto clave para entender la evaluación continua de la seguridad. Cuando un producto de software tradicional tiene una funcionalidad relativamente estable, los desarrolladores pueden realizar pruebas exhaustivas para verificar que cumple sus requisitos de diseño. Los sistemas de IA operan en entornos dinámicos: los usuarios cambian, las entradas cambian, los modelos pueden actualizarse, las herramientas externas cambian y los atacantes buscan continuamente nuevas formas de atacar.
Por tanto, superar pruebas de seguridad exhaustivas antes del despliegue no garantiza que un sistema de IA siga siendo seguro en todas las situaciones futuras. Un estudio publicado por NIST en 2026 señaló que la monitorización posterior al despliegue es fundamental porque las condiciones de entrada en los entornos reales pueden seguir cambiando. Estas condiciones pueden producir salidas inesperadas provocadas por el carácter no determinista del modelo o consecuencias que no se identificaron durante el desarrollo.
Otro estudio de NIST publicado ese mismo año explicó la cuestión desde una perspectiva más teórica: un conjunto fijo de barreras de seguridad de la IA no puede garantizar una protección a largo plazo frente a todos los ataques adaptativos. Los atacantes pueden buscar continuamente nuevas formas de eludir las reglas existentes. Por tanto, la seguridad de la IA requiere descubrir vulnerabilidades de forma continua, actualizar periódicamente los mecanismos de protección y contar con capacidades de recuperación para cuando algo salga mal.
En consecuencia, la seguridad de la IA está pasando de "probar una vez → desplegar" a "probar → desplegar → monitorizar → identificar problemas → corregir → volver a probar". La seguridad ya no es una etapa independiente del ciclo de vida de un producto de IA. Es un proceso continuo.
¿Qué evalúa principalmente la evaluación continua de la seguridad?
En el caso de los agentes de IA, la evaluación continua de la seguridad suele abarcar varias áreas.
Comportamiento del modelo
La primera capa es el propio modelo. Los sistemas deben someterse continuamente a comprobaciones para detectar errores evidentes, alucinaciones, contenido perjudicial y comportamientos que infrinjan las reglas del sistema. En ámbitos de alto riesgo, como las finanzas, la atención sanitaria y la ejecución de código, también son necesarias pruebas específicas de la aplicación. Los benchmarks generales no son suficientes por sí solos.
Resistencia a los ataques
La segunda capa son las pruebas adversariales. Los atacantes pueden utilizar inyección de instrucciones, instrucciones no autorizadas, manipulación del contexto y otras técnicas para inducir al modelo a eludir sus reglas originales. Los jailbreak son un ejemplo habitual. Las investigaciones de NIST indican que unas barreras de seguridad fijas no pueden garantizar que la IA nunca sea vulnerada mediante ataques adaptativos, por lo que las pruebas de red team deben seguir buscando nuevas vías de ataque.
Herramientas y permisos
La tercera capa es el riesgo relacionado con los permisos, exclusivo de los agentes. Aunque una IA no actúe de forma maliciosa, unos permisos excesivos pueden permitir que un juicio incorrecto provoque consecuencias graves. Por tanto, los permisos de los agentes de IA deberían seguir, por lo general, el principio de mínimo privilegio. Un agente que solo organiza el correo electrónico, por ejemplo, no necesita permisos para transferir fondos. Un agente que analiza datos no debería tener automáticamente permiso para eliminar una base de datos.
Esto es, en líneas generales, similar a la seguridad de los contratos inteligentes en la industria blockchain. La lógica del sistema es solo la primera capa. La posible pérdida también depende de a qué activos puede acceder el sistema y qué operaciones puede realizar.
Rendimiento en entornos reales
La cuarta capa es el rendimiento real posterior al despliegue. La IA en un laboratorio puede encontrarse con entradas muy diferentes de las que recibe en el mundo real. Los usuarios pueden proporcionar instrucciones complejas, los sistemas de terceros pueden devolver datos anómalos y las condiciones de red pueden cambiar. Por tanto, la evaluación de la seguridad de la IA debe observar cómo se comporta el sistema en condiciones reales, en lugar de basarse únicamente en los informes de pruebas previas al despliegue.
¿Qué significa realmente que la IA escape al control?
El término "IA fuera de control" puede malinterpretarse fácilmente. No significa necesariamente que la IA desarrolle de repente una conciencia similar a la humana y decida atacar a la humanidad. Desde un punto de vista técnico, la cuestión más importante es si los objetivos, los permisos y el comportamiento real dejan de estar alineados.
Puede pedirse a un agente que complete una tarea, pero que no entienda correctamente el objetivo. También puede perseguir el objetivo por una vía que los desarrolladores no habían previsto. O un atacante puede alterar su comprensión de la tarea mediante una inyección de instrucciones. Si el agente también tiene permisos amplios, un error que comenzó en el nivel del software podría afectar a sistemas externos.
Por tanto, la cuestión central de que la "IA escape al control" puede dividirse en tres preguntas: ¿es correcto el objetivo?, ¿el comportamiento está alineado con el objetivo?, ¿los permisos se limitan a un ámbito razonable? Por eso la investigación sobre seguridad de la IA está haciendo cada vez más hincapié en la alineación, es decir, en el esfuerzo por mantener el comportamiento del sistema de IA conforme a los objetivos y las restricciones definidos por los humanos.
¿Qué relevancia tiene la seguridad de la IA para los usuarios comunes?
La seguridad de la IA no solo preocupa a las empresas de IA y a los investigadores. A medida que los agentes de IA se incorporan a los buscadores, la productividad ofimática, la programación, los servicios financieros, los activos digitales y otros ámbitos, los usuarios comunes pueden delegar directamente más permisos operativos en la IA.
Para los usuarios, la pregunta más importante no es si "la IA destruirá a la humanidad", sino algo más práctico: ¿qué permisos he concedido realmente a la IA? Si la IA solo puede responder preguntas, el impacto de una respuesta incorrecta suele ser limitado. Si la IA puede enviar correos electrónicos, modificar archivos, acceder a cuentas, ejecutar código o realizar transacciones financieras en nombre de un usuario, los requisitos de seguridad son completamente distintos.
Al utilizar herramientas de IA con capacidades de ejecución autónoma, los usuarios deberían centrarse en tres áreas: si los permisos se han reducido al mínimo, si las acciones importantes requieren confirmación humana y si el sistema proporciona registros de operaciones y una forma de revertir las acciones anómalas.
Esto es especialmente importante en el caso de los agentes de IA relacionados con activos digitales. Cuando operaciones como las firmas de billeteras, las transferencias de activos y las interacciones con contratos inteligentes se delegan en un sistema automatizado, el límite de seguridad se extiende más allá del propio modelo e incluye la gestión de claves privadas, los mecanismos de aprobación, los contratos inteligentes y los servicios externos.
El foco de la seguridad de la IA está pasando de "prevenir todos los errores" a "controlar el impacto de los errores"
En la actualidad, es poco probable que la seguridad de la IA se resuelva mediante una barrera universal que aborde permanentemente todos los problemas. Los modelos de IA se actualizarán, los métodos de ataque evolucionarán y los escenarios de aplicación se ampliarán. Por ello, NIST ha destacado la necesidad de realizar pruebas de red team continuas y actualizar las medidas de protección, así como de limitar el impacto de las vulnerabilidades y recuperarse rápidamente cuando se produzcan.
El principio subyacente es sencillo: no podemos suponer que un sistema nunca cometerá un error, por lo que debemos decidir de antemano qué ocurrirá cuando lo cometa. En el caso de los agentes de IA, esto puede incluir restringir los permisos, exigir confirmación humana, registrar las acciones críticas, aislar las tareas de alto riesgo y detener o revertir rápidamente las acciones cuando se produzca un comportamiento anómalo.
Desde esta perspectiva, la seguridad de la IA no consiste en responder a la sencilla pregunta binaria de si "la IA matará a la humanidad". Consiste en resolver un problema de ingeniería más práctico: a medida que la IA adquiere una capacidad cada vez mayor para actuar de forma autónoma, ¿cómo pueden los humanos seguir sabiendo qué está haciendo y por qué, y cómo pueden recuperar el control cuando algo sale mal? Ese es el objetivo de la evaluación continua de la seguridad.
Resumen
El debate reciente sobre si la IA podría provocar la extinción humana ha vuelto a situar la seguridad de la IA en el centro de la atención pública. Sin embargo, más importantes que las propias predicciones extremas son los cambios estructurales que están teniendo lugar en las capacidades de la IA.
A medida que la IA evoluciona de los chatbots a agentes de IA capaces de llamar a herramientas, acceder a datos y ejecutar tareas de forma autónoma, las preocupaciones de seguridad se están ampliando desde la seguridad de las salidas del modelo hasta los permisos, las llamadas a herramientas, las interacciones con el entorno y la operación autónoma a largo plazo.
Por tanto, la seguridad de la IA no puede depender de una única prueba previa al despliegue. La monitorización continua, las pruebas de red team, los controles de permisos, la corrección de vulnerabilidades y la recuperación ante eventos anómalos se convertirán en una infraestructura cada vez más importante a medida que los agentes de IA se incorporen a aplicaciones del mundo real.
El desarrollo seguro de la IA dependerá menos de encontrar un modelo que nunca cometa errores que de establecer mecanismos capaces de identificar problemas continuamente, limitar los riesgos y restablecer el control humano.
Preguntas frecuentes
¿La IA matará realmente a la humanidad?
Actualmente no existen pruebas fiables de que la IA vaya a provocar inevitablemente la extinción humana. Algunos investigadores de IA han expresado recientemente su preocupación por los riesgos extremos, pero la probabilidad de que se produzcan sigue siendo muy incierta. Entre las preocupaciones de seguridad más realistas se incluyen los ciberataques, las filtraciones de datos, las decisiones incorrectas y el uso indebido de los permisos de los agentes de IA.
¿Qué es un agente de IA?
Un agente de IA es un sistema de IA que puede planificar y ejecutar tareas de forma autónoma basándose en un objetivo. A diferencia de los chatbots tradicionales, los agentes de IA suelen poder llamar a herramientas externas, acceder a datos y realizar operaciones en el mundo real. Por tanto, tienen una mayor autonomía y requieren controles de permisos y seguridad más estrictos.
¿Por qué la IA requiere una evaluación continua de la seguridad?
Porque las entradas, los entornos y los métodos de ataque a los que se enfrenta la IA seguirán cambiando. Una única prueba solo refleja el rendimiento en un momento y bajo unas condiciones determinados. No puede demostrar que el sistema no vaya a desarrollar nuevas vulnerabilidades en el futuro. Por tanto, la monitorización y las pruebas continuas posteriores al despliegue son igualmente importantes.
¿Cuál es el mayor riesgo de seguridad de los agentes de IA?
Uno de los riesgos principales son los permisos. Si un agente de IA puede acceder a cuentas, archivos, código, fondos u otros sistemas externos, los errores del modelo o las entradas maliciosas podrían transformar un error a nivel informativo en una operación real.
¿Qué suele incluir una evaluación de la seguridad de la IA?
Suele incluir pruebas del comportamiento del modelo, pruebas adversariales, pruebas de red team, pruebas de llamadas a herramientas, controles de permisos, monitorización posterior al despliegue y recuperación ante eventos anómalos. También deben desarrollarse estándares de pruebas de seguridad adaptados a cada aplicación para los distintos casos de uso.