Para quienes comienzan a delimitar las capacidades de la IA, un modelo del mundo responde a si un sistema puede anticipar las consecuencias de una acción, no a si redacta respuestas fluidas. Las secciones siguientes abordan la definición, el ciclo de predicción, tres enfoques técnicos, la selección de tareas entre modelo del mundo y LLM, las diferencias con la generación de vídeo, los casos de uso y los límites de evaluación. Los conceptos relacionados se explican en los artículos de Gate Learn sobre superinteligencia (ASI) e IA privada.
Puntos clave
- La capacidad central es la predicción condicionada por acciones: dado un estado y una acción, genera el siguiente estado (o la siguiente representación) para la planificación y el control.
- Tres enfoques habituales: RL basada en modelos (MBRL) / entrenamiento mediante imaginación, simulación interactiva generativa y representaciones predictivas de estilo JEPA.
- Los modelos de lenguaje de gran tamaño destacan en la predicción del siguiente token y los generadores de vídeo en la continuidad visual. Ninguno equivale automáticamente a un modelo del mundo apto para la planificación.
- La evaluación debe vigilar la física simulada incorrecta, la desviación a largo plazo, los fallos fuera de distribución, las métricas estrictas y el límite respecto a los simuladores programados manualmente.
¿Qué es un modelo del mundo y qué problema resuelve?
Un modelo del mundo aborda una cuestión práctica: antes de que un agente actúe, ¿puede estimar de forma fiable qué ocurrirá después? Sin esta capacidad, el aprendizaje depende de pruebas y errores reales, que suelen ser costosos, lentos o inseguros, y la planificación sin conexión se vuelve difícil.
En robótica, conducción autónoma, agentes de juegos y entrenamiento mediante simulación, especialmente para agentes incorporados en entornos virtuales o físicos, la retroalimentación es costosa o arriesgada. Por ejemplo, una política de conducción deficiente puede provocar un accidente real antes de aprender. Un modelo del mundo traslada la “prueba de acciones” a dinámicas aprendidas: avanza en el espacio latente o de observación y, posteriormente, aplica una política más sólida en el mundo real. Este objetivo difiere de los sistemas conversacionales que principalmente reformulan conocimientos. Se acerca más a la previsión causal dentro de un entorno interactivo.
La entrada del glosario de NVIDIA sobre modelos del mundo los describe como representaciones internas que ayudan a la IA a comprender y predecir cómo evoluciona el mundo físico. A Path Towards Autonomous Machine Intelligence de Yann LeCun sitúa los modelos del mundo predictivos en el camino hacia una inteligencia más autónoma, y el trabajo “World Models” de David Ha, publicado en 2018, ayudó a definir el enfoque moderno basado en aprendizaje. Un agente normalmente solo observa información parcial, por lo que el estado completo no está disponible de forma directa. Desde estas perspectivas, la predicción existe para respaldar decisiones.
¿Cómo funciona un modelo del mundo? Estado, acción y ciclo de predicción
La prueba más sólida de un sistema orientado a modelos del mundo es la predicción condicionada por acciones: si las entradas incluyen explícitamente la acción de un agente (o señal de control) y si la salida es el siguiente estado o la siguiente representación condicionada por esa acción.
El ciclo suele resumirse en tres pasos: codificar las observaciones en un estado, condicionarlo con una acción candidata y predecir el siguiente estado. El entorno cambia tras esa acción y devuelve nuevas observaciones, y la predicción puede avanzar opcionalmente para convertirse en un nuevo punto de partida. Una política o un planificador compara trayectorias imaginadas según la recompensa, el riesgo o las restricciones, y después ejecuta la acción. Una observación nueva reinicia la codificación.
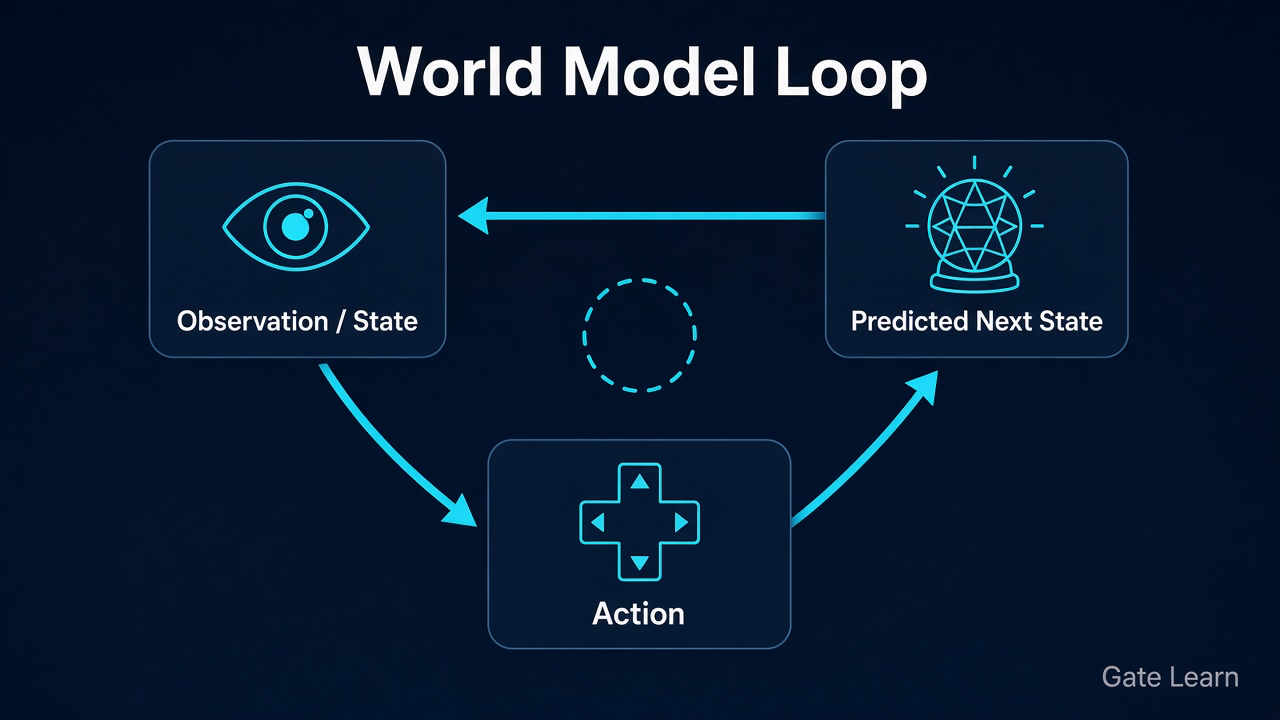
Figura 1. Ciclo del modelo del mundo: la observación/el estado más una acción producen un siguiente estado predicho que alimenta el siguiente ciclo.
Muchos sistemas prácticos evitan las predicciones a largo plazo en píxeles sin procesar y, en su lugar, aprenden dinámicas latentes: comprimen datos visuales de alta dimensión en un estado compacto y luego avanzan en ese espacio. Las simulaciones latentes reducen el ruido visual y abaratan el entrenamiento mediante imaginación. Que el estado latente siga siendo fiel a la física real requiere comprobaciones mediante tareas posteriores y pruebas fuera de distribución, especialmente porque el entorno físico solo se observa parcialmente y debe inferirse a través de la retroalimentación.
¿Cuáles son los principales enfoques técnicos de los modelos del mundo?
“Modelo del mundo” es una etiqueta amplia que abarca varias familias técnicas, no el nombre de un único algoritmo. La selección comienza por el objetivo: políticas controlables, simulación interactiva en píxeles o representaciones abstractas transferibles.
| Enfoque |
Idea central |
Mejor aplicación |
Coste principal |
| MBRL / entrenamiento mediante imaginación |
Aprende dinámicas y, después, entrena una política con simulaciones del modelo (Dreamer) |
Control, juegos, RL eficiente en muestras |
El error del modelo perjudica la política, desviación |
| Simulación interactiva generativa |
Aprende un entorno interactivo que genera los siguientes fotogramas/observaciones |
Aumento de datos, mundos de vídeo interactivos |
Apariencia ≠ física, evaluación costosa |
| Representaciones predictivas JEPA |
Predice representaciones futuras o enmascaradas en el espacio de representaciones (I-JEPA) |
Aprendizaje de representaciones, predicción abstracta para planificación |
Sin píxeles, requiere una pila de control |
Un enfoque puede centrarse en un modelo de vídeo que predice fotogramas futuros, mientras que otro busca dinámicas latentes preparadas para la planificación en lugar de una reconstrucción visual completa.
Los tres enfoques pueden coexistir: los métodos de estilo Dreamer destacan el entrenamiento de políticas mediante imaginación; los modelos del mundo de vídeo generativo destacan la simulación interactiva de la apariencia; I-JEPA de Meta AI muestra la predicción en un espacio de incrustación conjunto en lugar de reconstruir cada píxel. Los distintos sistemas también eligen recetas de entrenamiento diferentes en función de si aprenden a partir de pares de entrada y salida, simulaciones de control o incrustaciones predictivas. Primero alinea la tarea y luego debate los nombres.
¿En qué se diferencian los modelos del mundo de los LLM y la generación de vídeo?
Los tres “predicen”, pero dentro de la IA generativa predicen objetos distintos y difieren en el condicionamiento por acciones: los LLM predicen el siguiente token, los generadores de vídeo predicen la apariencia del siguiente fotograma y los sistemas orientados a modelos del mundo predicen cómo evoluciona el estado tras una acción.
| Dimensión |
Modelo del mundo |
Modelo de lenguaje de gran tamaño (LLM) |
Generación de vídeo |
| Objetivo principal de predicción |
Siguiente estado / dinámicas latentes (a menudo condicionadas por acciones) |
Siguiente token / estructura de texto |
Apariencia del siguiente fotograma o clip |
| Relación con la acción |
La predicción condicionada por acciones es el eje de decisión |
Normalmente no hay un ciclo de control físico |
Puede condicionarse por texto o primer fotograma, pero no es ejecutable |
| Uso habitual |
Planificación, control, IA incorporada |
Lenguaje, redacción, orquestación de herramientas |
Generación de contenido, vistas previas, simulaciones interactivas |
| Confusión habitual |
Capacidad de conversación = modelo del mundo |
Redactar sobre física = capacidad física |
Fotogramas fotorrealistas = dinámicas correctas |
Por tanto, un generador de vídeo similar a Sora puede mostrar fotogramas coherentes con alta fidelidad visual e incluso una aparente consistencia espacial, y puede etiquetarse como un “modelo del mundo de vídeo”, pero estos rasgos por sí solos no demuestran comprensión física. Sin una interfaz de acción estable, transiciones de estado verificables y un ciclo de planificación, la categoría precisa sigue siendo vídeo generativo. Un sistema más sólido también puede evaluar secuencias de acciones para respaldar la planificación y la toma de decisiones, no solo representar pasivamente vistas probables. Un LLM puede describir “qué ocurriría si empujas la taza”, pero eso no crea dinámicas del entorno que puedan simularse y evaluarse.
¿Dónde se utilizan habitualmente los modelos del mundo?
La IA incorporada es un entorno frecuente: los brazos robóticos y los robots móviles necesitan inteligencia espacial, es decir, razonamiento sobre distribuciones, movimiento y cambios en el mundo físico, además de previsiones de contacto y desplazamiento antes de tocar objetos, ya que muchas interacciones son difíciles de revertir una vez que comienza el movimiento. La predicción condicionada por acciones permite a los sistemas descartar trayectorias fallidas en simulación o en el espacio latente antes de asumir el coste de colisiones reales. Las demostraciones pueden inicializar comportamientos, pero no sustituyen al aprendizaje basado en la interacción.
Los juegos y el aprendizaje por refuerzo basado en modelos son otro ámbito fundamental. Los métodos de estilo Dreamer mejoran las políticas sobre trayectorias imaginadas para que pueda surgir un control útil con menos interacciones reales. Ideas similares se transfieren a registros de control industrial en los que un simulador programado manualmente es incompleto, pero el historial de observaciones es abundante, ya que el modelo intenta captar las dinámicas del sistema a partir de ese historial.
La conducción autónoma, la planificación de almacenes y las simulaciones multiagente también incorporan componentes de modelos del mundo, no como sustitución completa de las pilas de planificación, sino como una capa de consecuencias a corto plazo. Las pruebas virtuales y los datos de vídeo seleccionados se utilizan a menudo para entrenar y evaluar estos componentes en distintos escenarios antes de su implementación real. Cualquier sistema de control que deba “pensar antes de actuar” puede incluir un módulo de modelo del mundo.
¿Qué ventajas, riesgos y límites son importantes al evaluar modelos del mundo?
La ventaja es una mayor eficiencia de muestras y pruebas y errores más seguros: imaginar dentro de un modelo puede reducir la exploración peligrosa y las previsiones condicionadas por acciones pueden basar la planificación en dinámicas inspeccionables. Los límites y riesgos suelen aparecer cuando un modelo parece correcto pero no es fiable, ya que una representación interna pulida no equivale a un comportamiento que resista la implementación.
| Mecanismo |
Lo que se observa |
Por qué se oculta |
Preguntas de comprobación |
| Física simulada incorrecta |
Trayectorias fluidas que vulneran la conservación o el contacto |
La visión confía en la fluidez |
¿Se conservan las cantidades clave? ¿Pueden los objetos atravesarse? |
| Desviación a largo plazo |
Las simulaciones cortas funcionan, las largas colapsan |
Las demostraciones favorecen clips cortos |
¿Cómo crece el error con los pasos? ¿Hay replanteamiento? |
| Fallo fuera de distribución |
Falla con objetos, iluminación o rangos de acción nuevos |
Las puntuaciones dentro de distribución parecen sólidas |
¿Protocolo OOD? ¿Modos de fallo públicos? |
| Evaluación estricta |
No existe una puntuación compartida de “comprensión del mundo” |
El éxito de la tarea absorbe la métrica |
Además de la puntuación de la tarea, ¿se informa del error de predicción? |
| Límite frente a simuladores programados manualmente |
Los modelos aprendidos se tratan como motores verificados |
El marketing mezcla simulador y modelo del mundo |
¿Qué restricciones están codificadas? ¿Cuáles son solo ajustes? |
La transferencia a la realidad es difícil debido a la brecha entre simulación y realidad. Las buenas pruebas deben preguntar si el modelo predice resultados controlables mediante acciones, no solo imágenes plausibles.
Utiliza la tabla como lista de comprobación de afirmaciones: confirma una interfaz condicionada por acciones, exige después pruebas a largo plazo y fuera de distribución y, por último, separa “se ve bien” de “las dinámicas se pueden planificar”. Sin estas pruebas, una formulación más prudente es “incluye componentes de modelos del mundo u objetivos de investigación”, no “tiene un modelo del mundo completo”. Dado que los agentes tienen capacidad limitada, la evaluación debe centrarse en el estado relevante para el objetivo, no en la reproducción total de la escena.
Resumen
Los modelos del mundo llevan a la IA de “puede hablar / puede dibujar” a “puede anticipar las consecuencias de una acción”, como predecir que un robot derribará una taza si sigue una trayectoria incorrecta. El núcleo operativo es un ciclo cerrado de estado, acción y predicción, con la predicción condicionada por acciones como el eje de decisión más claro.
Los tres enfoques, MBRL/entrenamiento mediante imaginación, simulación interactiva generativa y representaciones predictivas JEPA, sirven a objetivos distintos y no son intercambiables. Frente a los LLM y los generadores de vídeo, compara los objetivos de predicción y las interfaces de acción. Al evaluar, prioriza la física simulada incorrecta, la desviación, los fallos OOD, las métricas estrictas y los límites de los simuladores.
Preguntas frecuentes
¿Qué es un modelo del mundo?
Un modelo del mundo es un modelo de dinámicas internas aprendido que representa cómo puede cambiar un entorno dado un estado actual, o una observación, y una acción. El mundo en cualquier momento es más complejo que lo que un agente puede observar directamente, por lo que el modelo resume las variables importantes para la planificación, por ejemplo, dónde termina un robot después de girar a la izquierda. Su propósito es respaldar la planificación y las pruebas y errores mediante imaginación, no solo generar texto o apariencia de vídeo.
¿En qué se diferencia un modelo del mundo de un modelo de lenguaje de gran tamaño?
Los modelos de lenguaje de gran tamaño predicen principalmente el siguiente token y destacan en el lenguaje y la orquestación del conocimiento. Los modelos del mundo predicen principalmente cómo evoluciona el estado tras las acciones para el control y la planificación. Un LLM puede hablar sobre física sin proporcionar dinámicas del entorno que puedan simularse y evaluarse.
¿Cómo funciona un modelo del mundo?
Un ciclo típico codifica las observaciones en un estado, lo condiciona con una acción candidata, predice el siguiente estado tras esa acción y puede avanzar en el espacio latente. Un planificador compara simulaciones imaginadas, ejecuta una acción y, después, actualiza el estado a partir de una nueva observación.
¿Sora o la generación de vídeo cuentan como modelo del mundo?
No automáticamente. Si un sistema produce principalmente vídeo con una apariencia coherente sin una interfaz estable condicionada por acciones, transiciones de estado verificables y uso para planificación, se describe mejor como generador de vídeo. Se acerca a un modelo del mundo solo cuando se demuestran la predicción condicionada por acciones y un ciclo apto para la planificación.
¿En qué se diferencia un modelo del mundo de un simulador tradicional?
Los simuladores tradicionales suelen codificar reglas y restricciones físicas programadas manualmente, mientras que los modelos del mundo basados en datos se aprenden a menudo con redes neuronales. Los modelos aprendidos pueden ser más flexibles y aproximarse más al ruido de los sensores, pero también son más propensos a la física simulada incorrecta y a la desviación a largo plazo, por lo que no debe asumirse que equivalen a un motor de física verificado.