A medida que la IA generativa se extiende desde el entrenamiento de modelos hasta las aplicaciones comerciales a gran escala, también está cambiando el foco de la competencia en el mercado de la computación para IA. Las empresas no solo necesitan entrenar modelos más potentes, sino también procesar continuamente las solicitudes de los usuarios con costes controlados, ejecutar agentes de IA, generar voz y ofrecer servicios interactivos en tiempo real. En este contexto, la arquitectura especializada de aceleración de inferencia representada por Groq ha atraído una atención cada vez mayor. Este artículo examina el posicionamiento corporativo de Groq, la tecnología LPU, el modelo de negocio de GroqCloud y la competencia del sector para analizar su papel en la infraestructura de inferencia de IA, así como los desafíos técnicos y comerciales a los que se enfrenta el enfoque basado en chips especializados.
Puntos clave
- Groq es una empresa de tecnología informática centrada en la inferencia de IA. Sus tecnologías principales incluyen chips LPU, compiladores e infraestructura de inferencia.
- El entrenamiento y la inferencia de IA tienen requisitos informáticos diferentes. La inferencia en tiempo real concede especial importancia al tiempo hasta el primer token, la velocidad de generación y la estabilidad del servicio.
- Las LPU de Groq optimizan cargas de trabajo específicas de inferencia de IA mediante SRAM integrada en el chip, ejecución determinista y codesarrollo de hardware y software.
- GroqCloud integra las capacidades informáticas subyacentes en API en la nube, lo que permite a los desarrolladores utilizar los modelos compatibles.
- Las LPU y las GPU tienen arquitecturas y ámbitos de aplicación diferentes. El rendimiento general no puede evaluarse únicamente en función de la velocidad de generación de un solo token.
- La competitividad comercial a largo plazo de Groq depende de la escalabilidad de sus chips, su ecosistema de software, los costes de inferencia, la demanda de los clientes y el rendimiento de la inversión en infraestructura.
¿Qué es Groq y qué papel desempeña en la cadena de valor de la computación para IA?
Groq es una empresa tecnológica centrada en la computación para la inferencia de IA. Jonathan Ross, que anteriormente participó en el proyecto TPU de Google, fundó la empresa en 2016. Groq desarrolla principalmente chips especializados de aceleración de IA, compiladores y sistemas de computación para inferencia, y ofrece capacidades de inferencia de modelos a desarrolladores y empresas mediante servicios como GroqCloud.
Es importante señalar que Groq y Grok no son el mismo producto. Groq es un nombre tecnológico relacionado con la infraestructura de computación para IA, mientras que Grok es un modelo de inteligencia artificial y un producto de asistencia desarrollado por xAI. Aunque sus nombres son similares, pertenecen a empresas diferentes y tienen un posicionamiento técnico y modelos de negocio distintos.
En la cadena de valor de la IA, Groq se sitúa principalmente en la capa de infraestructura informática. Una aplicación completa de IA generativa suele incluir el desarrollo de modelos, la computación de entrenamiento, el despliegue de inferencia, las interfaces de aplicación y los servicios para usuarios finales. La actividad principal de Groq no consiste en desarrollar modelos de chat de uso general para consumidores. Su objetivo es proporcionar entornos de inferencia de alto rendimiento para distintos modelos.
Por ejemplo, al crear un asistente de IA en tiempo real, los desarrolladores pueden seleccionar un modelo ya entrenado y utilizar un servicio de inferencia para procesar las entradas de los usuarios. El modelo comprende las preguntas y genera contenido, mientras que la plataforma informática subyacente determina la rapidez con la que puede ejecutarse el modelo y la cantidad de recursos informáticos que consume cada solicitud.
La optimización de este proceso informático constituye el núcleo de la propuesta de valor de Groq. Mediante procesadores y sistemas de software diseñados específicamente para este fin, Groq reduce la sobrecarga de ejecución de determinadas tareas de inferencia y permite que los modelos generen respuestas con mayor rapidez.
Este posicionamiento implica que la oportunidad de mercado de Groq no depende únicamente de que un modelo de IA concreto alcance popularidad, sino también de la demanda de inferencia en toda la industria de la IA generativa, de las arquitecturas de los modelos y de la evolución de los costes informáticos.
¿Por qué la industria de la IA presta cada vez más atención a la computación de inferencia?
La computación para IA suele dividirse en dos etapas: entrenamiento e inferencia. El entrenamiento utiliza grandes cantidades de datos para ajustar los parámetros del modelo, de modo que este pueda adquirir capacidades como la comprensión del lenguaje y el reconocimiento de imágenes. La inferencia consiste en que un modelo entrenado reciba nuevas entradas y genere resultados basándose en sus parámetros existentes.
Ambas etapas requieren recursos informáticos, pero sus cargas de trabajo son considerablemente diferentes. El entrenamiento de modelos suele implicar el procesamiento de grandes conjuntos de datos, el cálculo de gradientes y la actualización de parámetros. Da prioridad a la computación paralela a gran escala, la capacidad de memoria y la coordinación entre varios dispositivos. La inferencia, en cambio, debe generar resultados rápidamente en respuesta a las solicitudes de los usuarios. Esto es especialmente importante en aplicaciones de chat, voz y automatización, donde los tiempos de respuesta afectan directamente a la experiencia del usuario.
En los modelos de lenguaje de gran tamaño, el proceso de inferencia suele incluir dos etapas: Prefill y Decode. Prefill procesa el prompt de entrada y establece el estado computacional relevante, mientras que Decode genera los tokens posteriores uno a uno. Dado que los modelos de lenguaje autorregresivos suelen tener que predecir el siguiente token basándose en el contenido generado hasta ese momento, el proceso de generación continua exige una alta eficiencia en el acceso a la memoria y en la planificación de la computación.
Los usuarios de las aplicaciones de chat habituales pueden tolerar una espera breve. Sin embargo, en los asistentes de voz en tiempo real, el servicio de atención al cliente automatizado y los escenarios de IA interactiva, la latencia de respuesta puede afectar directamente a la naturalidad de la conversación. Si un modelo tarda demasiado en generar la primera parte de una respuesta o si su velocidad de salida no es suficiente para la comunicación en tiempo real, puede tener dificultades para cumplir los requisitos empresariales prácticos, aunque el propio modelo sea muy capaz.
El desarrollo de los agentes de IA ha aumentado aún más la demanda de inferencia. A diferencia de las interacciones puntuales de preguntas y respuestas, un agente de IA puede tener que llamar a varios modelos, analizar datos externos, ejecutar operaciones con herramientas y verificar resultados. Una única tarea del usuario puede generar varias rondas de razonamiento interno y múltiples solicitudes de API, lo que incrementa el consumo informático total.
Por ello, la competencia en infraestructura de IA ya no se limita a buscar mayores capacidades de entrenamiento de modelos. También se centra en ofrecer servicios de inferencia con menor latencia, mayor rendimiento y costes más razonables.
No obstante, el aumento de la demanda de inferencia no significa que la computación de entrenamiento esté perdiendo importancia. El entrenamiento de nuevos modelos, el ajuste fino de modelos y la prestación de servicios de inferencia pueden seguir creciendo al mismo tiempo. La diferencia es que los requisitos de hardware de las distintas tareas informáticas son cada vez más especializados.
¿Cuáles son las principales características del enfoque tecnológico LPU de Groq?
LPU es el término técnico que utiliza Groq para describir su procesador especializado de inferencia. En comparación con las GPU de uso general, diseñadas para una amplia variedad de tareas informáticas, el diseño de las LPU se centra más en la computación, el movimiento de datos y el control de la latencia para cargas de trabajo específicas de IA.
La tecnología LPU de Groq puede entenderse a través de tres aspectos: la memoria integrada en el chip, la ejecución determinista y los compiladores.
¿Cómo afecta la SRAM integrada en el chip a la eficiencia del acceso a los datos?
La computación moderna para IA está limitada no solo por las capacidades aritméticas de un chip, sino también por la velocidad de acceso y transferencia de datos. Durante la inferencia de modelos de lenguaje de gran tamaño, las unidades de computación deben acceder continuamente a los pesos del modelo y a los datos intermedios. Si los datos no llegan a tiempo, el procesador puede no utilizar plenamente sus recursos, aunque tenga una gran capacidad informática teórica.
Una característica importante de las LPU de Groq es su énfasis en la SRAM integrada en el chip (memoria estática de acceso aleatorio). Por lo general, la SRAM ofrece una menor latencia de acceso y puede ayudar a los procesadores a leer rápidamente los datos necesarios. En comparación con los diseños que dependen de memorias externas de gran capacidad y alto ancho de banda, esta arquitectura intenta reducir la sobrecarga del acceso a los datos en determinadas tareas informáticas.
La SRAM también tiene limitaciones de coste y capacidad. Con la misma superficie de chip, la SRAM generalmente no puede ofrecer la misma escala de almacenamiento que una memoria externa de gran capacidad. Por tanto, el despliegue de modelos con un mayor número de parámetros puede requerir coordinación entre varios chips, partición del modelo y optimización a nivel de sistema para cumplir los requisitos de capacidad.
Esto significa que la SRAM integrada en el chip no es intrínsecamente superior a cualquier otra arquitectura de memoria. Su valor depende del modelo y la carga de trabajo específicos, así como de si el sistema informático puede coordinar eficazmente el almacenamiento y la transferencia de datos.
¿Por qué es importante la ejecución determinista?
Otro elemento clave del diseño de Groq es la ejecución determinista. Con este enfoque arquitectónico, el compilador puede planificar por adelantado un gran número de operaciones informáticas y transferencias de datos, lo que permite que el procesador funcione conforme a una programación de ejecución predeterminada.
Por lo general, las GPU tradicionales deben admitir una gran variedad de tareas informáticas, programación dinámica y entornos de software complejos, lo que les proporciona una gran versatilidad. Groq, en cambio, intenta reducir parte de la incertidumbre asociada a la programación en tiempo de ejecución y a la coordinación de recursos mediante planes de ejecución más explícitos.
En la inferencia de baja latencia, la previsibilidad del tiempo de ejecución tiene un valor práctico. Cuando las empresas ofrecen servicios de IA en tiempo real, no solo les preocupa la velocidad media de respuesta, sino también la variación de la latencia entre distintas solicitudes. Si un servicio experimenta ocasionalmente retrasos importantes, la experiencia del usuario puede verse afectada aunque el rendimiento medio sea alto.
La ejecución determinista no significa que todas las solicitudes vayan a tener exactamente el mismo tiempo de respuesta. La latencia real también puede verse afectada por factores como la longitud de la entrada, la longitud de la salida, las estrategias de procesamiento por lotes, la carga del sistema y las condiciones de la red.
¿Cómo contribuye el compilador a optimizar el rendimiento de las LPU?
El enfoque tecnológico de Groq no depende únicamente del hardware para mejorar el rendimiento. Hace hincapié en el codesarrollo de hardware y software. El compilador debe analizar el grafo computacional del modelo y asignar las operaciones relevantes a los recursos de computación y almacenamiento del chip.
En este proceso, el compilador no solo se encarga de convertir el modelo en instrucciones ejecutables, sino también de organizar las transferencias de datos, las secuencias de computación y el uso de recursos para que las distintas unidades de computación puedan funcionar conjuntamente conforme a un plan predeterminado.
Este diseño permite una optimización profunda de los modelos compatibles, pero también exige mucho a la cadena de herramientas de software. Cuando cambian las estructuras de los modelos, los tipos de operadores o los requisitos de inferencia, la plataforma debe mejorar continuamente su compilador y su entorno de ejecución.
Por tanto, la competitividad tecnológica de Groq no procede únicamente del chip LPU, sino también de su compilador, sus capacidades de adaptación de modelos y la eficiencia coordinada de todo su sistema de inferencia.
¿Cómo convierte GroqCloud la computación LPU en un servicio comercial?
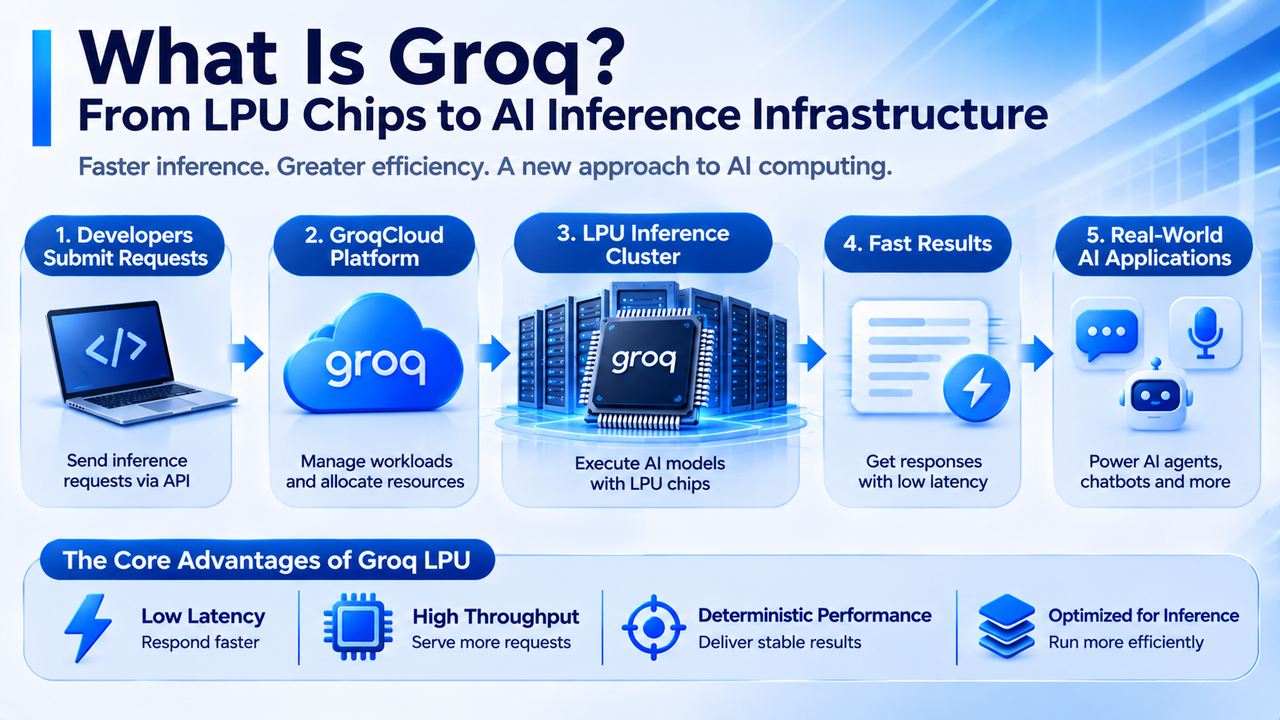
GroqCloud es el servicio de inferencia de IA en la nube de Groq para desarrolladores y empresas. Integra los chips subyacentes, los clústeres informáticos y los entornos de ejecución de modelos en servicios accesibles mediante API. Esto permite a los clientes utilizar la infraestructura de inferencia de Groq sin comprar ni desplegar ellos mismos chips especializados.
En una aplicación habitual, los desarrolladores seleccionan primero un modelo compatible con la plataforma y, a continuación, envían texto u otros tipos de entrada mediante una API. GroqCloud recibe la solicitud, asigna la tarea informática correspondiente al sistema de inferencia subyacente y devuelve el resultado generado a la aplicación. Este proceso incluye la programación de solicitudes, la ejecución del modelo, la gestión de recursos y la transmisión de resultados.
Para los clientes empresariales, el principal valor de utilizar un servicio de inferencia en la nube es que reduce las barreras de despliegue de la infraestructura. Crear un clúster informático de IA de forma independiente suele requerir comprar hardware, configurar redes, desplegar modelos y mantener el entorno de ejecución. El uso de un servicio de inferencia mediante API convierte parte de la inversión fija en infraestructura en un gasto de servicio que varía en función del uso empresarial.
La plataforma de Groq también se está ampliando desde una única API de inferencia hacia servicios de infraestructura empresarial más completos. Su cartera de productos incluye infraestructura informática especializada, una pila de software de inferencia y capacidades de gobernanza y control a nivel empresarial para satisfacer los distintos requisitos de los clientes en materia de rendimiento, métodos de despliegue y permisos de gestión.
Sin embargo, el valor comercial de un servicio de inferencia en la nube no depende exclusivamente de la velocidad del chip. Las empresas también deben considerar la compatibilidad de modelos, la estabilidad de la API, la disponibilidad del servicio, la seguridad de los datos y el coste por solicitud. Si una plataforma solo admite una gama limitada de modelos u operadores, puede no satisfacer todos los requisitos de las aplicaciones empresariales, aunque ofrezca una baja latencia en tareas específicas.
En cuanto a los modelos de ingresos, los servicios de inferencia en la nube suelen cobrar en función del uso del modelo, del número de tokens procesados o de la capacidad informática reservada. Los distintos métodos de tarificación generan diferentes requisitos de gestión de recursos. La facturación basada en el uso depende en mayor medida del volumen real de solicitudes, mientras que los servicios con capacidad reservada requieren prestar atención a los contratos con clientes, la prestación de recursos y la utilización de los equipos.
Por tanto, la capacidad de GroqCloud para comercializar su tecnología depende, en última instancia, de si puede convertir las ventajas de rendimiento subyacentes de las LPU en servicios de inferencia estables, escalables y competitivos en costes.
¿Cómo cambia la asociación de Groq con NVIDIA su posicionamiento en el sector?
La relación de Groq con NVIDIA constituye un antecedente importante para comprender su posicionamiento actual en el sector.
En diciembre de 2025, Groq y NVIDIA suscribieron un acuerdo no exclusivo de licencia de tecnología de inferencia de IA. Según la información divulgada por ambas partes, NVIDIA obtuvo una licencia sobre la tecnología de inferencia pertinente de Groq, mientras que el fundador de Groq, Jonathan Ross, el entonces presidente, Sunny Madra, y algunos miembros del equipo se incorporaron a NVIDIA. Groq continuó operando como empresa independiente bajo la dirección de su director ejecutivo, Simon Edwards, y su negocio GroqCloud siguió operativo.
Esta operación significa que el valor de la tecnología de Groq se refleja no solo en la venta independiente de servicios de inferencia, sino también en su entrada en el ecosistema más amplio de la computación para IA mediante la concesión de licencias tecnológicas.
En marzo de 2026, NVIDIA presentó además la arquitectura de aceleración de inferencia Groq 3 LPX y la combinó con la plataforma Vera Rubin. La solución relacionada intenta asignar las cargas de trabajo entre GPU y LPU en función de las características informáticas de las distintas etapas de la inferencia de IA, con el objetivo de mejorar la eficiencia de la inferencia de baja latencia. Esta evolución refleja la creciente complejidad de la competencia en el mercado de chips para IA. En el pasado, los chips especializados de inferencia se consideraban a menudo posibles sustitutos de las GPU. Sin embargo, en las arquitecturas informáticas heterogéneas, los distintos tipos de procesadores también pueden desempeñar funciones complementarias.
Por ejemplo, las GPU pueden encargarse de la computación paralela a gran escala y de determinados cálculos de atención adecuados para su arquitectura, mientras que las LPU pueden gestionar tareas informáticas más sensibles al tiempo de ejecución y a la latencia de transferencia de datos. Mediante la programación a nivel de sistema, ambos tipos de procesadores pueden trabajar conjuntamente en una misma carga de inferencia.
No obstante, las arquitecturas heterogéneas también introducen una complejidad de ingeniería adicional. Los sistemas deben coordinar las transferencias de datos, la asignación de tareas y la gestión de memoria entre distintos dispositivos. Si la sobrecarga de comunicación entre dispositivos es demasiado elevada, las ventajas teóricas del hardware pueden no traducirse plenamente en un rendimiento práctico.
En agosto de 2026, Groq también anunció su incorporación al programa NVIDIA Cloud Partner, lo que reforzó aún más su posicionamiento como operador de infraestructura de nube para IA. Por tanto, Groq ya no puede describirse simplemente como una empresa de chips completamente independiente del ecosistema de NVIDIA y centrada únicamente en competir con las GPU. Su actividad actual incluye servicios independientes de inferencia en la nube, tecnología de chips especializados y cooperación en infraestructura con NVIDIA.
¿Cómo adapta Groq su modelo de negocio al crecimiento del mercado de inferencia de IA?
La demanda comercial del mercado de inferencia de IA procede principalmente de las aplicaciones empresariales, los servicios para desarrolladores y los productos de IA que funcionan de manera continua. A diferencia del entrenamiento de modelos, que generalmente se lleva a cabo por proyectos y en etapas, los servicios de inferencia deben proporcionar capacidad informática de forma continua a medida que cambia el tráfico de usuarios. Por ello, conceden mayor importancia a la utilización de recursos, los costes unitarios y la estabilidad del servicio.
El modelo de negocio de Groq puede entenderse en tres niveles.
- Construcción de infraestructura de inferencia. Groq necesita crear capacidad informática utilizable mediante chips, servidores, redes y centros de datos. Estos activos solo pueden atender las solicitudes de los clientes y generar ingresos después del despliegue de los equipos, la adaptación de los modelos y el lanzamiento del servicio.
- Servicios de inferencia en la nube. GroqCloud convierte la capacidad informática en API que los desarrolladores pueden utilizar, sin que los clientes tengan que gestionar directamente los chips subyacentes. Para el proveedor del servicio, el crecimiento de los ingresos depende del número de clientes, el volumen de solicitudes, los precios del servicio y la retención de clientes.
- Servicios de infraestructura empresarial. Algunas empresas pueden necesitar recursos informáticos dedicados, métodos de despliegue específicos o requisitos de gobernanza más estrictos. Estas necesidades pueden generar relaciones más estables y a largo plazo con los clientes, pero también requieren una mayor inversión en ingeniería, operaciones y atención al cliente.
En junio de 2026, Groq anunció que había obtenido 650 millones de dólares en financiación para expandir su negocio global de nube de inferencia de IA, con el objetivo de alcanzar aproximadamente 200 MW de capacidad de infraestructura para 2027. En ese momento, la empresa declaró que operaba 13 centros de datos en varias regiones, prestaba servicio a más de 5 millones de desarrolladores y procesaba decenas de billones de tokens de IA cada semana.
Estas cifras pueden utilizarse para observar el ritmo de expansión del negocio, pero no demuestran directamente su rentabilidad. El número de desarrolladores, el volumen de tokens y el número de centros de datos reflejan, respectivamente, el alcance entre los usuarios, la actividad del servicio y la escala de la infraestructura. No equivalen a los ingresos reales, los beneficios ni el flujo de caja libre.
Por ejemplo, supongamos que el número de tokens procesados cada mes por una plataforma de inferencia aumenta un 100 %, pero que el precio por token disminuye un 40 % debido a la competencia del mercado. En ese caso, el crecimiento de sus ingresos podría ser inferior al crecimiento del uso. Si los costes de construcción y operación de la infraestructura también aumentan durante el mismo periodo, los márgenes de beneficio podrían verse aún más afectados.
Por tanto, el análisis del potencial de comercialización de Groq requiere considerar simultáneamente el crecimiento de la demanda de inferencia, los precios de los servicios, la utilización de los equipos y los gastos de capital. El valor de mercado no puede evaluarse únicamente en función de la velocidad de ejecución de los modelos.
¿A qué desafíos técnicos y de escalabilidad se enfrenta Groq?
Aunque los chips especializados de inferencia pueden optimizarse para cargas de trabajo específicas, Groq sigue enfrentándose a desafíos derivados de los cambios en los modelos, la escalabilidad del hardware y la competencia del mercado.
Adaptación de modelos. Las arquitecturas de los modelos de IA siguen evolucionando rápidamente. Los distintos modelos pueden utilizar diferentes mecanismos de atención, escalas de parámetros, precisiones computacionales y estrategias de inferencia. Si un procesador especializado pretende admitir más modelos, su compilador, entorno de ejecución y herramientas de software relacionadas deben actualizarse continuamente.
Esto también significa que una ventaja de rendimiento conseguida por una generación de chips en un modelo específico puede no trasladarse directamente a todos los modelos nuevos. A medida que evolucionan la inferencia con contextos largos, los modelos de mezcla de expertos y la computación multimodal, los sistemas informáticos subyacentes deben adaptarse continuamente a nuevas cargas de trabajo.
Escalabilidad entre varios chips. Las LPU de Groq hacen hincapié en la SRAM integrada en el chip y la ejecución determinista, pero los modelos grandes suelen requerir recursos de almacenamiento y computación que superan la capacidad de un solo chip. Cuando un modelo se distribuye entre varios chips, el sistema debe coordinar las transferencias de datos y las secuencias de computación entre los dispositivos.
Si la comunicación entre varios chips no es eficiente, la ventaja de baja latencia de un solo chip puede reducirse. Por tanto, las interconexiones entre chips, el ancho de banda del sistema y las capacidades de programación del compilador son factores importantes para determinar si una arquitectura especializada de inferencia puede escalar.
Costes de construcción de la infraestructura. Aunque los chips ofrezcan una alta eficiencia informática, la construcción de un centro de datos de IA sigue requiriendo conexiones eléctricas, espacio en las instalaciones, sistemas de refrigeración e infraestructura de red. A medida que sus servicios de inferencia se expandan, Groq también tendrá que asumir los correspondientes costes de capital y operativos.
Competencia del mercado. Las GPU de NVIDIA, las GPU de AMD, las TPU de Google y otros aceleradores especializados de IA compiten por la demanda de computación de inferencia. Cada plataforma puede tener ventajas distintas en materia de compatibilidad de modelos, rendimiento, latencia, costes y ecosistemas de software.
Para los clientes empresariales, la elección final generalmente no está determinada por una única métrica de rendimiento. Depende de los costes totales del servicio, la compatibilidad con las aplicaciones y la fiabilidad operativa a largo plazo. Por tanto, la capacidad del enfoque tecnológico de Groq para establecer una competitividad sostenida depende no solo de la arquitectura LPU, sino también de si la empresa puede seguir ampliando la compatibilidad de software, mejorar la utilización de los recursos informáticos y controlar el coste de la expansión de la infraestructura.
¿Qué implica Groq para los chips de IA y la industria informática?
El enfoque tecnológico representado por Groq refleja el cambio gradual de la industria de la computación para IA, que pasa de arquitecturas centradas en aceleradores de uso general a sistemas informáticos heterogéneos optimizados para distintas cargas de trabajo. En las primeras etapas del desarrollo de la IA generativa, las capacidades de entrenamiento fueron un motor importante del progreso del sector. A medida que más modelos entran en aplicaciones prácticas, los servicios de inferencia comienzan a generar una demanda informática continua, lo que incrementa los requisitos empresariales de baja latencia, eficiencia de costes y estabilidad del servicio.
Esto crea oportunidades para el desarrollo de chips especializados de inferencia. Al optimizar el hardware y el software para procesos informáticos específicos, las arquitecturas especializadas pueden lograr ventajas de rendimiento o de costes en determinadas tareas.
Sin embargo, esto no significa que las GPU vayan a ser sustituidas por completo por chips especializados de inferencia. Las GPU cuentan con amplios ecosistemas de software, una extensa compatibilidad con modelos y capacidades informáticas de uso general, lo que les permite adaptarse a diversas cargas de trabajo de entrenamiento e inferencia. En cambio, los aceleradores especializados pueden desempeñar un papel en modelos, etapas informáticas o escenarios de baja latencia concretos.
La cooperación tecnológica entre NVIDIA y Groq sugiere además que los futuros centros de datos de IA podrían desplegar simultáneamente distintos tipos de dispositivos informáticos y coordinarlos mediante sistemas de programación de software. Este enfoque podría mejorar la utilización de los recursos informáticos, pero también aumentaría la complejidad del diseño y la gestión de los sistemas.
Para la industria de la infraestructura de IA, el foco de la competencia puede ampliarse gradualmente desde el rendimiento teórico de los chips individuales hasta la capacidad de ofrecer sistemas informáticos completos. El rendimiento de los chips, el ancho de banda de la memoria, las interconexiones entre dispositivos, los compiladores, la eficiencia energética y las operaciones de los servicios en la nube pueden afectar al rendimiento comercial final.
El desarrollo de Groq también demuestra que la infraestructura de inferencia de IA no es simplemente una cuestión de fabricación de chips. Es una industria integrada que abarca la arquitectura de hardware, la optimización de software, la construcción de centros de datos y la prestación de servicios comerciales.
Conclusión
Groq es una empresa tecnológica centrada en la computación para la inferencia de IA. Su arquitectura LPU utiliza elementos de diseño como la SRAM integrada en el chip, la ejecución determinista y la programación del compilador para mejorar la eficiencia de ejecución en cargas de trabajo específicas de IA. GroqCloud convierte las capacidades informáticas subyacentes en servicios de inferencia en la nube, lo que permite a desarrolladores y empresas utilizar la infraestructura correspondiente mediante API.
A medida que las aplicaciones de IA se extienden más allá del entrenamiento de modelos hacia la interacción en tiempo real, los agentes de IA y los servicios empresariales de funcionamiento continuo, la latencia de inferencia, el rendimiento y los costes se están convirtiendo en métricas técnicas cada vez más importantes. La arquitectura especializada de inferencia representada por Groq ofrece a la industria de la computación para IA un enfoque alternativo a las GPU de uso general.
Al mismo tiempo, la concesión de licencias tecnológicas y la cooperación en infraestructura entre Groq y NVIDIA demuestran que los chips especializados de inferencia y las GPU no tienen por qué ser exclusivamente competidores. Los futuros centros de datos de IA podrían adoptar cada vez más arquitecturas informáticas heterogéneas, en las que distintos procesadores se encarguen de tareas adecuadas a sus respectivas características.
No obstante, las ventajas técnicas de los chips especializados no se traducen automáticamente en éxito comercial. Groq todavía debe abordar la adaptación de modelos, la escalabilidad entre varios chips, los costes de infraestructura y la rentabilidad de los servicios en la nube. Su desarrollo a largo plazo dependerá de si puede convertir sus ventajas de rendimiento en inferencia en una demanda estable de los clientes, ingresos sostenibles y un rendimiento razonable del capital.
Preguntas frecuentes
¿Qué tipo de empresa es Groq?
Groq es una empresa tecnológica centrada en la computación para la inferencia de IA. Sus principales áreas de negocio incluyen los procesadores especializados LPU, los sistemas de computación para inferencia y los servicios de inferencia en la nube de GroqCloud.
¿Groq y Grok son el mismo producto?
No. Groq es una empresa tecnológica relacionada con la infraestructura de inferencia de IA, mientras que Grok es un modelo de inteligencia artificial y un producto de asistencia desarrollado por xAI.
¿Qué es la LPU de Groq?
La LPU es un procesador especializado de inferencia de IA diseñado por Groq. Hace hincapié en la SRAM integrada en el chip, la ejecución determinista, la programación del compilador y la computación de baja latencia.
¿En qué se diferencia la LPU de Groq de una GPU de NVIDIA?
Las LPU se centran más en optimizar la computación y la transferencia de datos para tareas de inferencia específicas, mientras que las GPU ofrecen capacidades más amplias de computación paralela y ecosistemas de software más extensos. El rendimiento real depende del modelo, el tamaño del lote, los requisitos de latencia y el entorno de despliegue.
¿NVIDIA adquirió Groq?
En noviembre de 2026, Groq continúa operando como empresa independiente. Ambas partes suscribieron un acuerdo no exclusivo de licencia tecnológica en diciembre de 2025, y algunos miembros del equipo de Groq se incorporaron a NVIDIA. Esto no significa que NVIDIA completara una adquisición total de Groq.
¿Qué es GroqCloud?
GroqCloud es el servicio de inferencia de IA en la nube de Groq. Permite a los desarrolladores utilizar mediante API los modelos compatibles con la plataforma sin comprar ni desplegar ellos mismos el hardware informático subyacente.
¿Por qué Groq ha atraído la atención del mercado de la computación para IA?
El enfoque tecnológico de Groq optimiza la latencia, la transferencia de datos y la eficiencia de ejecución en la inferencia de IA. Esto se ajusta a los requisitos de eficiencia informática de las aplicaciones de IA en tiempo real, los agentes de IA y los servicios empresariales de inferencia.
¿Tiene Groq su propia criptomoneda?
Groq es una empresa de infraestructura de computación para IA. Sus negocios de LPU y GroqCloud no dependen de un token de criptomoneda nativo. Los tokens de terceros con nombres similares no deben considerarse directamente activos emitidos o respaldados por Groq.