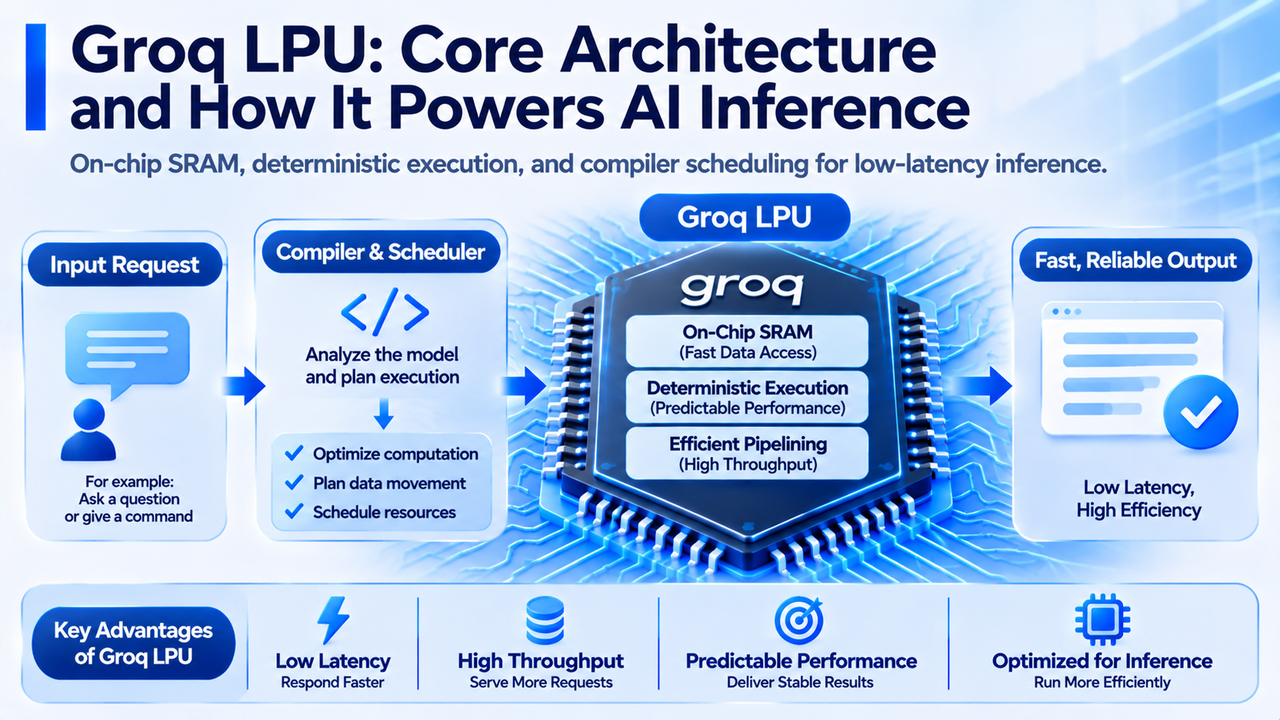
A diferencia de las GPU, diseñadas para una amplia variedad de tareas de computación masivamente paralela, las LPU de Groq utilizan una arquitectura que prioriza la SRAM integrada en el chip, la planificación estática del compilador y la ejecución determinista. Este enfoque busca reducir la transferencia de datos y la sobrecarga de planificación en tiempo de ejecución durante la inferencia, proporcionando capacidades de computación más específicas para aplicaciones de IA en tiempo real.
A medida que los modelos de lenguaje de gran tamaño se utilizan cada vez más en atención al cliente inteligente, interacciones de voz, agentes de IA y automatización empresarial, los requisitos de inferencia van más allá de maximizar la velocidad de procesamiento e incluyen la latencia de respuesta, la estabilidad del servicio y los costes de computación por unidad. El enfoque de aceleradores especializados representado por las LPU de Groq ofrece a la infraestructura de IA una opción técnica distinta de las arquitecturas de computación tradicionales de propósito general. Este artículo presenta en profundidad el funcionamiento de las LPU de Groq, analiza cómo la SRAM, la ejecución determinista y los compiladores afectan al rendimiento de la inferencia, y aborda sus escenarios de aplicación y limitaciones técnicas.
Puntos clave:
-
Groq LPU es un procesador especializado diseñado para cargas de trabajo de inferencia de IA, con énfasis en una baja latencia, una ejecución predecible y una transferencia de datos eficiente.
-
La inferencia de modelos de lenguaje de gran tamaño suele constar de dos etapas: prellenado y decodificación. Estas etapas tienen distintos requisitos de capacidad de computación y ancho de banda de memoria.
-
Las LPU de Groq utilizan SRAM integrada en el chip para acortar determinadas rutas de acceso a datos, pero su capacidad de almacenamiento integrada relativamente limitada también plantea requisitos para el despliegue de modelos y el escalado con varios chips.
-
La ejecución determinista y la planificación estática del compilador pueden reducir parte de la sobrecarga de planificación en tiempo de ejecución, pero no implican que cada solicitud tenga exactamente el mismo tiempo de respuesta.
-
Las LPU presentan posibles ventajas en aplicaciones de baja latencia, como la generación de texto en tiempo real y las interacciones de voz. Su rendimiento real sigue dependiendo del modelo, la carga de trabajo, la configuración del sistema y el precio del servicio.
¿Qué es Groq LPU? ¿En qué se diferencia de los aceleradores de IA tradicionales?
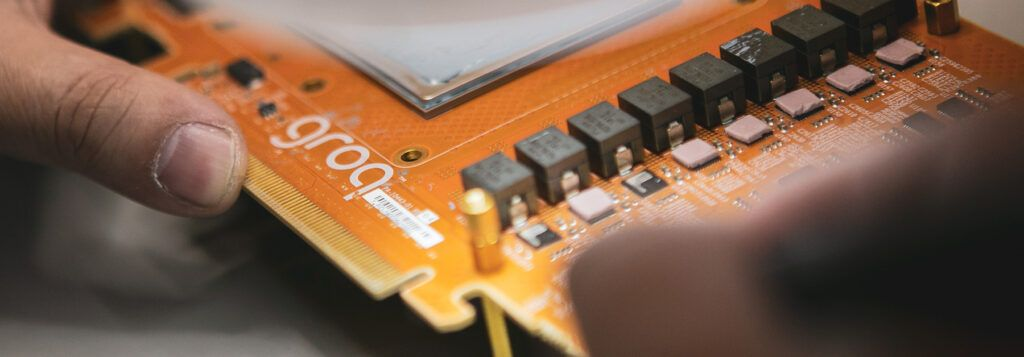
Groq LPU es un procesador especializado de inferencia de IA diseñado por Groq. LPU significa Language Processing Unit. Su diseño está destinado a optimizar el movimiento de datos, la ejecución de cálculos y el control de la latencia en la inferencia de modelos de lenguaje, en lugar de proporcionar capacidades de computación de propósito general para todo tipo de tareas.
Para comprender el posicionamiento técnico de las LPU, primero es necesario reconocer los distintos enfoques de diseño utilizados por los aceleradores de IA. Las GPU se diseñaron originalmente principalmente para el procesamiento gráfico. Posteriormente, se adoptaron ampliamente para el entrenamiento y la inferencia de aprendizaje profundo debido a sus capacidades de computación paralela a gran escala y a su ecosistema de software consolidado. Los aceleradores especializados, como las TPU, mejoran la eficiencia de ejecución de tareas de computación específicas al optimizar operaciones para el aprendizaje automático.
Las LPU de Groq ponen aún más énfasis en la coordinación entre el compilador y el hardware. Su arquitectura busca planificar el cálculo y la transferencia de datos antes de ejecutar un modelo, lo que permite al chip completar las tareas conforme a una programación predeterminada y reducir así parte de la sobrecarga generada por la planificación dinámica.
Este enfoque de diseño está estrechamente relacionado con la dirección tecnológica Tensor Streaming Processor (TSP) introducida por Groq durante sus primeras etapas de desarrollo. Al organizar los recursos de computación, el almacenamiento integrado en el chip y las rutas de transferencia de datos, el procesador permite que las operaciones del modelo se ejecuten en la secuencia organizada por el compilador.
Es importante señalar que LPU no es una categoría industrial estandarizada para todos los procesadores de modelos de lenguaje. Es un nombre técnico utilizado por Groq. Distintos fabricantes pueden emplear diferentes diseños de chips o lograr una inferencia de baja latencia mediante GPU, ASIC u otros aceleradores especializados.
Por tanto, evaluar el valor técnico de las LPU de Groq requiere más que considerar el nombre del procesador. Es necesario analizar cómo gestionan el acceso a datos, la planificación de cálculos y la comunicación entre varios chips durante la inferencia.
¿Por qué los modelos de lenguaje de gran tamaño necesitan computación de baja latencia?
La inferencia de modelos de lenguaje de gran tamaño se refiere al proceso mediante el cual un modelo recibe una entrada y utiliza sus parámetros entrenados para generar una salida. En los modelos de lenguaje autorregresivos habituales, la inferencia suele constar de dos etapas: prellenado y decodificación. La etapa de prellenado procesa principalmente la instrucción del usuario y establece el estado computacional necesario para la generación posterior. Como esta etapa puede procesar simultáneamente varios tokens de entrada, suele presentar características de computación paralela sólidas.
La etapa de decodificación genera tokens de salida de uno en uno. El modelo normalmente necesita predecir el siguiente token basándose en la entrada existente y el contenido generado previamente, por lo que existen dependencias entre varios pasos de generación. Como resultado, estos pasos no pueden paralelizarse completamente con la misma facilidad que algunos cálculos de entrenamiento.
Esta diferencia implica que el rendimiento de la inferencia no puede medirse con una única métrica.
El tiempo hasta el primer token (TTFT) mide el tiempo desde el inicio de una solicitud hasta la generación del primer token de salida. Afecta principalmente al tiempo que los usuarios perciben que deben esperar para recibir una respuesta.
La velocidad de generación de tokens mide cuántos tokens puede generar un modelo por unidad de tiempo después de comenzar a producir una salida. Afecta directamente a la fluidez de la generación continua de texto. El rendimiento se centra en cuántas solicitudes o tokens puede procesar un sistema durante un periodo determinado y refleja la capacidad general de procesamiento de un servicio de inferencia bajo una carga concurrente relativamente alta.
Por ejemplo, dos plataformas de inferencia pueden ejecutar el mismo modelo de lenguaje, pero la plataforma A puede ofrecer una generación de tokens más rápida para la solicitud de un único usuario, mientras que la plataforma B puede lograr un mayor rendimiento general al procesar cientos de solicitudes simultáneamente.
Esto significa que la baja latencia y el alto rendimiento no son exactamente el mismo objetivo de rendimiento. Un sistema optimizado para la interacción en tiempo real con un único usuario puede no presentar las mismas ventajas en todos los escenarios de procesamiento por lotes o alta concurrencia.
Para asistentes de voz, traducción en tiempo real y aplicaciones de IA interactivas, el TTFT y la velocidad de generación continua son especialmente importantes. Los usuarios normalmente esperan que el sistema comience a responder rápidamente y continúe produciendo contenido natural y fluido.
Para tareas como el análisis de documentos sin conexión y el procesamiento de datos por lotes, el tiempo de respuesta inmediato de una solicitud individual puede ser menos importante. En su lugar, las empresas pueden centrarse más en el rendimiento general y los costes de procesamiento por unidad.
Una de las prioridades de diseño de las LPU de Groq es optimizar la eficiencia de ejecución para cargas de trabajo de inferencia sensibles al tiempo de respuesta.
¿Cómo utilizan las LPU de Groq la SRAM para mejorar la eficiencia del acceso a datos?
El rendimiento de los procesadores de IA modernos no depende únicamente de cuántas operaciones pueden realizar sus unidades de cálculo, sino también de si los datos pueden llegar a dichas unidades a tiempo.
Durante la inferencia de modelos de lenguaje de gran tamaño, los procesadores leen repetidamente los pesos del modelo, acceden a resultados intermedios y mantienen datos relacionados con el contexto. Si los datos no pueden leerse con suficiente rapidez, incluso un chip con una elevada capacidad de computación teórica puede no funcionar a plena capacidad porque está esperando datos.
Este problema se conoce habitualmente como cuello de botella de memoria.
Una de las principales características arquitectónicas de las LPU de Groq es su énfasis en el uso de SRAM integrada en el chip (memoria estática de acceso aleatorio) para el almacenamiento y acceso a datos.
La SRAM suele ofrecer una baja latencia de acceso y puede integrarse directamente en el chip del procesador. En comparación con los datos a los que se accede mediante una interfaz de memoria externa, el almacenamiento integrado en el chip puede acortar las rutas de transferencia de datos y reducir parte de la sobrecarga de acceso.
Para comprender este diseño, resulta útil comparar las características básicas de la SRAM y la memoria de alto ancho de banda (HBM).
| Dimensión de comparación |
SRAM |
HBM |
| Ubicación habitual |
Dentro del chip del procesador |
Una pila de memoria independiente dentro del encapsulado del procesador |
| Ventajas principales |
Baja latencia de acceso e integración estrecha |
Mayor capacidad y elevado ancho de banda agregado |
| Limitaciones principales |
Coste elevado de superficie y capacidad limitada |
El acceso a datos sigue requiriendo una interfaz de memoria |
| Usos habituales |
Caché y memoria de trabajo integrada en el chip |
Datos a gran escala, como pesos del modelo y activaciones |
| Relevancia para la inferencia |
Optimiza determinadas rutas de acceso a datos |
Admite modelos y estados computacionales de mayor tamaño |
Sin embargo, no puede suponerse simplemente que la SRAM sea más rápida que la HBM en todas las situaciones o que el uso de SRAM elimine el cuello de botella de memoria. El rendimiento real también depende de la disposición de los datos, los patrones de acceso paralelo, el ancho de banda de memoria y la arquitectura del modelo.
Las principales limitaciones de la SRAM son su densidad de almacenamiento y el coste de superficie del chip. Para modelos de lenguaje con un gran número de parámetros, la SRAM de un único procesador generalmente no es suficiente para almacenar todos los pesos del modelo y estados de ejecución.
Por ello, Groq necesita utilizar coordinación entre varios chips y asignación de datos a nivel de sistema para ejecutar modelos en sistemas de computación de mayor tamaño. Esto significa que las ventajas de las LPU no provienen por completo de la SRAM de un chip individual. Más bien, son el resultado del diseño conjunto del almacenamiento integrado en el chip, las canalizaciones de computación, las interconexiones entre chips y los compiladores.
¿Cómo afectan la ejecución determinista y la planificación del compilador al rendimiento de la inferencia?
La ejecución determinista es otro concepto fundamental para comprender la arquitectura Groq LPU. Su idea central consiste en determinar en la mayor medida posible el orden de ejecución de las operaciones de cálculo, las rutas de transferencia de datos y la asignación de recursos antes de que se ejecute un programa, reduciendo la necesidad de tomar decisiones temporales de planificación durante la ejecución.
En las arquitecturas de computación tradicionales de propósito general, los procesadores deben adaptarse a distintos tipos de programas y cargas de trabajo. Para mejorar el uso de los recursos, los sistemas suelen incluir planificación dinámica de tareas, gestión de caché y otros mecanismos de tiempo de ejecución. Estos diseños proporcionan una flexibilidad considerable, pero también pueden introducir una sobrecarga adicional de planificación.
Las LPU de Groq utilizan un enfoque de diseño diferente. Antes de ejecutar un modelo, el compilador analiza su grafo computacional y crea un plan de ejecución para las operaciones de cálculo y el movimiento de datos. El procesador se ejecuta posteriormente conforme a este plan, lo que permite que los datos se desplacen de forma ordenada entre distintas unidades de cálculo. Por ejemplo, un modelo de lenguaje puede necesitar realizar continuamente operaciones matriciales, funciones de activación y otros cálculos. El compilador puede organizar de antemano cuándo se ejecutarán estas tareas en distintos recursos de computación y coordinar las transferencias de datos necesarias.
Este enfoque es similar a planificar cada paso de una línea de producción con antelación para que las diferentes etapas puedan trabajar juntas según un ritmo predeterminado.
Para la inferencia de IA, la ejecución determinista tiene tres implicaciones principales.
-
Puede reducir parte de la sobrecarga de planificación en tiempo de ejecución. El procesador no necesita volver a determinar el orden de ejecución de cada tarea en cada etapa de cálculo, lo que puede ayudar a mejorar la eficiencia de ejecución para cargas de trabajo específicas.
-
Puede hacer que los tiempos de ejecución de los cálculos sean más predecibles. Para los servicios de IA en tiempo real, un rendimiento de respuesta uniforme es tan importante como una baja latencia media. La ejecución determinista no significa que el tiempo de respuesta de las solicitudes reales de API sea completamente fijo. La longitud de la entrada, el número de tokens de salida, la cola de solicitudes, la transmisión de red y la carga del servicio aún pueden causar diferencias en la latencia de extremo a extremo.
-
La planificación estática también puede reducir la flexibilidad de algunas tareas de cálculo. Si un modelo tiene un flujo de control dinámico complejo o la ruta de ejecución debe cambiar con frecuencia en función de resultados en tiempo real, el compilador puede necesitar utilizar estrategias de procesamiento adicionales.
Por tanto, el valor de la ejecución determinista no consiste en eliminar toda la incertidumbre. Más bien, para tareas de cálculo adecuadas, mejora la eficiencia de utilización de los recursos de hardware mediante una planificación de ejecución más explícita.
¿Por qué las LPU de Groq son adecuadas para la inferencia de IA de baja latencia?
El diseño de baja latencia de las LPU de Groq no depende de una única tecnología. Es el resultado de los efectos combinados de la SRAM integrada en el chip, la ejecución determinista, la optimización del compilador y las interconexiones a nivel de sistema. Durante la generación de modelos de lenguaje de gran tamaño, el modelo debe realizar cálculos continuamente y generar tokens posteriores basándose en los resultados existentes. Si un procesador puede reducir parte de los retrasos en el acceso a datos y de la sobrecarga de planificación en tiempo de ejecución, puede acortar el tiempo necesario para los pasos de generación sucesivos.
Esto es especialmente relevante para la etapa de decodificación. Como los modelos autorregresivos generalmente necesitan generar tokens de uno en uno, la latencia de cada paso de generación se acumula y acaba afectando a la velocidad de salida de texto que perciben los usuarios. Sin embargo, los cuellos de botella de rendimiento de las distintas tareas de inferencia no siempre son los mismos. El procesamiento de instrucciones largas puede depender más de las capacidades de computación paralela a gran escala, mientras que la generación continua puede verse más afectada por el acceso a memoria y la latencia de ejecución paso a paso.
Por tanto, el rendimiento real de las LPU de Groq debe evaluarse en combinación con el tipo de modelo, la longitud de entrada, la longitud de salida y el número de solicitudes simultáneas.
Desde la perspectiva de las aplicaciones, los siguientes tipos de servicios son especialmente sensibles a la inferencia de baja latencia.
Interacciones de voz en tiempo real. Un asistente de voz necesita convertir el habla del usuario en texto, llamar a un modelo de lenguaje para generar una respuesta y, posteriormente, producir el resultado mediante síntesis de voz. Si el modelo de lenguaje genera respuestas lentamente, la conversación puede experimentar pausas perceptibles.
Agentes de IA interactivos. Al realizar tareas, un agente de IA puede necesitar llamar a un modelo de lenguaje varias veces para determinar la siguiente acción. Cada retraso de inferencia afecta al tiempo total de finalización de la tarea, por lo que reducir el tiempo de espera de las inferencias individuales puede mejorar la experiencia del usuario.
Atención al cliente inteligente y aplicaciones en tiempo real. Los servicios en línea que atienden a un gran número de usuarios no solo deben responder rápidamente, sino también controlar las fluctuaciones de latencia entre solicitudes para mantener una calidad de servicio estable.
Sin embargo, una baja latencia no implica necesariamente el menor coste de computación por unidad. Por ejemplo, una plataforma de inferencia puede procesar una solicitud individual a gran velocidad, pero si su coste de adquisición de hardware es elevado o una cantidad significativa de recursos permanece inactiva con cargas bajas, su coste real de servicio por millón de tokens puede seguir superando al de otras soluciones. Por el contrario, otra plataforma puede generar tokens más lentamente para solicitudes individuales, pero atender a muchos usuarios simultáneamente mediante procesamiento por lotes y, en última instancia, lograr un coste medio inferior.
Por tanto, al seleccionar una plataforma de inferencia, las empresas deben equilibrar la latencia, el rendimiento, el coste y la compatibilidad de modelos, en lugar de tomar una decisión basándose únicamente en los tokens por segundo.
¿Cuáles son las limitaciones técnicas de las LPU de Groq?
Aunque las LPU de Groq están optimizadas específicamente para la inferencia de IA, una arquitectura especializada no implica que supere a otras soluciones en todas las tareas de cálculo. Sus principales limitaciones técnicas se relacionan con la capacidad de memoria, el escalado con varios chips, la compatibilidad de modelos y el coste del sistema.
Limitaciones de capacidad de la SRAM integrada en el chip. Debido a que la SRAM tiene una densidad de almacenamiento relativamente baja, la cantidad de almacenamiento integrado disponible en un único chip es limitada. Cuando los parámetros del modelo y los estados de ejecución superan la capacidad de un único chip, el cálculo y los datos deben distribuirse entre un sistema de varios chips.
Por ejemplo, un modelo de lenguaje de gran tamaño puede requerir decenas de gigabytes o más de almacenamiento. Generalmente es difícil almacenar todos estos datos utilizando únicamente la SRAM integrada en el chip de un solo chip. Por ello, el sistema debe distribuir el modelo entre varios procesadores y utilizar interconexiones entre chips para realizar los intercambios de datos necesarios.
Este enfoque puede aumentar el tamaño de los modelos que pueden desplegarse, pero también incrementa la complejidad del diseño del sistema.
Sobrecarga de comunicación entre varios chips. Incluso si una LPU individual puede ejecutar cálculos rápidamente, la velocidad total de inferencia puede verse afectada por el ancho de banda de interconexión, la latencia de comunicación y las estrategias de asignación de datos cuando el modelo requiere transferencias frecuentes de datos entre chips. En sistemas de inferencia a gran escala, el rendimiento no depende únicamente de la capacidad de cálculo de un procesador individual, sino también del funcionamiento coordinado de todo el clúster de chips.
Compatibilidad de modelos. Las LPU de Groq dependen de compiladores para asignar los cálculos del modelo al hardware especializado y, por tanto, requieren el correspondiente soporte de software. Cuando nuevos modelos de IA introducen diferentes operadores de cálculo, mecanismos de atención o métodos de ejecución dinámica, la plataforma puede necesitar actualizar su compilador y su entorno de ejecución. En comparación con las GPU de propósito general, que cuentan con ecosistemas de software amplios, los procesadores de inferencia especializados requieren un desarrollo continuo de software para adaptarse a tecnologías de modelos que cambian rápidamente.
Costes de infraestructura y comerciales. Las ventajas de rendimiento de las LPU requieren un sistema de computación completo. El despliegue real sigue implicando costes de fabricación de chips, servidores, redes, energía e instalaciones de refrigeración. Para los proveedores de servicios de inferencia en la nube, la utilización de los equipos y la demanda de los clientes también determinan el retorno de la inversión.
Por tanto, las LPU de Groq deben evaluarse junto con sus condiciones reales de despliegue. Una elevada velocidad de generación de tokens en una prueba concreta no demuestra directamente una mayor eficiencia de costes en todos los modelos y escenarios comerciales.
¿Qué significan las LPU de Groq para el futuro de la infraestructura de inferencia de IA?
El desarrollo de las LPU de Groq refleja la creciente especialización del mercado de computación de IA. A medida que se expanden las aplicaciones de IA generativa, las empresas comienzan a seleccionar arquitecturas de computación más especializadas en función de las distintas cargas de trabajo, en lugar de centrarse únicamente en el rendimiento máximo teórico de un único procesador.
En el entrenamiento de modelos, la computación paralela a gran escala, la capacidad de memoria y la comunicación entre múltiples dispositivos siguen siendo importantes. En la inferencia, el TTFT, la velocidad de generación continua, el rendimiento concurrente y el coste por token se han convertido en métricas comerciales más directas.
Las diferencias entre las tareas de cálculo crean espacio para el desarrollo de chips de inferencia especializados. Al mismo tiempo, los procesadores especializados y las GPU no tienen necesariamente una relación puramente sustitutiva. En marzo de 2026, NVIDIA presentó una arquitectura de inferencia que combina Groq 3 LPX con la plataforma Vera Rubin, explorando cómo distintos tipos de dispositivos de computación pueden gestionar tareas de inferencia adecuadas para sus respectivas características.
Esta dirección refleja la tendencia de desarrollo de la computación heterogénea. En el futuro, los centros de datos de IA pueden desplegar simultáneamente GPU, aceleradores de inferencia especializados y otros dispositivos de computación, mientras los sistemas de software coordinan la ejecución de diferentes tareas.
Por ejemplo, pueden utilizarse recursos de GPU adecuados para cargas de trabajo que requieren procesamiento paralelo a gran escala, mientras que los procesadores de inferencia especializados pueden ofrecer ventajas para determinadas tareas de generación muy sensibles a la latencia. Sin embargo, la computación heterogénea no significa que añadir más tipos de chips mejore automáticamente la eficiencia. Los sistemas también deben abordar la comunicación entre dispositivos, la planificación de tareas, la compatibilidad de software y los costes de infraestructura.
Para la industria de chips de IA, esto significa que la competencia se está ampliando desde el rendimiento de componentes de hardware individuales hasta la eficiencia de sistemas de computación completos. La arquitectura de los procesadores, los compiladores, los sistemas de memoria, las tecnologías de interconexión y las operaciones de servicios en la nube pueden convertirse en factores que determinen el rendimiento final y el valor comercial.
El enfoque tecnológico representado por las LPU de Groq proporciona un ejemplo concreto de este cambio. Su valor a largo plazo dependerá no solo de la velocidad de inferencia de una generación de chips específica, sino también de si pueden seguir adaptándose a la evolución de los modelos y convertir el rendimiento técnico en servicios de computación estables y escalables.
Conclusión
Groq LPU es un procesador especializado diseñado para la inferencia de IA. Utiliza tecnologías como la SRAM integrada en el chip, la ejecución determinista y la planificación estática del compilador para optimizar el acceso a datos y la ejecución de cálculos en determinadas cargas de trabajo de modelos de lenguaje de gran tamaño.
En comparación con las GPU de propósito general, las LPU de Groq ponen mayor énfasis en la baja latencia y la previsibilidad de ejecución para tareas de inferencia específicas. Este diseño es adecuado para explorar la optimización del rendimiento en aplicaciones como la generación de texto en tiempo real, las interacciones de voz y los agentes de IA, pero no implica que las LPU puedan sustituir a las GPU en todos los modelos y escenarios de cálculo.
Al mismo tiempo, la capacidad de SRAM, la comunicación entre varios chips, la adaptación de modelos y los costes de infraestructura siguen siendo cuestiones importantes que deben abordar las arquitecturas de inferencia especializadas.
A medida que la industria de la IA se expande desde el desarrollo de modelos hacia aplicaciones a gran escala, la competencia en computación de inferencia está pasando de maximizar simplemente la capacidad de cálculo a optimizar la latencia, el rendimiento, el coste y la eficiencia general del sistema. El desarrollo de las LPU de Groq demuestra que los aceleradores especializados pueden desempeñar un papel más importante en la futura infraestructura de IA, pero su valor real aún debe validarse mediante cargas de trabajo específicas y resultados de despliegue comercial.
Preguntas frecuentes
¿Qué es Groq LPU?
Groq LPU es un procesador especializado de inferencia de IA diseñado por Groq. Utiliza principalmente tecnologías como SRAM integrada en el chip, ejecución determinista y planificación del compilador para optimizar tareas específicas de inferencia de modelos de lenguaje.
¿Cuáles son las principales diferencias entre las LPU y las GPU?
Las LPU ponen mayor énfasis en optimizar la ejecución y la transferencia de datos para tareas de inferencia específicas, mientras que las GPU ofrecen amplias capacidades de computación paralela y un ecosistema de software consolidado. Sus diferencias de rendimiento dependen del modelo específico y del entorno de ejecución.
¿Por qué las LPU de Groq utilizan SRAM?
La SRAM proporciona acceso a datos integrado en el chip con baja latencia, lo que puede ayudar a reducir la sobrecarga de lectura de datos en determinadas tareas de inferencia. Sin embargo, la capacidad de la SRAM es limitada, por lo que el despliegue de modelos grandes generalmente requiere coordinación entre varios chips.
¿Qué significa la ejecución determinista?
La ejecución determinista consiste en planificar en la mayor medida posible el orden de cálculo, las transferencias de datos y la asignación de recursos antes de que se ejecute un programa. Esto puede reducir parte de la sobrecarga de planificación en tiempo de ejecución y hacer que la ejecución de cálculos sea más predecible.
¿Pueden utilizarse las LPU de Groq para el entrenamiento de modelos de IA?
Las LPU de Groq están diseñadas principalmente para cargas de trabajo de inferencia y no están destinadas principalmente al entrenamiento de modelos de gran tamaño de propósito general. Su soporte real depende de la arquitectura de hardware y la cadena de herramientas de software.
¿Las LPU de Groq siempre son más rápidas que las GPU de NVIDIA para la inferencia?
No necesariamente. Los distintos modelos, longitudes de entrada, longitudes de salida, niveles de concurrencia y entornos de prueba pueden afectar a los resultados. Una mayor velocidad de generación de tokens para un único usuario no implica necesariamente un mejor rendimiento general ni menores costes por token.
¿Por qué las LPU de Groq son adecuadas para los agentes de IA?
Los agentes de IA pueden necesitar realizar varias llamadas de inferencia de forma secuencial. Reducir la latencia de respuesta de cada solicitud puede acortar el tiempo de ejecución de la tarea completa, pero el resultado final también depende de las llamadas a herramientas, la transmisión de red y otras etapas de procesamiento.