El 3 de noviembre de 2026, AMD presentó sus resultados financieros del tercer trimestre, con ingresos trimestrales de 13 377 millones de USD, un 45 % más interanual. Los ingresos del centro de datos alcanzaron los 8546 millones de USD, un 97 % más interanual. La empresa prevé ingresos de aproximadamente 17 000 millones de USD en el cuarto trimestre y destacó que las GPU Instinct, las CPU EPYC y los sistemas a escala de rack Helios impulsarán conjuntamente el crecimiento de su negocio de centros de datos. Estos avances han aumentado la atención de los inversores sobre si AMD puede captar una mayor cuota del mercado de computación de IA dominado por NVIDIA.
Sin embargo, la competencia en chips de IA no se limita a comparar el rendimiento de los productos de dos empresas. La capacidad de memoria de las GPU, el rendimiento de inferencia, la compatibilidad de software, las redes, el consumo energético y el coste total de propiedad pueden influir en las decisiones de adquisición de los principales proveedores de servicios en la nube. Este artículo analiza la dinámica competitiva entre AMD y NVIDIA a través de las características técnicas de la inferencia de IA, así como lo que estos cambios implican para la industria de los chips de IA y los inversores relacionados con acciones estadounidenses.
Puntos clave:
-
La competencia en chips de IA se está ampliando de la capacidad de computación para entrenamiento a la eficiencia de inferencia. A medida que las aplicaciones de modelos de lenguaje grandes se expanden, los costes de computación, la velocidad de respuesta y el consumo energético durante la inferencia se están convirtiendo en factores importantes para las adquisiciones de centros de datos.
-
AMD está ampliando su negocio de IA para centros de datos. En el tercer trimestre de 2026, los ingresos de AMD en centros de datos alcanzaron aproximadamente 8550 millones de USD, un 97 % más interanual, lo que elevó los ingresos totales de la empresa a un nuevo máximo.
-
La ventaja competitiva de NVIDIA va más allá del hardware de GPU. Su ecosistema de software CUDA, sus redes, sus herramientas para desarrolladores y sus sistemas de rack integrados ofrecen sólidas capacidades de integración de sistemas para implementaciones de infraestructura de IA a gran escala.
-
AMD busca crear una alternativa integral mediante las GPU Instinct, Helios y ROCm. Su enfoque competitivo está cambiando gradualmente del rendimiento de chips individuales a las capacidades de computación a nivel de sistema y al coste total de propiedad.
-
El aumento de la demanda de inferencia de IA no implica necesariamente que suban las acciones de AMD o NVIDIA. Los inversores también deben seguir las capacidades de entrega de chips, los márgenes de beneficio, los gastos de capital de los clientes y las valoraciones de mercado.
¿Qué es la inferencia de IA? ¿En qué se diferencia del entrenamiento de modelos de IA?
La inferencia de IA se refiere al proceso computacional mediante el cual un modelo de inteligencia artificial entrenado genera predicciones, texto, imágenes u otros resultados a partir de la información introducida por el usuario. Por ejemplo, cuando un usuario hace una pregunta a un asistente de IA y el modelo genera progresivamente una respuesta basándose en esa información, ese proceso es inferencia. A diferencia del entrenamiento, que ajusta continuamente los parámetros del modelo, la inferencia estándar utiliza principalmente parámetros de modelo ya existentes para realizar cálculos. Sin embargo, algunos sistemas de inferencia también pueden incorporar recuperación de información, llamadas a herramientas y pasos computacionales adicionales.
El entrenamiento y la inferencia de IA tienen requisitos significativamente distintos de recursos computacionales. El entrenamiento de modelos grandes suele requerir que muchas GPU trabajen conjuntamente durante periodos prolongados, lo que genera altas exigencias de rendimiento computacional, capacidad de memoria e interconexiones de alta velocidad. La inferencia da mayor importancia al tiempo de respuesta de las solicitudes, al número de tareas que pueden procesarse por unidad de tiempo y al coste computacional requerido para cada solicitud. En aplicaciones como el chat en tiempo real y los asistentes de voz, los usuarios son muy sensibles a la latencia de respuesta. Para tareas de procesamiento de texto por lotes o análisis de datos, el rendimiento global y el coste pueden ser más importantes.
| Dimensión de comparación |
Entrenamiento de IA |
Inferencia de IA |
| Objetivo principal |
Aprender y optimizar los parámetros del modelo |
Usar el modelo para generar resultados |
| Características computacionales |
Computación a gran escala y de larga duración |
Procesamiento continuo y de alta frecuencia de solicitudes |
| Métricas clave |
Velocidad de entrenamiento y eficiencia de escalado |
Latencia, rendimiento y coste por unidad |
| Requisitos de memoria |
Parámetros, gradientes y estados de entrenamiento |
Pesos del modelo, caché KV y más |
| Casos de uso empresarial |
Desarrollo de modelos fundacionales |
Asistentes de IA, búsqueda, Agents y aplicaciones empresariales |
A medida que las aplicaciones de IA se expanden, las solicitudes de inferencia pueden seguir creciendo. Por ejemplo, un modelo puede requerir solo un número limitado de ejecuciones de entrenamiento a gran escala, pero podría atender a millones de usuarios durante un largo periodo tras su implementación. Esto genera la posibilidad de que el gasto acumulado en inferencia se convierta en una fuente importante de costes de infraestructura de IA. Sin embargo, la proporción entre el gasto en entrenamiento e inferencia varía significativamente entre modelos y aplicaciones, por lo que no se puede asumir que los costes de inferencia siempre superarán los de entrenamiento.
¿Por qué la inferencia de IA se está convirtiendo en un foco de competencia entre AMD y NVIDIA?
El mercado de la inferencia de IA está atrayendo atención principalmente porque los modelos de negocio de IA están pasando de competir en capacidades de modelos a competir en costes reales de uso. Para los proveedores de servicios en la nube y los desarrolladores de aplicaciones de IA, la capacidad de un modelo para completar tareas es solo un requisito básico. Su capacidad para prestar servicios continuamente a un gran número de usuarios a un coste razonable también determina si el producto puede comercializarse. A medida que aumentan el número de usuarios y la frecuencia de las llamadas, incluso una pequeña reducción del coste por inferencia puede tener un impacto significativo en los gastos operativos totales.
Las cargas de trabajo de inferencia no son idénticas. Las conversaciones en tiempo real requieren baja latencia, los modelos de razonamiento complejo pueden necesitar generar procesos de razonamiento extensos y los Agents de IA pueden llamar a modelos, recuperar datos y ejecutar herramientas varias veces en una sola tarea. Las distintas cargas de trabajo tienen requisitos diferentes en cuanto a precisión computacional, capacidad de memoria, ancho de banda de memoria e interconexiones de sistema. Esto crea espacio para la competencia entre distintas arquitecturas de hardware y dificulta determinar qué chip tiene ventaja basándose en una única métrica de rendimiento.
Para AMD, la importancia del mercado de inferencia radica en su potencial para ampliar la cuota de mercado de las GPU de IA. Los principales proveedores de servicios en la nube suelen tratar de evitar una dependencia excesiva de un único proveedor mientras controlan los costes de adquisición de hardware. Si AMD puede ofrecer una alternativa competitiva en rendimiento, precios, compatibilidad de software y capacidades de entrega, podría participar en más planes de adquisición de centros de datos. Sin embargo, NVIDIA también optimiza continuamente sus productos de inferencia y plataformas de software, por lo que el crecimiento de la demanda de inferencia no implica necesariamente que la posición competitiva de NVIDIA se debilite.
¿Cómo se ha comportado recientemente el negocio de centros de datos de AMD?
Los resultados del tercer trimestre de AMD anunciados en noviembre de 2026 muestran que los centros de datos se han convertido en una de las fuentes de crecimiento empresarial más importantes de la compañía. Los ingresos totales alcanzaron los 13 377 millones de USD, un 45 % más interanual, mientras que los ingresos de centros de datos llegaron a los 8546 millones de USD, un 97 % más interanual. Durante el mismo periodo, el beneficio por acción no conforme con los PCGA alcanzó los 2,09 USD, un 74 % más interanual, lo que refleja la contribución de la expansión de los centros de datos a la rentabilidad general.
Cabe destacar que el negocio de centros de datos de AMD incluye no solo las GPU de IA Instinct, sino también las CPU para servidores EPYC. Por tanto, no todos los ingresos de centros de datos deben considerarse directamente ingresos de chips de inferencia de IA. El crecimiento del negocio de la empresa está impulsado tanto por la demanda de aceleradores de IA como por la demanda de computación de servidores de uso general. Para los inversores, determinar si AMD está ampliando realmente su cuota de mercado de GPU de IA requiere observar más a fondo los envíos de productos, las implementaciones de clientes y la composición específica del negocio.
AMD también prevé ingresos totales de aproximadamente 17 000 millones de USD en el cuarto trimestre de 2026, manteniendo el crecimiento respecto al tercer trimestre. La empresa también está avanzando en las implementaciones de sistemas a escala de rack Helios y ampliando la cooperación con los principales proveedores de servicios en la nube y empresas de IA. Estos avances indican que AMD busca evolucionar de proveedor de chips a proveedor más integral de infraestructura de IA. Sin embargo, que los ingresos futuros puedan seguir creciendo dependerá de las adquisiciones de los clientes, las cadenas de suministro y la competitividad de los productos.
¿Cuáles son las diferencias entre AMD Instinct y las GPU de NVIDIA para inferencia de IA?
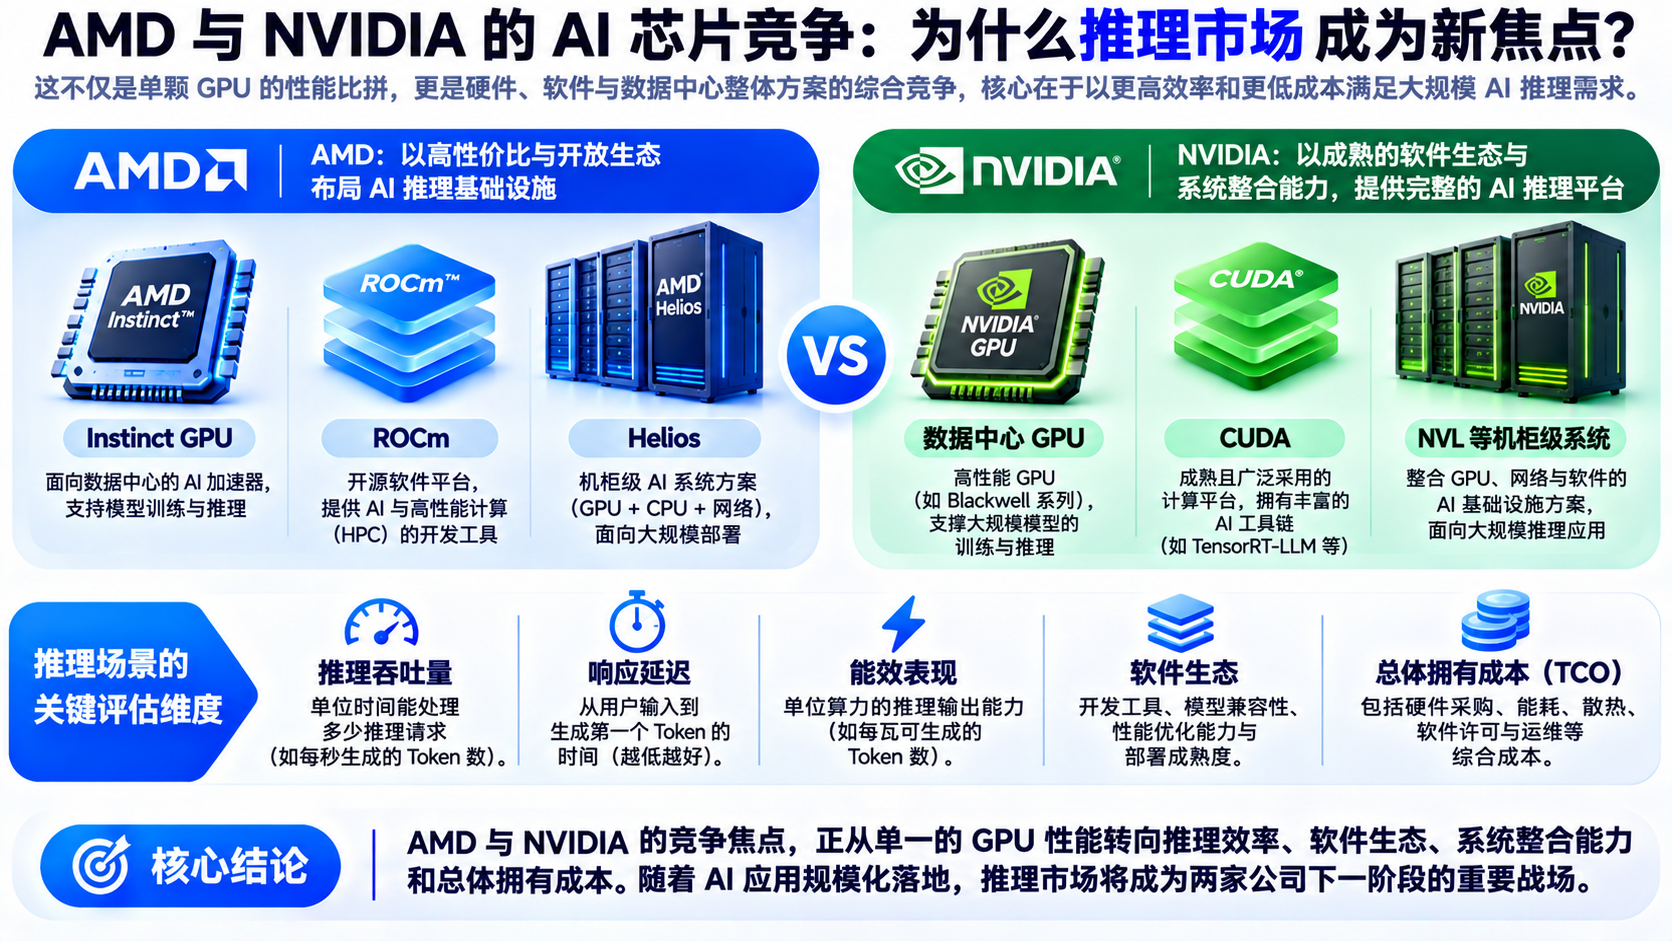
Tanto las GPU de IA de AMD como las de NVIDIA pueden admitir tareas de entrenamiento e inferencia de modelos, pero las empresas difieren en sus hojas de ruta de productos, ecosistemas de software y enfoques de integración de sistemas. La serie Instinct de AMD se dirige principalmente a la computación de alto rendimiento y la aceleración de IA en centros de datos, mientras que NVIDIA ha desarrollado un marco de computación de IA más integral mediante GPU para centros de datos, la plataforma de software CUDA y tecnologías de red complementarias.
Para las tareas de inferencia, el rendimiento computacional teórico de una GPU es solo un criterio de evaluación. Los modelos necesitan acceder con frecuencia a pesos y datos intermedios, por lo que la capacidad de memoria, el ancho de banda de memoria y la gestión de caché son igualmente importantes. Una mayor capacidad de memoria ayuda a alojar los parámetros del modelo y la caché KV generada por más solicitudes simultáneas, mientras que un mayor ancho de banda de memoria puede reducir los cuellos de botella de acceso a datos en determinadas tareas de inferencia. Sin embargo, los beneficios específicos dependen del tamaño del modelo, la precisión de cuantización, la estrategia de procesamiento por lotes y el nivel de optimización del software.
La ventaja de NVIDIA reside en sus capacidades de coordinación entre hardware y software. Además de las GPU, NVIDIA proporciona CUDA, TensorRT-LLM, marcos de servicio de inferencia y tecnologías de interconexión de alta velocidad, lo que permite a los desarrolladores implementar cargas de trabajo de IA en torno a un conjunto de herramientas relativamente maduro. AMD, por su parte, está mejorando la compatibilidad y el rendimiento del sistema mediante ROCm, las GPU Instinct y los sistemas Helios, con el objetivo de reducir los costes de migración para los clientes que adopten hardware alternativo.
| Dimensión de comparación |
AMD |
NVIDIA |
| Aceleradores de IA |
Serie Instinct |
Serie de GPU para centros de datos |
| Ecosistema de software |
ROCm |
CUDA |
| Soluciones a nivel de sistema |
Helios |
Plataformas a escala de rack como NVL |
| Enfoque competitivo principal |
Ecosistema abierto, coste y rendimiento |
Madurez de software e integración de sistemas |
| Enfoque de optimización de inferencia |
Capacidad de memoria, rendimiento y adaptación de software |
Latencia, rendimiento y coordinación entre hardware y software |
| Principales desafíos |
Compatibilidad del ecosistema y madurez de implementación |
Costes del sistema y concentración de proveedores de los clientes |
Es importante destacar que la comparación anterior refleja el posicionamiento de productos y ecosistemas, no una clasificación universal de rendimiento. Diferentes GPU pueden tener rendimientos significativamente distintos según los modelos, los niveles de precisión y las condiciones de implementación. La eficiencia real de inferencia no puede determinarse únicamente por la capacidad de memoria o el rendimiento computacional teórico.
¿Por qué CUDA y ROCm afectan al panorama competitivo de los chips de IA?
CUDA es la plataforma de computación paralela de NVIDIA desarrollada durante años, mientras que ROCm es la plataforma de software de AMD para computación con GPU y cargas de trabajo de IA. Ambas proporcionan herramientas de desarrollo, bibliotecas de computación y entornos de ejecución que permiten a los desarrolladores utilizar GPU para tareas computacionales complejas. Para las grandes empresas de IA, seleccionar GPU implica más que adquirir hardware. También supone determinar si el código de modelos existente, los marcos de entrenamiento, los motores de inferencia y los sistemas operativos pueden funcionar de forma fiable.
La ventaja competitiva de CUDA procede de su ecosistema de software consolidado desde hace tiempo. Muchos modelos de IA y herramientas de desarrollo ya se han adaptado y optimizado para las GPU de NVIDIA, por lo que las empresas que utilizan hardware de NVIDIA a menudo pueden reducir parte del trabajo de migración y depuración. Especialmente en entornos de clústeres a gran escala, la estabilidad del software, las herramientas de análisis de rendimiento y el soporte técnico pueden afectar directamente a la utilización de los recursos computacionales.
AMD está mejorando la experiencia de los desarrolladores y el soporte para los principales marcos de IA mediante ROCm. En el tercer trimestre de 2026, AMD lanzó ROCm 10, mejorando aún más las herramientas de desarrollo relacionadas, los compiladores, las bibliotecas de computación y el soporte de modelos. Estas mejoras ayudan a ampliar el abanico de aplicaciones de las GPU de AMD, pero el lanzamiento de una nueva versión no significa que todas las aplicaciones de CUDA puedan migrarse a ROCm sin modificaciones.
Desde una perspectiva comercial, la compatibilidad de software afecta al coste total de propiedad real de las GPU. Si una empresa compra aceleradores de menor precio, pero debe invertir recursos de ingeniería considerables para volver a optimizar los modelos, el ahorro en costes de hardware podría verse finalmente compensado por los costes de desarrollo. Por tanto, la competencia entre AMD y NVIDIA se desarrolla no solo a nivel de chip, sino también en los ecosistemas de desarrolladores, los marcos de inferencia y la eficiencia de implementación de sistemas.
¿Cómo cambia AMD Helios la competencia a nivel de sistema con NVIDIA?
Helios es la plataforma de computación a escala de rack de AMD para grandes centros de datos de IA. Combina GPU Instinct, CPU EPYC, interconexiones de red y componentes de software relacionados para proporcionar a los clientes un sistema de computación de IA más completo. En comparación con comprar GPU por separado e integrar después los sistemas, las soluciones a escala de rack pueden optimizar la computación, las comunicaciones y el diseño de implementación dentro de una arquitectura unificada.
Este cambio refleja cómo la competencia en infraestructura de IA se está ampliando de los chips individuales a sistemas computacionales completos. El entrenamiento y la inferencia de modelos grandes suelen requerir que varias GPU trabajen conjuntamente. Las velocidades de transferencia de datos entre GPU, las interconexiones dentro de los servidores, la topología de red y las capacidades de refrigeración pueden afectar a la eficiencia general. Incluso si un chip individual tiene un alto rendimiento computacional, el rendimiento real del clúster puede seguir limitado si la comunicación del sistema se convierte en un cuello de botella.
NVIDIA ya ha establecido una línea de productos relativamente completa mediante sistemas de IA a escala de rack, mientras que AMD busca ofrecer otra opción mediante Helios. En su último anuncio de resultados, AMD indicó que clientes como Anthropic, Meta, Microsoft, OpenAI y Oracle Cloud Infrastructure están ejecutando modelos o cargas de trabajo basados en las primeras soluciones Helios. Estas implementaciones indican que AMD está avanzando en el despliegue de productos a nivel de sistema, pero la escala de implementación, el importe de adquisición y la fase de comercialización de cada cliente todavía deben evaluarse por separado.
Para los principales proveedores de servicios en la nube, contar con varios proveedores competitivos de sistemas de IA puede aumentar la flexibilidad de adquisición y reducir el riesgo de concentración en la cadena de suministro. Sin embargo, la competencia a nivel de sistema también plantea mayores exigencias para AMD, incluida la oferta de chips, las interconexiones de red, la estabilidad del software, la implementación de racks y el mantenimiento a largo plazo.
¿Por qué los costes de inferencia de IA son más importantes que el rendimiento individual de las GPU?
El valor comercial de la inferencia de IA depende en última instancia de si los servicios pueden prestarse de forma continua a un coste aceptable. Para las plataformas de IA que procesan un gran número de solicitudes cada día, los precios de compra de las GPU son solo una parte del coste. La utilización de servidores, el consumo energético, la refrigeración, las redes, el mantenimiento y la eficiencia de ejecución de los modelos pueden afectar al gasto total.
Por ejemplo, supongamos que dos sistemas de GPU tienen costes de adquisición de 1 millón de USD y 1,2 millones de USD, respectivamente. Si el segundo puede procesar más solicitudes con la misma calidad de servicio o reducir significativamente el consumo energético de cada inferencia, el sistema de mayor precio podría seguir teniendo un menor coste por inferencia a largo plazo. Por el contrario, si un sistema tiene un alto rendimiento teórico, pero las aplicaciones reales no pueden aprovechar plenamente sus recursos de hardware, sus resultados económicos pueden quedar por debajo de las expectativas.
Por tanto, al evaluar los chips de inferencia de IA, es importante considerar métricas como el número de Tokens generados por segundo, el tiempo hasta el primer Token, la capacidad de solicitudes simultáneas y el coste real de procesamiento por millón de Tokens. Los distintos modelos y cargas de trabajo conceden diferentes niveles de importancia a estas métricas. Por ejemplo, las interacciones de voz en tiempo real priorizan la latencia, mientras que el análisis de documentos por lotes puede dar más importancia al rendimiento y al coste unitario.
Este cambio implica que AMD no necesita necesariamente superar a NVIDIA en todas las métricas de rendimiento para obtener oportunidades de mercado. Siempre que sus productos puedan ofrecer costes y rendimiento competitivos para cargas de trabajo específicas, cumpliendo al mismo tiempo los requisitos de los clientes en materia de estabilidad y soporte de software, pueden convertirse en alternativas viables. Del mismo modo, NVIDIA puede mantener su competitividad mediante la optimización de software y la eficiencia del sistema, en lugar de depender únicamente de un mayor rendimiento teórico de los chips.
¿Cómo afectará la competencia en el mercado de inferencia de IA a las valoraciones de las acciones de AMD y NVIDIA?
AMD y NVIDIA son importantes empresas cotizadas de la industria estadounidense de semiconductores, pero los inversores no aplican exactamente la misma lógica de valoración a ambas compañías. NVIDIA ya ha desarrollado un negocio de computación de IA a gran escala y un ecosistema de hardware y software relativamente maduro, y el mercado suele centrarse en si puede mantener la escala de ingresos, los márgenes de beneficio y las ventajas tecnológicas. AMD, por su parte, tiene la oportunidad de ampliar su cuota de mercado de IA, por lo que los inversores se centran más en si las implementaciones de nuevos productos, los pedidos de clientes y el crecimiento de ingresos pueden traducirse en una rentabilidad sostenida.
La expansión del mercado de inferencia de IA puede beneficiar a varios proveedores de chips al mismo tiempo, pero el crecimiento de la demanda de mercado no significa que los beneficios de todas las empresas aumenten de forma proporcional. A medida que se intensifica la competencia, pueden cambiar los precios de los productos, el poder de negociación de los clientes y la inversión en investigación y desarrollo. Si las empresas reducen precios para ganar cuota de mercado o necesitan dedicar más recursos al soporte de las implementaciones de clientes, el crecimiento de los ingresos podría no generar el mismo nivel de crecimiento de los beneficios.
Además, los precios de las acciones dependen de cuánto crecimiento esperado ya haya incorporado el mercado. Incluso si una empresa presenta sólidos resultados financieros, el precio de sus acciones podría seguir enfrentando presión si los inversores esperaban más. Por el contrario, si las entregas reales, los márgenes de beneficio o las previsiones de una empresa superan las expectativas, el mercado puede reevaluar su valoración. Por tanto, evaluar el valor de inversión de AMD y NVIDIA exige más que comparar qué GPU tiene mejor rendimiento. También requiere considerar la composición de los ingresos, la rentabilidad, los gastos de capital, el entorno competitivo y los múltiplos de valoración.
¿Qué indicadores del mercado de inferencia de IA deben seguir los inversores?
Los inversores que deseen comprender los movimientos de las acciones de chips de IA pueden observar los cambios del mercado desde tres perspectivas. La primera es la demanda, incluidos los gastos de capital en IA de los principales proveedores de servicios en la nube, el uso de servicios de inferencia y las implementaciones reales de clientes empresariales. Estos indicadores pueden ayudar a determinar si la demanda de potencia computacional de IA continúa expandiéndose, pero los planes de gastos de capital no equivalen a ingresos confirmados para los fabricantes de chips.
La segunda es la oferta, incluidos los volúmenes de entrega de GPU, el suministro de memoria de alto ancho de banda (HBM), la capacidad de empaquetado avanzado y el progreso de implementación de sistemas. Incluso cuando la demanda de mercado es elevada, los fabricantes de chips pueden no ser capaces de completar las entregas según lo previsto si el suministro de componentes críticos es insuficiente. Tanto AMD como NVIDIA dependen de complejas cadenas de suministro de semiconductores, por lo que las limitaciones de oferta pueden afectar al ritmo de crecimiento de ambas empresas.
La última área son las métricas de rentabilidad y valoración. Los inversores pueden seguir los ingresos de centros de datos, el margen bruto, el margen operativo, el flujo de caja libre y los cambios en las expectativas de mercado, y después utilizar ratios precio-beneficio o múltiplos de beneficios futuros para evaluar si el precio de las acciones es razonable. Es especialmente importante distinguir entre los resultados financieros ya obtenidos y las previsiones prospectivas de la dirección, así como evitar considerar los pedidos no cumplidos o las previsiones de crecimiento como ingresos seguros.
Resumen
La competencia entre AMD y NVIDIA en chips de IA se está ampliando de una comparación puramente de rendimiento computacional a la eficiencia de inferencia, los ecosistemas de software, los sistemas a escala de rack y el coste total de propiedad. A medida que las aplicaciones de IA entran en la fase de implementación a gran escala, los centros de datos necesitan no solo mayores capacidades computacionales, sino también la capacidad de procesar continuamente grandes volúmenes de solicitudes de usuarios a costes más razonables.
El rápido crecimiento del negocio de centros de datos de AMD en el tercer trimestre de 2026, junto con el desarrollo continuo de Instinct, ROCm y Helios, indica que está ampliando su negocio de infraestructura de IA. Sin embargo, NVIDIA conserva ventajas importantes en CUDA, la integración de sistemas y el ecosistema de desarrolladores. El resultado de la competencia futura dependerá de las entregas de productos, el rendimiento en condiciones reales, la adopción por parte de los clientes y la rentabilidad comercial, más que de una única métrica técnica de una generación de chips.
Para los inversores en acciones, el mercado de inferencia de IA ofrece una nueva perspectiva para observar la industria de semiconductores, pero la competitividad tecnológica y los rendimientos de las inversiones en acciones no son directamente equivalentes. Analizar conjuntamente la demanda de la industria, la rentabilidad empresarial y las valoraciones de mercado permite comprender de forma más integral el panorama competitivo entre AMD y NVIDIA.
Preguntas frecuentes
¿Qué es la inferencia de IA?
La inferencia de IA es el proceso de utilizar un modelo de inteligencia artificial entrenado para procesar información de entrada y generar resultados, como chat de IA, generación de imágenes, reconocimiento de voz y tareas realizadas por asistentes inteligentes.
¿Por qué el mercado de inferencia de IA está adquiriendo mayor importancia?
A medida que aumentan el número de usuarios de aplicaciones de IA y la frecuencia de uso, las empresas deben asumir continuamente costes computacionales de inferencia considerables. Como resultado, la velocidad de inferencia, el rendimiento, el consumo energético y los costes unitarios están adquiriendo mayor importancia.
¿Pueden las GPU de IA de AMD sustituir a NVIDIA?
Para determinados modelos y escenarios de aplicación compatibles, las GPU de AMD pueden servir como alternativa a NVIDIA. Sin embargo, la viabilidad real depende de la compatibilidad de software, el rendimiento, los costes de implementación y los requisitos de los clientes. No deben considerarse plenamente equivalentes en todos los escenarios.
¿Cuál es la diferencia entre CUDA y ROCm?
CUDA es la plataforma de computación paralela con GPU de NVIDIA, mientras que ROCm es la plataforma de software de AMD para computación con GPU. Ambas admiten computación de IA, pero difieren en herramientas de desarrollo, madurez del ecosistema y compatibilidad específica.
¿Qué es AMD Helios?
Helios es la plataforma de computación de IA a escala de rack de AMD que integra GPU, CPU, interconexiones y componentes de software para cargas de trabajo de entrenamiento e inferencia de IA en grandes centros de datos.
¿El aumento de la demanda de inferencia de IA significa que las acciones de AMD subirán con seguridad?
No necesariamente. Los precios de las acciones se ven afectados no solo por el crecimiento del negocio, sino también por la rentabilidad, el panorama competitivo, las cadenas de suministro, las expectativas del mercado y las valoraciones de las acciones.