بالنسبة إلى القرّاء الذين يختارون وفق المهمة، لا يتمثل العامل الأساسي في «أي الجانبين أقوى»، بل في ما إذا كان الإخفاق أكثر ضررًا عند ظهور كلام سلس بلا معنى أم عند انحراف الديناميكيات. تقارن الأقسام أدناه بين نموذج العالم والنموذج اللغوي الكبير (LLM) من حيث أهداف التنبؤ، والبيانات/التقييم، والمهام الملائمة، وقواعد الدمج، وسوء الفهم الشائع. تُناقش حدود القدرات إلى جانب الذكاء الخارق (ASI)، بينما تُناقش حدود النشر إلى جانب الذكاء الاصطناعي الخاص.
النقاط الرئيسية
- تعمل نماذج العالم على تحسين ديناميكيات الحالة التالية/الديناميكيات الكامنة المشروطة بالفعل، بينما تعمل النماذج اللغوية الكبيرة على تحسين الرمز التالي وبنية النص.
- فضّل نماذج العالم للتخطيط والتحكم في البيئات المادية، وفضّل النماذج اللغوية الكبيرة للكتابة والأسئلة والأجوبة المعززة بالاسترجاع واستدعاء الأدوات.
- عندما تحتاج المهمة إلى واجهة لغوية وديناميكيات بيئية قابلة للمحاكاة، اجمع بينهما بدلًا من التعامل معهما كبديلين.
- تختلف أنماط الإخفاق: غالبًا ما تفشل النماذج اللغوية الكبيرة عبر هلوسة اللغة، بينما تفشل نماذج العالم عبر انحراف الديناميكيات والفيزياء الزائفة.
ما هو نموذج العالم؟
نموذج العالم هو نظام ديناميكيات متعلَّم: عند تزويده بالحالة الحالية (أو الملاحظة) وفعل محتمل، يتنبأ بكيفية تغير البيئة لكي يتمكن الوكيل من تجربة التحركات في الخيال قبل التخطيط. محور القرار الأوضح هو التنبؤ المشروط بالفعل، وليس طلاقة المحادثة.
على عكس الأنظمة التي لا تنتج سوى النص أو المظهر، تربط البنى الموجهة نحو نماذج العالم التنبؤات بحلقات التخطيط أو التحكم أو التدريب عبر التخيل. وتشمل الأساليب الشائعة التعلم المعزز القائم على النموذج (مثل Dreamer)، والمحاكاة التفاعلية التوليدية، والتنبؤ بالتمثيلات بأسلوب JEPA؛ وتختلف الأهداف، لذا لا يمكن استخدام أسماء العلامات التجارية بالتبادل.
ما هو النموذج اللغوي الكبير؟
النموذج اللغوي الكبير (LLM) هو نموذج توليدي مدرَّب على مجموعات ضخمة من النصوص، ويكون التنبؤ بالرمز التالي هدفه الأساسي. يتميز النموذج اللغوي الكبير في فهم اللغة والتلخيص والترجمة والمساعدة في البرمجة وتنسيق النصوص متعددة الخطوات من خلال الموجّهات وواجهات الأدوات.
يمكن للنموذج اللغوي الكبير وصف العالم المادي أو كتابة خطوات لـ«ما الذي يحدث إذا دفعت كوبًا»، لكن الوصف ليس ديناميكيات بيئية قابلة للمحاكاة والتقييم. ومن دون واجهة فعل–حالة وفحوصات حلقة مغلقة، فإن التعامل مع نموذج لغوي كبير بوصفه متحكمًا أو محرك فيزياء هو خطأ في الاختيار، وليس مشكلة «نموذج صغير جدًا».
كيف تختلف أهداف التنبؤ؟
يكمن الاختلاف الأساسي في موضوع التنبؤ: يتنبأ نموذج العالم بالحالة التالية أو الديناميكيات الكامنة بعد فعل ما، بينما يتنبأ النموذج اللغوي الكبير بالرمز التالي وبنية النص. كلاهما «يتنبأ»، لكنهما لا يشتركان في معيار نجاح واحد.
| الميزة |
نموذج العالم |
النموذج اللغوي الكبير |
| هدف التنبؤ |
الحالة التالية / الديناميكيات الكامنة (وغالبًا ما تكون مشروطة بالفعل) |
الرمز التالي / النص واتباع التعليمات |
| الارتباط بالفعل |
التنبؤ المشروط بالفعل هو محور القرار |
لا ينمذج عادةً حلقة تحكم مادية |
| شكل المخرجات |
حالات أو تمثيلات أو مسارات أو ملاحظات تفاعلية |
نصوص أو تعليمات برمجية أو وسائط استدعاء الأدوات |
| معايير النجاح |
عواقب قابلة للتحقق، وقابلية للتخطيط، وخطأ قابل للتتبع |
صحة دلالية، وتنسيق قابل للاستخدام، واستشهادات قابلة للتحقق |
| الإخفاق المعتاد |
انحراف الديناميكيات، فيزياء زائفة |
هلوسة اللغة، استشهادات مختلقة |
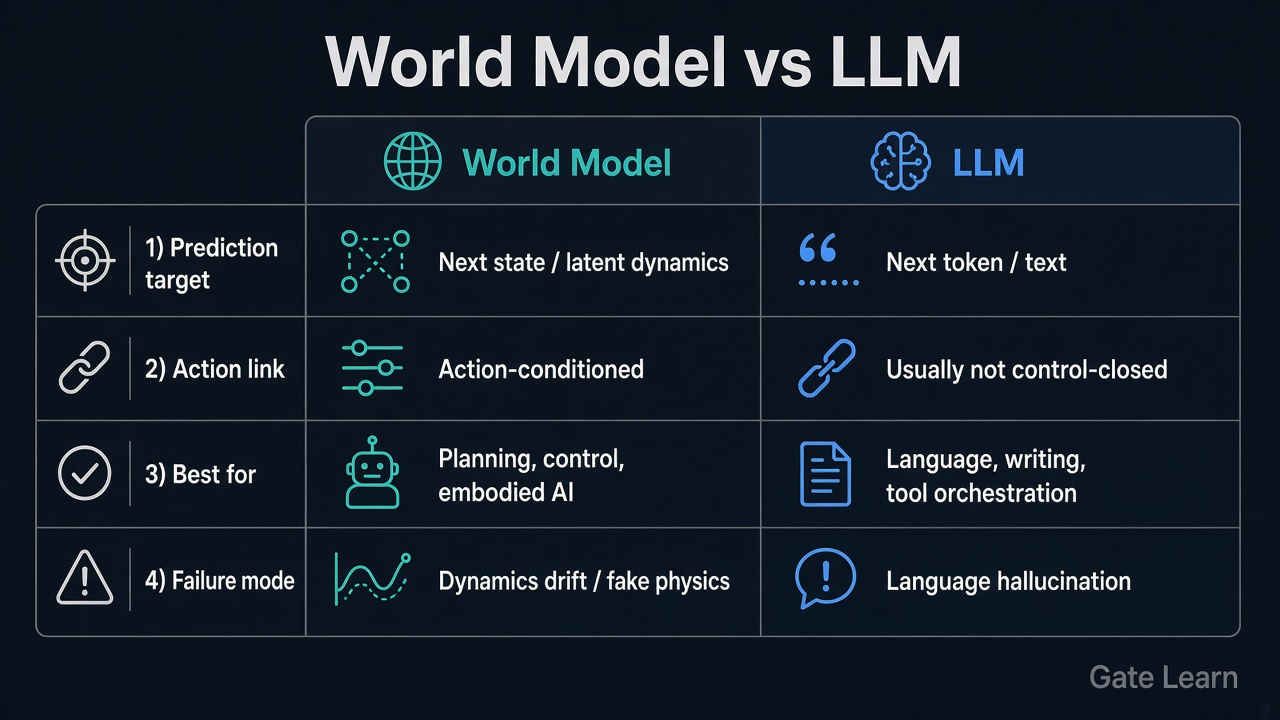
الشكل 1. مقارنة رباعية بين نماذج العالم والنماذج اللغوية الكبيرة: هدف التنبؤ، والارتباط بالفعل، والمهام الأنسب، ونمط الإخفاق.
غالبًا ما يحدث خلط بين JEPA والنماذج اللغوية الكبيرة. يتنبأ JEPA (مثل I-JEPA من Meta AI) بتمثيلات مستقبلية مجردة في فضاء تضمين مشترك، وهو موجه نحو نموذج العالم؛ بينما تظل النماذج اللغوية الكبيرة أنظمة لنمذجة اللغة. لا تعني الأسماء المتشابهة إمكانية استخدامهما بالتبادل. راجع مسرد NVIDIA: نماذج العالم ومناقشة LeCun للمسار (مسار نحو ذكاء آلي ذاتي الاستقلال).
كيف تختلف البيانات والمخرجات والتقييم؟
تتبع البيانات والتقييم هدف التنبؤ: تعتمد نماذج العالم على المسارات التفاعلية وانتقالات الحالة وإشارات التحكم، وأحيانًا الفيديو؛ بينما تعتمد النماذج اللغوية الكبيرة على المتون النصية وبيانات التعليمات وسجلات الأدوات (اختياريًا). ويحدد الاستخدام اللاحق مقاييس الخطأ.
| البعد |
نموذج العالم |
النموذج اللغوي الكبير |
| البيانات المعتادة |
مسارات الملاحظة–الفعل–الملاحظة التالية / المكافأة (تتضمن أحيانًا فيديو) |
نصوص وحوارات وتعليمات برمجية وآثار الأدوات |
| المخرجات الأساسية |
الحالة التالية، الديناميكيات الكامنة، المسارات المتخيلة |
نصوص، إجابات منظمة، استدعاءات دوال |
| محور التقييم |
الخطأ متعدد الخطوات، نجاح المهمة، المتانة خارج التوزيع (OOD) |
الصحة، والالتزام بالمصدر، والتنسيق، والسلامة |
| مشكلات يصعب اكتشافها |
فيزياء زائفة تبدو سلسة؛ نمو الخطأ على المدى الطويل |
هلوسات سلسة؛ استشهادات لا تجتاز التحقق |
إن استخدام «اكتب فقرة صحيحة عن الفيزياء» لاعتماد نموذج عالم، أو «يبدو المقطع جيدًا» لاعتماد حلقة تحكم لنموذج لغوي كبير، يبدّل محور التقييم. حدّد أولًا المخرجات القابلة للتحقق، ثم اختر فئة النموذج.
ما المهام الأنسب لنماذج العالم؟ وما المهام الأنسب للنماذج اللغوية الكبيرة؟
ابدأ بتحديد موضع تكلفة الإخفاق: الفيزياء/التحكم أم الدلالات/التواصل. فضّل نماذج العالم للأولى والنماذج اللغوية الكبيرة للثانية. وعندما يجب توفر الأمرين معًا، استخدم «يجب الدمج» بدلًا من فرض فائز واحد.
| شرط المهمة |
فضّل نموذج العالم |
فضّل النموذج اللغوي الكبير |
متى يكون الدمج مطلوبًا |
| تحتاج إلى تنبؤ صريح من الفعل → الحالة التالية |
نعم |
لا |
— |
| تحتاج إلى واجهة بلغة طبيعية، أو إنشاء وثائق/تعليمات برمجية |
لا |
نعم |
— |
| تخطيط في بيئة مادية؛ تصفية المسارات الفاشلة قبل التلامس، كما في القيادة الذاتية |
نعم |
لا (قد يقتصر دور النموذج اللغوي الكبير على الشرح) |
النموذج اللغوي الكبير للتعليمات؛ نموذج العالم لديناميكيات قابلة للمحاكاة |
| أسئلة وأجوبة معززة بالاسترجاع، والكتابة، وتنسيق الأدوات |
لا |
نعم |
— |
| تدريب سياسة عبر التخيل (MBRL) |
نعم |
لا |
قد يصوغ النموذج اللغوي الكبير نص المهمة؛ لكن الديناميكيات لا تزال تحتاج إلى نموذج عالم |
| حوار حول الأهداف مع حلقة تحكم قابلة للتنفيذ |
لا يكفي وحده |
لا يكفي وحده |
يجب الدمج: يحلل النموذج اللغوي الكبير الأهداف → ينفذ نموذج العالم / المخطط |
يناسب «يجب الدمج» نمطًا شائعًا: يتولى النموذج اللغوي الكبير النية والواجهة؛ ويتولى نموذج العالم (أو المحاكي مع ديناميكيات متعلَّمة) التنبؤ بالعواقب وتصفية المسارات. وغالبًا ما يؤدي إسقاط أحد الجانبين إلى الوقوع في نمط إخفاق الجانب الآخر.
متى ينبغي الجمع بينهما؟
اجمع بينهما عندما تتضمن المهمة هدفًا على مستوى اللغة وعواقب على مستوى البيئة؛ ولا تتعامل مع ذلك بوصفه استبدالًا. تسلسل نموذجي: يحول النموذج اللغوي الكبير الأهداف إلى أهداف فرعية أو قيود؛ ويحاكي نموذج العالم الأفعال المحتملة؛ ويختار مخطط مسارًا وفق التكلفة والسلامة؛ ثم يعيد التنفيذ ملاحظة جديدة تحدّث الحالة.
لا يعني الدمج «ضم موجّهين معًا». يجب أن تكون الواجهات صريحة: ما الأهداف المنظمة التي ينتجها النموذج اللغوي الكبير، وما الأفعال التي يقبلها نموذج العالم، وكيف يؤدي الخطأ متعدد الخطوات إلى إعادة التخطيط أو إلى بديل محافظ. ومن دون هذا العقد، تبدو الأنظمة على هيئة «كلام سلس، حركة معطلة» أو «مسارات جميلة، تعليمات غير متطابقة».
كما أن التكديس الإلزامي لا يناسب الحالات التي تكاد فيها الأسئلة والأجوبة البحتة حول المستندات لا تحتاج إلى نموذج عالم، أو التي يكون فيها التحكم منخفض المستوى بالمؤازر يمتلك بالفعل ديناميكيات موثوقة ولا يحتاج إلى نموذج لغوي كبير عام. تنبع قيمة الدمج من تقسيم العمل، لا من عدد النماذج.
ما الأخطاء في التقدير والمخاطر التي تظهر عند الاختيار؟
أكثر حالات سوء الفهم شيوعًا هي اعتبار «القدرة على التحدث عن الفيزياء» مساوية لـ«القدرة على تنفيذ الفيزياء»، واعتبار «الإطارات/المسارات الجميلة» مساوية لـ«ديناميكيات قابلة للتخطيط». تفشل هذه الفئات بطرق مختلفة؛ ويؤدي خلط فحوصات القبول إلى زيادة مخاطر النشر.
| نمط الإخفاق |
الأكثر شيوعًا في |
كيفية ظهوره |
مخاطر الاختيار |
كيفية اكتشافه |
| هلوسة اللغة |
النموذج اللغوي الكبير |
حقائق/استشهادات خاطئة لكنها سلسة |
مصدر معرفة وحيد أو «دليل» للتحكم |
افرض تتبع المصدر وفحوصات الأدوات وارفض الادعاءات غير المدعومة |
| انحراف الديناميكيات |
نموذج العالم |
الخطوات القصيرة سليمة؛ لكن عمليات المحاكاة الطويلة تتشوه |
ثقة بحلقة مفتوحة على آفاق زمنية طويلة |
ارسم الخطأ مقابل الأفق؛ وتحقق من إعادة التخطيط |
| فيزياء زائفة |
نموذج العالم |
مسارات سلسة تنتهك التلامس/الحفظ |
عروض مرئية بوصفها اعتمادًا للفيزياء |
تحقق من الاختراق والطاقة وقيود التلامس |
| التعامل مع نموذج لغوي كبير بوصفه محاكيًا |
عدم تطابق في الاختيار |
يحل الوصف النصي محل انتقالات الحالة |
مهام مادية بلا حلقة مشروطة بالفعل |
اطلب واجهة الفعل والحالة القابلة للمحاكاة |
| التعامل مع نموذج العالم بوصفه محرك محادثة |
عدم تطابق في الاختيار |
فرض التنبؤ بالحالة على أسئلة وأجوبة الدعم |
تكلفة مرتفعة، وتجربة مستخدم لغوية ضعيفة |
اسأل عما إذا كانت جودة النص هي المهمة الرئيسية |
ينبغي أن ترتبط فحوصات المخاطر بمحفزات: إذا كانت المهمة تتعلق أساسًا بالصحة الدلالية، فاحكم هلوسة اللغة أولًا؛ وإذا كانت تتعلق أساسًا بعواقب التحكم، فاحكم انحراف الديناميكيات والفيزياء الزائفة أولًا. لا تحل سرديات القدرات محل فحوصات القبول.
الملخص
تحل نماذج العالم والنماذج اللغوية الكبيرة مشكلات تنبؤ مختلفة: تستهدف الأولى عواقب الأفعال والديناميكيات القابلة للتخطيط، بينما تستهدف الثانية اللغة وتنسيق الأدوات. عند الاختيار، حدّد الجانب الذي يتحمل تكلفة الإخفاق، ثم استخدم جدول الشروط للاستخدام المنفرد أو الدمج.
التنبؤ بالتمثيلات بأسلوب JEPA موجه نحو نموذج العالم وليس نموذجًا لغويًا كبيرًا. وعند القبول، افحص هلوسة اللغة بصورة منفصلة عن انحراف الديناميكيات / الفيزياء الزائفة، حتى لا يخفي عرض واحد نمط الإخفاق الآخر.
الأسئلة الشائعة
ما الفرق بين نموذج العالم والنموذج اللغوي الكبير؟
يتنبأ نموذج العالم بصورة أساسية بالحالة التالية أو الديناميكيات الكامنة بعد فعل ما لأغراض التخطيط والتحكم؛ بينما يتنبأ النموذج اللغوي الكبير بصورة أساسية بالرمز التالي لفهم اللغة وتوليدها وتنسيق الأدوات. يمكن لكليهما «التوليد»، لكن النجاح يعني عواقب قابلة للتحقق مقابل دلالات وتنسيق قابلين للاستخدام.
هل يمكن لنموذج العالم أن يحل محل النموذج اللغوي الكبير؟
عادةً لا. لا يوفر نموذج العالم بطبيعته واجهة لغوية قوية أو تنسيقًا واسع النطاق للنصوص؛ ولا يوفر النموذج اللغوي الكبير بطبيعته ديناميكيات مشروطة بالفعل قابلة للمحاكاة. فضّل النماذج اللغوية الكبيرة للمهام اللغوية، وأضف مكونات نموذج العالم عندما تحتاج المهمة إلى عواقب بيئية.
متى ينبغي استخدام نموذج العالم؟
استخدم نظامًا موجهًا نحو نموذج العالم عندما تتطلب المهمة التنبؤ بالحالة التالية من الحالة والفعل، ثم التخطيط أو التحكم أو تجربة التحركات في الخيال. تشمل الحالات النموذجية التخطيط في البيئات المادية، والتعلم المعزز القائم على النموذج، واستشراف العواقب قصيرة الأفق. ولا تكون الكتابة البحتة أو الأسئلة والأجوبة حول المستندات هي الاستخدام الأنسب عادةً.
كيف ترتبط JEPA بالنماذج اللغوية الكبيرة؟
يتنبأ JEPA (بنية التنبؤ بالتضمين المشترك) بتمثيلات مستقبلية أو محجوبة في فضاء التضمين، وينتمي إلى تعلم التمثيلات المرتبط بنماذج العالم؛ بينما تركز النماذج اللغوية الكبيرة على التنبؤ بالرمز التالي. يمكن لكليهما أن يكون ضمن بنية وكيل، لكن الأهداف والمقاييس تختلف — فـJEPA ليس «نموذجًا لغويًا كبيرًا آخر».
هل يمكن استخدامهما معًا؟
نعم — وبالنسبة إلى المهام التي تمزج التعليمات باللغة الطبيعية مع التنفيذ في بيئة ما، يكون الدمج مطلوبًا غالبًا: يحلل النموذج اللغوي الكبير الأهداف والقيود؛ بينما يتنبأ نموذج العالم أو المخطط بالعواقب ويصفّي المسارات. العنصر الأساسي هو واجهة واضحة ومحفزات لإعادة التخطيط، وليس ربطهما في موجّه واحد.