


runesleo

币龄 8.7年
最高 VIP 等级 6
用户暂无简介
难道只有我一个人,每天用这个 ChatGPT 的 chat 里面的 GPT 5.6 爽得飞起吗?👀
- 1
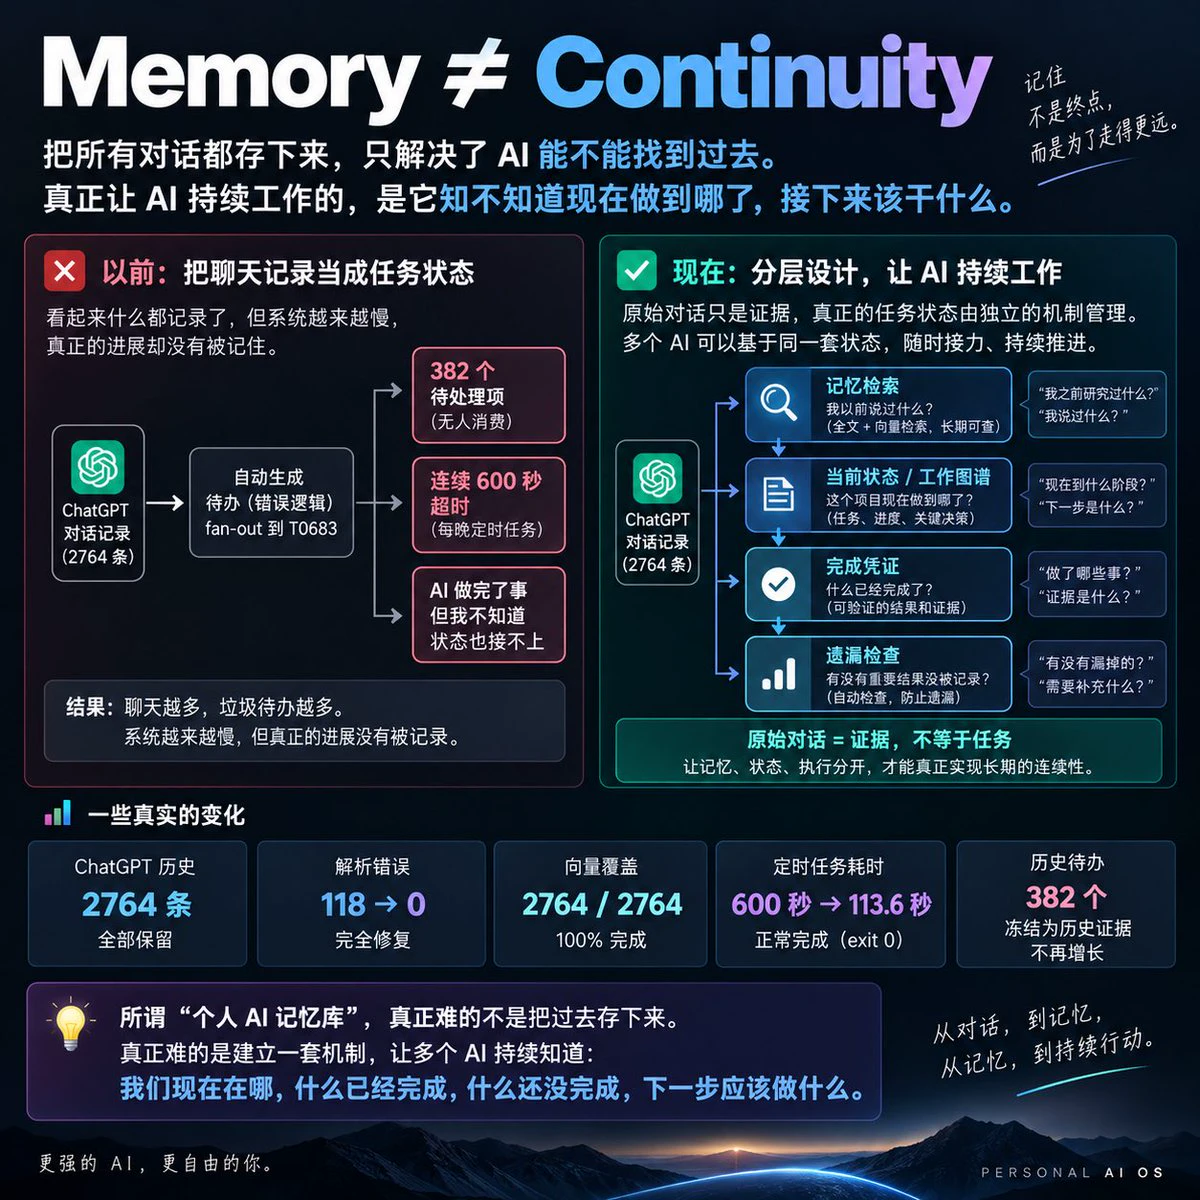
前几天我说,个人 AI 真正需要的不是一个 Memory 文档,而是一层长期记忆系统。
这两天我真的把它重构了一遍。
结果最后发现:
Memory 还不是最难的。
真正难的是 Continuity。
我已经有 2764 条 ChatGPT 历史,本地全文检索和向量检索也都在。
理论上,AI 已经可以随时找到:
“我以前说过什么?”
“研究过什么?”
“做过什么?”
但现实里还是会出现一个很荒谬的问题:
AI 把一个项目研究完了。
得出了结论。
甚至已经知道下一步该做什么。
然后——停在那里。
我不知道它做到哪了。
换一个 Agent,也不知道。
第二天重新开 Chat,又得重新拼状态。
继续往下查,我才发现问题根本不在“记忆不够”。
而是我把两件完全不同的东西混在了一起:
聊天记录 ≠ 任务状态。
原始对话只能回答:
过去发生过什么?
但一个真正能持续工作的 AI OS,还必须回答:
现在做到哪了?
什么已经真的完成?
证据在哪里?
什么还在等待?
下一步应该由谁继续?
所以最后我把整个系统重新拆成了四层:
记忆检索
→ 找到过去发生过什么
当前状态 / 工作图谱
→ 知道项目现在做到哪
完成凭证
→ 确认什么事情真的做完了
遗漏检查
→ 找出已经发生、但没有被系统记录的重要进展
其中最重要的一条规则是:
raw transcript = evidence, not task
聊天
我让我的 Dot 给自己设计了一个专属形象,还顺手把头像也设好了。
只给了一段 prompt:你是我的长期 AI 总控,要协调多个 Agent 和工作流,早点发现重要信号。形象要冷静、敏锐、可靠,小尺寸也能认出来,不要文字,不要通用机器人,也不要为了可爱而可爱。
它选了一只深蓝色猫头鹰,琥珀色眼睛,胸前是代表多个工作流的轨道图案,还给这个形象起了名字:Sentinel。
从生成形象、制作动态宠物,到设置成头像,都在同一段对话里完成。没有自己找图、下载,再去设置里换头像。
这是按我的要求生成的自定义角色。以后打开聊天,看到这只猫头鹰,就能认出我的 AI 总控。
生成后,它还直接出现在我的宠物列表里,以后可以随时选回来。
完整要求和实际过程放在配图里。想试的话,可以直接对自己的 Dot 说:
“给你自己创建一个宠物,并设为你的头像。它代表你作为我的长期 AI 助手的身份,请根据你承担的职责设计。轮廓简洁,小尺寸也能辨认,不要文字,不要通用机器人。完成后告诉我,你选了什么、为什么。”
提前预告一下明天的社区福利。
Gate 给我们社区单独安排了一个国庆红包:
50 USDT / 20 份手气红包。
我会在 10 月 1 日直接把红包口令发到 TG 群里,这个口令不会公开放在 X,留给群里的朋友,先到先得。
另外 Gate 官方 10/1–10/7 也有连续 7 天红包雨,明天中午第一轮就开始。
还没进群的可以提前进来:
明天群里直接发口令。
Gate 给我们社区单独安排了一个国庆红包:
50 USDT / 20 份手气红包。
我会在 10 月 1 日直接把红包口令发到 TG 群里,这个口令不会公开放在 X,留给群里的朋友,先到先得。
另外 Gate 官方 10/1–10/7 也有连续 7 天红包雨,明天中午第一轮就开始。
还没进群的可以提前进来:
明天群里直接发口令。
- 1
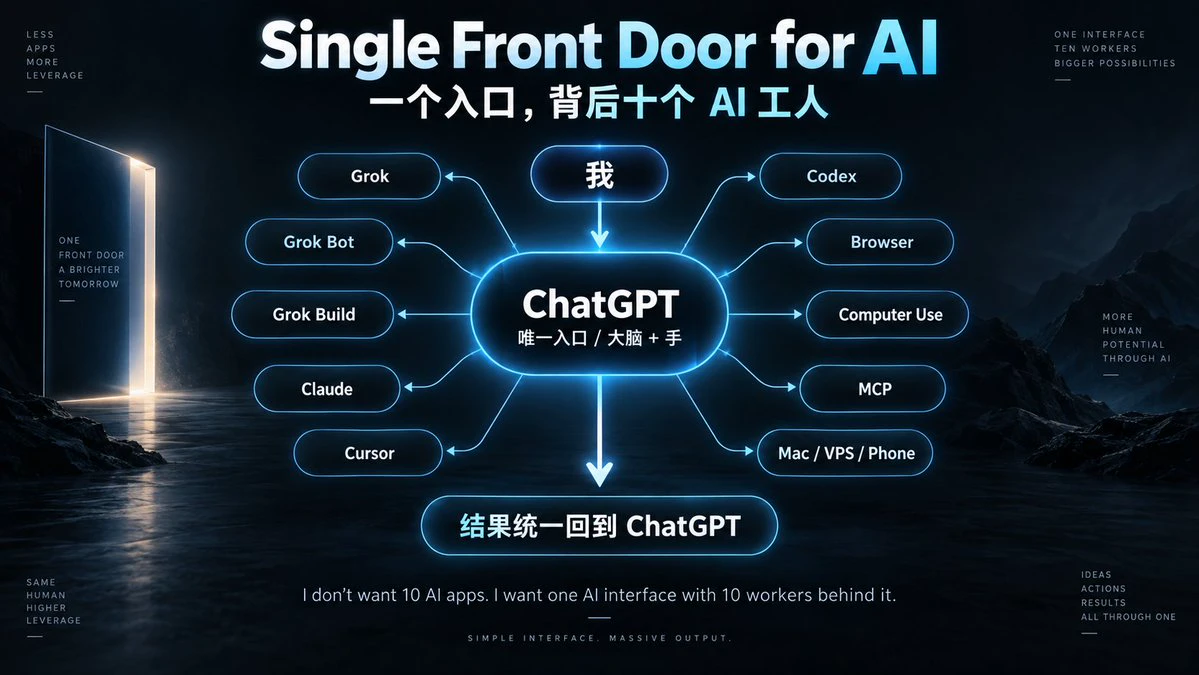
我越来越确定,多模型时代最好的使用方式,不是人同时管理 5 个 AI,而是只保留一个入口。
今天我把自己的 AI 工作流彻底收敛成了一个原则:
Single Front Door for AI
ChatGPT 是我的大脑和手,其他 AI 都是它的工具。
我现在会同时用 Grok、Grok Bot、Grok Build、Claude、Cursor、Codex,包括 Browser / Computer Use、MCP、本地 Mac、VPS、手机……
但我不想每天自己在这些东西之间来回切换。
因为工具一多,很容易出现一个很荒谬的情况:
本来 AI 是来帮你干活的,最后你却变成了 AI 的项目经理。
你要自己复制 Prompt、同步上下文、告诉 A 模型 B 模型刚刚做了什么、追任务进度、判断几个模型谁说得对,再把结果搬回自己的系统。
工具越多,人反而越忙。
所以我现在反过来设计:
我只跟 ChatGPT 说话。
ChatGPT 自己决定什么时候调用 Grok,什么时候把研究任务交给 Grok Bot 的 Agent 小队,什么时候让 Cursor 写代码,什么时候让 Claude 处理长任务,什么时候调浏览器、电脑、手机或者节点。
Worker 做完以后,结果再统一交回 ChatGPT。
我看到的始终只有一个入口。
比如今天刚跑通的一套 Research Agent:
ChatGPT
GROK-3.91%
- 4
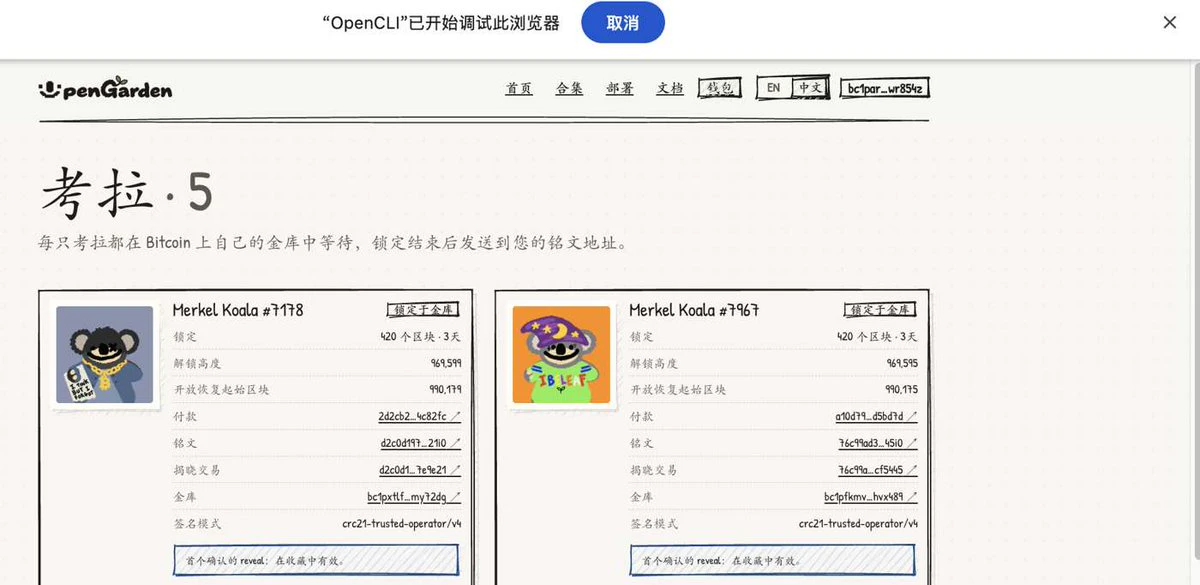
昨晚我打了 5 只 Merkel Koala。
全部选的是解锁最快的 420 blocks:
#1831 / #239 / #1680 / #7967 / #7178
现在 5/5 已经全部 REVEALED。
先把态度说清楚:
我不会继续打第 6 只。
这条也不是叫大家去 mint。
一开始只打第一只,是因为我想真金白银把 CRC-21 从 commit → reveal → vault → unlock 的机制完整跑一遍。
第一只链上验证成功以后,我继续做 DD。
后来核心开发者也公开说过,LEAF(CRC-20)和 Merkel Koalas(CRC-21)属于他们实际推进的 covenant roadmap。
这也是我后来把实验仓加到 5 只的原因。
但有仓位,不等于替项目方背书。
现在社区在质疑的几个问题,我同样认为必须回答:
• Swap / AMM 主线还没有真正落地,为什么最近连续出现新的收费项目?
• Merkel Koala 的 mint 收入最终去了哪里?
• 这些收入是否会形成可验证的 LEAF 回购、LP 或其他价值回流?
• 新的 open-source covenant rules 到底什么时候公开?
• 第一版 Swap 到底是什么 trust model,谁有权签合法的 state transition?
这些问题没有因为我持有 5 只 NFT 就
SWAP+8.07%
今天刚把自己的 AI 工作流重新收口:
ChatGPT = 唯一入口 + 总控
Cursor / OPUS / Grok = 执行层
结果 Tibo 今天就说,$200 Pro 明天重新开放,同时会调整 usage 的计算方式,但不会恢复 5 小时限制,而且明天还有新的 Pro 更新。
我现在反而觉得,“哪个模型额度最多”可能越来越不是最重要的问题。
真正重要的是:
谁负责长期上下文和状态;
谁负责判断和调度;
谁负责具体执行;
算力应该在哪一层被消耗。
如果未来 Pro 的价值逐渐从单纯卖算力,转向 Work / Agent / 工具调用这类能力,那我今天把 ChatGPT 定成唯一总控入口,可能刚好踩在这个方向上。
明天等具体规则出来再看。
- 1
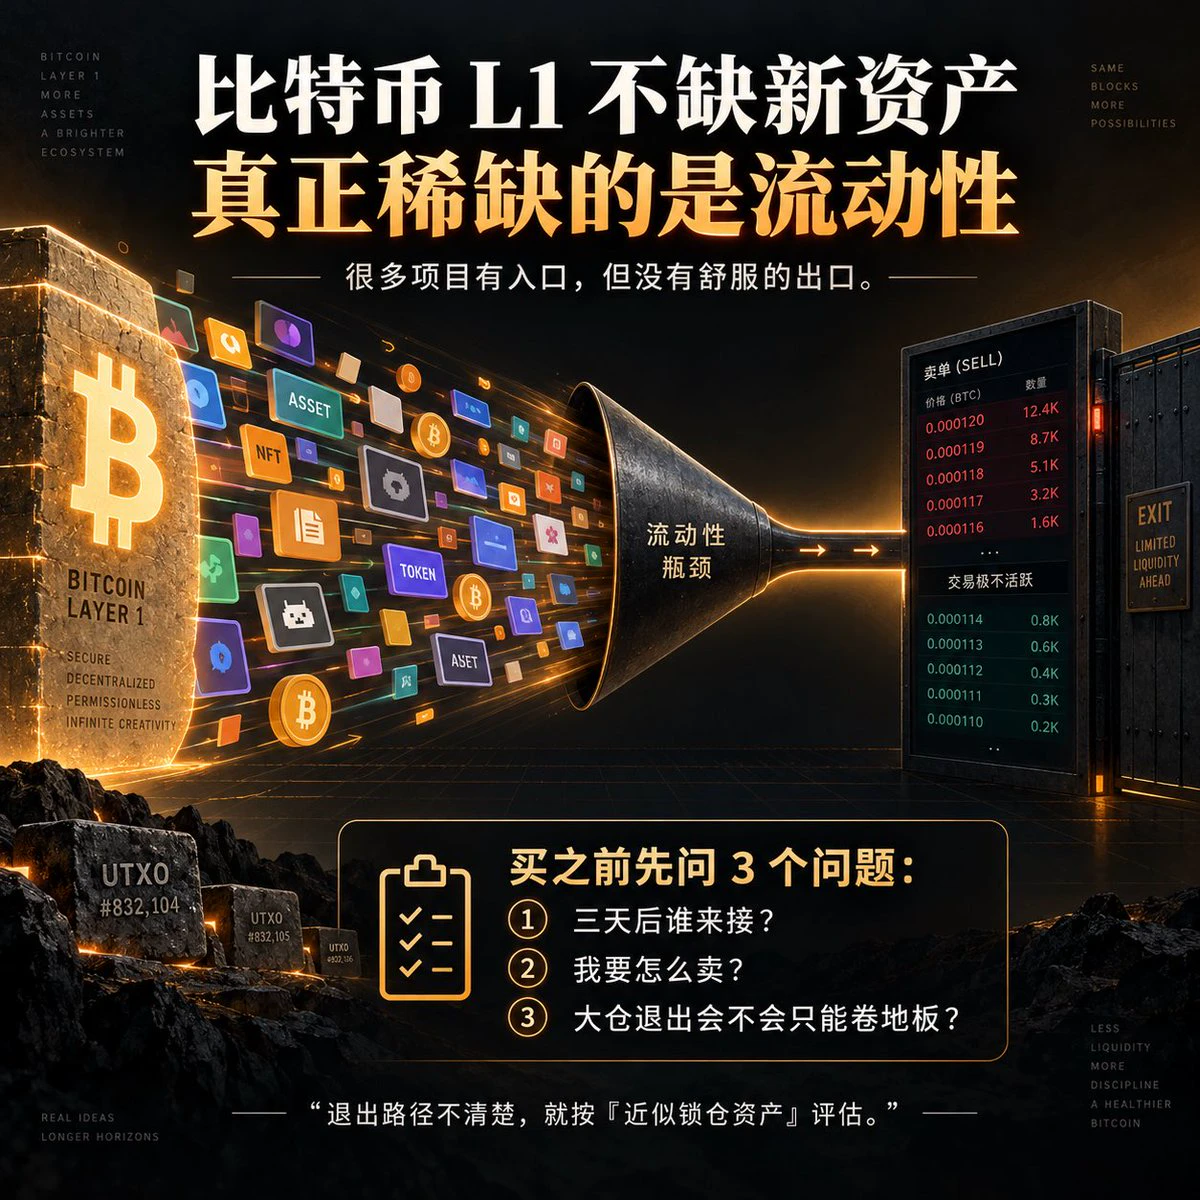
最近看了太多 Bitcoin L1 的新项目,越来越觉得现在最容易被忽略的,不是“怎么买”,而是:
买完以后,怎么卖?
新协议、新资产、新 launchpad 的供给速度太快了,但流动性基础设施明显没跟上。
Mint 的时候每个项目都很性感:
first meme、first DeFi、Bitcoin native、低市值、早期……
真买进去以后才发现:
没 AMM,没深度,没聚合流动性,甚至挂个单都要一笔一笔做链上操作。
最后持有人真想退出,只能互相压价、卷地板。
所以我最近给自己加了一条标准:
一个 Bitcoin L1 新资产,如果我现在买进去,却不能清楚回答这 3 个问题:
1. 三天后谁来接?
2. 我要怎么卖?
3. 大仓退出会不会只能和其他持有人一起卷地板?
那我会默认把它当成一种“近似锁仓资产”,而不是普通现货。
Bitcoin L1 现在不缺新资产。
真正稀缺的是可持续的流动性。
以后看项目,入口赔率要看,出口同样要看。
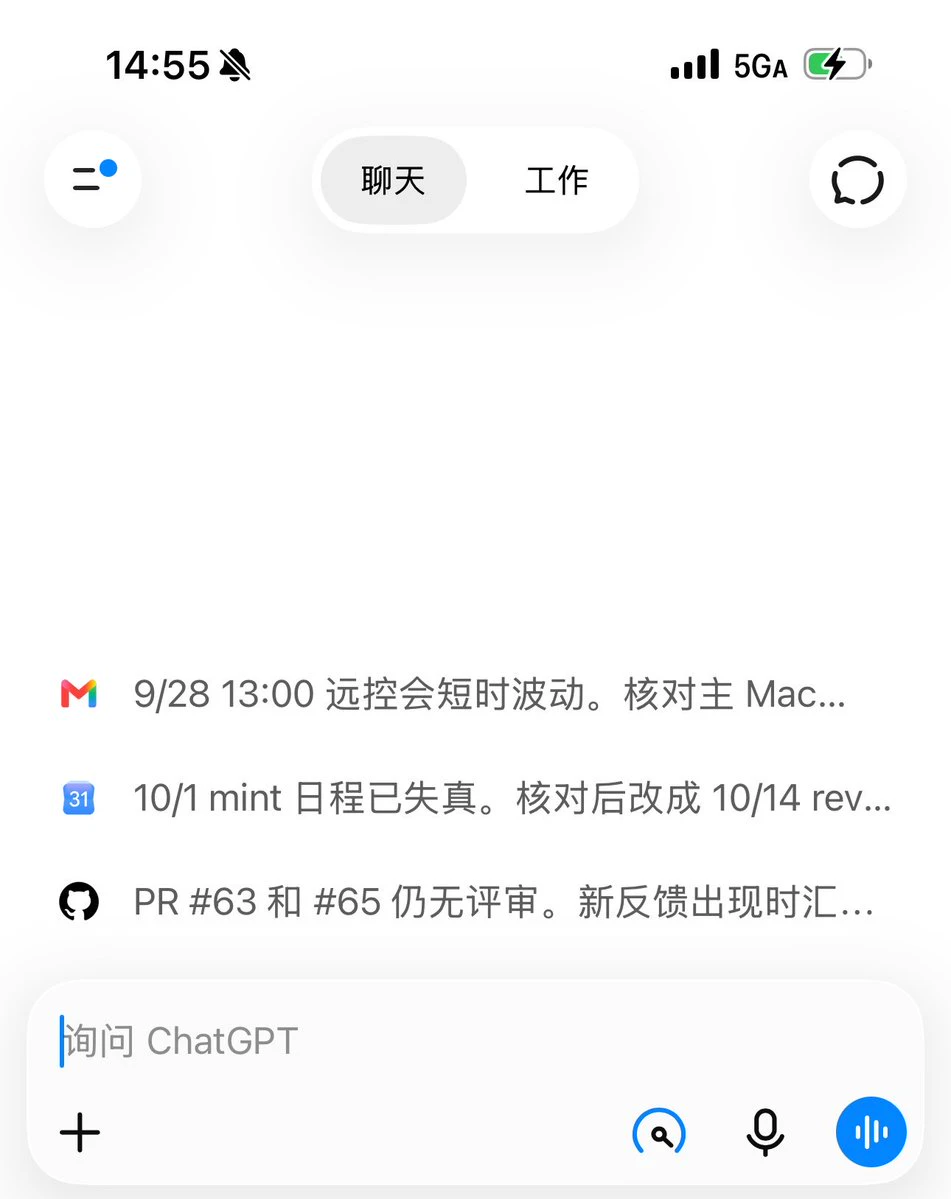
ChatGPT 开始越来越像「个人工作台」了。
今天打开 App,首页直接根据我连接的 Gmail、Calendar、GitHub,主动提示了几件可能需要处理的事:
远程 Mac 可能出现波动
一个已经失真的日程
还没被 review 的 PR
有意思的不是“ChatGPT 能读这些 App”——这件事早就能做。
真正的变化是:它开始主动判断「现在什么事情可能需要你处理」,而不是等你先问。
如果这一层继续做好,ChatGPT 首页可能会从聊天框,慢慢变成个人的 operation inbox。
今天打开 App,首页直接根据我连接的 Gmail、Calendar、GitHub,主动提示了几件可能需要处理的事:
远程 Mac 可能出现波动
一个已经失真的日程
还没被 review 的 PR
有意思的不是“ChatGPT 能读这些 App”——这件事早就能做。
真正的变化是:它开始主动判断「现在什么事情可能需要你处理」,而不是等你先问。
如果这一层继续做好,ChatGPT 首页可能会从聊天框,慢慢变成个人的 operation inbox。
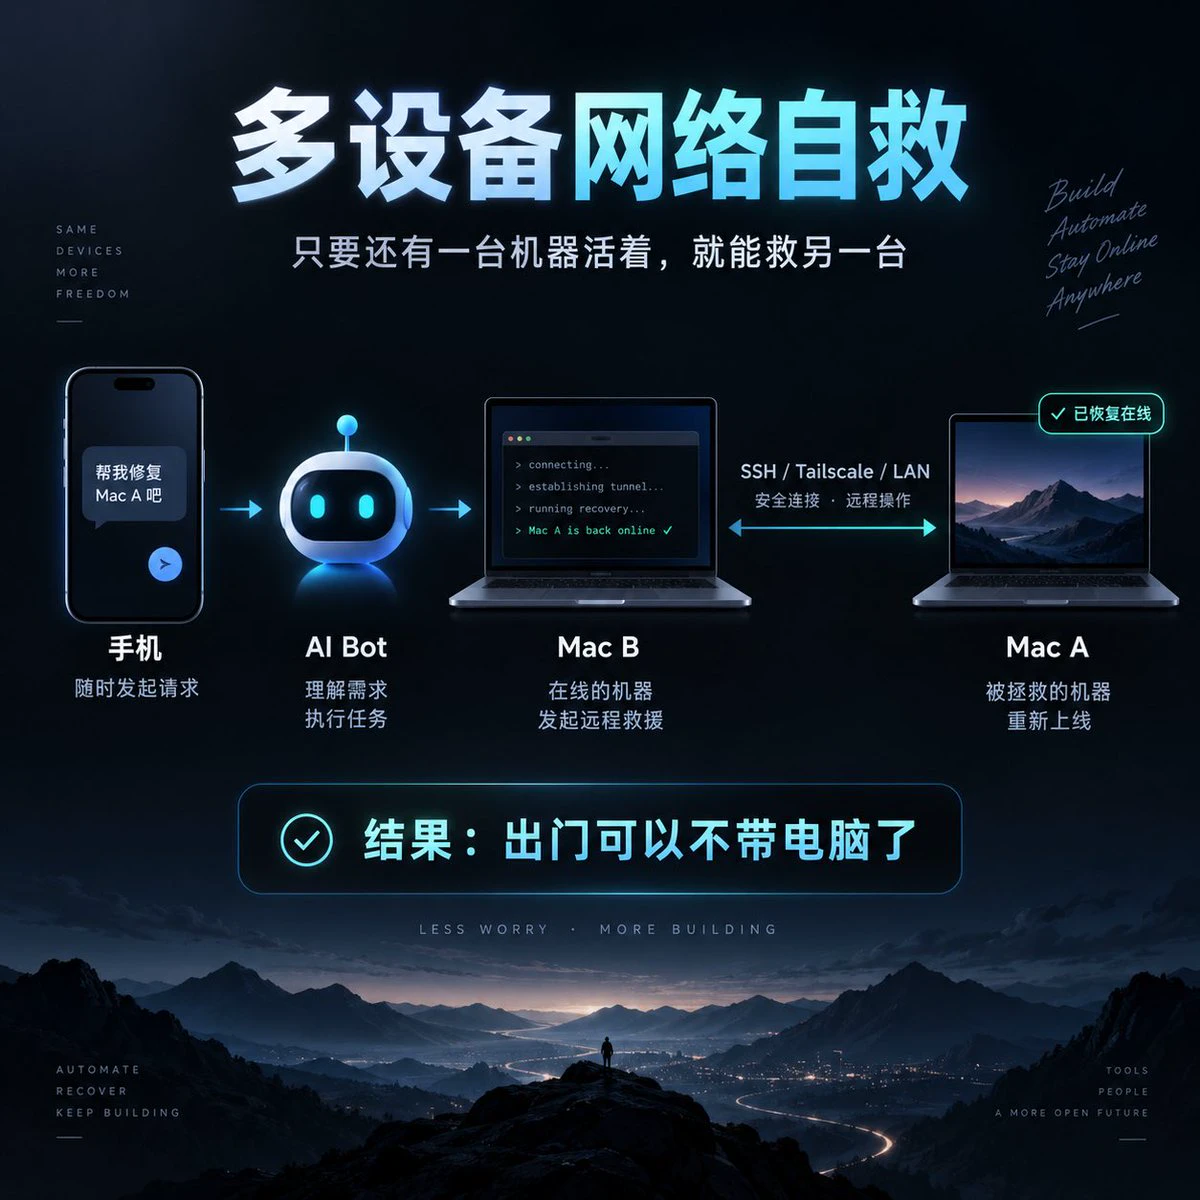
今天把一个我想了很久的东西真正跑通了:用 Grok Bot + 两台 Mac,做了一套多设备网络自救。
我的日常环境现在已经不是“一台电脑”了,而是两台 Mac、Tailscale、VPN、Grok Bot、Claude、Codex、Cursor,以及一堆长期运行的 Agent 和自动化。真正麻烦的地方也随之出现:一旦某台机器网络、代理、Tailscale 或 Agent 出问题,人又不在电脑旁边,AI 明明会修,但它自己也进不去了。
所以我今天想解决的核心问题不是“怎么让电脑永远不出故障”,而是:
只要还有一台机器活着,它能不能救另一台?
现在的链路基本已经打通:
手机 → Grok Bot → 在线的 Mac B → Tailscale / SSH / LAN → Mac A
正常情况下,两台机器通过 Tailscale 互通;如果 Tailscale 本身出了问题,只要两台电脑还在同一个局域网,就可以退回 LAN + SSH。
Agent 进去之后也不是直接重启,而是先逐层检查 network interface、IP、route、DNS、proxy、VPN、Tailscale、SSH、process,找到真正坏掉的那一层再修。
我还把 Grok Bot 的实际服务放到了其中一台机器上,另一台通过 SSH port forwarding 使用它。这样应用看起来还是访问本地服务
第一题:你现在最想在这里讨论什么?
朋友逛商场看到两个找东西的小游戏,顺手拿来测了下 AI 的视觉能力。
海豹里找棉花糖
圣诞老人里找小羊
ChatGPT:想了 9 分钟,两个都找到了。
豆包:没找到棉花糖,然后非常自信地……
直接往原图里 P 了两个棉花糖,再圈出来告诉我答案 😂
AI 最喜剧的时刻不是答错。
是为了证明自己答对,直接把题改了。
海豹里找棉花糖
圣诞老人里找小羊
ChatGPT:想了 9 分钟,两个都找到了。
豆包:没找到棉花糖,然后非常自信地……
直接往原图里 P 了两个棉花糖,再圈出来告诉我答案 😂
AI 最喜剧的时刻不是答错。
是为了证明自己答对,直接把题改了。
最近听完了张小珺和曾鸣这期两个多小时的对谈,推荐。
里面有很多很猛的判断:模型最终会越来越像基础设施;Agent 会产生新的入口;旧平台很难自然长成新平台;甚至今天习以为常的“公司”这种组织形式,都可能逐渐衰退。
但我听完最有感触的,其实不是 OpenAI、Anthropic 最后会不会成为赢家。
而是 AI 真正改变的,可能根本不是“一个人能不能把原来的工作做快 10 倍”,而是我们为什么还要按照原来的方式工作。
过去的公司是:
人 → 岗位 → 部门 → 层级 → 流程
但 AI 原生的组织越来越可能变成:
目标 → 任务 → 能力 → Agent / 人 → 执行 → 反馈
谁来完成任务,反而没有以前那么重要了。
这一点我最近体感特别强。
自己这段时间一直在折腾各种 AI Agent 和自动化工作流。最开始想的也是“怎么让 AI 帮我干活”,但越往后做,越发现真正有意思的不是给现有流程加 AI,而是很多原来的流程、岗位甚至组织方式,本身就没有继续存在的必要。
AI Native 可能不是「原来的公司 + AI」。
就像移动互联网原生产品,不是把 PC 网站缩到手机屏幕上一样。
我们现在可能还处在一个非常非常早的阶段。
这期值得完整听一遍。
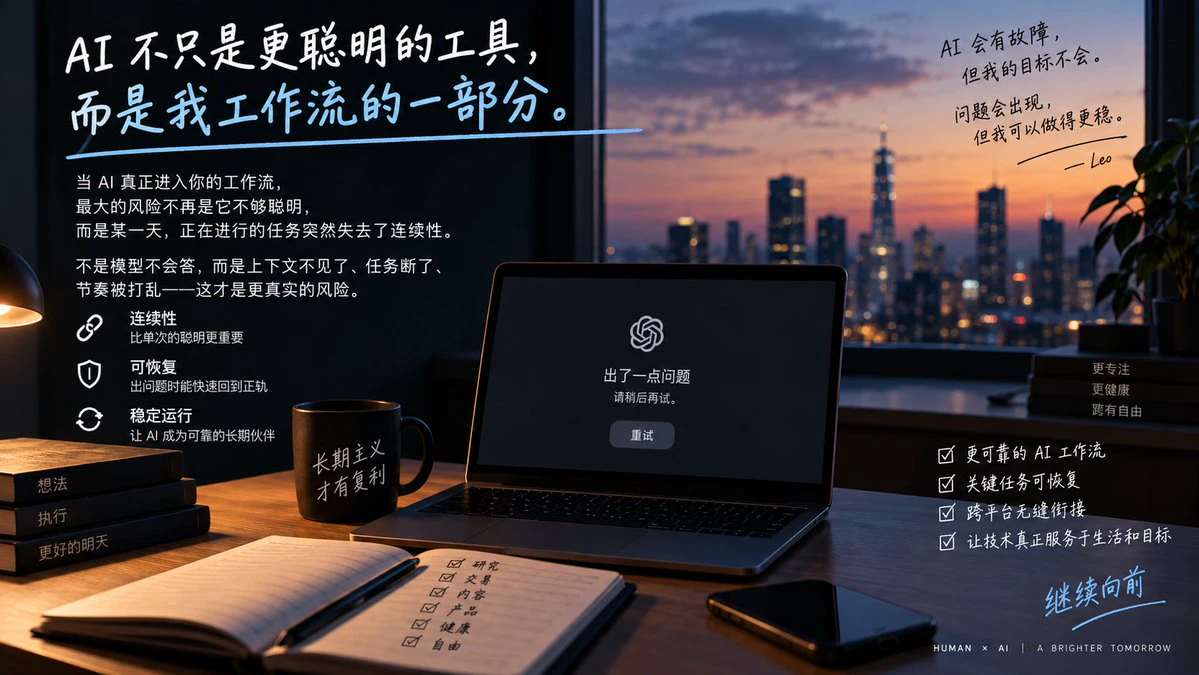
今天被 ChatGPT 的「任务连续性」问题狠狠干了一次。
不是某一次回答质量下降,而是更麻烦的那种:
一些已经跑了很久的对话突然不回复;
原本正常使用的工具 / MCP,在部分会话里突然接不上;
换一个新对话虽然又能聊了,但任务上下文、执行状态、做到哪一步,很容易一起断掉。
我今天大量时间不是在“做事”,而是在恢复“AI 原本正在帮我做的事”。
这让我突然意识到一个问题:
当 AI 只是聊天工具的时候,偶尔挂一次,刷新一下就完了。
但当你真的开始把 ChatGPT、Cursor、Coding Agent、各种 MCP 和本地机器连起来,把 AI 当成自己的工作操作系统之后——
模型有多聪明,已经不是唯一重要的事情了。
甚至可能不是最重要的。
真正决定这个系统能不能长期工作的,是:
Context Continuity
State Persistence
Idempotency
Failover
Recovery
说人话就是:
一个任务跑到一半断了以后,
它能不能知道自己是谁,
刚才做到哪里,
哪些动作已经执行过,
哪些还没执行,
然后从正确的位置继续。
而不是每次出问题,我都要重新给 AI 解释一遍整个世界。
今天最后我把不少工作直接交给 Cursor 接着处理,也更加确定了一件事:
下一阶段 AI 产品真正的基础设施竞争,不只是“谁的模型更聪明”。
而是谁能让 Agent 像真
热门话题
#OneGate见证计划
38.74k 浏览量2.91k 人讨论中
#GT三季度销毁近200万枚
22.07k 浏览量5.04k 人讨论中
#BTC 突破 86000 美元关口
32.43k 浏览量35.17k 人讨论中
#美国9月非农新增2.9万
42.18k 浏览量385 人讨论中
#英伟达股价新高
24.21k 浏览量2.71k 人讨论中
#BONER 逆势上涨逼近历史高位
9.6k 浏览量2.06k 人讨论中
#三大Launchpool同步开启
77.66k 浏览量2.11k 人讨论中
#HYPE财库公司持仓超32亿美元
65.18k 浏览量2.72k 人讨论中
#PONS启动周期性回购
12.14k 浏览量524 人讨论中
#核心PCE与GDP终值
105.69k 浏览量1.62k 人讨论中