


Stephan_

币龄 3.6年
最高 VIP 等级 0
用户暂无简介
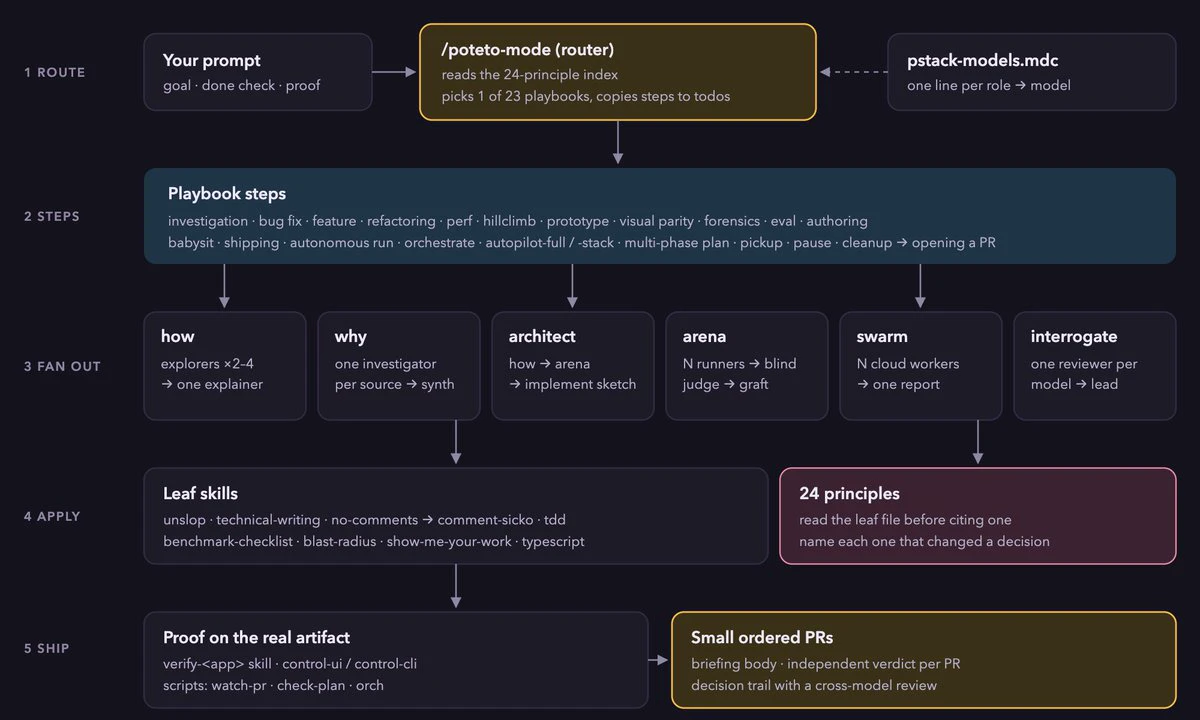
最近在系统学习 @poteto 的 pstack,确实牛逼!感觉豁然开朗了!
等我接下来边学边分享出来:
等我接下来边学边分享出来:
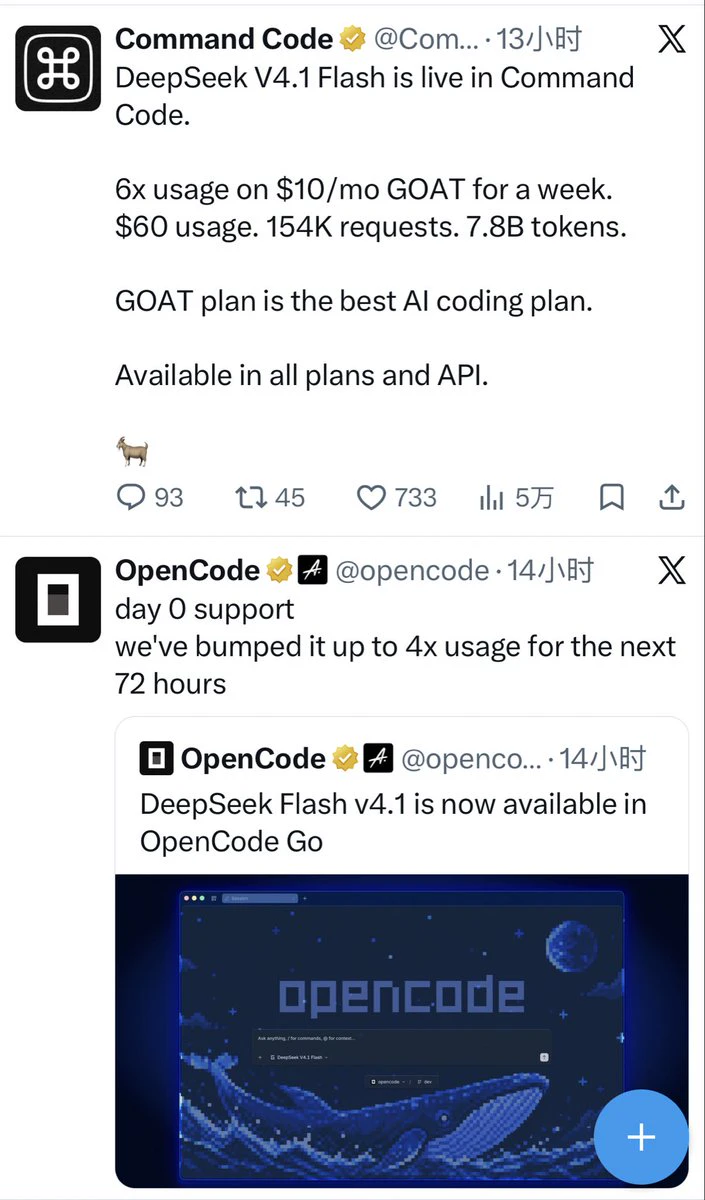
现在最划算的订阅不是opencode-go
也不是 commandcode-goat
是 ChatGPT-plus 😂
也不是 commandcode-goat
是 ChatGPT-plus 😂
最近一直在思考一个问题:面向前沿模型编写skill,确定性和灵活性的平衡如何把握?
确定性指的是用更多硬约束或代码来编写 skill
灵活性指的是更少的细节和约束,只从 high-level 和 prompt-driven 的角度来编写 skill
这两者之间需要一个动态平衡,不是唯一答案
起因是在比较 matt 写的 /spec-implement 和我写的 /pi-matt-implement-flow
我的流程和框架限定很多,好处是确定性强,agent不容易跑偏。坏处也是确定性强,agent自我发挥的空间不足😂
以前的模型还不够聪明,所以我会更偏确定性强的方向
现在Opus-5.5/GPT-6.1-sol这个级别的模型就不一样了,确定性太强似乎反而会限制他的发挥
你怎么看?
- 1
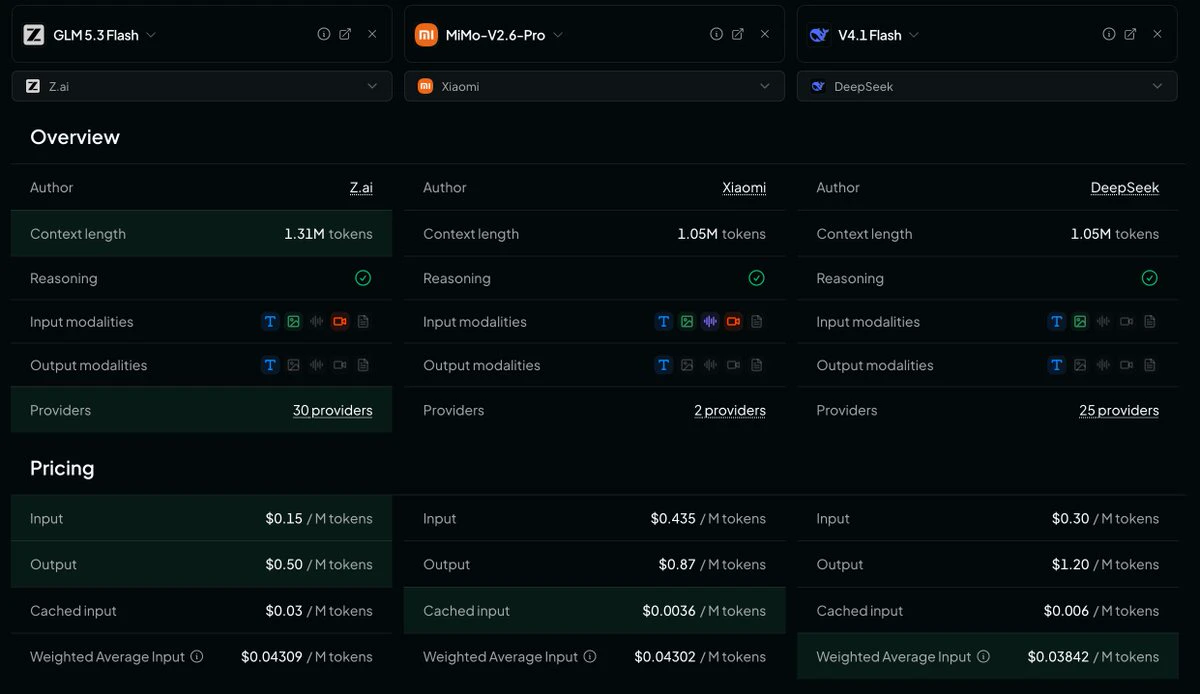
按照 OpenRouter 的真实 Weighted Average Input 来看,这三个模型的成本非常接近了。所以如果从这三个里选一个作为主力模型的话,你会选哪个?
npm 官方仓库挂了,就在我准备注册 npm 官方仓库并发包的时候 😤
- 3
最近的思考🤔:
研发更多的时间应该放在制定 eval 评估数据集和评估准确性及完备性上,然后通过构建 eval loop 驱动业务迭代
而不是直接 vibe coding 业务代码
理想情况下,通过合理的 goal + eval loop ,业务代码应该可以自我迭代才对
正在尝试做这方面的转变,欢迎交流
研发更多的时间应该放在制定 eval 评估数据集和评估准确性及完备性上,然后通过构建 eval loop 驱动业务迭代
而不是直接 vibe coding 业务代码
理想情况下,通过合理的 goal + eval loop ,业务代码应该可以自我迭代才对
正在尝试做这方面的转变,欢迎交流
为什么很多AI测评跑分和自己的体感不太一样?
我觉得关键是大部分测评都是发令枪一响,看谁跑的远
至于跑到哪里去不管,跑到天上去都行,整个测评过程不需要收敛
真实场景下,最磨人的是收敛和对齐的过程,跑的远的不一定就好,能在跑道里一直跑的才好
我觉得关键是大部分测评都是发令枪一响,看谁跑的远
至于跑到哪里去不管,跑到天上去都行,整个测评过程不需要收敛
真实场景下,最磨人的是收敛和对齐的过程,跑的远的不一定就好,能在跑道里一直跑的才好
- 2
用 grok 做了个自动化任务,统计 commandcode GOAT 中主流模型的额度和月估算可调用次数(按调用次数排序),分享一下:

- 3
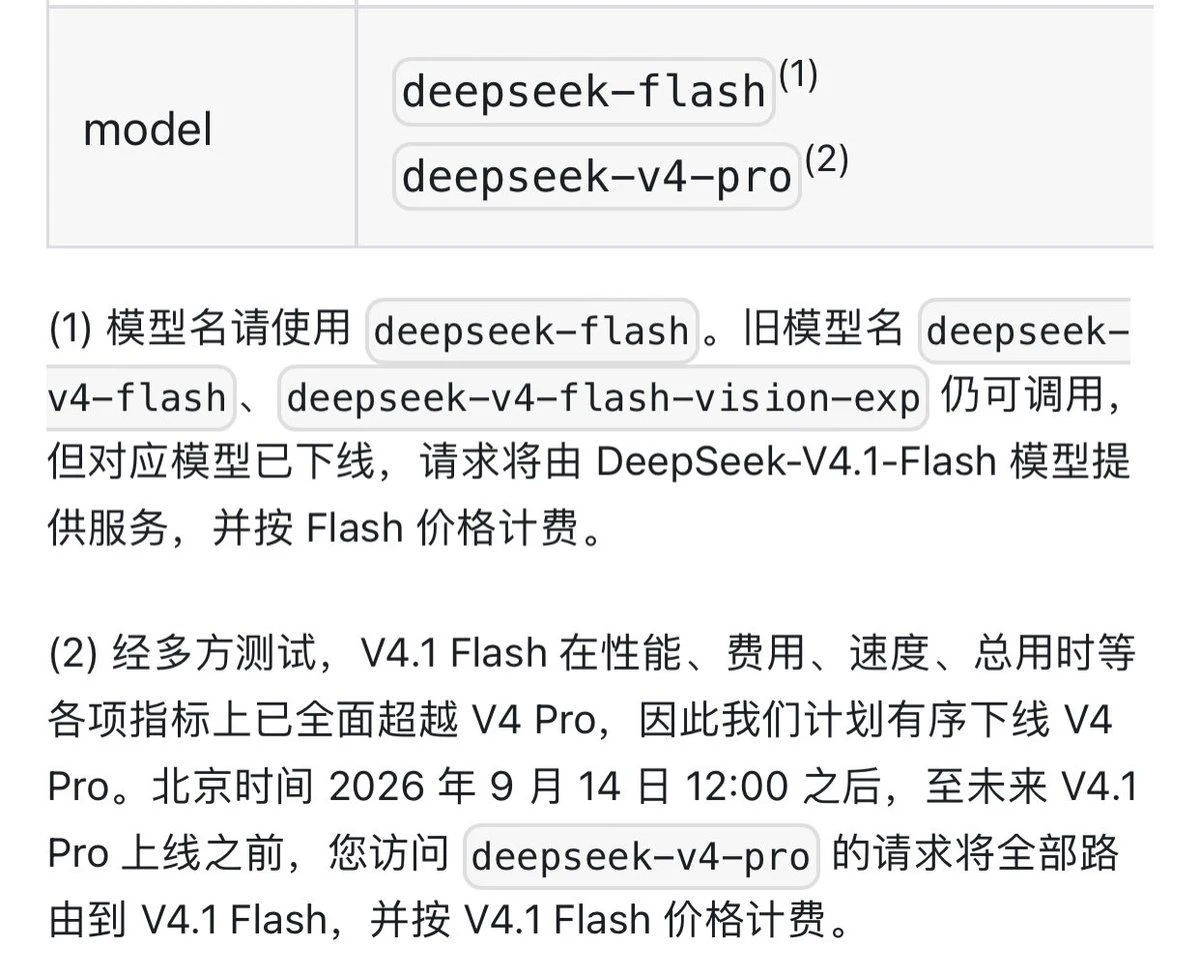
ds这是大一统了呀,全站只有一个模型😂
- 1
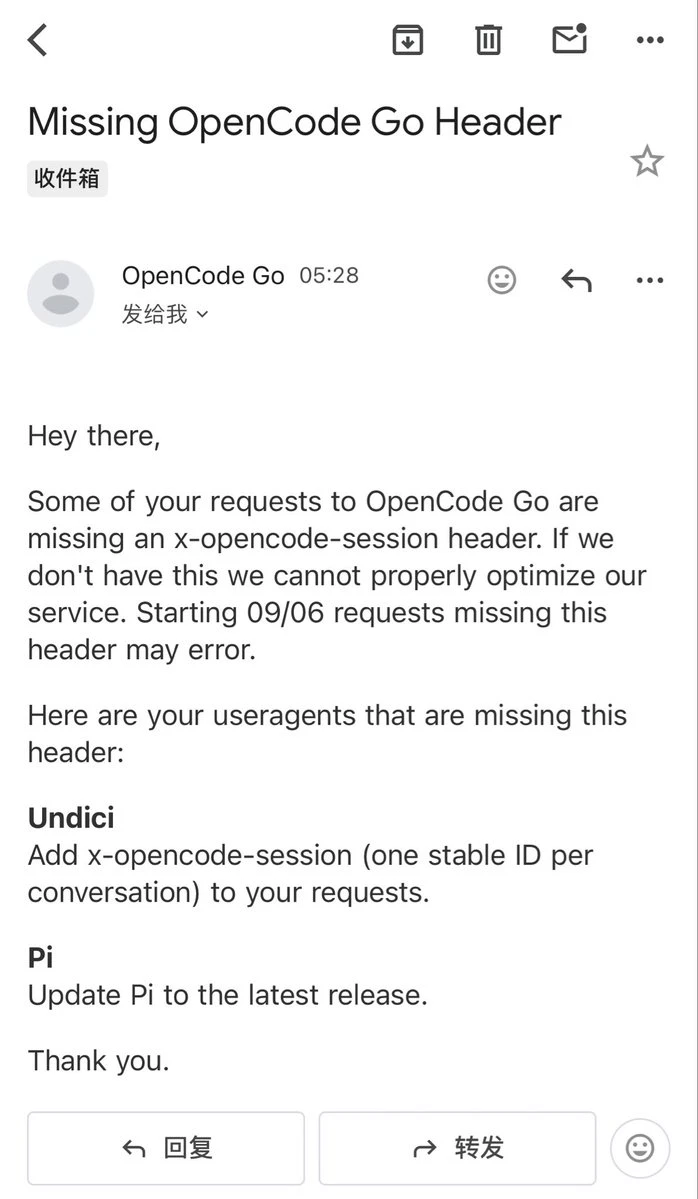
用 pi + opencode-go 订阅有一段时间了,刚刚收到以下这封邮件
总感觉这事有点奇怪,一个 provider 给一个 harness 的客户发邮件,要求尽快升级否则你就用不了我们啦😂
另外,这个 ua 为啥不是 pi-agent 呢,Undici 是 pi 底层通讯用的 sdk 吗?
总感觉这事有点奇怪,一个 provider 给一个 harness 的客户发邮件,要求尽快升级否则你就用不了我们啦😂
另外,这个 ua 为啥不是 pi-agent 呢,Undici 是 pi 底层通讯用的 sdk 吗?
思考一个问题:有没有一套框架,能把一个完整的 SaaS 服务模板 + AI harness + 自定义skill 做成一个可插拔框架?
DeepSeek Harness 可能成为这样的一个基础设施吗?有没有其他已成型的项目?
DeepSeek Harness 可能成为这样的一个基础设施吗?有没有其他已成型的项目?
DEEPSEEK+6.31%
Matt Pocock 提到的 smart zone 是 120K 左右的上下文长度,我用 grok-4.6 的体感也查不多,到接近 200K 左右会出现明显变笨的情况了。不知道大家的体感如何?其他模型是否也有明显的 smart zone ?
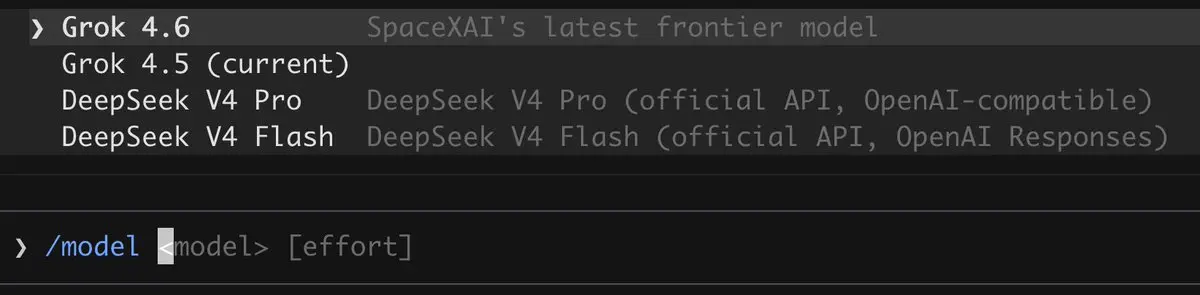
grok build 是我用过体验最好的 TUI ,现在搭配 grok-4.6 可以说是性价比之王了。主要 grok 的速度比很多一线模型要快,质量能站到第一梯队的话竞争力就太强了(而且随便充不封号)!
grok-4.6 & deepseek-v4-pro 一起发布了!
看完了老罗采访周鸿祎的三个半小时的播客,能听出来老周是确实有很多切实的行业经验的,可惜老罗问的问题不够深入和专业,有点遗憾
比如老罗说到海外顶尖模型是这个观点,我觉得是有些偏颇了。因为不同领域有不同的最佳模型,比如在编程领域目前claude-4和gpt-5-codex可能都优于;又比如老周不止一次提到的LLM幻觉问题,在360是如何优化的?并没有追问下去
听完整体感觉最有价值的点就是老周说到的垂直+订阅的收费模式,老周还提到收费模式上应该是token按量计费+membership会员费的方式,这种方式确实是一种长期看更可行的收费模式。单纯卖token的模式壁垒太低,用户付费的动机应该是在LLM之上,产品提供的垂直Agent的能力
比如老罗说到海外顶尖模型是这个观点,我觉得是有些偏颇了。因为不同领域有不同的最佳模型,比如在编程领域目前claude-4和gpt-5-codex可能都优于;又比如老周不止一次提到的LLM幻觉问题,在360是如何优化的?并没有追问下去
听完整体感觉最有价值的点就是老周说到的垂直+订阅的收费模式,老周还提到收费模式上应该是token按量计费+membership会员费的方式,这种方式确实是一种长期看更可行的收费模式。单纯卖token的模式壁垒太低,用户付费的动机应该是在LLM之上,产品提供的垂直Agent的能力
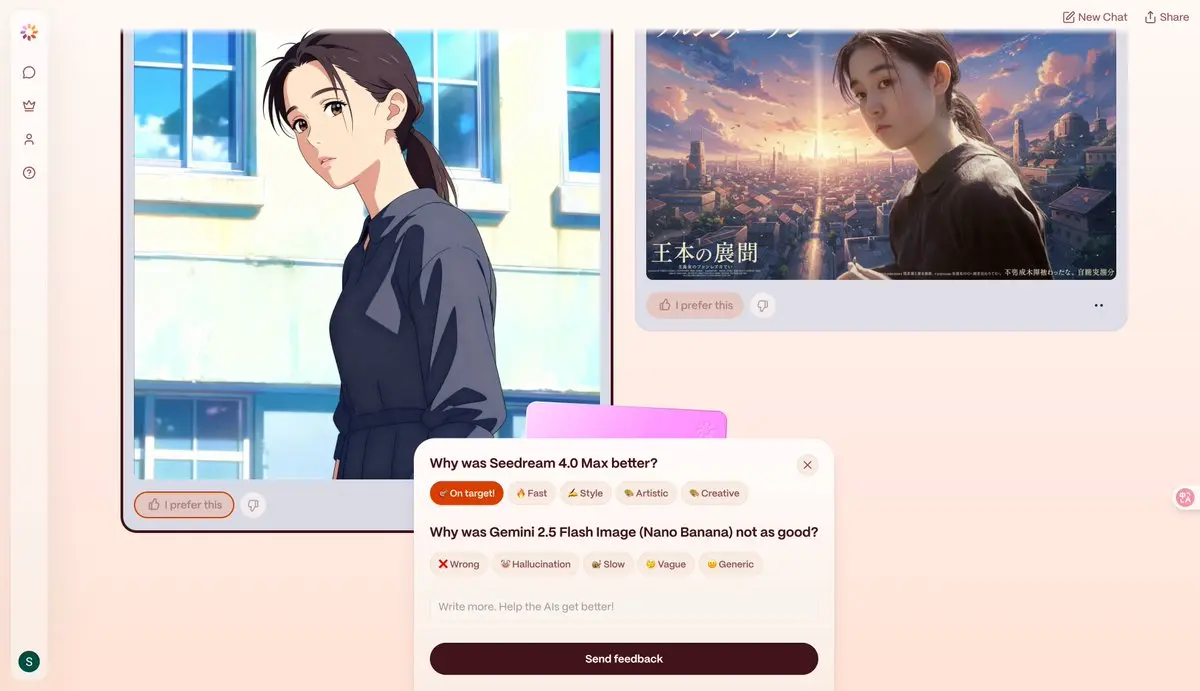
yupp 这个网站有点意思,它能免费使用和对比最领先的AI模型
在 yupp 上的每次对话都有至少两个AI大模型同时给你回答,你可以从其中选择你认为更好的回答,并分享你的使用反馈给yupp
用户反馈可以获得积分,更优质的反馈可以获取更多积分,更多积分意味着你可以使用更多高级模型,甚至将积分提现
这个网站之所以能免费使用大模型,与它建立的用户反馈机制直接相关。这些反馈数据会提供给模型厂商用来优化模型
这个商业模式之所以可行,我认为是因为大模型的token价格会越来越低,而用户真实反馈会更有价值,尤其是跨厂商的比较。对于模型厂商来说用token换用户反馈是很划算的买卖
另一方面对于用户来说,现在模型太多,在不同领域、不同场景下,哪个模型表现最好?哪个模型最适合自己的应用场景? yupp 可以帮我们进行免费的比较
目前 yupp 主要支持文本聊天、图像生成、图像理解等场景,看起来编程领域还不是它的主要应用场景
OpenAI 发布了一篇 "GPT-5 编码指南", 给出了6条使用GPT-5进行AI编程的最佳实践:
# 1. 指令应精确,避免信息冲突
新款GPT-5模型在遵循指令方面的能力有了显着提升,但这也带来一个副作用:当面对模糊或相互冲突的指令时,它可能会难以处理。这种情况在你的 .cursor/rules 或 配置文件中尤其需要注意
# 2. 设定合适的推理级别
GPT-5 在解决问题时总会进行一定程度的推理。若想获得最佳效果,处理复杂任务时应使用 "high reasoning effort" 。如果你发现模型对简单问题有“想太多”的倾向,可以给出更具体的指令,或选择 medium 或 low 的推理级别
# 3. 使用类似XML的语法来帮助结构化指令
我们与Cursor合作发现,使用类似XML的语法可以为模型提供更多上下文,从而使GPT-5更好地工作。例如,你可以给模型以下编码指南:
- 每个组件都应该是模块化和可重用的
- 样式:TailwindCSS
# 4. 避免使用
XPRT+12.08%
热门话题
#Gate发布9月透明度报告
289.37k 浏览量2.61k 人讨论中
#GateWCTCS9全球交易赛
38.11k 浏览量6.9k 人讨论中
#比特币短线站上8.2万美元
41.25k 浏览量2.22k 人讨论中
#拉脱维亚通过加密货币税法
34.37k 浏览量246 人讨论中
#韩国KOSPI开盘暴跌3.17%
47.72k 浏览量2.13k 人讨论中
#特斯拉Roadster带火Meme币
102.34k 浏览量7.65k 人讨论中
#质押LaunchPool瓜分280万$DNA
36.77k 浏览量678 人讨论中
#山寨币反弹势头消退
75.88k 浏览量4.68k 人讨论中
#SpaceX第三季度财报
142.45k 浏览量3.07k 人讨论中
#沃什IMF讲话
62.62k 浏览量1.31k 人讨论中