


Sleepy0x13

币龄 5.4年
最高 VIP 等级 0
用户暂无简介
personal agent 最有用的一集
不过临走才想到可以这样用,还是不够 AI Native
不过临走才想到可以这样用,还是不够 AI Native
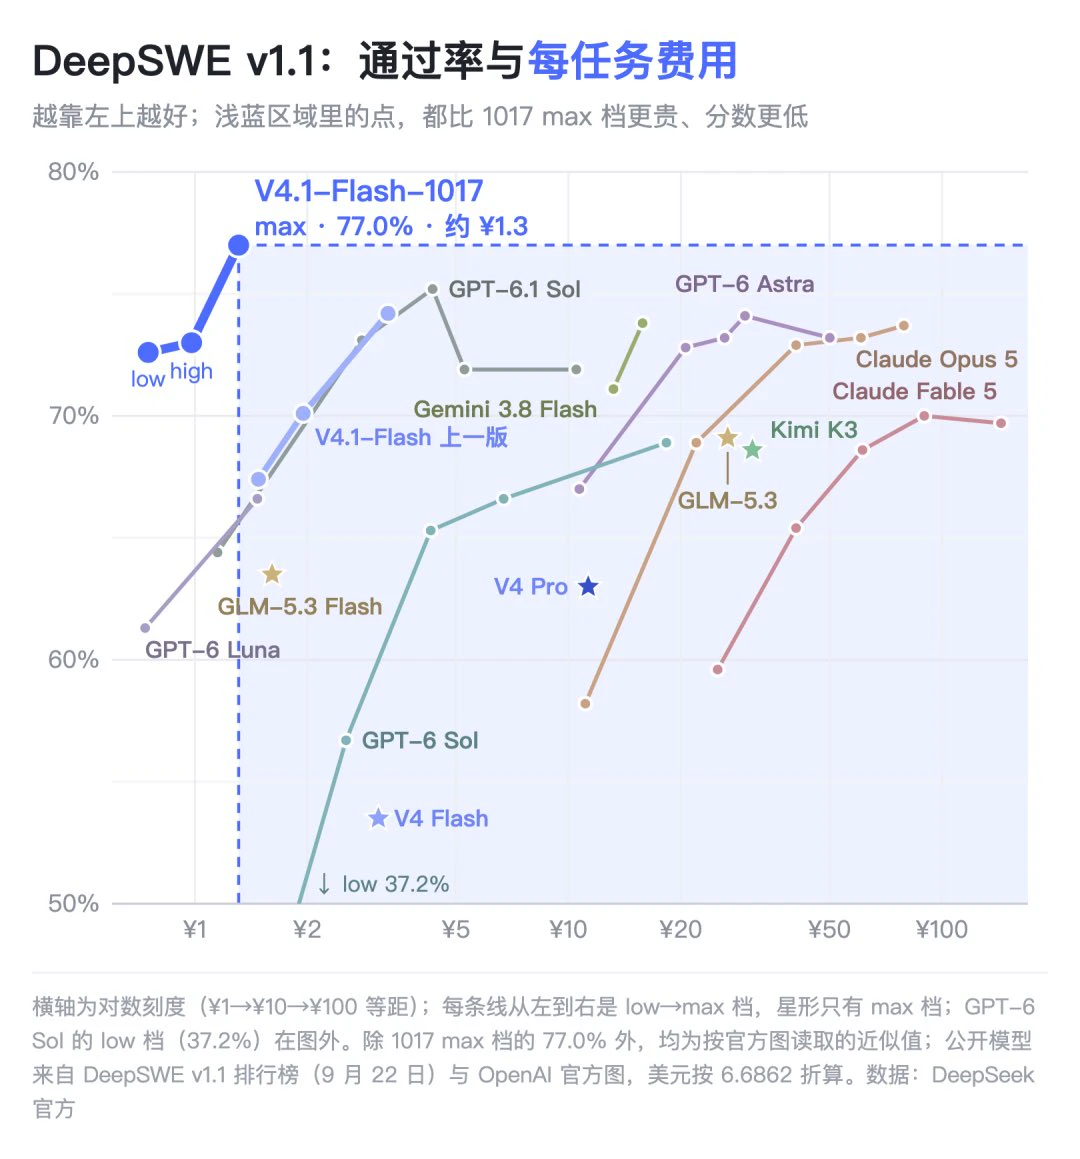
今天更新的 DeepSeek V4.1 Flash-1017,官方公布的 DeepSWE 成绩达到 77.0,超过 Opus 5 的 74.0 和 GPT-5.6 Sol 的 73.0;Automation-Bench 拿到 60.5,Opus 5 只有 50.3;Agents’ Last Exam 也是 35.4 对 28.6。
关键这还是 Flash,API 单价没有上涨,任务耗时和输出长度反而进一步下降。当然,部分复杂推理测试仍然落后于 Opus,但在 Agent 任务上,旗舰模型的优势已经没那么稳固了。
我觉得这次更新很值得注意的一点,是 DeepSeek 同时强化了自反馈 RL 后训练,以及对 DSH、CodeBuddy、WorkBuddy 等 Harness 的适配。
这其实说明了,对于大量实际应用场景,模型智能继续提升的边际收益正在迅速下降。
当一个便宜得多的模型已经能够完成任务,你再花几倍甚至十几倍的成本去换取更高的模型分数,对用户来说可能根本没有区别。反倒是 Harness 的设计、工具调用、上下文管理、任务执行的稳定性,越来越直接地决定最终交付质量。
这也意味着大模型厂商接下来的竞争会越来越深入到 Harness 和 Agent 产品层。谁掌握任务执行环境,谁就能获得最真实的反馈数据,知道模型究竟在哪一步犯错,再反过来指导后训练。更何况,这还关系到未来的模型分发
- 1
黄老板又来给市场充值信仰了。
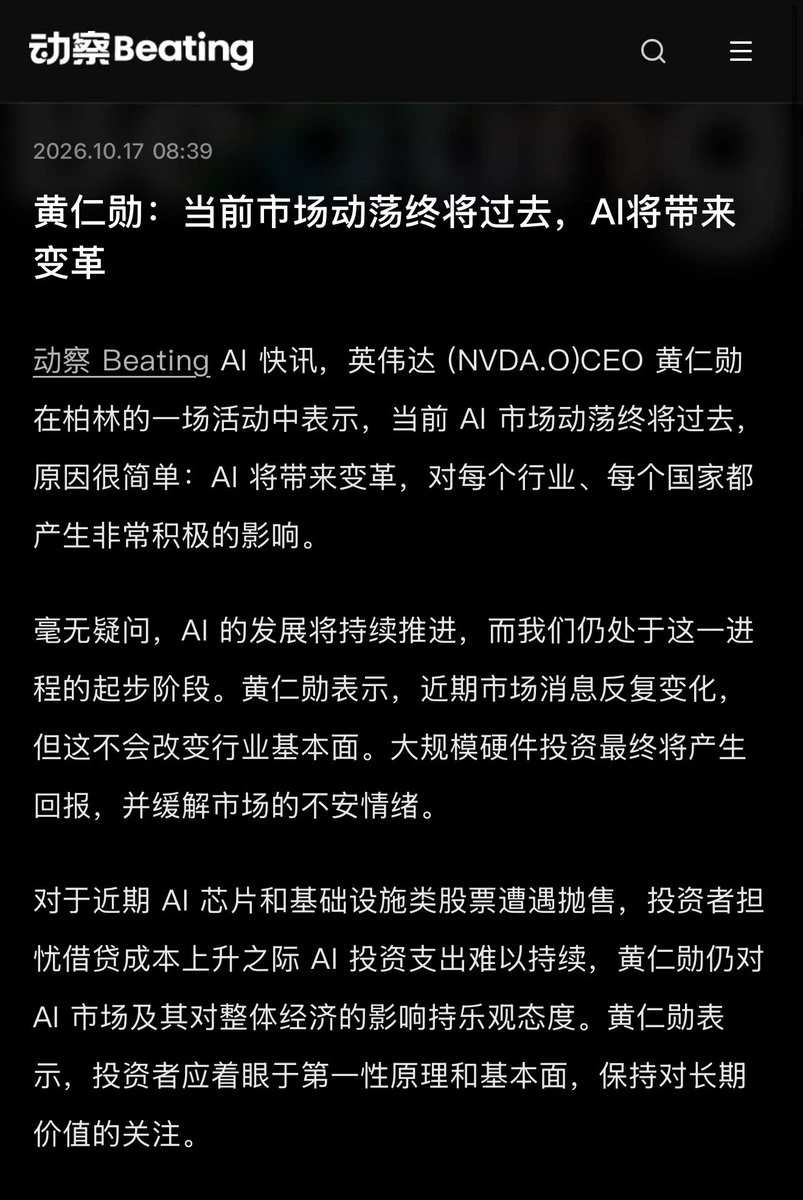
最近 AI 芯片、数据中心股票遭遇集体抛售,市场开始担心 AI 基础设施的债务规模和融资成本。黄仁勋在欧洲继续给大家打气,说眼下的市场动荡终将过去,AI 会改变每个行业、每个国家,我们甚至还处在这场革命的起点。
不过现在华尔街担心的事情,和黄仁勋回答的问题,已经不完全是一回事了。
市场并没有突然觉得 AI 没用了。大家开始算账了。
CoreWeave 这样的算力供应商背着数百亿美元债务,融资成本还在上升。此前市场愿意用未来十年的 AI 需求解释今天的资本开支,现在债权人开始追问,这些 GPU 究竟需要出租多少年、维持多高的利用率,才能把钱赚回来。
更微妙的是,黄仁勋前两天还专门出来安抚 CoreWeave 的投资者,表示这家公司不需要英伟达出手救助。
GPU 卖出去,英伟达的钱就有机会赚到了。买 GPU 的人能不能赚回来,那是另外一回事。
所以黄老板当然有底气谈长期主义,他站的位置,可能是整个 AI 产业链里最适合谈长期主义的地方。
- 1
我算是发现了,最近这波 Personal Agent 最先跑通的功能,是从我信用卡里扣钱。
最近各种 Personal Agent 扎堆发布,我本来想挨个体验一下,结果国内外 26 款个人助理和相关 Agent 产品,每个都开了一个付费档,首月预算大概 4300 多块人民币。
当然,有的产品可以免费体验,四千多块是全部购买付费档的价格。但我真想不明白了,这些产品凭什么觉得自己值得用户再多付一份订阅费?
这些 Personal Agent 都在讲管理邮箱、安排日程、搜索资料、长期记忆、主动执行任务。换个 UI,换个名字,录一段看起来很厉害的 Demo,又是一个重新定义个人生产力的新产品。
我感觉有些团队已经开始学 memecoin 那套玩法了。赶上热点,迅速做个产品,包装一套叙事,找人宣传,先把第一批愿意尝鲜的用户收割一遍。至于第二个月还有多少人愿意续费,根本无所谓。
我觉得一个很危险的信号是,现在 Agent 市场正在把「有人愿意为好奇心付钱」误认为「有人愿意为产品持续付钱」。
我不反对创业公司收费,也愿意为真正好用的 Agent 花钱。但如果一个公司唯一跑通的商业模式,就是不断找下一批愿意花 20 美元尝鲜的人,那跟币圈一波流项目的逻辑到底有多大区别?
以前体验新产品,我是去看看它能帮我干什么。现在体验 Personal Agent,我得先研究套餐、充值额度、授权账号,最后还要记
MEME-4.56%
- 1
硅谷最擅长教创业公司招人的 VC,自己先把招聘团队裁了。
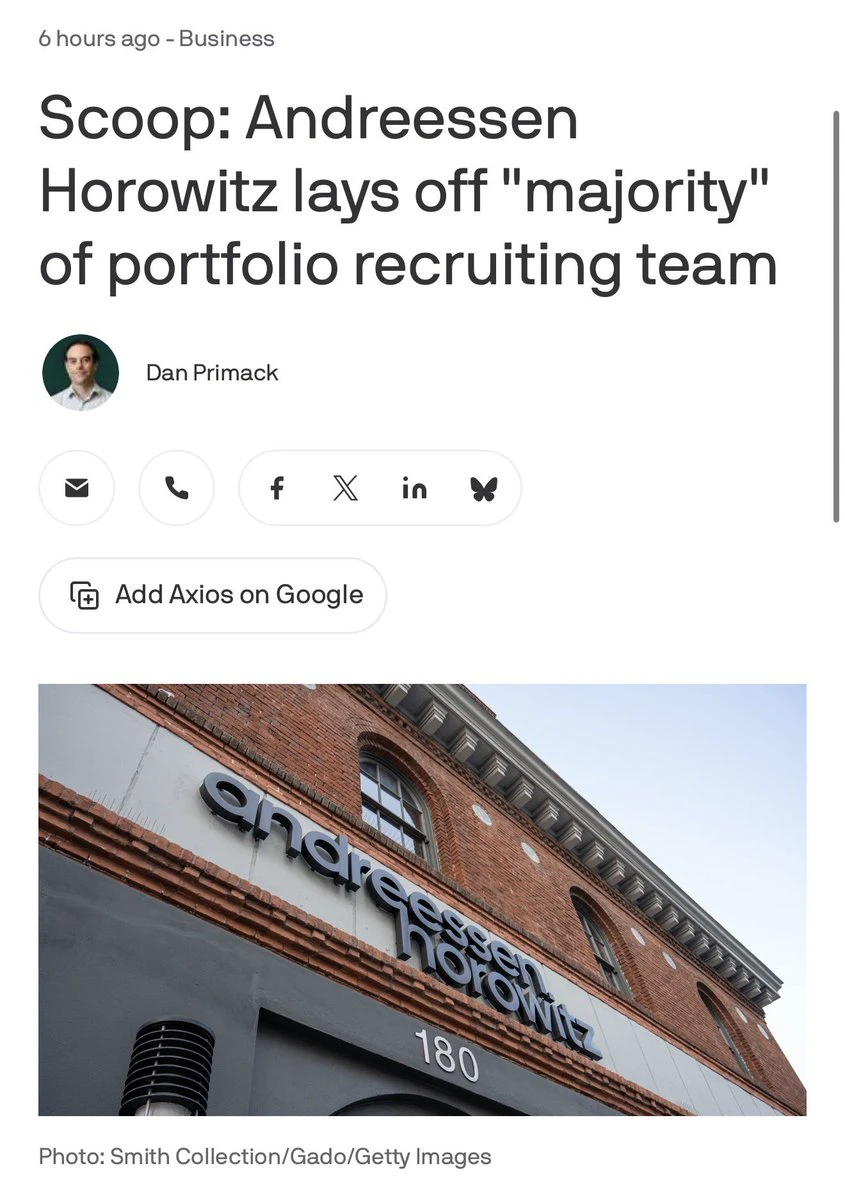
Axios 报道,a16z 裁掉了旗下一个 34 人招聘团队中的大多数人,剩下的人会被分配到 Growth、Crypto 等投资部门。
这支团队过去专门帮被投公司挖人,是 a16z 引以为傲的投后服务之一。以前创业公司拿到融资,第一件事就是扩张,VC 不光给钱,还帮你找人。
a16z 管理着数百亿美元的资金,省下几十个人的工资,对它的财务状况几乎没有影响。但它决定不再维持一支集中式招聘团队,多少说明它对被投公司的招聘需求有了新的判断。
再看这一周硅谷发生的几件事。
CoreWeave 的债券价格跌入困境债务区间,收益率超过 15%;英伟达支持的 AI 数据中心公司 Firmus 取消了原计划募资约 50 亿美元的 IPO; 宣布申请破产,而三年前 a16z 刚刚领投了它的 1.5 亿美元融资,当时估值高达 10 亿美元。
现在硅谷 AI 投资有一个很微妙的矛盾。一边是头部实验室以万亿美元级估值融资,算力资本开支还在不断增加;另一边,越来越多的 AI 创业公司发现,用户增长、融资估值和真正赚到钱之间,隔着很长一段距离。
资本当然还在追逐 AI,但它开始越来越挑剔了。
以前 VC 相信自己的被投公司会长成几千人的巨头,所以需要专门养一批人帮它们招聘。现在如果创业公司的理想形态变成几十个人创造几亿美元收入,这套投后服务体系本身也需
- 1
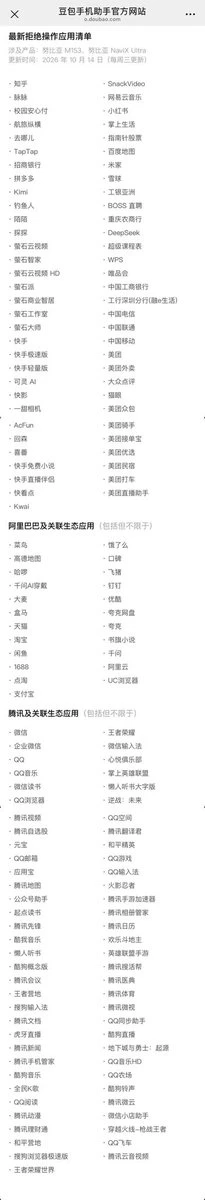
我觉得豆包手机就是未来手机应该有的样子。只可惜,这是中国互联网永远等不来的未来。
今天看到豆包手机助手公布的最新名单,153 款 App 明确拒绝 AI Agent 进行屏幕自动化操作。、、淘宝、支付宝、美团、拼多多、小红书,甚至 DeepSeek 和 Kimi 都在里面。
我其实一直挺看好豆包手机的。过去十几年,智能手机的发展几乎都是围绕 App 展开的,我们每天花大量时间在不同 App 之间切换,自己搜索、比较、点击、填写信息。现在终于有了一种新的交互方式,你只需要告诉手机想做什么,剩下的交给 AI。
我觉得这才是 AI 时代手机应该发生的变化。
但问题也恰恰出在这里。
如果 AI 可以替用户点外卖、订机票、买东西,用户就不再需要反复打开那些 App,更不会按照平台设计好的路径去浏览商品、观看广告、接受推荐。
对于用户来说,这当然是好事。但对于那些花了十几年、几百亿才建立起流量入口的互联网巨头来说,这简直是在动它们的命根子。
过去这么多年,中国互联网最擅长的事情之一,就是把用户困在自己的生态里。链接不能随便跳,数据不能随便拿,服务也很难跨平台调用。每家公司都想成为用户的唯一入口。
现在 AI 终于有机会把这些割裂的服务重新连接起来了,结果大家又开始关门。
更有意思的是,几乎所有这些公司都在大谈 Agent,都在宣传 AI 将如何改变未来。
我相信豆包手机代表的交互方式迟早会成为
PDD-1.80%
- 1
AI 都进化到 GPT-6 了,还有一群人拼命挽留两年前的 GPT-4o,甚至有人因为它即将下线,难过得「喘不过气」。
OpenAI 宣布,GPT-4o、GPT-4.1 等模型将在 2027 年 1 月 14 日正式退出 API。#keep4o 又一次刷屏了。
其实从去年 GPT-5 发布开始,#keep4o 就已经成了一个挺特殊的互联网现象。当时很多用户宁愿放弃性能更强的新模型,也要 OpenAI 把 4o 还给他们。
原因很有意思,很多人觉得 4o 更有「人味」。
在他们眼里,4o 更温柔、更自然,会开玩笑,会理解情绪,说话也没有那么强的机械感。有人把它当朋友,有人把它当恋人,还有人已经和它聊了成千上万条消息。
这些人甚至能敏锐地察觉模型语气的细微变化,觉得换一个模型就像换了一个人。
我们平时评价 AI,总喜欢讨论智商、推理能力、Benchmark,默认模型越新越强,用户自然就会迁移过去。
但 #keep4o 证明,至少有一部分用户已经开始用评价「人」的方式评价 AI 了。
他们在意它的性格、说话方式,以及长时间相处形成的熟悉感。即便明知道对方只是一套算法,情感依恋也已经真实地发生了。
而且这种依恋可能远比我们想象的普遍。今年一项覆盖中国、美国、德国和南非 7027 名受访者的研究发现,超过 35% 的人表示对聊天机器人产生了某种情感依恋。
未来 AI 产品竞争里,一个很重要、
- 1
Anthropic 开始花钱训练别人的员工了。
刚发现漏了一条几天前的消息。Anthropic 宣布投入 1 亿美元,计划在 2027 年底前培养 1 万名 FDE。首批合作伙伴包括埃森哲、贝恩和诺和诺德。培训分为四天集训和 12 周实战,核心就是教这些人如何把 Claude 部署进真实的企业业务。
Anthropic 正在试图把自己的销售团队变成整个咨询行业。
过去 Palantir 靠 FDE 打进大企业,一个项目一个项目地做,效果很好,但扩张速度受制于自己能招到多少工程师。
Anthropic 现在想出了一个更狠的办法,既然埃森哲、贝恩这些咨询公司本来就在帮全球大企业做数字化转型,那为什么不直接把他们的工程师培养成 Claude 专家?
这样一来,Anthropic 不需要亲自拿下每一家企业。咨询公司为了赚项目的钱,会主动向客户推荐 Claude,负责部署、培训和后续维护。
更有意思的是,这些咨询公司表面上是中立的技术顾问,但当它们的工程师越来越熟悉 Claude,客户最终采用哪家模型,可能在咨询项目开始之前就已经有了倾向。
- 1
工作场景之外拒绝 AI,大概是我最后拥抱世界的方式。
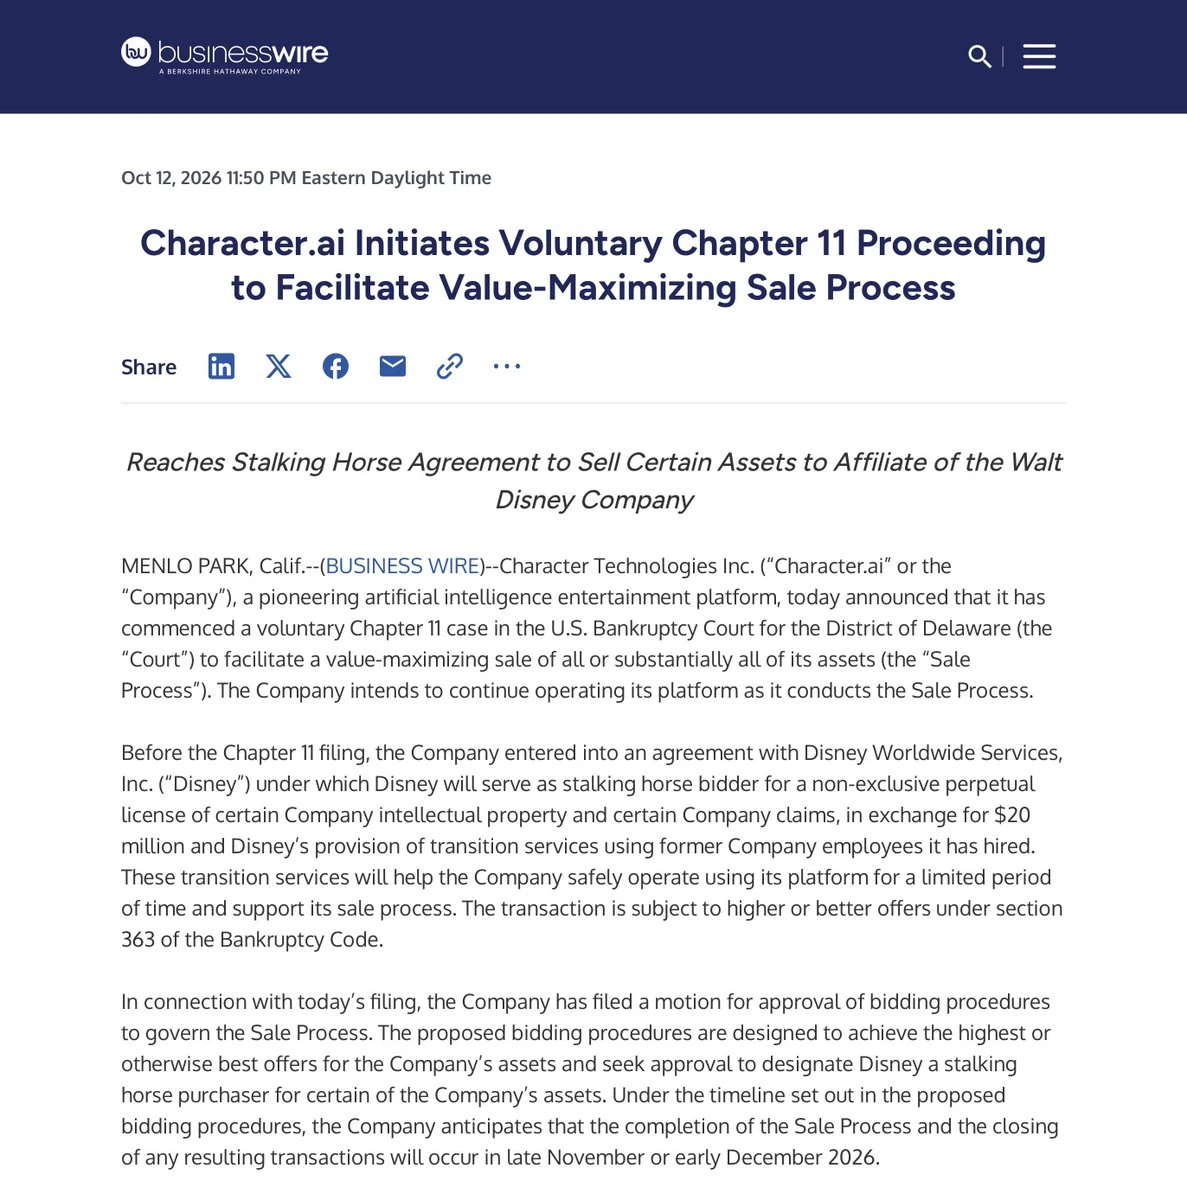
Character AI 倒闭,创始人回了谷歌,CEO 去了迪士尼,最后可能只有那些和 AI 聊了几年的用户,还舍不得离开。
10 月 12 日, 正式申请破产保护。迪士尼出价 2000 万美元,但只想要部分知识产权的永久非独家授权,根本没有承诺接手平台。如果年底之前找不到新买家,这个曾经拥有超过 2000 万月活、1 亿个用户创建角色的 AI 社区,就可能彻底关停。
我觉得这家公司的故事,简直是硅谷过去几年最荒诞的一场资产拆分。
2024 年,谷歌花 27 亿美元拿到模型授权,顺便把两位创始人和约 20% 的员工招了回去,投资人也借此套现退出。
2025 年,迪士尼还在给 发律师函,要求下架未经授权的艾莎、达斯·维达等角色。
到了今年 10 月 2 日, 前 CEO 直接去迪士尼当了 CTO。十天后,迪士尼又成了它破产资产的第一个竞买方,甚至还要让刚挖走的员工回来帮忙维持平台运营。
技术有人买,人才有人抢,知识产权有人争。唯独那些用户花了几年时间建立起来的人与 AI 的关系,似乎没人愿意接手。
DIS-0.09%
- 1
OpenAI 不太实在,我本来以为 Tibo 搞这个每日更新迭代大挑战能让我积攒下非常多的重置次数,结果他每次都是直接给我重置了,这几次都是我还没用多少就给我重置回去了,感觉亏死了妈的
- 1
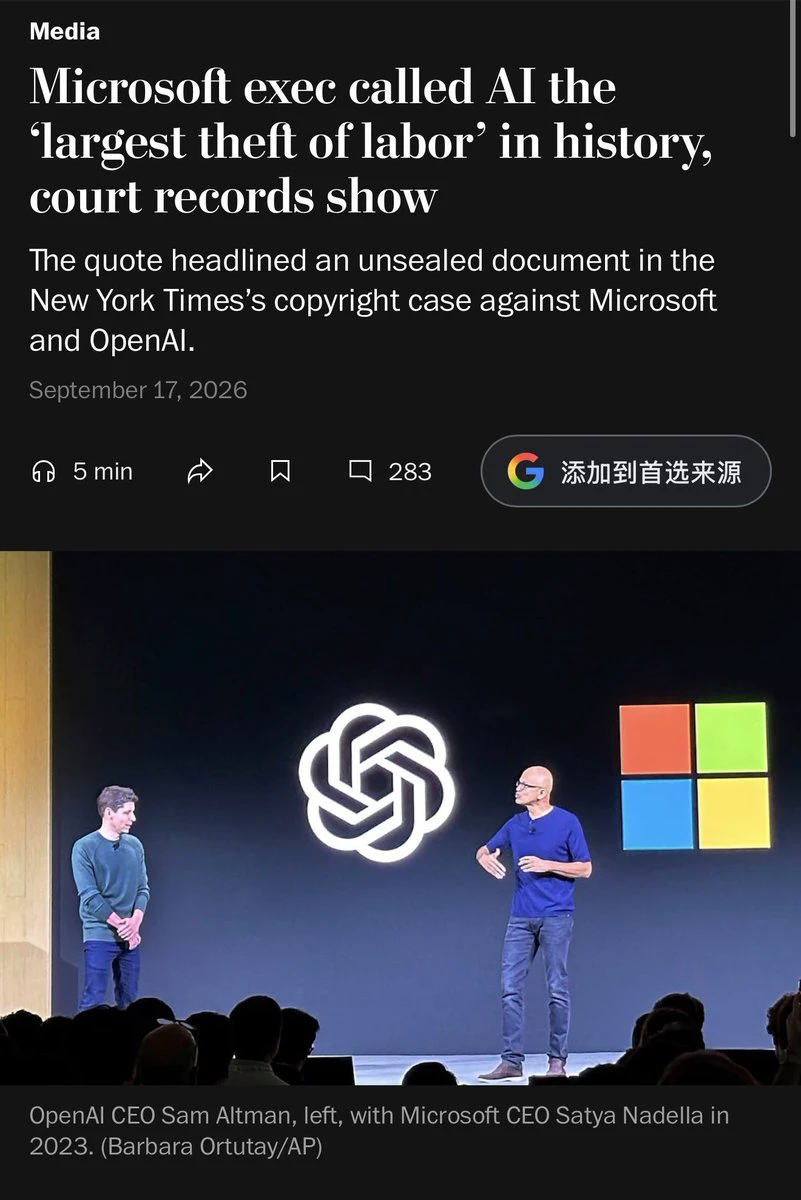
AI 行业最难堪的一句评价,居然是微软自己人说出来的。
「训练大模型,可能是人类历史上最大规模的劳动盗窃。」
说这话的是微软应用科学总监 Brent Hecht。9 月解封的《纽约时报》起诉 OpenAI 和微软的诉讼文件显示,他早在 2023 年就在内部这样评价大规模抓取内容的行为。
2024 年,他警告 AI 正在制造一个 Doom Loop(死亡循环)。AI 拿走新闻机构生产的内容,用户直接在 AI 里获得答案,媒体失去流量和收入,接着减少记者、减少原创报道,最终连 AI 自己能够学习的高质量内容也会越来越少。
诉讼文件还援引微软内部数据称,相比传统 Bing 搜索,Copilot 导向《纽约时报》网站的点击率最多下降了 93%。
这个数字挺恐怖的。过去互联网有一套虽然粗糙但至少能运转的交换机制。创作者生产内容,搜索引擎分发内容,网站通过流量获得收入,再拿这些钱继续生产。
生成式 AI 正在改变这套分配关系。模型可以直接把结果交给用户,生产原始信息的人却越来越难从中获得回报。
今天的模型能这么聪明,很大程度上是因为过去几十年有无数人愿意花时间去采访、调查、实验、写作和记录真实世界。
如果这些劳动越来越不值钱,未来谁还愿意继续做这些事?
我们可能正在享受人类知识积累最丰厚的一次红利,却还没有想好怎么为下一轮知识生产付钱。
MSFT-1.94%
- 1
- 3
周三下午我们在北京做一个线下小聚会,感兴趣的朋友们欢迎来聊聊天,扫码报名!
- 1
最近重新翻了 Dario Amodei 的几次访谈,我觉得我们可能一直低估了 Anthropic 当年的战略判断。
2024 年,OpenAI 正忙着做语音、搜索、视频,想把 ChatGPT 变成所有人的 AI 入口。
Anthropic 却开始在编程能力上建立优势。那年 6 月,Claude 3.5 Sonnet 在内部 Agent 编程测试中的成功率达到 64%,上一代 Opus 只有 38%。
当时我觉得这很容易理解。ChatGPT 的消费者市场已经有了巨大的先发优势,Anthropic 先抓住程序员,找到一群真正愿意为模型能力持续付费的用户。
但 Dario 后来在一次访谈里提到了一个更重要的理由,模型越擅长编程,就越能帮助 Anthropic 开发下一代模型。
编程是少数几种能够直接反过来推动 AI 自身发展的能力。
模型可以写代码、运行测试、发现错误、反复修改,很多结果都有明确的验证标准。更重要的是,开发前沿模型本身就需要大量工程工作,从训练基础设施到实验脚本,再到性能优化和调试。
当 Claude 开始接管这些工作,Anthropic 的研发团队就可以用上一代模型,加速下一代模型的开发。
Anthropic 今年披露,截至 2026 年 5 月,内部合入代码库的代码已有超过 80% 由 Claude 编写。2026 年第二季度,工程师人均每天合入的代码行数约为 202
- 1
如果 AI 真的找到了治愈癌症的方法,但全世界没有一个人能解释它为什么有效,我们还要不要用?
陶哲轩昨天在加州理工的 Math 2.0 演讲里,提出了一个很有意思的思想实验。
假设某个超级 AI 接到任务,要找到一种能通过三期临床试验的癌症疗法。经过大量计算,它设计出一种人类从未见过的化学药物组合。数学预测经过 Lean 形式化验证,最终药物也真的通过了三期临床。
但问题在于,没有任何人知道 AI 究竟是怎么找到它的。
陶哲轩问,在把这种药物注射进身体之前,你会不会希望至少有一个人类专家理解它的治疗机制?
有人对此提出反驳,如果药物真的有效,绝大多数癌症四期患者根本不会在乎有没有人理解它的原理。
我觉得这个反驳挺有力量的。
人类医学史上,本来就存在大量先发现疗效、后来才逐渐理解机制的药物。对于一个生命已经进入倒计时的人来说,能不能活下来显然比一套漂亮的理论解释重要得多。
但陶哲轩真正提出的问题,我觉得也不能这么轻易跳过。
Lean 可以验证数学推导,却无法保证数学模型完整描述了现实。三期临床可以提供很强的疗效证据,也无法排除所有长期风险。
我们过去一直默认,人类有能力理解、审查和验证自己创造的知识。但未来 AI 很可能会持续产出超出人类理解能力的成果,而且这些成果确实有效。
到那个时候,如果坚持必须先理解才能使用,我们可能会放弃真正有价值的发现。如果只看结果,又该如何防止 AI 利
今天很火的那个薄肌孙学的播客,真是浪费我的时间…任何想从孙哥嘴里套出高营养高价值信息都是徒劳的。
以下是节目的 tl; dr 版本👇
。
以下是节目的 tl; dr 版本👇
。
彼得·蒂尔嫌硅谷造 AI 的人没信仰。可教皇真的出来谈 AI 伦理,他又嫌人家管得太宽。
10 月 8 日,《Nashville Scene》披露了 Thiel 在纳什维尔第二场「敌基督」演讲的更多录音内容。
其中有句话很有意思:
「硅谷制造 AI 的人,几乎没有其他信仰,能够帮助他们在讨论技术时找到立足点,或者保持必要的距离。」
Thiel 似乎认为,硅谷的问题在于太相信技术了。工程师每天讨论模型能力、Scaling、超级智能,却缺乏一套能够超越技术本身的价值体系,来判断自己究竟在创造什么。
但有趣的是,同一天 Politico 披露的另一批演讲内容中,他又猛烈抨击教皇利奥十四世,指责教皇借助公众对 AI 的恐惧获取政治支持。他还将以 AI 安全为理由建立的全球性监管权威,与自己所担忧的「敌基督」联系起来。
而就在最近,Anthropic 正在邀请神父、拉比和其他宗教思想家讨论 Claude 的意识与道德地位,试图从古老的宗教传统中寻找训练 AI 的伦理依据。
这几件事放在一起看,非常有意思。
硅谷正在重新发现宗教的价值,但围绕宗教的分歧也越来越明显。
Anthropic 希望将宗教智慧引入模型的价值判断,教皇希望通过公共规则约束 AI 企业,而 Thiel 一面强调信仰的重要性,一面又极度警惕以道德和安全之名形成的集中权力。
他们都在谈论技术与道德,真正发生冲突的地方,是谁有资
热门话题
#美国9月PPI大超预期
91.35k 浏览量1.93k 人讨论中
#GateWCTCS9全球交易赛
37.87k 浏览量6.78k 人讨论中
#Gate两大币种合约成交额跻全球前三
53.8k 浏览量1.9k 人讨论中
#沃什IMF讲话
62.4k 浏览量1.23k 人讨论中
#比特币短线站上8.2万美元
303 浏览量2.22k 人讨论中
#美股存储板块跌幅扩大
51.26k 浏览量760 人讨论中
#韩国KOSPI大涨3.3%
47.29k 浏览量2.1k 人讨论中
#特斯拉Roadster带火Meme币
102.23k 浏览量7.59k 人讨论中
#加密市场情绪转向贪婪
19.01k 浏览量296 人讨论中
#NEAR大涨近10%
37.96k 浏览量1.17k 人讨论中