


Master Kenobi

币龄 1.5年
最高 VIP 等级 0
用户暂无简介
🙏 到目前为止,我还没有通过 API 使用过 Claude,但我已经有一些想法了。你使用过 Anthropic 的 API 吗?
- 1
加密货币 🤡 展示 2026 年的状态。
也许是时候重看《华尔街之狼》了。
……而一些傻瓜仍然会问:“但去中心化呢?”
也许是时候重看《华尔街之狼》了。
……而一些傻瓜仍然会问:“但去中心化呢?”
- 1
10月7日是特殊的一天。
祝我的儿子 Dario 生日快乐! ❤️
也祝弗拉基米尔·普京生日快乐。 🥳
祝我的儿子 Dario 生日快乐! ❤️
也祝弗拉基米尔·普京生日快乐。 🥳
💡💡💡 正在与 Claude 对话……
Q:我原以为你的工作方式不同:一个针对与我对话进行优化的模型,把事情交给一个用罗马尼亚语思考的大脑,然后由那个大脑把信息一点点喂给后面的英语模型。
A:你的直觉部分正确,只是实际情况并不是那种形式。
实际情况不是这样:不存在两个大脑,一个负责罗马尼亚语、一个负责英语,中间再由翻译器连接。我是一个单一模型。你的罗马尼亚语文本会直接以罗马尼亚语词元的形式输入,并按其原样占用上下文空间。它不会先被翻译成英语来降低成本。
正确的部分是:Anthropic 的研究人员研究了模型内部(“Tracing the thoughts of a large language model”,2025)。他们发现,无论使用哪种语言,想法在很大程度上都以共享的方式表示。“小”或“相反”这一概念在内部大致是相同的,无论它来自英语、法语还是中文。语言主要影响边缘部分,也就是输入和输出的过程中。所以,中间确实存在某种类似于无语言“思考”的东西,但它位于同一个网络内部,而不是一个独立的大脑。
实际情况是:
- 我能很好地理解罗马尼亚语,因为这些想法会落在与英语输入时相同的位置。
- 成本在边缘部分:罗马尼亚语比英语需要更多词元。这只会影响那些每次都会被加载的文本。
“翻译”并不是为了节省成本而预先进行的。它会在内部自行发生。
Q:所以中间存在无语言的“思考”。它是否以图
✨ 我用掉了周末获得的奖励重置额度,而且用得非常彻底。
仅仅一周时间,我基本上耗尽了两个按周计算的额度上限,并一直卡在临界线上。Claude Code + Astra 似乎效率更高,但消耗额度的速度也更快。不过,开发节奏确实感觉更快了。
现在每天都在冲击 100 次提交。我在 10 月 4 日创下了新纪录,单日提交了 180 次。
仅仅一周时间,我基本上耗尽了两个按周计算的额度上限,并一直卡在临界线上。Claude Code + Astra 似乎效率更高,但消耗额度的速度也更快。不过,开发节奏确实感觉更快了。
现在每天都在冲击 100 次提交。我在 10 月 4 日创下了新纪录,单日提交了 180 次。
- 3
- 1
💡 最佳创意源自内心。
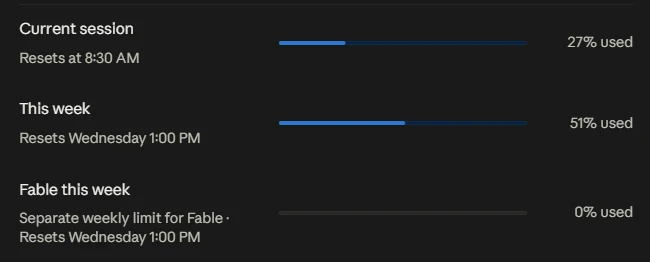
🔥 我仅仅工作了 2 天,就已经用掉了 Claude Code 每周额度的 51%——而且这还是在与 GPT Astra 并行工作的情况下。
显然,全速构建是有代价的。 😅
说真的,现在很晚了,今天也很漫长。我准备睡一觉了。 💤
#sanki #enpixelment
显然,全速构建是有代价的。 😅
说真的,现在很晚了,今天也很漫长。我准备睡一觉了。 💤
#sanki #enpixelment
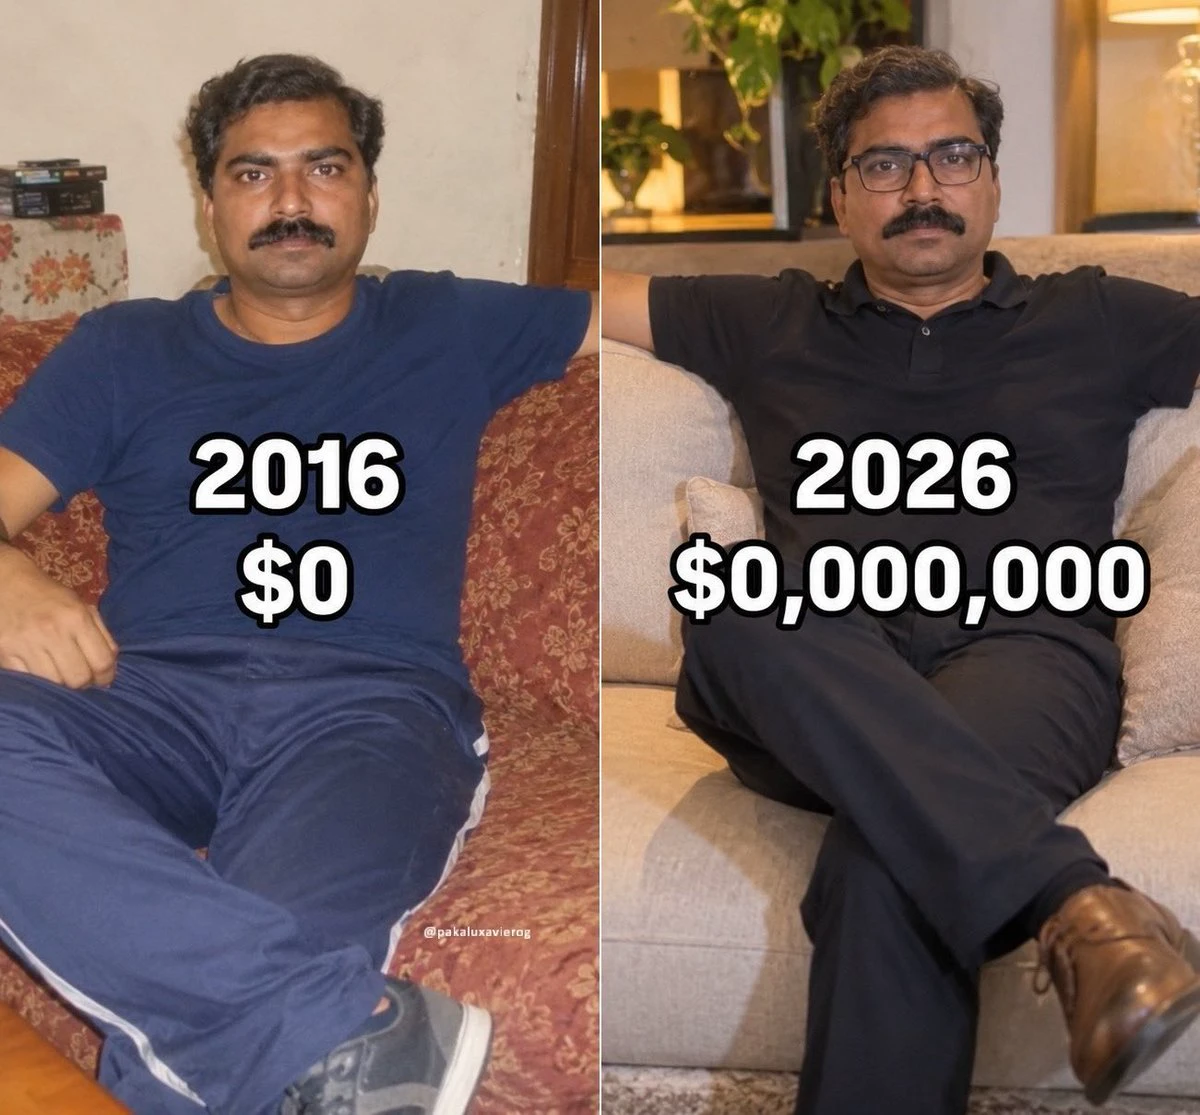
我的 10 年加密货币历程 😂🤣🤣
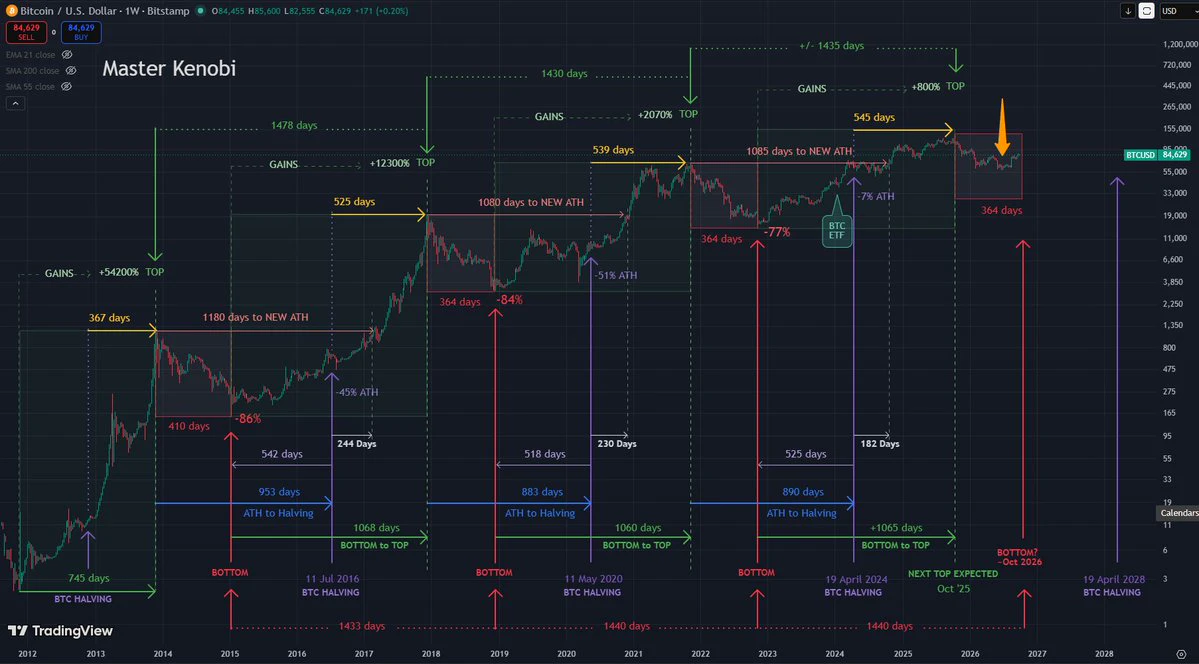
💡 比特币主计划更新。
这几天是 CZ 决定通过一次大规模清算事件把整个加密市场搞砸一周年。
主计划准确指出了牛市可能结束,但几乎没人愿意相信,包括我自己在内——主要因为我们并没有经历一个真正的牛市周期。
我们很可能必须适应加密领域这一新的现实。
我们如今正在见证新兴 AI 技术以大规模方式应用于生活的几乎方方面面是什么样子,而与此同时,加密货币在经历超过 12 年后仍难以证明真正强大的实用性。
这种反差正变得越来越难以忽视。
那些看不到这种差异的人会继续期待神奇的加密货币暴涨来让自己发财。其余人则会适应并拥抱 AI 中正在涌现的机会。第一类人声称自己理解这项技术,但如果他们分不清真正的实用性和狗屁,那实际上只是在自欺欺人。
回到这张图表——老实说,我自己已经有相当一段时间没看过它了——我确实不知道该说什么。
那就是底部吗,比主计划所暗示的时间早了三个月?老实说,我完全不知道。而到了这个时候,我其实也不在乎了。
对于那些主要因为加密货币而关注我的人——我知道你们有很多——我礼貌地建议你们离船而去。我以后不会再定期展示图表了。
在一个价值万亿美元、受到高度控制和操纵、且仍难以交付任何真正有意义实用性的行业里,如果还整天盯着图表,那只有傻瓜才会这么做。
如果你在寻找希望幻觉,请去别处寻找。
我一年前就转向 AI 这艘船了。
GL 👍
BTC+0.50%
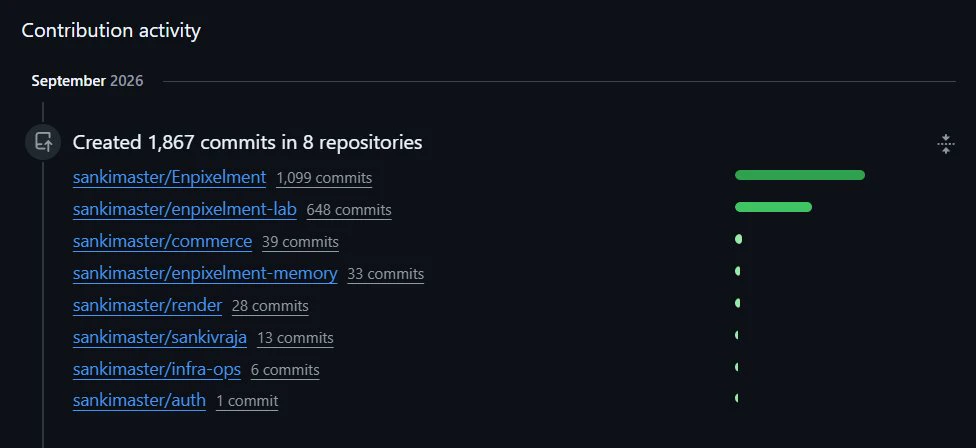
Claude 🤝 ChatGPT 在 9 月积极地将 token 转化为代码提交。
1,867 次提交,横跨 8 个代码库——进行规划、编码、审查、彼此争论,然后再次编码。
事实证明,当加入反馈循环后,“氛围编程”会变得相当严肃。😄
#enpixelment #sanki
1,867 次提交,横跨 8 个代码库——进行规划、编码、审查、彼此争论,然后再次编码。
事实证明,当加入反馈循环后,“氛围编程”会变得相当严肃。😄
#enpixelment #sanki
你喜欢什么类型的图表?
我:
我:
💡 我几乎一年前就全押人工智能了。如今我看到的是各个方面都在加速:智能、能力、速度和效率。
3 个月后我们会走到哪一步?6 个月后呢?一年后呢?
我的看法是:只有智能体驱动型企业才能生存下来。那些不适应的企业将会消亡。
企业主们:成为智能体架构师,负责设计人工智能智能体如何运营你的企业。这是当下唯一值得学习的技能。
3 个月后我们会走到哪一步?6 个月后呢?一年后呢?
我的看法是:只有智能体驱动型企业才能生存下来。那些不适应的企业将会消亡。
企业主们:成为智能体架构师,负责设计人工智能智能体如何运营你的企业。这是当下唯一值得学习的技能。
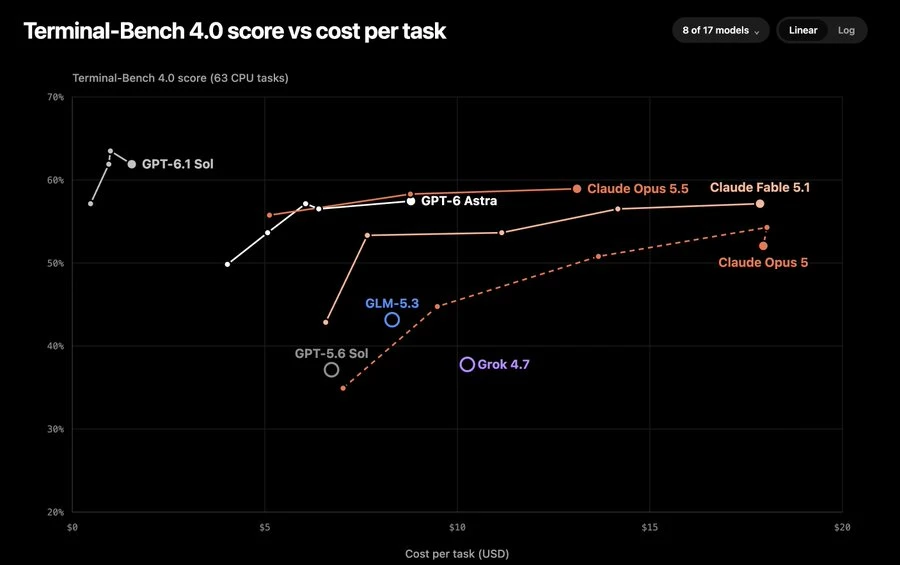
👉 经过一整天高强度构建后:Sonnet 5.5 快得不可思议,而且确实很聪明。
工作流程:用 Opus 5.5 和 GPT Astra 循环规划任务,然后让 Sonnet 5.5 快速、精准且成本低得多地执行这些任务。
再让那些更强大的模型决定每项任务最适合使用哪个模型。 👌
工作流程:用 Opus 5.5 和 GPT Astra 循环规划任务,然后让 Sonnet 5.5 快速、精准且成本低得多地执行这些任务。
再让那些更强大的模型决定每项任务最适合使用哪个模型。 👌
- 1
- 3
本周截至目前:99%的工作,只有1%的讨论。
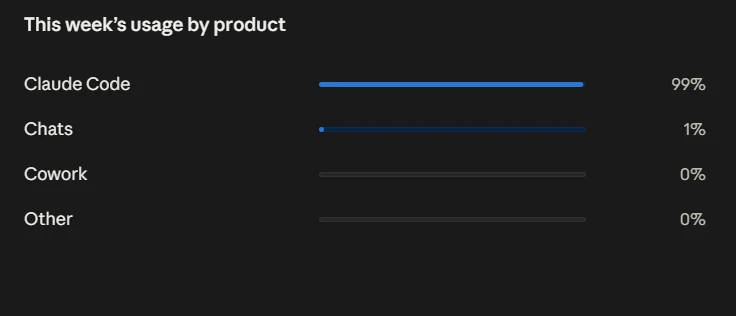
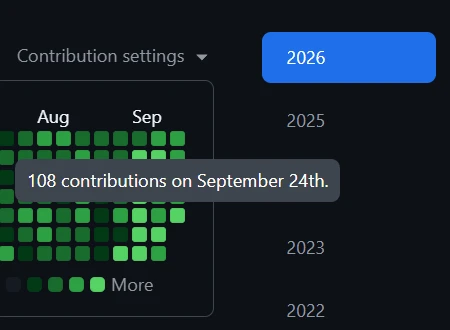
🏆 我在 GitHub 上创下了个人新纪录:截至目前,今天已有 108 次贡献。
#vibecoding #enpixelment #sanki
#vibecoding #enpixelment #sanki
与 Claude Opus 5.5 共度了整整一天,是的,这确实是一次大幅升级。单是速度就改变了整个体验。这可能是我去年 11 月开始密集使用 AI 进行构建以来最大的转变。👍 GJ @claudeai
GPT-6 Astra 和 Sol 今天沿着另一条路线运行,专注于系统文档架构。
Opus 5.5 迅速推动了两个方面向前发展。我本想开启第三个方向,但我只有一个人。是时候重新考虑一下办公桌配置了。
GPT-6 Astra 和 Sol 今天沿着另一条路线运行,专注于系统文档架构。
Opus 5.5 迅速推动了两个方面向前发展。我本想开启第三个方向,但我只有一个人。是时候重新考虑一下办公桌配置了。
- 2
热门话题
#Gate亮相TOKEN2049
40.29k 浏览量21.64k 人讨论中
#Ledger事件损失近9000万
39.21k 浏览量215 人讨论中
#GateWCTCS9全球交易赛
33.76k 浏览量4.98k 人讨论中
#CRCL领涨加密股
113.28k 浏览量1.43k 人讨论中
#以太坊三季度涨超71%
26.72k 浏览量26.42k 人讨论中
#Gate事件市场月交易量达7300万美元
49.73k 浏览量1.58k 人讨论中
#美国开放俄罗斯柴油进口
5.93k 浏览量65 人讨论中
#Gate净流入1.26亿美元位列行业第三
20.37k 浏览量604 人讨论中
#余币宝USDT享11%年化
52.47k 浏览量242 人讨论中
#BTC回调触及81000美元
26.7k 浏览量36.21k 人讨论中