对需要按任务选型的读者,关键不是「哪边更强」,而是失败时更怕语言胡说还是动力学漂移。后文把 世界模型 与大语言模型(LLM)对照预测目标、数据评测、适用任务、组合条件与误判。能力上限可旁观 超级智能(ASI);部署边界可对照 Private AI。
核心要点
- 世界模型优化动作条件的下一状态 / 潜动态;大语言模型优化下一词元与文本结构。
- 具身规划与控制优先世界模型;写作、检索增强问答与工具调用优先大语言模型。
- 需要「语言接口 + 可滚动环境动态」时应组合,而非互相替换。
- 失败模式不同:LLM 常见语言幻觉;世界模型常见动力学漂移与虚假物理。
世界模型是什么?
世界模型是一类学习动态系统:给定当前状态(或观测)与候选动作,预测环境如何变化,使智能体可在内部「想象」中试动作后再规划。判定轴通常是动作条件预测,而非聊天是否流畅。
与只生成文本或外观不同,世界模型取向系统把预测接到规划、控制或想象训练闭环。常见路线包括模型基强化学习(如 Dreamer)、生成式可交互模拟与 JEPA 类表征预测;目标不同,不能用品牌名互相替代。
大语言模型是什么?
大语言模型(Large Language Model,LLM)是在大规模文本上训练、以下一词元(next-token)预测为核心目标的生成模型。LLM 擅长语言理解、摘要、翻译、代码辅助,以及经提示与工具接口完成多步文本编排。
LLM 可以描述物理或写出「推杯子会怎样」的步骤,但描述不等于可滚动、可评估的环境动态。缺少动作—状态接口与闭环评测时,把 LLM 当控制器或物理引擎属于选型错位,而非「模型不够大」。
预测目标有何不同?
核心差异在预测对象:世界模型预测动作后的下一状态或潜动态;大语言模型预测下一词元与文本结构。「会预测」不共享同一成功标准。
| 维度 | 世界模型 | 大语言模型 |
|---|---|---|
| 预测目标 | 下一状态 / 潜动态(常条件于动作) | 下一词元 / 文本与指令跟随 |
| 与动作的关系 | 动作条件预测是判定轴 | 通常不建模物理控制闭环 |
| 输出形态 | 状态、表征、轨迹或可交互观测 | 文本、代码、工具调用参数 |
| 成功标准 | 后果可检验、可规划、误差可追踪 | 语义正确、格式可用、引用可核 |
| 典型失败 | 动力学漂移、虚假物理 | 语言幻觉、编造引用 |
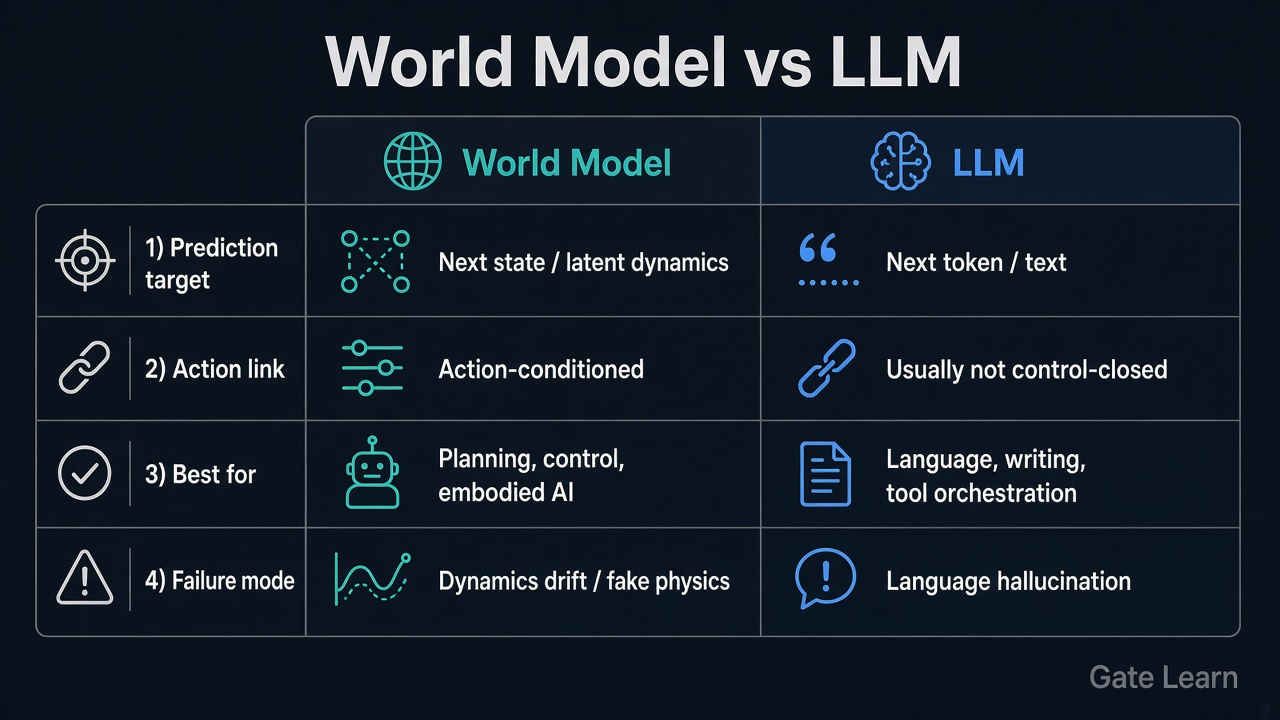
图 1. 世界模型 vs 大语言模型四维对照:预测目标、动作链接、适用任务与失败模式。
JEPA 与 LLM 常被混淆。JEPA(如 Meta AI 的 I-JEPA)在联合嵌入空间预测抽象未来表征,属世界模型取向;LLM 仍落在语言建模。名称相近不等于可互换。术语边界见 NVIDIA Glossary: World Models 与 LeCun 路径讨论(A Path Towards Autonomous Machine Intelligence)。
数据、输出与评测有何不同?
数据与评测跟着预测目标走:世界模型依赖交互轨迹、状态转移与控制信号;大语言模型依赖语料、指令数据与(可选)工具日志。下游如何消费输出,决定误差指标。
| 维度 | 世界模型 | 大语言模型 |
|---|---|---|
| 典型数据 | 观测—动作—下一观测 / 奖励轨迹(有时含视频) | 文本、对话、代码、工具轨迹 |
| 主要输出 | 下一状态、潜动态、想象轨迹 | 文本、结构化答案、函数调用 |
| 评测重点 | 多步误差、任务成功、分布外稳健 | 正确性、忠实度、格式与安全 |
| 难测之处 | 虚假物理好看难抓;长时程累积 | 幻觉通顺;引用看似成立却难核 |
用「写对一段物理说明」证明世界模型就绪,或用「短视频好看」证明 LLM 有控制闭环,都会换错评测轴。应先固定可检验输出,再选模型族。
哪些任务更适合世界模型?哪些更适合大语言模型?
选型先看失败成本落在物理/控制侧还是语义/沟通侧:前者优先世界模型,后者优先大语言模型。两者须同时成立时走「必须组合」,不要二选一硬刚。
| 任务条件 | 更适合世界模型 | 更适合大语言模型 | 何时必须组合 |
|---|---|---|---|
| 需要显式动作→下一状态预测 | 是 | 否 | — |
| 需要自然语言接口、文档/代码生成 | 否 | 是 | — |
| 具身规划、接触前筛失败轨迹(如自动驾驶短时程) | 是 | 否(可作辅助说明) | 指令用 LLM,滚动动态用世界模型 |
| 检索增强问答、写作、工具编排 | 否 | 是 | — |
| 要在想象中练策略(MBRL) | 是 | 否 | 任务描述可用 LLM;动力学仍须世界模型 |
| 既要对话下指令,又要可执行控制闭环 | 单独不够 | 单独不够 | 必须组合:LLM 解析目标 → 世界模型/规划器执行 |
「必须组合」对应常见形态:LLM 负责意图与接口,世界模型(或仿真器 + 学习动态)负责后果预测与轨迹筛选。砍掉任一侧,常会在另一侧失败模式上崩盘。
什么时候应该两者组合使用?
当任务同时含「语言层目标」与「环境层后果」时,应组合而非争论替换。典型链路:LLM 把目标写成子目标或约束;世界模型在候选动作上滚动;规划器按代价与安全选轨;执行后再用新观测更新状态。
组合不等于串联提示词。须明确接口:LLM 输出何种结构化目标、世界模型接受何种动作、多步误差如何触发重规划或保守回退。缺契约时,常表现为「话说得通、动作做不通」或「轨迹好看、指令对不上」。
不宜硬叠的情形也包括:纯文档问答几乎不需世界模型;低层伺服若已有可靠动力学,不必强塞通用 LLM。组合价值来自分工,非模型数量。
选型时有哪些常见误判与风险?
最常见误判是把「会说物理」当成「会做物理」,把「画面/轨迹好看」当成「动态可规划」。失败模式不同,混用验收会放大部署风险。
| 失败模式 | 更常见于 | 表现 | 选型风险 | 识别方法 |
|---|---|---|---|---|
| 语言幻觉 | LLM | 通顺但事实/引用错误 | 当唯一知识源或控制说明书 | 强制溯源、工具核验、拒无依据断言 |
| 动力学漂移 | 世界模型 | 短步尚可,多步后失真 | 长时程开环信任模型 | 看误差随步数;是否重规划 |
| 虚假物理 | 世界模型 | 轨迹流畅却违反接触/守恒 | 用视觉 demo 代替物理验收 | 检查穿透、能量、接触约束 |
| 把 LLM 当仿真器 | 选型错位 | 文本描述代替状态转移 | 具身任务无动作条件闭环 | 追问动作接口与可滚动状态 |
| 把世界模型当聊天引擎 | 选型错位 | 强行用状态预测做客服 | 语言任务成本高、体验差 | 任务是否以文本质量为主 |
风险识别应绑定触发条件:语义正确为主时优先治幻觉;控制后果为主时优先治漂移与虚假物理。能力叙事不能替代验收。
总结
世界模型与大语言模型解决不同预测问题:前者面向动作后果与可规划动态,后者面向语言与工具编排。选型先固定失败成本落在哪一侧,再用条件表决定单用或组合。
JEPA 等表征预测属世界模型取向,不等于 LLM。验收须分开检查语言幻觉与动力学漂移 / 虚假物理,避免一种演示掩盖另一种失败。
FAQ
世界模型和大语言模型有什么区别?
世界模型主要预测动作后的下一状态或潜动态,服务规划与控制;大语言模型主要预测下一词元,服务语言理解、生成与工具编排。二者都可「生成」,但成功标准分别是后果可检验与语义/格式可用。
世界模型能替代大语言模型吗?
一般不能。世界模型不天然提供强语言接口与大规模文本编排;大语言模型也不天然提供可滚动的动作条件动态。语言任务优先 LLM;需环境后果预测时再引入世界模型。
什么时候用世界模型?
当任务须根据状态与动作预测下一状态,并据此规划、控制或在想象中试错时,用世界模型取向系统。典型包括具身规划、模型基强化学习、短时程后果预感。纯写作或文档问答通常不是主场。
JEPA 和 LLM 什么关系?
JEPA(联合嵌入预测架构)在嵌入空间预测未来或掩码表征,属世界模型相关表征学习;LLM 以下一词元预测为核心。二者可同处智能体栈,但目标与评测不同,JEPA 不是「另一种 LLM」。
两者可以一起用吗?
可以,且在「自然语言下指令 + 环境中执行」任务中常须组合:LLM 解析目标与约束,世界模型或规划模块预测后果并筛选轨迹。关键是清晰接口与重规划触发,而非串进同一提示。
* 投资有风险,入市须谨慎。本文不作为 Gate 提供的投资理财建议或其他任何类型的建议。
* 在未提及 Gate 的情况下,复制、传播或抄袭本文将违反《版权法》,Gate 有权追究其法律责任。


相关文章
GateClaw 与 AI Skills:Web3 AI Agent 的能力体系解析
GateClaw 的核心功能:Web3 AI Agent 工作站能力解析
一文盘点 Top 10 AI Agents
什么是 TAO?Bittensor 代币经济学、供应模型与激励机制详解
解读 Vana 的野心:实现数据货币化,构建由用户主导的 AI 开发生态