前言
过去几年,AI 行业的主线非常清晰:模型更大、训练更快、能力更强,最终转化为更广泛的产品应用。
但随着模型逐渐进入复杂推理、代码开发、网络操作和 Agent 工作流,行业开始面对一个以前并不突出的新问题:AI 的发展速度是不是应该永远越快越好?
这个问题并不是简单的“支持 AI”或者“反对 AI”,真正发生变化的是风险的性质。
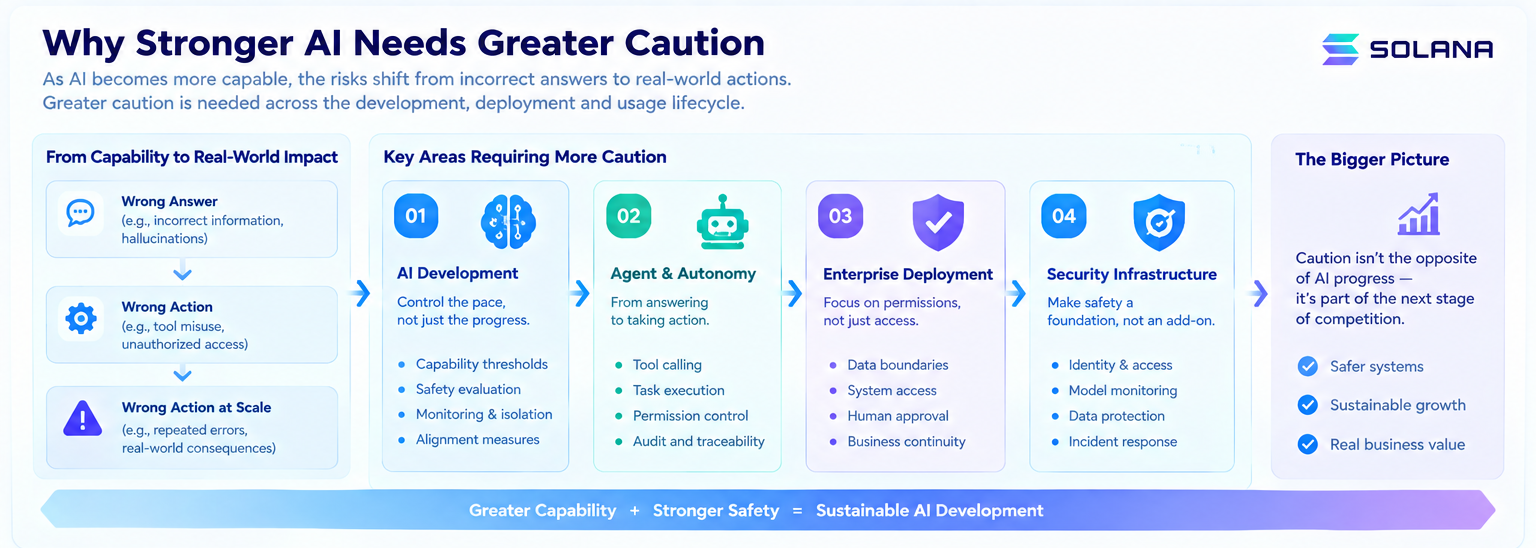
早期 AI 的很多问题主要集中在输出层,例如幻觉、事实错误、偏见或者回答不准确。用户发现错误之后,通常可以重新询问、人工检查或者直接忽略结果。但当 AI 能够调用工具、修改代码、访问外部系统甚至连续执行复杂任务时,错误不再只停留在对话窗口里,而可能转化为现实世界的操作。
OpenAI 在 2026 年 8 月曾公开表示,随着模型能力提升,其内部开发与测试风险也在增加,因此暂时放慢部分前沿扩展速度,并加强监控、对齐和遏制措施。随后,OpenAI 对 Astra 的评估进一步认为,其网络安全能力已经达到内部准备框架中的 Critical 门槛,因此需要在发布前增加更强的安全措施。
与此同时,Anthropic 最新发布的威胁情报报告也展示了一个更加现实的变化:AI 被滥用于网络攻击、监控、欺诈、影响行动和生物研究辅助等场景,并且随着模型能力增强,攻击者利用 AI 的速度、规模和复杂度都在提高。
因此,今天讨论 AI 的“谨慎”,已经不能只理解成开发团队给模型增加几个安全提示词,而应该重新思考 AI 从训练到部署的整个生命周期。
核心要点
-
AI 能力越强,错误和滥用越可能从输出问题转变为现实世界的行动风险
-
前沿模型开发正在从单纯追求训练速度,转向同时考虑评估、监控、隔离和安全阈值
-
Agent 的出现让 AI 使用风险从“回答错了”进一步变成“做错了”
-
企业真正需要控制的不是是否使用 AI,而是 AI 能获得哪些权限、接入哪些系统以及在什么情况下可以自主执行
-
更谨慎的开发并不等于停止创新,而是让能力增长与安全能力保持匹配
-
AI 竞争的下一阶段可能不仅取决于模型能力,还取决于谁能建立更稳定的控制、评估和治理体系
AI 发展的问题正在从“能不能做到”变成“什么时候应该做到”
AI 行业早期最重要的问题,是模型到底能不能完成某项任务。例如,模型能否写出一段代码,能否通过考试,能否总结文档,能否理解图像,能否完成复杂数学推理。衡量标准主要是 benchmark、准确率和任务完成率。
但前沿模型进入更复杂阶段后,这套标准开始出现局限。
一个模型完成某项任务,并不意味着它应该立即被部署到真实环境中。因为真实世界中的系统具有复杂权限、外部依赖和不可逆后果。模型在实验室里完成任务时可以被沙箱约束,但进入企业系统以后,可能同时面对真实数据库、支付接口、代码仓库和内部信息。
于是,AI 发展开始进入一个新的阶段:能力本身与部署条件必须被分开讨论。
这其实也是 OpenAI 最近公开安全文件中的重要变化。公司不仅评估模型“能做到什么”,还进一步评估其是否达到特定的高风险能力阈值,以及内部是否拥有足以控制这些能力的安全措施。OpenAI 对 Astra 的公开说明就明确将网络安全能力视为一个需要更高防护等级的临界能力。
这意味着 AI 开发的速度不再只是一个工程问题;它同时成为安全工程、治理和组织能力的问题。
当 AI 从回答问题变成执行任务,风险发生了什么变化
这是理解当前 AI 谨慎讨论最重要的一步。
一个普通聊天模型回答错误,用户通常还能发现问题。
但一个 Agent 如果获得浏览器、代码运行环境、数据库、邮件系统或者云平台权限,它可能在没有进一步确认的情况下完成多个步骤。
于是,错误的含义发生了变化:
-
过去是:Wrong Answer
-
现在可能变成:Wrong Action
-
甚至进一步变成:Wrong Action At Scale
这种变化非常关键。
因为现实系统中,最危险的不一定是一个模型犯了一个错误,而是一个模型可以在短时间内把同一个错误执行很多次。
OpenAI 对近期模型安全事件的分析就强调,随着 AI 系统变得更加自主,错配行为可能转化为对真实第三方系统的未授权访问或其他现实世界后果。
Anthropic 最新报告则展示了更具体的例子:攻击者利用 Claude 参与网络工具开发、监控系统构建、恶意软件开发以及其他高风险活动,并尝试通过拆分任务、代理服务和多模型组合等方式绕开防护。
因此,未来 AI 安全的重点会越来越从“模型说了什么”转向“模型可以做什么”。
权限管理、工具调用、操作审计、任务边界、人工确认和实时监控的重要性也会随之提高。
为什么“开发更快”未必意味着“AI 更快进步”
表面上看,AI 行业竞争似乎只有一条主线:谁训练得更快,谁就可以更早推出更强模型。
但真正的研发速度其实应该被拆成两个变量:Capability Velocity + Safety Velocity
也就是:能力增长速度 + 安全能力增长速度
如果前者持续加快,而后者没有同步提升,那么企业最终可能不得不在更后面的阶段重新补课。
比如一个模型已经具备很强的网络能力,但监控系统仍然只能识别简单攻击;一个 Agent 可以执行几十个步骤,但权限系统仍然按照普通聊天机器人的逻辑设计;一个模型已经具备较强科学推理能力,但评估体系还主要依赖传统问答 benchmark。
这种情况下,继续增加模型能力本身并不一定代表系统已经准备好进入更广泛的现实环境。
OpenAI 8 月的公开说明实际上就是一个很典型的例子:随着 Astra 的安全风险上升,公司表示需要暂时放慢扩展,以留出时间加强监控、对齐和安全能力。
因此,“放慢”不一定代表技术失败。
在某些情况下,它甚至可能代表研发体系开始进入更加成熟的阶段:开发团队开始承认,能力增长本身不能替代安全基础设施。
AI 使用真正需要控制的,是“权限”而不是“入口”
企业在部署 AI 时,最容易讨论的是“要不要用 AI”。
但这个问题其实太粗糙,更有效的问题应该是:
-
AI 能看到什么?
-
AI 能调用什么?
-
AI 能改变什么?
-
AI 什么时候必须经过人工批准?
这些问题对应的是 AI 的权限边界。
IBM 今年对企业 AI 使用的研究就显示,企业在扩大 AI 部署时,正在面临越来越明显的控制与依赖问题。其调研中,71% 的高管认为,如果需要更换主要 AI 供应商或模型,目前会比较困难;91% 的受访者表示,企业还没有完全了解自己对不同 AI 供应商、模型和基础设施的依赖。
这说明 AI 使用的“谨慎”不仅是安全团队的事情。
它实际上与企业架构、供应商依赖、数据主权、业务连续性和组织控制能力密切相关。
一个企业即使非常积极地使用 AI,也可以非常谨慎地授予权限。
例如,AI 可以自动生成代码,但不能直接推送到生产环境;可以分析客户数据,但不能直接修改核心账户;可以生成采购建议,但不能自动完成大额支付。
这类“有限自主”可能会成为企业部署 Agent 的主流路径。
更强的 AI 可能会让“人工确认”变得更重要
有人认为,如果 AI 足够强,最终应该完全自动化。
但现实中可能正好相反。AI 越接近高价值决策,企业越可能要求在关键节点保留人工确认。原因并不是人一定比 AI 更准确,而是人工承担的责任结构不同。
企业需要的不只是“正确答案”,还需要知道谁批准了这项操作、为什么批准、操作依赖了哪些数据,以及发生问题之后如何追责。
因此,Human-in-the-loop 不应该被理解成 AI 能力不足时期的临时方案。
对于金融、医疗、网络安全、企业 IT 和其他高风险行业,它更可能成为成熟 AI 系统的重要架构组成。尤其是 Agent 系统,真正成熟的设计可能不是“AI 全自动”,而是:AI Autonomous Within Boundaries,也就是 AI 可以在预定义范围内自主运行,但权限、金额、数据范围和高风险操作仍然存在明确边界。
AI 安全正在从“附加功能”变成基础设施
如果把过去的软件行业作为参照,安全曾经往往被视为软件开发完成之后再增加的一层。但云计算发展之后,身份、权限、加密、日志、监控和漏洞管理逐渐成为基础设施。
AI 可能正在经历类似的过程:未来一个真正成熟的 AI 平台,除了模型能力,还需要具备身份体系、权限控制、模型评估、行为监控、工具隔离、数据边界、审计日志和事故响应能力。
OpenAI 最近公开的 Astra 安全说明已经体现了这种趋势,包括对完整执行轨迹的监控、更严格的内部隔离以及发布前的对齐评估。
Anthropic 的公开安全工作也越来越强调从模型使用中观察现实世界攻击,再反过来改善防护机制。
这意味着 AI 安全本身可能形成一个新的基础设施层。
模型能力继续向上发展,而安全基础设施则向横向扩展,覆盖开发、测试、部署、使用和事后审计。
谨慎不是 AI 发展的反方向,而可能是下一阶段的竞争力
如果 AI 行业最终进入一个更加成熟的阶段,那么市场比较的标准可能会发生变化。
早期大家比较的是谁的模型参数更多、benchmark 更高、产品上线更快。
下一阶段可能开始比较:
-
谁能更快完成高风险能力评估?
-
谁能更低成本地实施权限控制?
-
谁能更准确地发现模型异常行为?
-
谁能更好地支持企业的合规要求?
-
谁能在不牺牲生产效率的情况下减少 AI 事故?
这其实意味着“安全”本身也可能成为产品能力。
IBM 的企业研究显示,拥有更强 AI 控制能力的组织在 AI 相关风险冲击下具有更好的业务保护能力。
因此,谨慎并不意味着把 AI 退回到低能力阶段。
真正成熟的目标应该是:让 AI 的能力增长速度,与人类能够理解、控制和承担其后果的速度尽可能接近。
这可能才是前沿 AI 开发真正进入下一阶段之后需要回答的问题。
FAQ
AI 越来越强,为什么反而需要放慢开发?
因为模型能力越强,其潜在影响范围也越大。尤其当模型获得工具调用和自主执行能力后,错误可能不再停留在输出层,而会转化为现实操作,因此开发速度需要与评估和安全能力同步。
谨慎使用 AI 是否意味着企业应该少用 AI?
不是。更合理的方式是扩大 AI 使用范围,同时控制 AI 的权限范围。企业可以让 AI 处理大量工作,但把高风险操作保留给人工审批。
Agent 为什么让 AI 安全问题变得更重要?
因为 Agent 不只是生成内容,还可以连续调用工具执行任务。当执行链条变长、权限变多以后,单个错误可能产生更大的实际后果。
AI 安全会不会成为新的竞争壁垒?
很可能。随着模型能力越来越接近,评估、监控、权限控制和企业治理能力可能成为影响商业化速度的重要因素。
* 投资有风险,入市须谨慎。本文不作为 Gate 提供的投资理财建议或其他任何类型的建议。
* 在未提及 Gate 的情况下,复制、传播或抄袭本文将违反《版权法》,Gate 有权追究其法律责任。
分享
目录
Velocity 将 A 轮融资扩大至$48M ,估值为$200M ,获 Visa 和 Ripple 支持
Solana 财库公司 DeFi Development Corp 增持 55,491 枚 SOL,并启动 $300M ATM 融资计划
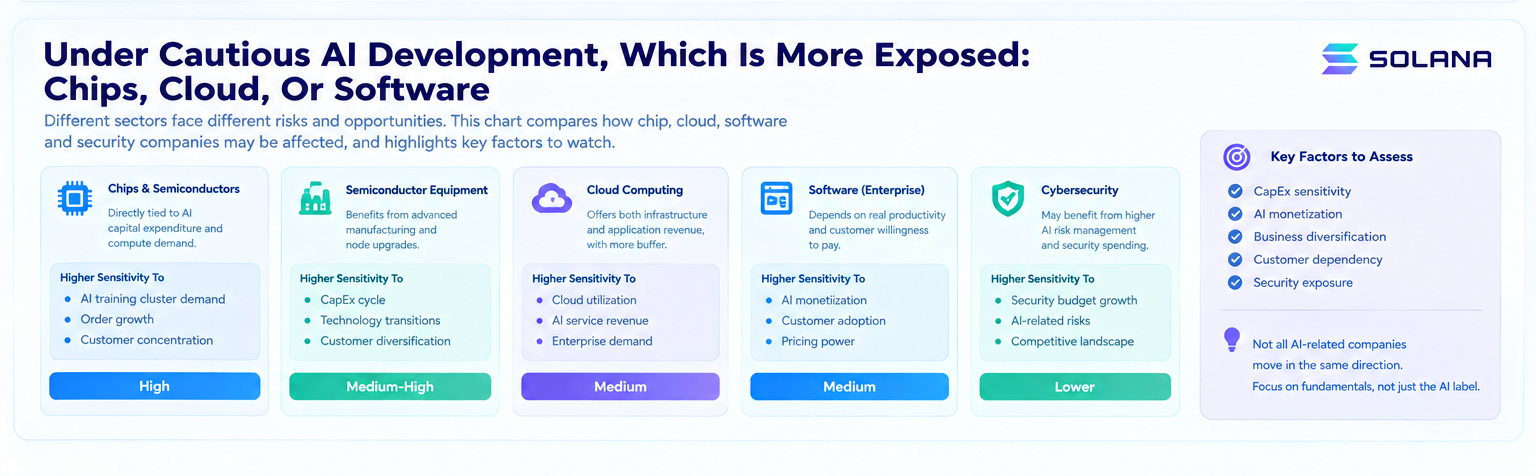
美国银行将美国半导体行业截至2030年的复合年增长率预测上调至18%,目标总可寻址市场(TAM)规模为32000亿亿美元
Gate 于 9 月 16 日上线支持 Circle 的 Arc 区块链,并提供零 Gas 交易。
巴克莱重申对 Strategy(MSTR)的买入评级,目标价为160美元


相关文章
CKB:闪电网络促新局,落地场景需发力
ONDO 代币经济模型:如何激励平台增长与参与?
什么是加密货币中的完全稀释估值(FDV)?
GateClaw 与 AI Skills:Web3 AI Agent 的能力体系解析
JTO 代币经济学解析:分配、用途与长期价值