Đối với người đọc lựa chọn theo tác vụ, điểm then chốt không phải là “bên nào mạnh hơn”, mà là liệu thất bại gây hại nhiều hơn dưới dạng lời nói trôi chảy nhưng vô nghĩa hay động lực học bị sai lệch. Các phần dưới đây so sánh mô hình thế giới với LLM về mục tiêu dự đoán, dữ liệu/đánh giá, tác vụ phù hợp, quy tắc kết hợp và các nhận định sai lầm. Giới hạn năng lực liên quan đến Siêu trí tuệ (ASI); ranh giới triển khai liên quan đến AI riêng tư.
Những điểm chính
- Mô hình thế giới tối ưu hóa động lực học trạng thái tiếp theo/tiềm ẩn có điều kiện theo hành động; LLM tối ưu hóa token tiếp theo và cấu trúc văn bản.
- Ưu tiên mô hình thế giới cho việc lập kế hoạch và điều khiển trong môi trường vật lý; ưu tiên LLM cho viết nội dung, hỏi đáp có tăng cường truy xuất và gọi công cụ.
- Khi một công việc cần cả giao diện ngôn ngữ lẫn động lực học môi trường có thể mô phỏng diễn tiến, hãy kết hợp chúng thay vì xem chúng là các lựa chọn thay thế.
- Các chế độ thất bại khác nhau: LLM thường thất bại do ảo giác ngôn ngữ; mô hình thế giới thất bại do sai lệch động lực học và vật lý giả.
Mô hình thế giới là gì?
Mô hình thế giới là một hệ thống động lực học được học: với một trạng thái hiện tại (hoặc quan sát) và một hành động dự kiến, hệ thống dự đoán môi trường sẽ thay đổi như thế nào để tác tử có thể thử các bước đi trong mô phỏng trước khi lập kế hoạch. Trục quyết định rõ ràng nhất là dự đoán có điều kiện theo hành động, không phải độ trôi chảy khi trò chuyện.
Không giống các hệ thống chỉ tạo ra văn bản hoặc hình ảnh, các ngăn xếp hướng đến mô hình thế giới kết nối dự đoán với các vòng lặp lập kế hoạch, điều khiển hoặc huấn luyện bằng mô phỏng. Các hướng tiếp cận phổ biến gồm RL dựa trên mô hình, chẳng hạn như Dreamer, mô phỏng tương tác tạo sinh và dự đoán biểu diễn theo kiểu JEPA; mục tiêu khác nhau, vì vậy không thể hoán đổi tên thương hiệu cho nhau.
Mô hình ngôn ngữ lớn là gì?
Mô hình ngôn ngữ lớn (LLM) là một mô hình tạo sinh được huấn luyện trên các kho ngữ liệu văn bản lớn, với dự đoán token tiếp theo là mục tiêu cốt lõi. LLM mạnh về hiểu ngôn ngữ, tóm tắt, dịch thuật, hỗ trợ lập trình và điều phối văn bản nhiều bước thông qua câu lệnh cùng giao diện công cụ.
LLM có thể mô tả thế giới vật lý hoặc viết các bước cho “điều gì xảy ra nếu bạn đẩy một chiếc cốc”, nhưng mô tả không phải là động lực học môi trường có thể mô phỏng diễn tiến và đánh giá. Nếu không có giao diện hành động–trạng thái và các bước kiểm tra vòng kín, việc coi LLM là bộ điều khiển hoặc động cơ vật lý là một lỗi lựa chọn, không phải vấn đề “mô hình quá nhỏ”.
Mục tiêu dự đoán khác nhau như thế nào?
Khác biệt cốt lõi nằm ở đối tượng dự đoán: mô hình thế giới dự đoán trạng thái tiếp theo hoặc động lực học tiềm ẩn sau một hành động; LLM dự đoán token tiếp theo và cấu trúc văn bản. Cả hai đều “dự đoán”, nhưng không dùng chung một tiêu chuẩn thành công.
| Tính năng |
Mô hình thế giới |
LLM |
| Mục tiêu dự đoán |
Trạng thái tiếp theo / động lực học tiềm ẩn, thường có điều kiện theo hành động |
Token tiếp theo / văn bản và tuân theo chỉ dẫn |
| Liên kết với hành động |
Dự đoán có điều kiện theo hành động là trục quyết định |
Thường không mô hình hóa vòng lặp điều khiển vật lý |
| Dạng đầu ra |
Trạng thái, biểu diễn, quỹ đạo hoặc quan sát tương tác |
Văn bản, mã, đối số gọi công cụ |
| Tiêu chí thành công |
Hệ quả có thể kiểm tra, khả năng lập kế hoạch, lỗi có thể theo dõi |
Tính đúng đắn về ngữ nghĩa, định dạng có thể sử dụng, trích dẫn có thể kiểm chứng |
| Thất bại điển hình |
Sai lệch động lực học, vật lý giả |
Ảo giác ngôn ngữ, trích dẫn bịa đặt |
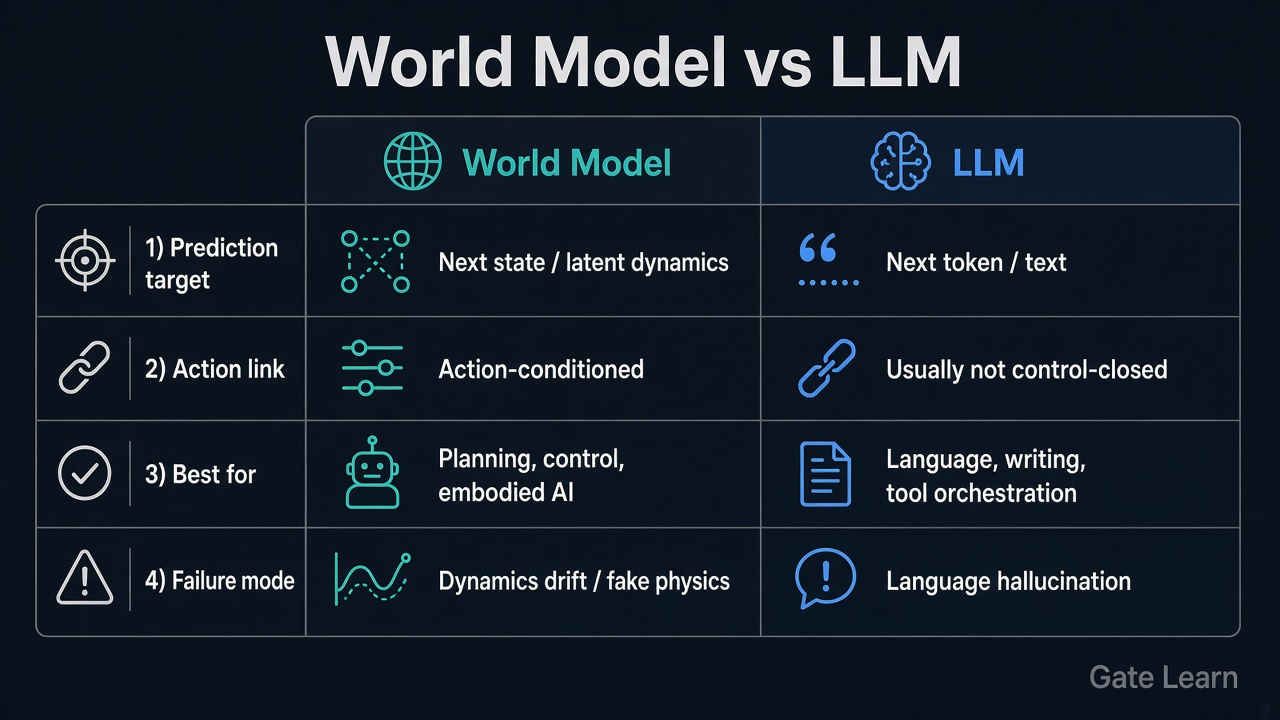
Hình 1. So sánh theo bốn khía cạnh giữa mô hình thế giới và LLM: mục tiêu dự đoán, liên kết với hành động, tác vụ phù hợp nhất và chế độ thất bại.
JEPA và LLM thường bị nhầm lẫn. JEPA, chẳng hạn I-JEPA của Meta AI, dự đoán các biểu diễn tương lai trừu tượng trong không gian nhúng chung và hướng đến mô hình thế giới; LLM vẫn là hệ thống mô hình hóa ngôn ngữ. Tên gọi tương tự không có nghĩa là có thể hoán đổi cho nhau. Xem Bảng thuật ngữ NVIDIA: Mô hình thế giới và phần thảo luận về lộ trình của LeCun (Con đường hướng tới trí tuệ máy tự chủ).
Dữ liệu, đầu ra và đánh giá khác nhau như thế nào?
Dữ liệu và đánh giá tuân theo mục tiêu dự đoán: mô hình thế giới dựa nhiều vào các quỹ đạo tương tác, chuyển đổi trạng thái, tín hiệu điều khiển và đôi khi là video; LLM dựa nhiều vào kho ngữ liệu, dữ liệu chỉ dẫn và tùy chọn là nhật ký công cụ. Cách sử dụng ở bước tiếp theo quyết định các chỉ số lỗi.
| Khía cạnh |
Mô hình thế giới |
Mô hình ngôn ngữ lớn |
| Dữ liệu điển hình |
Quỹ đạo quan sát–hành động–quan sát tiếp theo/phần thưởng, đôi khi bao gồm video |
Văn bản, hội thoại, mã, dấu vết công cụ |
| Đầu ra chính |
Trạng thái tiếp theo, động lực học tiềm ẩn, quỹ đạo được mô phỏng |
Văn bản, câu trả lời có cấu trúc, lệnh gọi hàm |
| Trọng tâm đánh giá |
Lỗi nhiều bước, mức độ hoàn thành tác vụ, độ bền vững ngoài phân phối |
Tính đúng đắn, độ trung thực, định dạng và an toàn |
| Vấn đề khó phát hiện |
Vật lý giả trông mượt mà; lỗi tăng theo thời hạn dài |
Ảo giác trôi chảy; trích dẫn không qua được kiểm tra |
Dùng “viết một đoạn văn vật lý chính xác” để chứng nhận một mô hình thế giới, hoặc dùng “đoạn video trông đẹp” để chứng nhận vòng lặp điều khiển LLM, là đã hoán đổi trục đánh giá. Hãy xác định đầu ra có thể kiểm tra trước, sau đó mới chọn họ mô hình.
Tác vụ nào phù hợp hơn với mô hình thế giới? Tác vụ nào phù hợp hơn với LLM?
Hãy bắt đầu từ nơi chi phí thất bại phát sinh, tức vật lý/điều khiển hoặc ngữ nghĩa/giao tiếp. Ưu tiên mô hình thế giới cho trường hợp đầu và LLM cho trường hợp sau. Khi cả hai đều cần thiết, hãy dùng “bắt buộc kết hợp” thay vì cố chọn một bên thắng.
| Điều kiện tác vụ |
Ưu tiên mô hình thế giới |
Ưu tiên LLM |
Khi cần kết hợp |
| Cần dự đoán rõ ràng từ hành động → trạng thái tiếp theo |
Có |
Không |
— |
| Cần giao diện ngôn ngữ tự nhiên, tạo tài liệu/mã |
Không |
Có |
— |
| Lập kế hoạch trong môi trường vật lý; lọc các quỹ đạo thất bại trước khi va chạm, như trong lái xe tự động |
Có |
Không, LLM chỉ có thể giải thích |
LLM dùng cho chỉ dẫn; mô hình thế giới dùng cho động lực học được mô phỏng |
| Hỏi đáp có tăng cường truy xuất, viết nội dung, điều phối công cụ |
Không |
Có |
— |
| Huấn luyện chính sách trong mô phỏng, MBRL |
Có |
Không |
LLM có thể soạn nội dung tác vụ; động lực học vẫn cần mô hình thế giới |
| Hội thoại về mục tiêu kèm vòng lặp điều khiển có thể thực thi |
Không đủ nếu dùng riêng |
Không đủ nếu dùng riêng |
Bắt buộc kết hợp: LLM phân tích mục tiêu → mô hình thế giới / bộ lập kế hoạch thực thi |
“Bắt buộc kết hợp” phù hợp với một cấu trúc phổ biến: LLM đảm nhiệm ý định và giao diện; mô hình thế giới, hoặc bộ mô phỏng kết hợp động lực học đã học, đảm nhiệm dự đoán hệ quả và lọc quỹ đạo. Loại bỏ một trong hai thường khiến hệ thống rơi vào chế độ thất bại của bên còn lại.
Khi nào nên kết hợp cả hai?
Hãy kết hợp chúng khi một tác vụ bao gồm cả mục tiêu ở lớp ngôn ngữ và hệ quả ở lớp môi trường, thay vì tranh luận về việc thay thế. Một chuỗi điển hình là: LLM chuyển mục tiêu thành các mục tiêu con hoặc ràng buộc; mô hình thế giới mô phỏng các hành động ứng viên; bộ lập kế hoạch chọn quỹ đạo theo chi phí và an toàn; quá trình thực thi trả về một quan sát mới để cập nhật trạng thái.
Kết hợp không phải là “nối hai câu lệnh”. Các giao diện phải rõ ràng: LLM tạo ra những mục tiêu có cấu trúc nào, mô hình thế giới chấp nhận những hành động nào và lỗi nhiều bước kích hoạt việc lập kế hoạch lại hoặc phương án dự phòng thận trọng như thế nào. Nếu không có hợp đồng này, hệ thống sẽ giống như “lời nói trôi chảy, chuyển động hỏng” hoặc “quỹ đạo đẹp, chỉ dẫn không khớp”.
Việc chồng ghép cứng nhắc cũng không phù hợp khi hỏi đáp tài liệu thuần túy hầu như không cần mô hình thế giới, hoặc khi điều khiển servo cấp thấp đã có động lực học đáng tin cậy và không cần LLM tổng quát. Giá trị của việc kết hợp đến từ sự phân công lao động, không phải số lượng mô hình.
Những nhận định sai lầm và rủi ro nào xuất hiện khi lựa chọn?
Các nhận định sai lầm phổ biến nhất là coi “có thể nói về vật lý” là “có thể thực hiện vật lý”, và coi “khung hình/quỹ đạo đẹp” là “động lực học có thể lập kế hoạch”. Các họ mô hình thất bại theo những cách khác nhau; việc trộn lẫn các bước kiểm tra chấp nhận làm tăng rủi ro triển khai.
| Chế độ thất bại |
Phổ biến hơn ở |
Biểu hiện |
Rủi ro lựa chọn |
Cách phát hiện |
| Ảo giác ngôn ngữ |
LLM |
Thông tin/trích dẫn trôi chảy nhưng sai |
Nguồn kiến thức duy nhất hoặc “sổ tay” điều khiển |
Bắt buộc có nguồn gốc, kiểm tra công cụ, từ chối các tuyên bố không được hỗ trợ |
| Sai lệch động lực học |
Mô hình thế giới |
Các bước ngắn ổn; mô phỏng dài bị biến dạng |
Tin cậy vòng hở trong thời hạn dài |
Vẽ biểu đồ lỗi theo thời hạn; kiểm tra việc lập kế hoạch lại |
| Vật lý giả |
Mô hình thế giới |
Quỹ đạo mượt mà nhưng vi phạm va chạm/bảo toàn |
Dùng bản trình diễn trực quan làm tiêu chí chấp nhận vật lý |
Kiểm tra xuyên thấu, năng lượng, ràng buộc va chạm |
| Coi LLM là bộ mô phỏng |
Lệch lựa chọn |
Mô tả văn bản thay thế cho chuyển đổi trạng thái |
Tác vụ vật lý không có vòng lặp điều kiện theo hành động |
Yêu cầu giao diện hành động và trạng thái có thể mô phỏng diễn tiến |
| Coi mô hình thế giới là công cụ trò chuyện |
Lệch lựa chọn |
Ép dự đoán trạng thái vào hỏi đáp hỗ trợ |
Chi phí cao, trải nghiệm ngôn ngữ kém |
Hỏi liệu chất lượng văn bản có phải là công việc chính hay không |
Các bước kiểm tra rủi ro cần gắn với tác nhân kích hoạt: nếu công việc chủ yếu là tính đúng đắn về ngữ nghĩa, hãy quản trị ảo giác trước; nếu chủ yếu là hệ quả điều khiển, hãy quản trị sai lệch và vật lý giả trước. Các câu chuyện về năng lực không thay thế được bước kiểm tra chấp nhận.
Tóm tắt
Mô hình thế giới và mô hình ngôn ngữ lớn giải quyết các vấn đề dự đoán khác nhau: loại thứ nhất hướng đến hệ quả của hành động và động lực học có thể lập kế hoạch; loại thứ hai hướng đến ngôn ngữ và điều phối công cụ. Khi lựa chọn, hãy xác định bên nào gánh chi phí thất bại, sau đó dùng bảng điều kiện để quyết định sử dụng riêng lẻ hay kết hợp.
Dự đoán biểu diễn theo kiểu JEPA hướng đến mô hình thế giới và không phải là LLM. Khi đánh giá chấp nhận, hãy kiểm tra riêng ảo giác ngôn ngữ với sai lệch động lực học / vật lý giả để một bản trình diễn không thể che giấu chế độ thất bại còn lại.
Câu hỏi thường gặp
Sự khác biệt giữa mô hình thế giới và mô hình ngôn ngữ lớn là gì?
Mô hình thế giới chủ yếu dự đoán trạng thái tiếp theo hoặc động lực học tiềm ẩn sau một hành động để phục vụ lập kế hoạch và điều khiển; LLM chủ yếu dự đoán token tiếp theo để hiểu ngôn ngữ, tạo nội dung và điều phối công cụ. Cả hai đều có thể “tạo sinh”, nhưng thành công lần lượt là các hệ quả có thể kiểm tra và ngữ nghĩa cùng định dạng có thể sử dụng.
Mô hình thế giới có thể thay thế mô hình ngôn ngữ lớn không?
Thông thường là không. Mô hình thế giới không tự nhiên cung cấp giao diện ngôn ngữ mạnh hoặc khả năng điều phối văn bản quy mô lớn; LLM không tự nhiên cung cấp động lực học có điều kiện theo hành động có thể mô phỏng diễn tiến. Hãy ưu tiên LLM cho các công việc ngôn ngữ và bổ sung thành phần mô hình thế giới khi tác vụ cần các hệ quả trong môi trường.
Khi nào bạn nên sử dụng mô hình thế giới?
Hãy dùng hệ thống hướng đến mô hình thế giới khi tác vụ phải dự đoán trạng thái tiếp theo từ trạng thái và hành động, sau đó lập kế hoạch, điều khiển hoặc thử các bước đi trong mô phỏng. Các trường hợp điển hình gồm lập kế hoạch trong môi trường vật lý, RL dựa trên mô hình và dự báo hệ quả trong thời hạn ngắn. Viết nội dung thuần túy hoặc hỏi đáp tài liệu thường không phải là trường hợp phù hợp chính.
JEPA và LLM có liên quan như thế nào?
JEPA (Kiến trúc dự đoán nhúng chung) dự đoán các biểu diễn tương lai hoặc bị che trong không gian nhúng và thuộc lĩnh vực học biểu diễn liên quan đến mô hình thế giới; LLM tập trung vào dự đoán token tiếp theo. Cả hai có thể nằm trong một ngăn xếp tác tử, nhưng mục tiêu và chỉ số khác nhau, JEPA không phải là “một LLM khác”.
Có thể sử dụng cả hai cùng nhau không?
Có, và đối với các công việc kết hợp chỉ dẫn bằng ngôn ngữ tự nhiên với việc thực thi trong một môi trường, việc kết hợp thường là bắt buộc: LLM phân tích mục tiêu và ràng buộc; mô hình thế giới hoặc bộ lập kế hoạch dự đoán hệ quả và lọc quỹ đạo. Điểm then chốt là giao diện rõ ràng cùng các điều kiện kích hoạt lập kế hoạch lại, không phải xâu chuỗi cả hai vào một câu lệnh.