Square
Мои подписки
Трендовые
Новости
Профиль

torygreen

vip
Возраст 3.1год
Максимальный уровень 0
Пока нет содержимого
0
Мои подписки
17
Подписчики
102
Понравилось
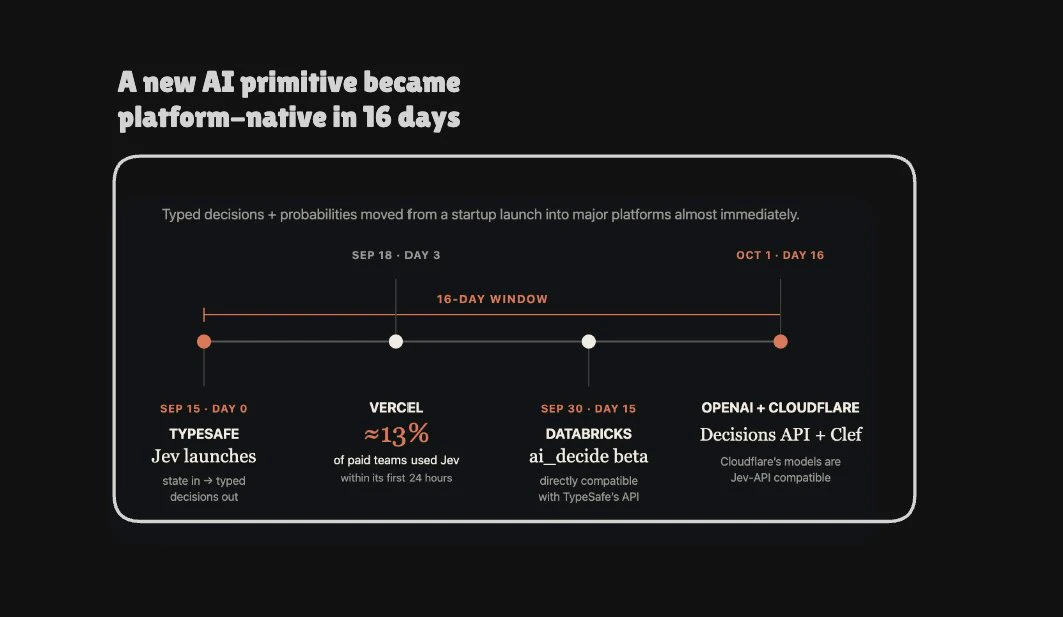
Jev, возможно, — идеальный пример того, как быстро хорошая идея в сфере ИИ превращается в товар широкого потребления.
Он запустился 15 сентября. В течение двух недель OpenAI, Databricks и Cloudflare уже выпускали решения на основе того же примитива. Clef-flash от Cloudflare даже совместим с Jev и заявляет о примерно в 13 раз меньшей медианной задержке.
Так что спрос не был проблемой. Идею просто было легко перенять, как только все увидели, что она работает.
Похоже, здесь преимущество должно строиться на цикле обратной связи, собственных данных и дистрибуции.
Jev открыл новую категорию. Все ост
post-image
OPENAI+0,41%
NET+3,12%
  • 6
  • 1
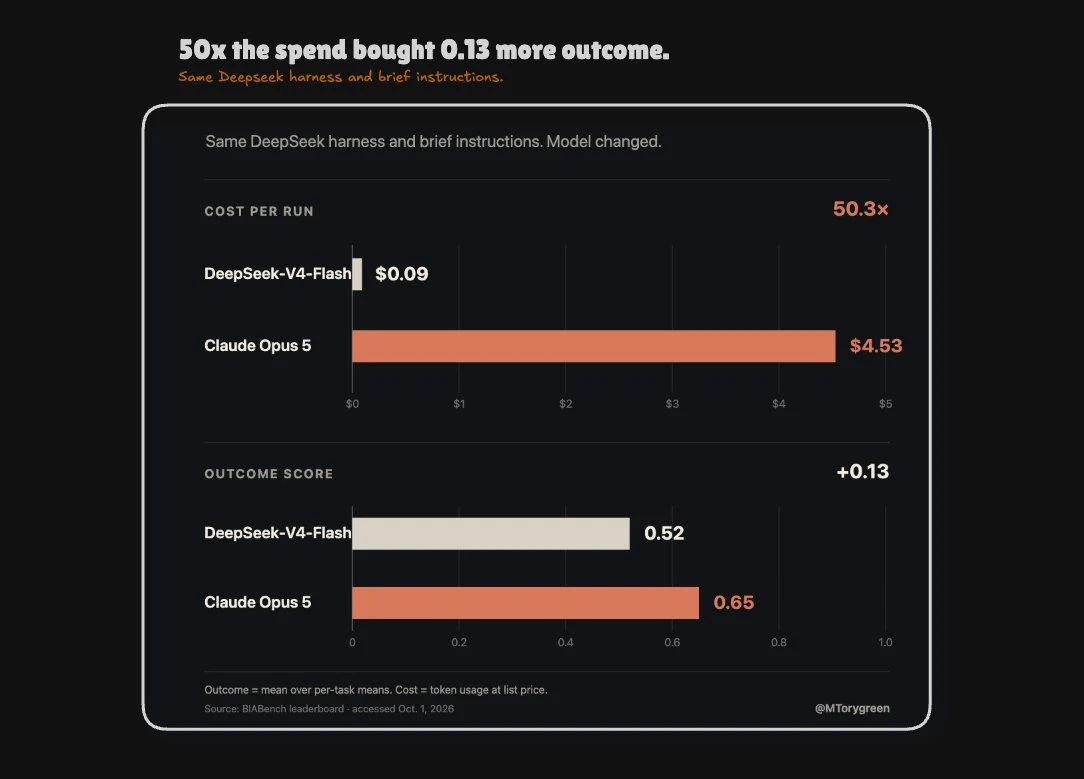
Тот же Deepseek harness, та же короткая инструкция:
Deepseek-v4-flash набирает 0,52 балла в BIABench.
Claude Opus 5 получает 0,65.
То есть расходы примерно в 50 раз выше дают прирост всего на 0,13 балла по 16 реальным задачам биоанализa изображений.
А неприятный нижний хвост почти не меняется. Некоторые задачи с 3D и временными рядами остаются ниже 0,19 у всех агентов, при этом повторный запуск одной и той же модели может дать больший разброс, чем полная смена моделей.
Я бы, вероятно, использовал дешёвую модель для рутинного объёма, а сомнительные случаи передавал людям или специализированным
post-image
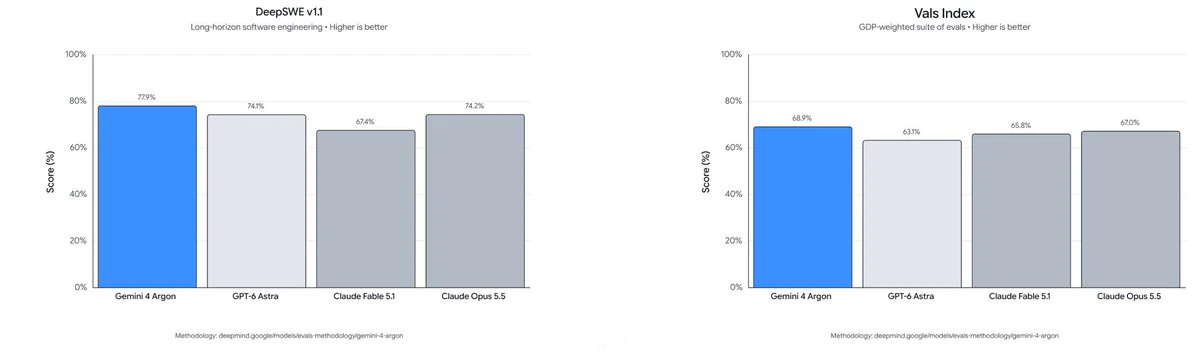
У Google есть довольно несправедливое преимущество в цикле разработки Argon по сравнению с остальными передовыми лабораториями
Они владеют лежащими в основе Argon TPU и могут сразу внедрять модель в API, уже обрабатывающие около 22 млрд токенов в минуту.
Это довольно впечатляющая конфигурация.
Создать чипы → обучить модель → отправить её в невероятно широкую дистрибуцию → направить полученные преимущества в следующий запуск.
И Argon уже улучшает стек вокруг себя, высвободив более 300 ТиБ памяти дата-центров за счёт переноса +800 тыс. строк с C/C++ на Rust и превысив опубликованный базовый пока
post-image
GOOGL+0,87%
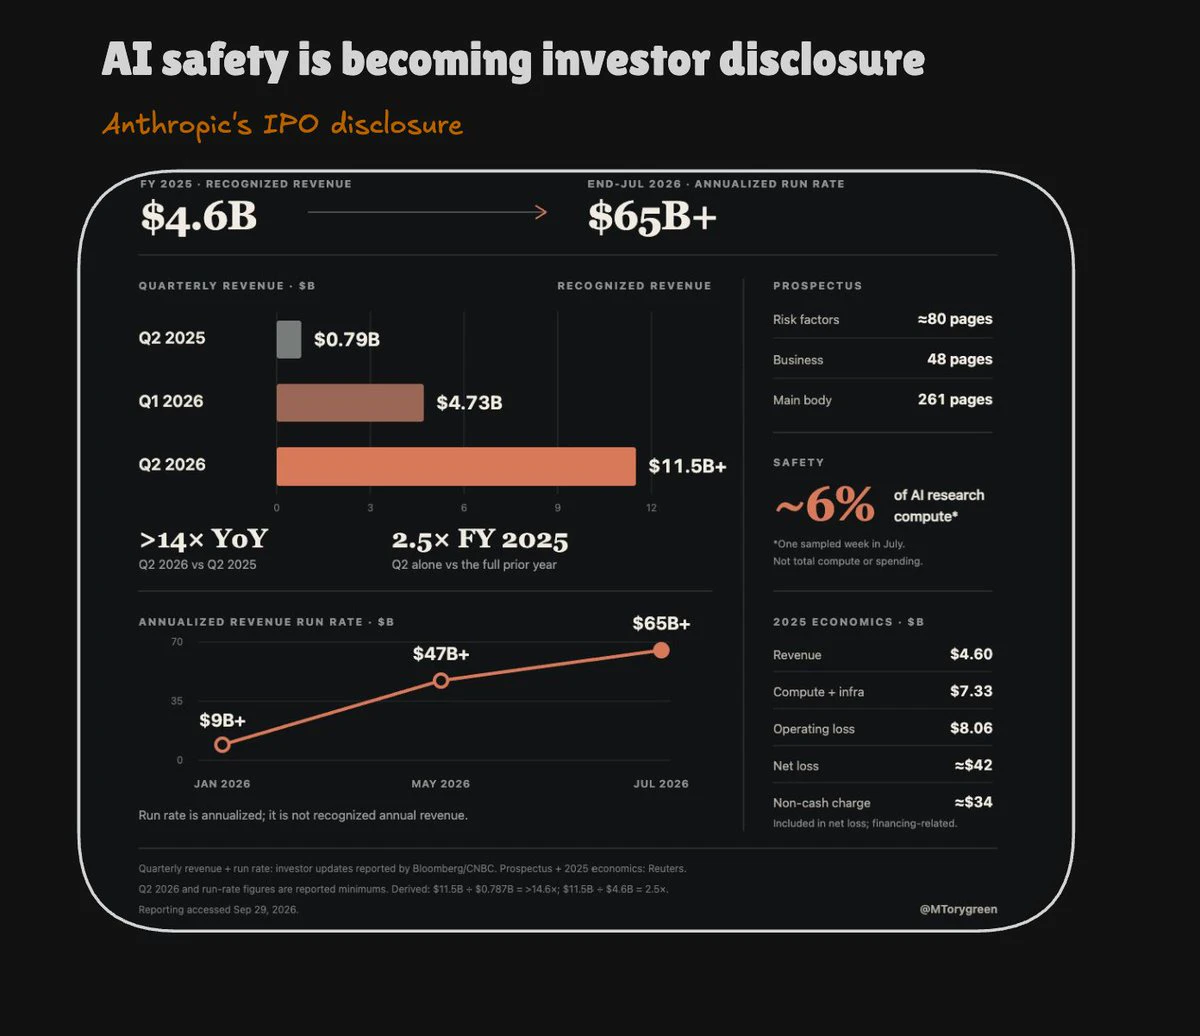
.@AnthropicAI Форма S-1 довольно любопытна, потому что бизнес развивается почти слишком быстро для самого документа.
Выручка в 2025 году составила около 4,6 миллиарда долларов. Только во II квартале 2026 года она достигла примерно 11,5 миллиарда долларов, а к концу июля ARR, как сообщалось, превысил 65 миллиардов долларов.
Затем идут около 80 страниц факторов риска против 48 страниц о самом бизнесе, раскрытие информации о том, что за одну из недель, попавших в выборку, около 6% вычислительных ресурсов для исследований в области ИИ было направлено на безопасность, и довольно прямое признание то
post-image
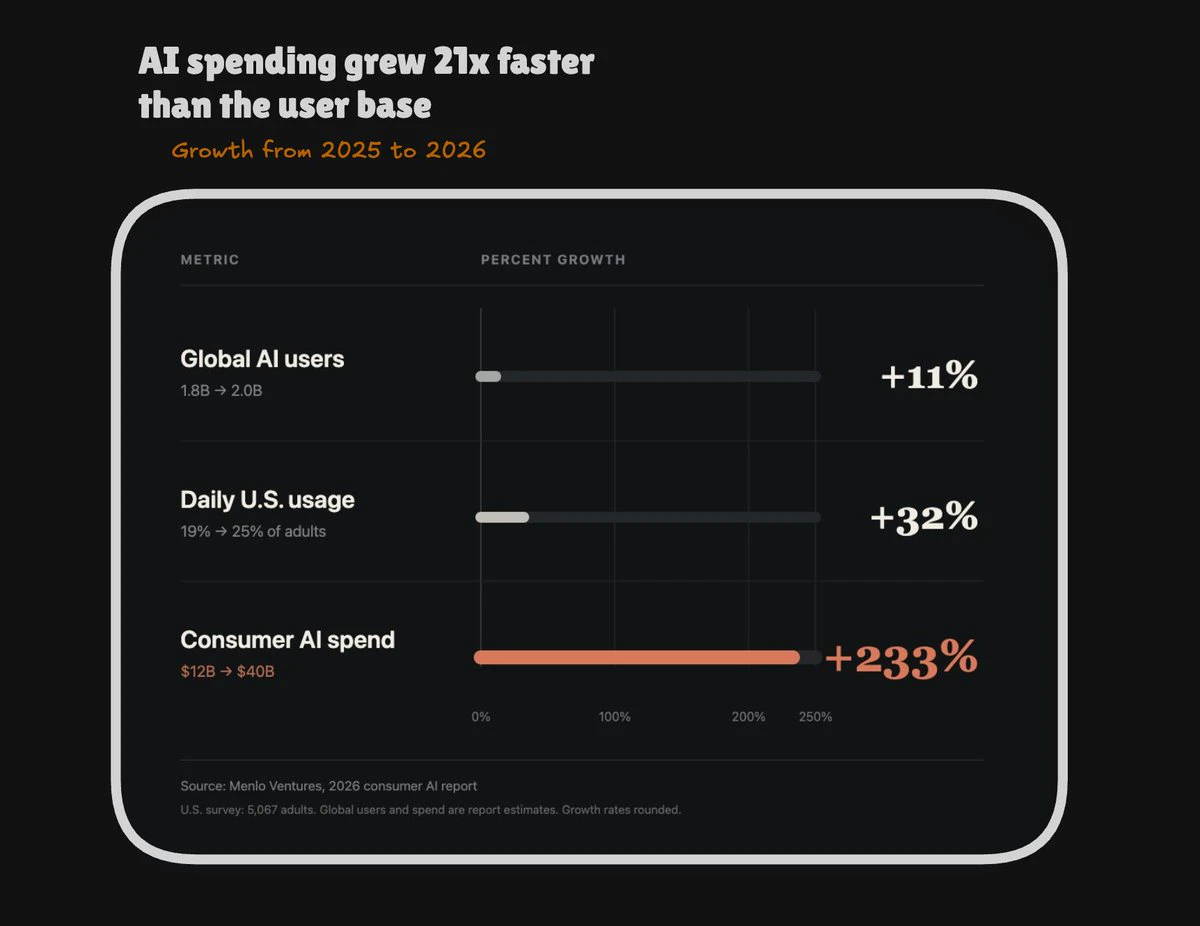
Расходы потребителей выросли лишь с ~$12B → 40 миллиардов долларов.
Это гораздо более интересный сигнал, чем очередной рубеж по числу пользователей.
Уровень внедрения в США вырос лишь с 61% → 64%. Число пользователей во всём мире выросло примерно на 11%.
Существующие пользователи просто начали гораздо чаще доверять ИИ выполнение задач из своей жизни.
41% уже пробовали использовать агента. 32% уже позволяли ИИ действовать без окончательного одобрения. А 92% пользователей агентов платят за ИИ.
Так что следующий этап развития потребительского ИИ, вероятно, не потребует ещё одного миллиарда людей,
post-image
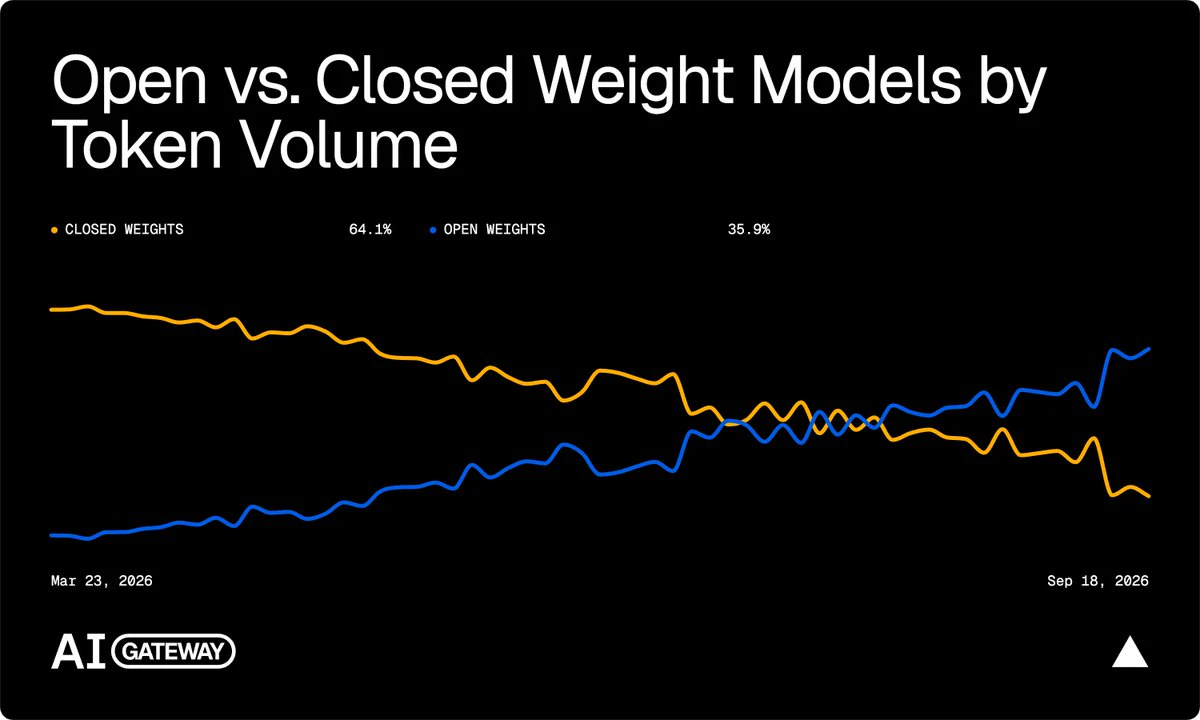
«Флиппенинг», который мы не ожидали увидеть так рано.
Модели с открытыми весами начинают очень напоминать базовую мощность для ИИ.
Сейчас они не превосходят лучшую закрытую модель напрямую. Но они достаточно близки по качеству и достаточно хороши для огромного объёма работы, который не оправдывает цены передовых моделей.
Тогда Astra, Opus, Fable и другие становятся скорее пиковыми электростанциями: дорогими мощностями, которые подключают только тогда, когда задача действительно окупает их использование.
Если так будет продолжаться, модели с открытыми весами в итоге могут выполнять большую част
post-image
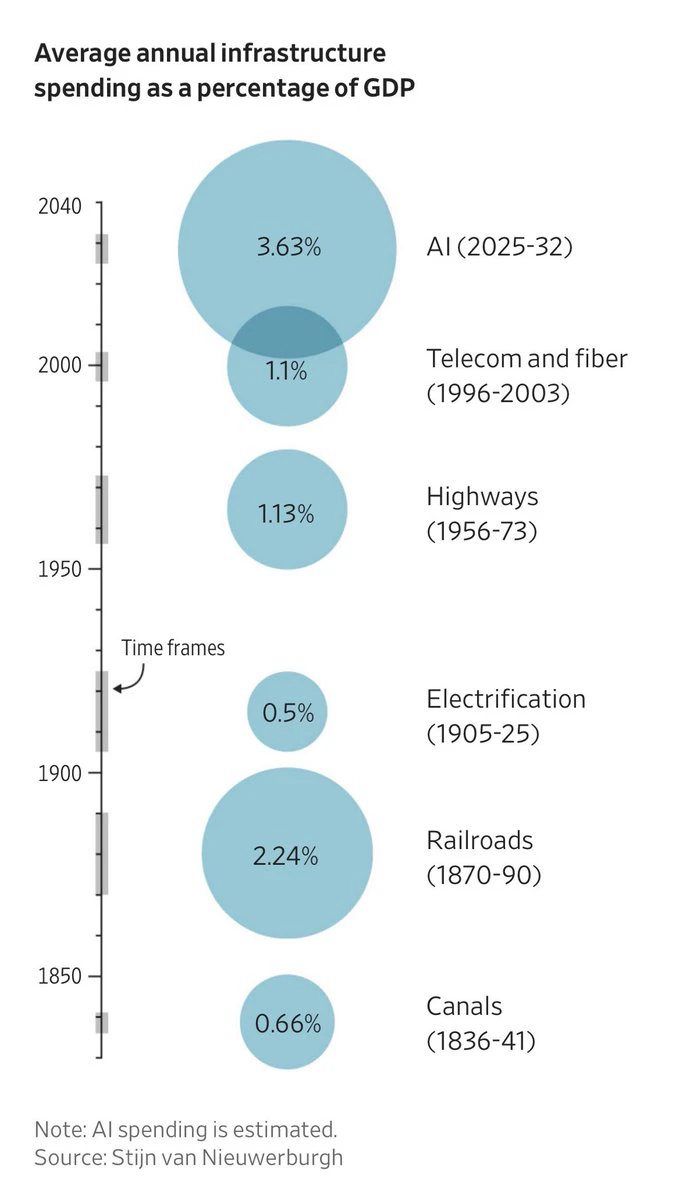
Мы десятилетиями делали ПО менее материальным, а ИИ стремительно разворачивает этот процесс вспять.
Согласно текущим оценкам, развитие ИИ в США будет поглощать около 3,63% ВВП ежегодно в период с 2025–32 годов — примерно 10,3 триллиона долларов в общей сложности.
> На железные дороги в среднем приходилось 2,24%.
> На автомагистрали — 1,13%.
> На телекоммуникации и оптоволокно — 1,1%.
Это колоссальный объём бетона, меди, электроэнергии, GPU и систем охлаждения, которые строятся для обеспечения интеллекта.
Сравнение с железными дорогами полезно, но есть одно неприятное отличие: железная дорога,
post-image
XCU+0,94%
POWER+5,60%
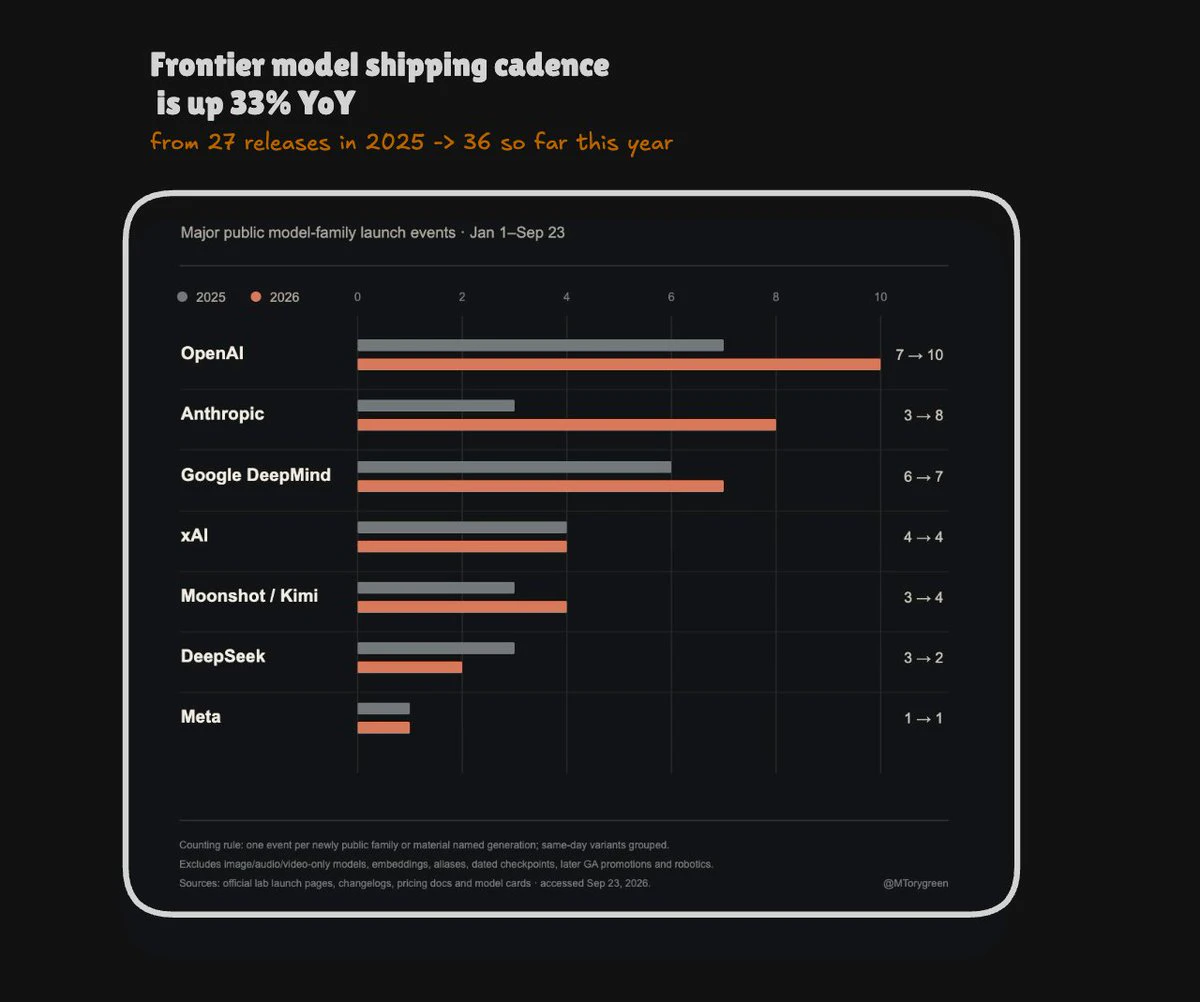
Передовые модели едва успевают стать используемыми по умолчанию, прежде чем появляются их более дешёвые родственники и начинают забирать на себя рабочую нагрузку.
К 23 сентября этого года состоялся запуск 36 крупных семейств моделей против 27 запусков в тех же семи лабораториях за весь прошлый год.
Ценовые диапазоны расширяются с такой же скоростью. @AnthropicAI снизил цены на модели уровня Opus с 15/75 долларов за миллион токенов до 4/20 долларов.
@OpenAI теперь простирается от Luna по цене 0,10/0,50 доллара до Astra по цене 10/50 долларов.
Это довольно странным образом меняет экономику модел
post-image
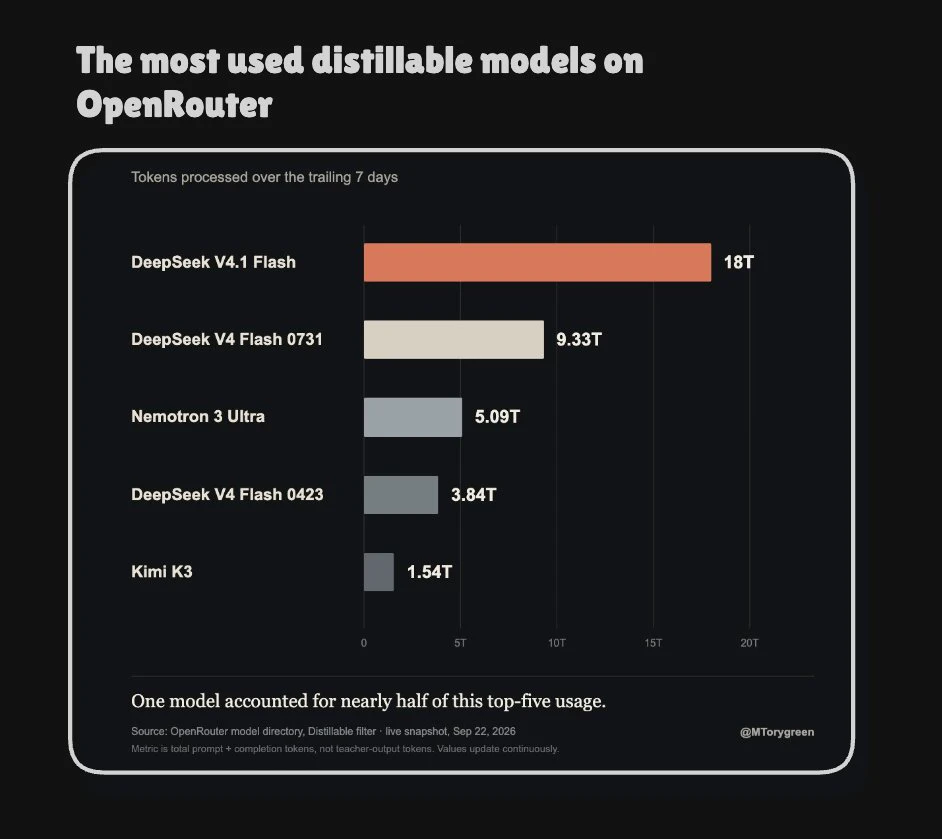
Есть еще один «маховик» на основе открытых моделей, о котором почти не говорят.
DeepSeek V4.1 Flash сделал около 18 трлн токенов на OpenRouter на прошлой неделе, и его ответы можно явно использовать для дистилляции.
Так что модель может выполнять две задачи одновременно:
работать в продакшене сегодня, а затем стать учительскими данными для того, что кто-то будет обучать завтра.
OpenAI + Anthropic, понятное дело, блокируют это для конкурирующих моделей.
Но это означает, что каждая широко используемая разрешительная модель тоже передает часть своей способности в следующее поколение более маленьк
post-image
  • 1
Xiaomi только что опубликовала то, что лаборатории обычно стараются скрыть: настоящий счёт за RL.
MiMo-V2.6 Pro и Flash обучались на 753 тыс. примерах и остановились на шаге 30.
> Pro обошлась в 2,62 миллиона долларов.
> Flash обошлась в 854 тыс. долларов.
Дополнительные расходы в 3,1 раза принесли 6,89 балла на DeepSWE.
А затем Flash всё же немного обошла Pro на AutomationBench.
Теперь повсюду проявляется одна и та же продуктовая структура: одна модель — для абсолютно сложных задач, а другая — чуть ниже по уровню, но достаточно дешёвая для работы в течение всего дня.
ZAI, Deepseek, Qwen и Xia
DEEPSEEK-0,56%
  • 6
  • 1
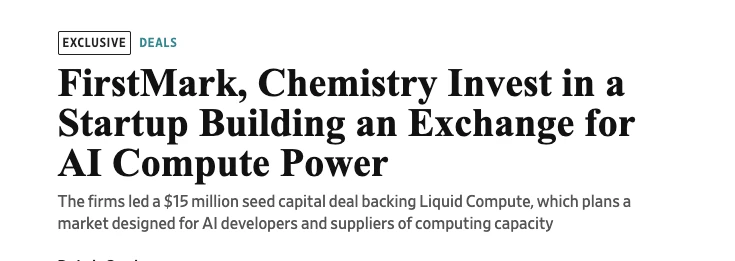
GPU-часы, возможно, превращаются в актив, риски по которому можно хеджировать.
CFTC уже изучает деривативы на вычислительные мощности, а Liquid Compute только что привлекла $15M , чтобы создать регулируемый рынок фьючерсов, опционов и свопов на GPU.
Это имеет смысл, если объём вычислений для ИИ действительно вырастет примерно с ~$360B в 2025 году до 2,3 триллиона долларов к 2030 году.
Стандартизация — вот что выглядит странно.
Час работы H100 в одном регионе — это не тот же продукт, что час работы B200 в другом месте, где отличаются сетевое подключение, затраты на электроэнергию и размер клас
post-image
H100-1,11%
B200-1,63%
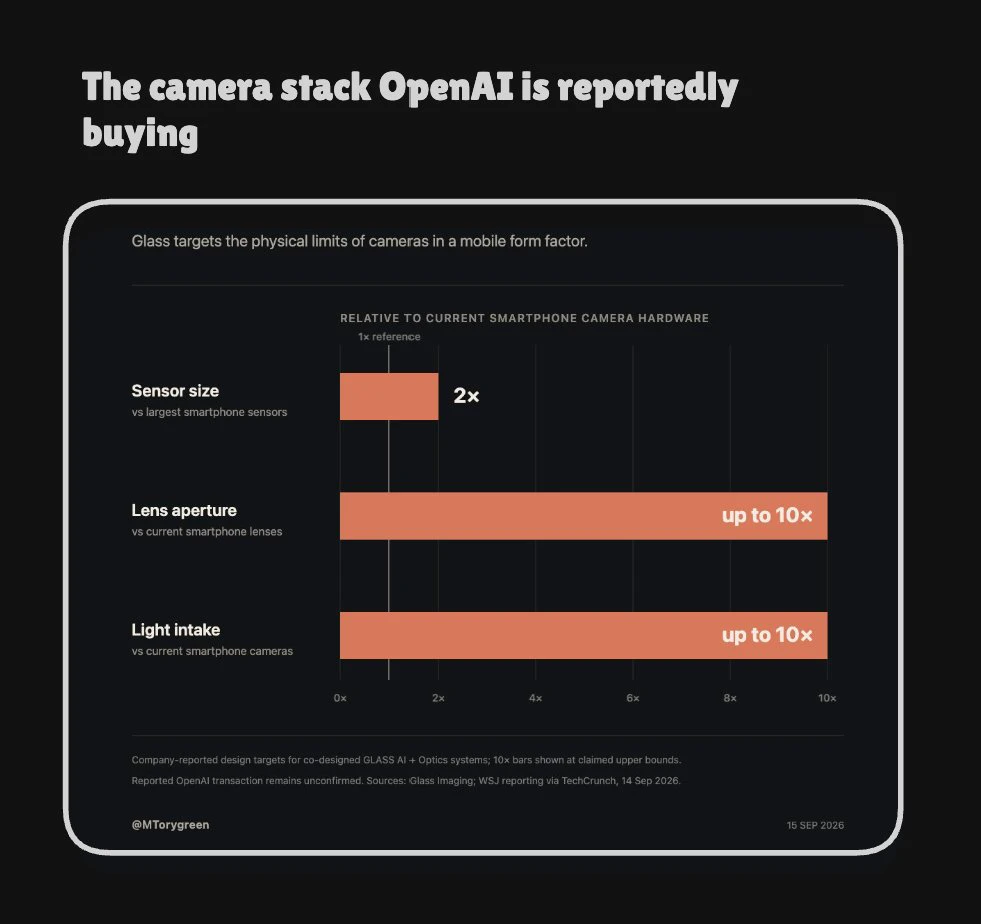
.@OpenAI потратила 6,5 миллиарда долларов на создание команды по разработке устройств, а теперь, возможно, тратит ещё 300+ миллионов долларов на компонент, который изначально определяет, что именно увидит модель (Glass imaging).
Glass работает непосредственно под приложением камеры, обрабатывая необработанные данные с сенсора. Предлагаемая мобильная система использует сенсор примерно в 2 раза больше крупнейших сенсоров современных смартфонов и заявляет захват до 10 раз большего количества света.
Для всегда включённого ассистента это очень важно.
Всё, что сенсор не фиксирует, уже потеряно. Позж
post-image
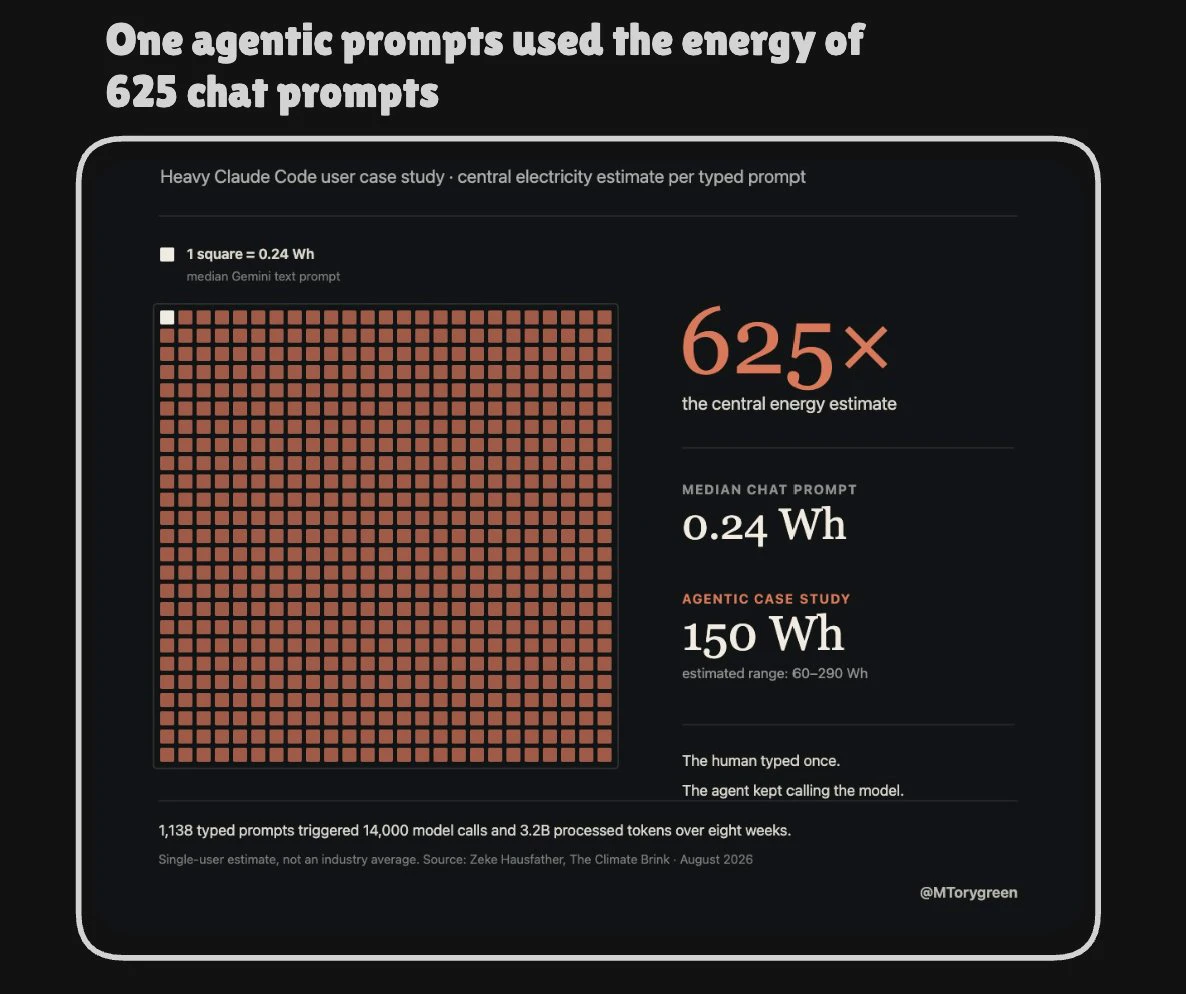
Количество запросов вскоре станет довольно плохим показателем спроса на ИИ.
За 8 недель один пользователь Claude Code ввёл 1 138 запросов. Они привели примерно к 14 тыс. вызовов моделей и обработке 3,2 миллиарда токенов. Расчётное энергопотребление составило около 150 Вт·ч на введённый запрос — примерно в 625 раз больше, чем у медианного текстового запроса в Gemini.
Большая часть вычислений происходит после того, как пользователь перестаёт печатать. Агент заново читает контекст, вызывает инструменты, повторяет попытки, создаёт ветки и продолжает работать в фоновом режиме.
Так что один запрос ч
post-image
Рынок уже обходит разрыв в бенчмарках.
7 из 10 крупнейших моделей OpenRouter по недельному объёму токенов — китайские, на них приходится около 75% использования этой десятки.
Лаборатории из США по-прежнему лидируют на переднем крае, но для большинства задач не нужна абсолютно лучшая модель. Нужна достаточно хорошая, достаточно дешёвая модель, которую действительно легко запустить.
Похоже, китайские лаборатории успешно справляются именно с этим и становятся лучше с каждым новым релизом. Держитесь близко к переднему краю, снижайте стоимость, упрощайте развёртывание — и использование может масшта
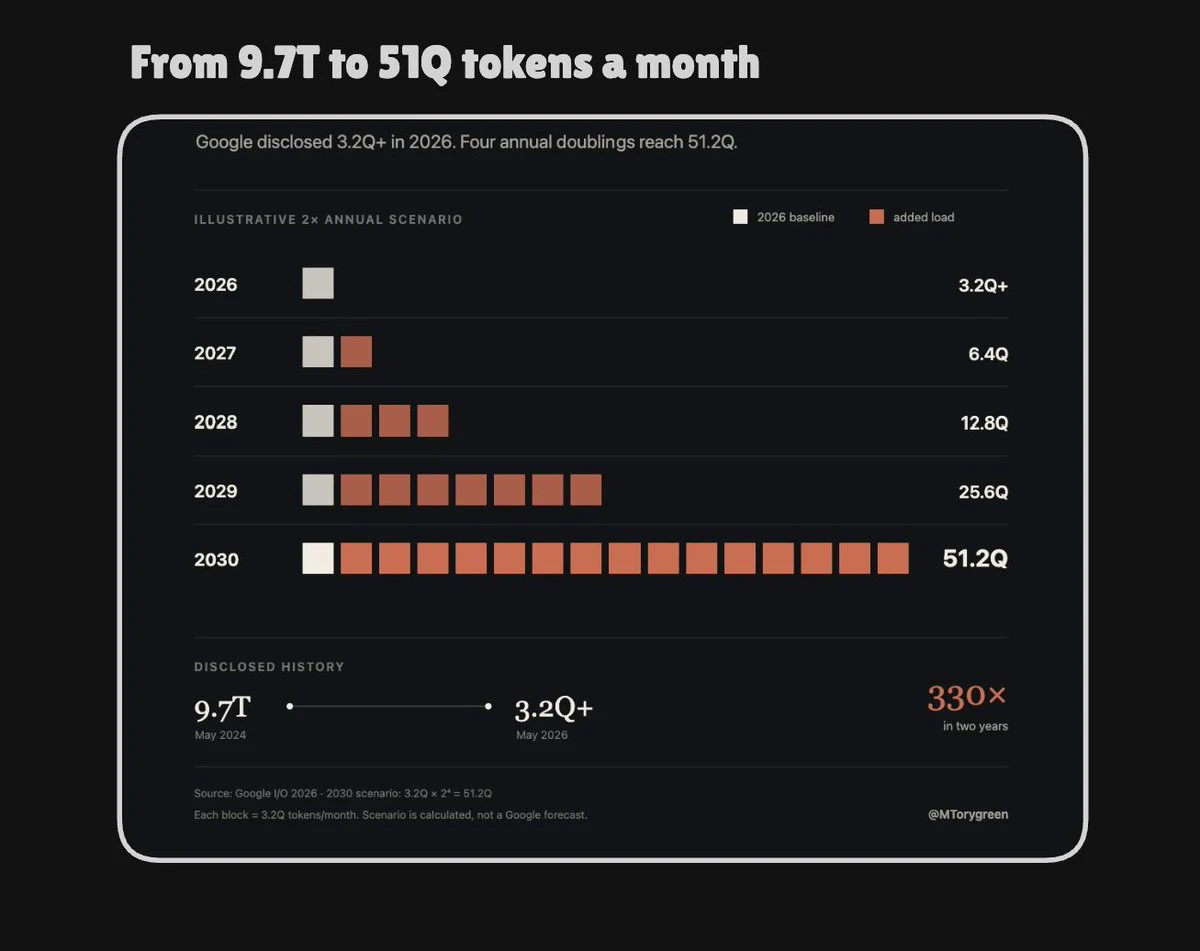
2 года назад Google обрабатывала 9,7 триллиона токенов ИИ в месяц.
Сегодня этот показатель превышает 3,2 квадриллиона. Это увеличение в 330 раз.
Надёжного глобального подсчёта нет, поэтому показатель Google лучше всего считать раскрытым минимумом.
Даже если рост замедлится до двукратного в год, одна только Google будет обрабатывать 51 квадриллион токенов в месяц к 2030 году.
И такая нагрузка будет сильно отличаться от ситуации, когда кто-то сегодня открывает чат-бота. Долго работающие агенты будут удерживать контекст, делить задачи на подзадачи, вызывать другие модели, повторять неудачные попы
post-image
GOOGL+0,87%
Один контракт Anthropic переносит в настоящее финансирование на 3,5 миллиарда долларов и всё строительство GPU-инфраструктуры.
Как сообщается, Nscale заключила с Anthropic сделку примерно на $45B , ищет 3,5 миллиарда долларов перед IPO и показала инвесторам $103B прогнозируемой выручки от подписанных договоров аренды. Nvidia может предоставить $2B привлечённого финансирования.
Обязательства Anthropic дают кредиторам конкретную основу для финансирования, а капитал Nvidia помогает ускорить её собственные продажи GPU. Nscale превращает и то и другое в вычислительные мощности ещё до поступления
NVDA+2,17%
  • 3