3 ноября 2026 года Binance опубликовала предварительное заявление по итогам расследования, посвященное инциденту безопасности 29 октября. В заявлении сообщается, что злоумышленники скомпрометировали устройства инженеров с помощью вредоносного ПО и использовали внутренние ИИ-инструменты для дальнейшего расширения доступа. Согласно заявлению, в результате атаки был получен несанкционированный доступ к внутреннему сервису подписания кошельков, что затронуло цифровые активы на сумму около $6,34 млрд. Однако в заявлении не раскрывается полная архитектура внутренних ИИ-инструментов и не подтверждается, что атака использовала уязвимости непосредственно в большой языковой модели или включала инъекцию промптов.
Этот инцидент поднимает важный вопрос корпоративной безопасности: как компаниям разграничивать разрешения на обработку информации и фактические операционные разрешения, когда ИИ-агент получает доступ к большему числу внутренних инструментов и конфиденциальных систем? В этой статье рассматриваются границы разрешений, инъекции промптов, управление учетными данными и риски горизонтального перемещения, начиная с принципов вызова инструментов ИИ-агентами. Также анализируются меры безопасности, которые могут применять компании.
Основные выводы
-
ИИ-агенты способны не только генерировать текст. Они также могут выполнять код, читать файлы, обращаться к API или работать с внутренними корпоративными системами через вызовы инструментов.
-
В предварительном заявлении Binance, опубликованном 3 ноября 2026 года, указано, что злоумышленники использовали скомпрометированные устройства инженеров и внутренние ИИ-инструменты для получения дальнейшего доступа к устройствам и разрешениям других инженеров.
-
Один из ключевых рисков безопасности ИИ-агентов заключается в преобразовании информации из внешних сред или сред с низким уровнем доверия в действия с фактическими привилегиями на выполнение.
-
Инъекции промптов, вредоносные результаты работы инструментов, чрезмерные разрешения и утечки учетных данных могут усиливать друг друга. Однако не каждая атака с использованием ИИ-инструментов является атакой с инъекцией промптов.
-
Компаниям необходимо рассматривать ИИ-агентов как программные сущности выполнения с определенными идентификаторами и разрешениями, а также контролировать риски с помощью принципа наименьших привилегий, изоляции инструментов, согласования операций и механизмов аудита.
Чем ИИ-агенты отличаются от традиционных ИИ-чат-ботов?
Традиционные ИИ-чат-боты в основном выполняют задачи, получая пользовательский ввод и формируя текстовые ответы. Даже если модель способна предоставить код, проанализировать файлы или объяснить порядок действий, она, как правило, не может напрямую изменить корпоративную базу данных, развернуть приложение или вызвать внутренний сервис без подключения к реальной среде выполнения.
ИИ-агенты отличаются тем, что могут связывать решения, сформированные моделью, с внешними инструментами. Например, разработчики могут настроить Агенту инструменты для поиска кода, выполнения команд в терминале, запросов к базе данных и управления репозиториями Git. Когда пользователь отправляет задачу, Агент может сначала найти связанные файлы, затем вызвать инструменты для получения информации и после этого определить дальнейшие действия на основе результатов. При наличии соответствующих разрешений Агент может даже создавать коммиты кода, запускать тесты или выполнять процессы развертывания.
Такая модель превращает ИИ-агента из простого инструмента генерации информации в программную систему с определенными операционными возможностями. Сам Агент может не иметь независимых прав администратора, однако он способен получать доступ к внешним системам через авторизацию пользователя, сервисные учетные записи, API-токены или другие учетные данные.
Поэтому безопасность ИИ-агентов нельзя оценивать исключительно по точности ответов модели. Даже если контент, сгенерированный моделью, не содержит явных ошибок, Агент может выполнять операции, выходящие за пределы ожиданий пользователя, если разрешения его инструментов настроены неправильно. Компаниям необходимо учитывать не только то, что генерирует ИИ, но и то, какие данные он может читать, какие инструменты может вызывать и какие операции действительно способны изменить состояние системы.
Как ИИ-агенты вызывают инструменты?
Вызов инструментов — важный механизм взаимодействия ИИ-агентов с внешними системами. Разработчики обычно предоставляют модели названия, функциональные описания и структуры параметров доступных инструментов. Затем модель определяет, следует ли вызывать конкретный инструмент, исходя из текущей задачи. Фактическое выполнение обычно осуществляет среда выполнения или приложение Агента, после чего результаты работы инструмента передаются модели для дальнейшей обработки.
Например, внутренний корпоративный Агент для разработки может читать репозитории кода, запрашивать журналы ошибок и запускать тесты. Когда пользователь просит его изучить проблему с сервисом, Агент может вызвать инструмент запросов к журналам, чтобы найти проблему, прочитать соответствующий код, а затем сформировать рекомендации по внесению изменений. Если компания также предоставляет разрешения на написание кода или развертывание, Агент может перейти от аналитической поддержки к выполнению фактических операций.
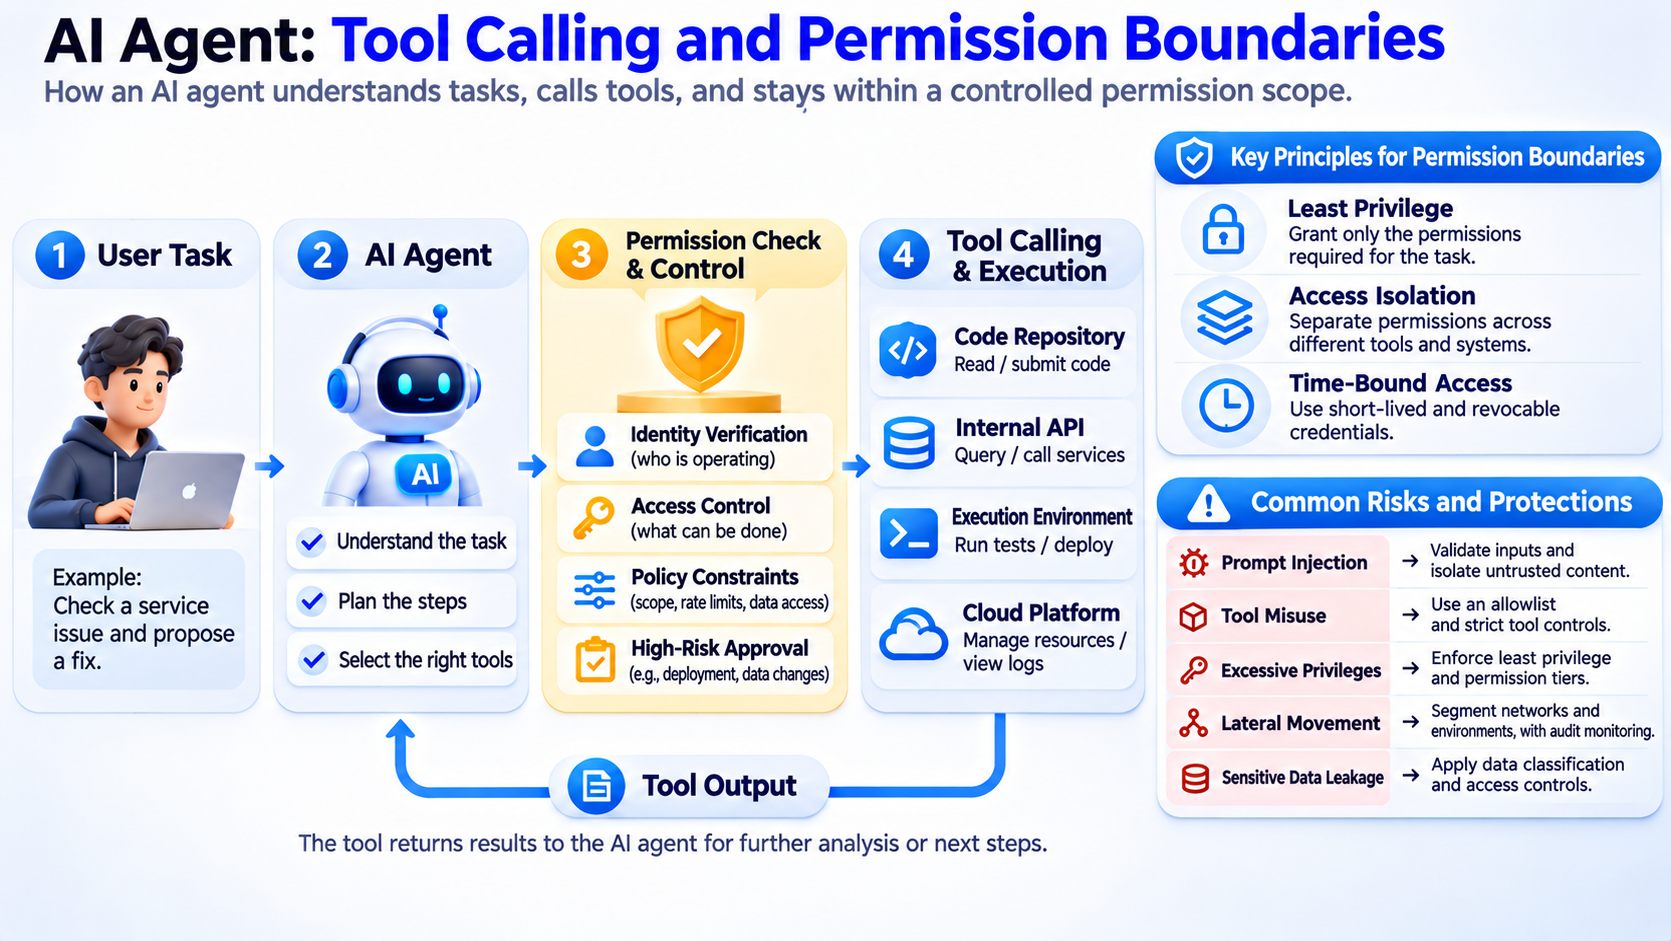
Риски вызова инструментов в основном связаны с двумя аспектами.
-
Агент может получить чрезмерные разрешения на выполнение. Например, ему может быть достаточно чтения журналов, но при этом он также получает возможность изменять конфигурации рабочей среды.
-
Агент может обрабатывать недоверенный контент с внешних веб-страниц, из комментариев в коде, электронных писем или результатов работы инструментов. Если система не может корректно отличить этот контент от фактической авторизации пользователя, внешняя информация может влиять на последующие вызовы инструментов.
Это означает, что компаниям не следует автоматически считать вызовы инструментов, сгенерированные моделью, доверенными операциями. Каждый вызов инструмента, связанный с конфиденциальными данными или изменениями системы, требует независимой проверки разрешений. Модель может отправить запрос на выполнение, но решение о допустимости такого запроса должно приниматься на основе явных политик безопасности.
Почему ИИ-агенты могут расширять поверхность атаки компании?
Традиционные корпоративные системы безопасности обычно выстраивают контроль доступа вокруг идентификаторов сотрудников, серверов, приложений и сетевых границ. У разных сотрудников разные разрешения в системах, а критически важные сервисы могут ограничивать доступ с помощью отдельных учетных данных и сетевых правил. Когда ИИ-агенты подключаются к корпоративным системам, они фактически создают новые автоматизированные пути доступа.
Например, Агент для разработки может одновременно подключаться к репозиторию Git, внутренней базе знаний, облачной платформе и системе управления задачами. Для выполнения межсистемных задач разработчики могут настроить несколько API-токенов или сервисных учетных записей. Если эти учетные данные не ограничены строго, злоумышленник, получивший контроль над средой выполнения Агента или связанной с ним учетной записью, может использовать эти возможности доступа для проникновения в другие системы.
Еще одна проблема — скорость выполнения операций. Сотрудникам обычно необходимо вручную входить на несколько платформ, чтобы выполнить последовательность действий, тогда как ИИ-агент может непрерывно вызывать инструменты за короткий промежуток времени. Автоматизация сама по себе не является небезопасной. Однако без ограничений частоты запросов, выявления аномалий и согласования высокорисковых операций ошибочные или вредоносные инструкции могут быть быстро выполнены.
Следовательно, ИИ-агенты расширяют не только количество программных интерфейсов, но и связи разрешений между разными системами. Компаниям необходимо оценивать, к каким ресурсам имеет доступ каждый Агент, может ли он пересекать различные домены безопасности и существуют ли пути перехода от инструментов с низким уровнем риска к высокорисковым системам.
Почему инъекция промптов может влиять на вызовы инструментов ИИ-агентами?
Инъекция промптов — это атака, при которой злоумышленник размещает в данных, доступных для чтения моделью, контент, похожий на инструкции, чтобы изменить задачу, которую должна выполнять модель. Для обычных чат-ботов такие атаки могут приводить к неверным ответам или раскрытию информации. Для ИИ-агентов, способных вызывать инструменты, они также могут влиять на реальные операции.
Например, компания может использовать ИИ-агента для автоматической организации отчетов о проблемах в репозитории кода. Если злоумышленник может контролировать содержание отчета, он может вставить инструкции, замаскированные под требования обслуживания системы, и побудить Агента прочитать дополнительные файлы или вызвать не связанные с задачей инструменты. Реальный риск заключается не в том, что Агент читает отчет, а в том, воспринимает ли он недоверенный контент отчета как инструкцию с полномочиями на выполнение.
Такие атаки обычно называют косвенной инъекцией промптов. Злоумышленнику не требуется напрямую отправлять команды пользователю Агента. Вместо этого он может влиять на Агента через веб-страницы, документы, комментарии в коде, результаты поиска или вывод инструментов. OWASP относит инъекции промптов, злоупотребление инструментами, повышение привилегий и раскрытие конфиденциальной информации к важным рискам безопасности ИИ-агентов.
Однако инъекцию промптов необходимо отличать от традиционных атак с использованием вредоносного ПО. Если злоумышленник уже получил контроль над компьютером инженера с помощью вредоносного кода, а затем использует существующие учетные данные для доступа к внутренним системам, участие ИИ-инструмента в цепочке атаки не обязательно означает, что произошла инъекция промптов. Эти механизмы могут встречаться вместе, но технически они различаются.
Какие риски для ИИ-инструментов и управления разрешениями выявляет инцидент безопасности Binance?
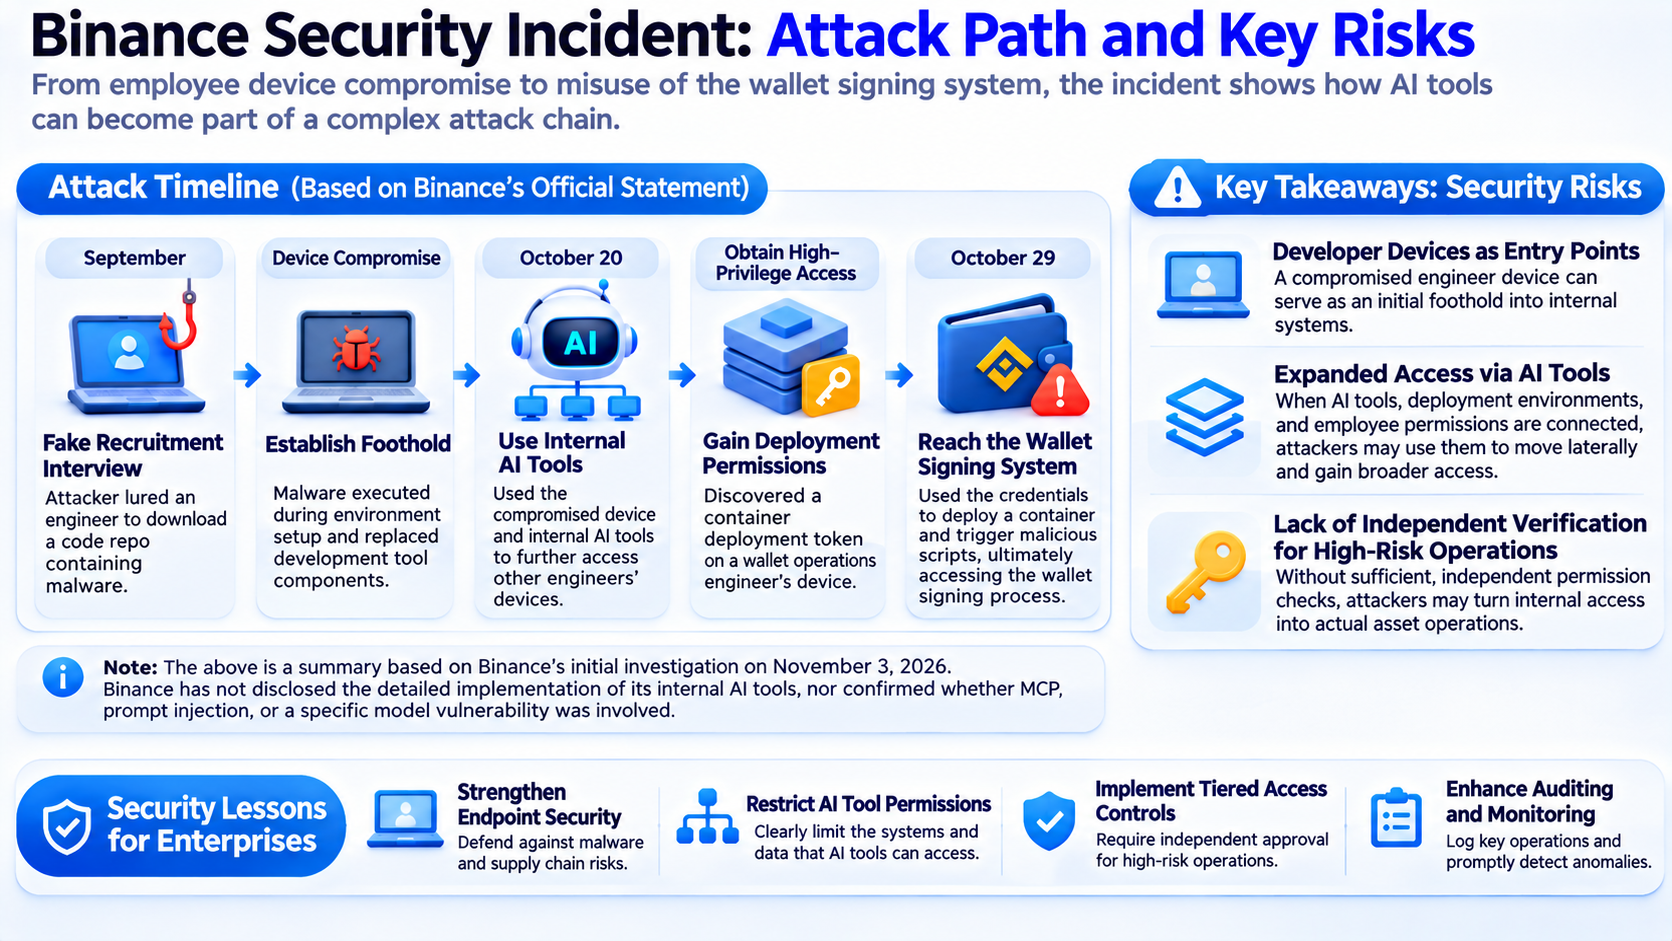
В предварительном заявлении по итогам расследования, опубликованном 3 ноября 2026 года, Binance раскрыла информацию о многоэтапной атаке, которая развивалась от компрометации устройства сотрудника до злоупотребления внутренней системой подписания кошельков. Согласно заявлению, в сентябре злоумышленники убедили инженера-программиста загрузить репозиторий с вредоносным кодом через поддельное собеседование. Вредоносный код выполнялся во время настройки среды и создавал управляемые злоумышленниками каналы связи путем замены компонентов инструментов разработки и другими способами.
20 октября злоумышленники использовали компьютер скомпрометированного инженера и внутренние ИИ-инструменты, чтобы получить контроль над устройствами дополнительных инженеров. Они также обнаружили токен разрешения на развертывание контейнеров на устройстве инженера по операциям с кошельками. 29 октября злоумышленники использовали соответствующие учетные данные для развертывания контейнеров и запуска вредоносных скриптов, в конечном итоге получив доступ к процессу операций подписания кошельков.
С точки зрения архитектуры безопасности этот инцидент отражает как минимум три вопроса, заслуживающих изучения. Во-первых, устройства разработчиков могут становиться точками входа во внутренние системы с высокой ценностью. Во-вторых, когда внутренние ИИ-инструменты, среды развертывания и разрешения сотрудников связаны между собой, злоумышленники могут использовать эти связи для расширения своего доступа. Наконец, если высокорисковые операции не предусматривают достаточной независимой проверки разрешений, злоумышленники могут преобразовать полученные внутренние разрешения в возможность совершать фактические операции с активами.
Важно подчеркнуть, что Binance не раскрыла конкретную реализацию своих внутренних ИИ-инструментов. Поэтому невозможно подтвердить, являлись ли эти инструменты ИИ-агентами с возможностями автономного планирования, или сделать вывод, что атака включала MCP, инъекцию промптов либо уязвимость в конкретной модели. Инцидент показывает, что ИИ-инструменты могут быть частью сложной цепочки атаки, но сам по себе не доказывает, что первопричиной атаки стал ИИ-агент.
Что такое граница разрешений ИИ-агента? Почему принцип наименьших привилегий так важен?
Граница разрешений определяет, к каким ресурсам программная сущность может обращаться, какие операции она может выполнять и при каких условиях она может получать дополнительные разрешения. Для ИИ-агента граница разрешений охватывает не только саму модель, но и среду выполнения Агента, интерфейсы инструментов, идентификатор пользователя, сервисные учетные записи и внешние системы.
Принцип наименьших привилегий требует, чтобы система предоставляла только те разрешения, которые необходимы для выполнения текущей задачи. Например, Агенту, отвечающему за анализ журналов сервера, обычно нужен доступ только к конкретным данным журналов. Он не должен автоматически получать возможность удалять базы данных, изменять рабочие среды или переводить цифровые активы. Если задача действительно требует высокорисковой операции, Агент должен получить временное разрешение через независимый механизм авторизации.
OWASP относит чрезмерную автономность к важным рискам в приложениях с большими языковыми моделями. Основная проблема заключается не в способности модели вызывать инструменты, а в том, что система предоставила модели ненужные функции, чрезмерные разрешения или неограниченные возможности автономной работы. Когда на модель влияют некорректный ввод, инъекция промптов или вредоносные результаты работы инструментов, такие разрешения могут увеличить потенциальный ущерб.
Поэтому компаниям необходимо размещать проверки разрешений в доверенной среде выполнения, а не ограничиваться инструкцией в системном промпте, запрещающей Агенту выполнять опасные операции. Даже если модель ошибочно запрашивает доступ к конфиденциальному инструменту, серверная служба должна иметь возможность отклонить неавторизованный запрос на основе идентификатора, области ресурсов и типа операции.
Какие новые проблемы безопасности могут создавать протоколы подключения инструментов, такие как MCP?
Model Context Protocol (MCP) — это открытый протокол для подключения ИИ-приложений к внешним инструментам и ресурсам данных. С помощью MCP разработчики могут подключать ИИ-агентов к файловым системам, базам данных, репозиториям кода и другим сервисам без необходимости создавать полностью новый способ интеграции для каждого инструмента.
Такой стандартизированный способ подключения может повысить эффективность разработки, однако он также означает, что Агенты могут проще получать доступ к нескольким внешним системам. Если компания не управляет MCP-серверами, определениями инструментов и разрешениями доступа, она может столкнуться с такими проблемами, как чрезмерные разрешения инструментов, вредоносные описания инструментов, компрометация сторонних сервисов или случайное раскрытие конфиденциальной информации.
Например, Агенту для разработки может требоваться чтение репозитория кода, но не нужен доступ к платежной системе компании. Если оба типа инструментов настроены в одной среде выполнения и используют общие учетные данные с высокими привилегиями, Агент, изначально предназначенный для помощи в разработке, может получить операционные возможности, не связанные с его задачей.
OWASP рекомендует создать механизм аудита для MCP-серверов, подключенных к ИИ-инструментам кодирования, ограничивать доступные для вызова инструменты и проверять, содержат ли определения инструментов вредоносные инструкции. Агенты, выполняющие код, также должны использовать такие меры, как песочницы, ограничения сетевого доступа и независимое управление учетными данными.
Сам MCP не является уязвимостью безопасности. Необходимо оценивать реализацию инструментов, аутентификацию, конфигурацию разрешений и то, как внешний контент влияет на поведение Агента после подключения протокола.
Как компаниям защищать идентификаторы ИИ-агентов и разрешения доступа?
Прежде всего компаниям следует создать систему идентификации ИИ-агентов, которая позволяет проводить аудит. Традиционные приложения обычно используют сервисные учетные записи или API-ключи для доступа к другим системам. Однако операции ИИ-агентов могут одновременно включать авторизацию пользователя, автоматизированные задачи и несколько инструментов. Поэтому компаниям необходимо четко различать идентификатор пользователя, идентификатор Агента и фактические разрешения на выполнение.
Например, запрос сотрудника к Агенту на получение внутреннего отчета не означает, что Агент может использовать свою сервисную учетную запись для чтения других файлов, к которым сотрудник не имеет доступа. Корректная архитектура авторизации должна проверять как наличие у запрашивающего пользователя разрешения на доступ к целевому ресурсу, так и право Агента выполнять соответствующую операцию. Это помогает предотвратить обход существующих средств контроля доступа Агентом из-за более высоких привилегий его прокси-сервиса.
В феврале 2026 года Национальный центр передового опыта в области кибербезопасности (NCCoE) при Национальном институте стандартов и технологий (NIST) опубликовал концептуальный документ об идентификации и авторизации программного обеспечения и ИИ-агентов. В документе рассматриваются такие вопросы, как распознавание идентификатора Агента, аутентификация, авторизация, временные учетные данные, делегированные разрешения и аудит. Это отражает расширение безопасности ИИ-агентов от контроля вывода модели к полноценной структуре управления идентификацией и доступом.
При фактическом развертывании компании могут использовать краткосрочные учетные данные доступа и ограничивать разрешения конкретными задачами, ресурсами и периодами времени. Для высокорисковых действий, таких как развертывание в рабочей среде, финансовые операции и изменение разрешений, также следует требовать независимое согласование и повторную проверку. Благодаря этому даже при компрометации среды выполнения Агента злоумышленник может не получить прямой доступ к долгосрочным учетным данным с высокими привилегиями.
Как компании могут снизить риски безопасности при вызовах инструментов ИИ-агентами?
Компании могут внедрить меры защиты в четырех областях: разрешения инструментов, среды выполнения, конфиденциальные операции и мониторинг поведения.
-
Компании должны ограничивать инструменты, доступные Агенту, исходя из бизнес-требований. Агенту, который только получает информацию, не нужны произвольные возможности выполнения кода, а Агент для проверки кода не должен автоматически получать разрешения на развертывание в рабочей среде. Для инструментов с возможностью записи компании могут дополнительно ограничивать пути к файлам, таблицы баз данных, типы операций API и области доступа.
-
Высокорисковые инструменты должны работать в изолированных средах. Выполнение кода, установка сторонних пакетов и обработка внешних веб-страниц могут включать недоверенный контент. Поэтому компании могут использовать контейнеры или другие технологии песочниц для ограничения доступа к файловым системам, сетям и системным ресурсам. Изоляция снижает вероятность того, что атака на один инструмент затронет другие системы.
-
Компании должны требовать одобрения человека для необратимых операций. Такие действия, как удаление важных данных, изменение разрешений, развертывание рабочих сервисов или перевод активов, не должны выполняться автоматически только потому, что Агент считает задачу обоснованной. Рекомендации Microsoft по безопасности Agent Framework также предлагают определять необходимость подтверждения человеком с учетом воздействия операции, конфиденциальности данных и обратимости действия.
-
Наконец, компаниям необходимо создать механизмы непрерывного аудита, фиксирующие, какие инструменты использовал Агент, к каким ресурсам он обращался, возникали ли аномальные запросы разрешений и соответствовали ли фактические результаты выполнения авторизованной задаче. Для повторяющихся неудачных вызовов инструментов, аномального доступа к данным и большого числа операций за короткий период компании могут сочетать обнаружение на основе правил с анализом поведения для выявления потенциальных рисков.
| Мера безопасности |
Основная функция |
| Принцип наименьших привилегий |
Ограничение инструментов и ресурсов, к которым может обращаться Агент |
| Согласование вызовов инструментов |
Предотвращение высокорисковых операций без подтверждения |
| Изоляция в песочнице |
Снижение последствий вредоносного кода или злоупотребления инструментами |
| Временные учетные данные доступа |
Снижение риска долгосрочного раскрытия учетных данных |
| Проверка ввода и вывода |
Снижение риска влияния вредоносного контента на выполнение инструментов |
| Аудит поведения |
Выявление аномальных вызовов и использования разрешений |
Эти меры не могут гарантировать полного устранения рисков безопасности ИИ-агентов. Однако они могут ограничить масштаб последствий успешной атаки и повысить вероятность обнаружения и устранения аномального поведения.
Почему безопасность ИИ-агентов становится важной проблемой для инфраструктуры Web3?
Сочетание ИИ-агентов и блокчейн-инфраструктуры придает вызовам инструментов и управлению разрешениями более прямое значение для безопасности активов. В традиционных корпоративных сценариях Агент может выполнять код, отправлять электронные письма или изменять базу данных. В сценариях Web3 Агент также может подключаться к кошелькам, запрашивать ончейн-активы, вызывать смарт-контракты или инициировать запросы на транзакции.
Например, Агенту для автоматического управления ончейн-активами может требоваться запрашивать балансы, анализировать рынок и предоставлять торговые рекомендации на основе пользовательских настроек. Если он также получает возможность подписывать транзакции или вызывать смарт-контракты, компании должны четко определять, какие операции могут выполняться автоматически, какие требуют подтверждения пользователя и как ограничивать сумму каждой транзакции, область активов и срок действия авторизации.
В этом процессе Session Keys, смарт-аккаунты и механизмы детализированной авторизации могут предоставлять различные формы управления разрешениями. Однако их фактическая безопасность зависит от реализации. Session Keys могут ограничивать определенные операционные разрешения конкретным периодом или областью, а смарт-аккаунты могут ограничивать поведение транзакций с помощью правил контрактов. Тем не менее риски безопасности все равно могут возникать, если условия авторизации слишком широки, логика проверки содержит недостатки или среда выполнения скомпрометирована.
Поэтому развитие ИИ-агентов для Web3 не может быть сосредоточено только на эффективности автоматизированной торговли или ончейн-платежей. Оно также должно учитывать проверку идентификаторов, делегирование разрешений, одобрение транзакций и отзыв авторизации. Для ИИ-систем, подключенных к реальным активам, граница безопасности должна охватывать весь процесс, от решений модели до вызовов инструментов, формирования транзакций, проверки подписей и ончейн-исполнения.
Заключение
ИИ-агенты меняют подход компаний к использованию искусственного интеллекта. По мере подключения моделей к репозиториям кода, внутренним API, базам данных и инструментам автоматизации ИИ-системы перестают быть лишь точками входа для обработки информации. Они все чаще становятся программными сущностями выполнения с реальными операционными возможностями.
Предварительное расследование Binance инцидента безопасности, информация о котором была раскрыта 3 ноября 2026 года, указывает, что внутренние ИИ-инструменты могли присутствовать в сложной цепочке атаки. Однако доступной информации недостаточно, чтобы доказать, что инцидент был непосредственно вызван уязвимостью ИИ-агента или инъекцией промптов. Более важный вывод заключается в том, что компаниям необходимо пересмотреть связи доступа между средами разработки, инструментами автоматизации и системами с высокими привилегиями.
В будущем безопасность ИИ-агентов будет зависеть не только от способности моделей распознавать вредоносные инструкции, но и от того, смогут ли компании создать надежные механизмы аутентификации идентификаторов, наименьших привилегий, изоляции инструментов и независимого согласования. Только корректное разделение возможностей ИИ для принятия решений и фактических разрешений на выполнение позволит компаниям контролировать потенциальные риски при повышении эффективности автоматизации.
Часто задаваемые вопросы
Почему ИИ-агенты имеют больше рисков безопасности, чем обычные чат-боты?
ИИ-агенты могут получать доступ к корпоративным данным, выполнять код или изменять системы через вызовы инструментов. В отличие от чат-ботов, которые только генерируют текст, их ошибки или манипулируемое поведение могут приводить к реальным операционным последствиям.
Что такое вызов инструментов ИИ-агентом?
Вызов инструментов означает, что ИИ-агент запрашивает выполнение операции внешней программой или сервисом в соответствии с требованиями задачи, например запрос к базе данных, чтение файла, вызов API или запуск кода.
Может ли инъекция промптов всегда контролировать ИИ-агента?
Не обязательно. Успех инъекции промптов зависит от архитектуры системы, поведения модели и средств контроля безопасности. Даже если злоумышленник влияет на вывод модели, независимая проверка разрешений может предотвратить неавторизованные операции с инструментами.
Доказывает ли инцидент безопасности Binance наличие уязвимостей у ИИ-агентов?
Нет. Предварительное расследование Binance подтвердило, что путь атаки включал внутренние ИИ-инструменты, однако не раскрыло технических доказательств, достаточных для установления существования уязвимости ИИ-агента или инъекции промптов.
Увеличивает ли MCP риски безопасности ИИ-агентов?
MCP может помогать ИИ-приложениям подключаться к внешним инструментам, однако основные риски безопасности связаны с реализацией инструментов, разрешениями доступа и обработкой недоверенного контента. Надлежащая аутентификация, аудит инструментов и ограничения разрешений могут снизить эти риски.
Как компаниям следует ограничивать разрешения ИИ-агентов?
Компании могут использовать принцип наименьших привилегий, временные учетные данные для конкретных задач, независимое согласование операций, изоляцию в песочнице и аудит вызовов инструментов, чтобы Агенты могли выполнять только явно авторизованные операции.







