Para quienes eligen según la tarea, la clave no es "qué opción es más potente", sino si el fallo perjudica más como una incoherencia fluida o como una desviación de la dinámica. Las secciones siguientes comparan un modelo del mundo con un LLM en objetivos de predicción, datos y evaluación, tareas adecuadas, reglas de combinación e interpretaciones erróneas. Los límites de capacidad se analizan junto con la superinteligencia (ASI), mientras que los límites de implementación se abordan junto con la IA privada.
Puntos clave
- Los modelos del mundo optimizan la dinámica latente o del siguiente estado condicionada por acciones. Los LLM optimizan el siguiente token y la estructura del texto.
- Prefiere los modelos del mundo para la planificación y el control en entornos físicos, y los LLM para redacción, preguntas y respuestas aumentadas con recuperación y llamadas a herramientas.
- Cuando una tarea necesita tanto una interfaz de lenguaje como dinámicas de entorno simulables, combínalos en lugar de tratarlos como sustitutos.
- Los modos de fallo son distintos: los LLM suelen fallar mediante alucinaciones lingüísticas, mientras que los modelos del mundo lo hacen mediante desviación de la dinámica y física simulada incorrecta.
¿Qué es un modelo del mundo?
Un modelo del mundo es un sistema de dinámica aprendida: dado un estado actual (u observación) y una acción candidata, predice cómo cambiará el entorno para que un agente pueda probar movimientos mediante simulación antes de planificar. El eje de decisión más claro es la predicción condicionada por acciones, no la fluidez conversacional.
A diferencia de los sistemas que solo generan texto o apariencia visual, las arquitecturas orientadas a modelos del mundo conectan las predicciones con ciclos de planificación, control o entrenamiento mediante simulación. Las vías habituales incluyen el RL basado en modelos (por ejemplo, Dreamer), la simulación interactiva generativa y la predicción de representaciones al estilo JEPA. Sus objetivos son diferentes, por lo que los nombres de marca no son intercambiables.
¿Qué es un modelo de lenguaje grande?
Un modelo de lenguaje grande (LLM) es un modelo generativo entrenado con grandes corpus de texto cuyo objetivo principal es la predicción del siguiente token. Un LLM destaca en comprensión del lenguaje, resumen, traducción, asistencia de programación y coordinación de texto en varios pasos mediante prompts e interfaces de herramientas.
Un LLM puede describir el mundo físico o redactar los pasos de "qué ocurre si empujas un vaso", pero una descripción no equivale a dinámicas del entorno simulables y evaluables. Sin una interfaz de acción-estado y comprobaciones de ciclo cerrado, tratar un LLM como controlador o motor de física es un error de selección, no un problema de que el modelo sea demasiado pequeño.
¿En qué se diferencian los objetivos de predicción?
La diferencia principal es el objeto de predicción: un modelo del mundo predice el siguiente estado o la dinámica latente después de una acción, mientras que un LLM predice el siguiente token y la estructura del texto. Ambos "predicen", pero no comparten el mismo criterio de éxito.
| Característica |
Modelo del mundo |
LLM |
| Objetivo de predicción |
Siguiente estado o dinámica latente (a menudo condicionada por acciones) |
Siguiente token, texto y seguimiento de instrucciones |
| Vínculo con la acción |
La predicción condicionada por acciones es el eje de decisión |
Normalmente no modela un ciclo de control físico |
| Forma de salida |
Estados, representaciones, trayectorias u observaciones interactivas |
Texto, código, argumentos para llamadas a herramientas |
| Criterios de éxito |
Consecuencias verificables, capacidad de planificación, error rastreable |
Corrección semántica, formato utilizable, citas verificables |
| Fallo típico |
Desviación de la dinámica, física simulada incorrecta |
Alucinación lingüística, citas inventadas |
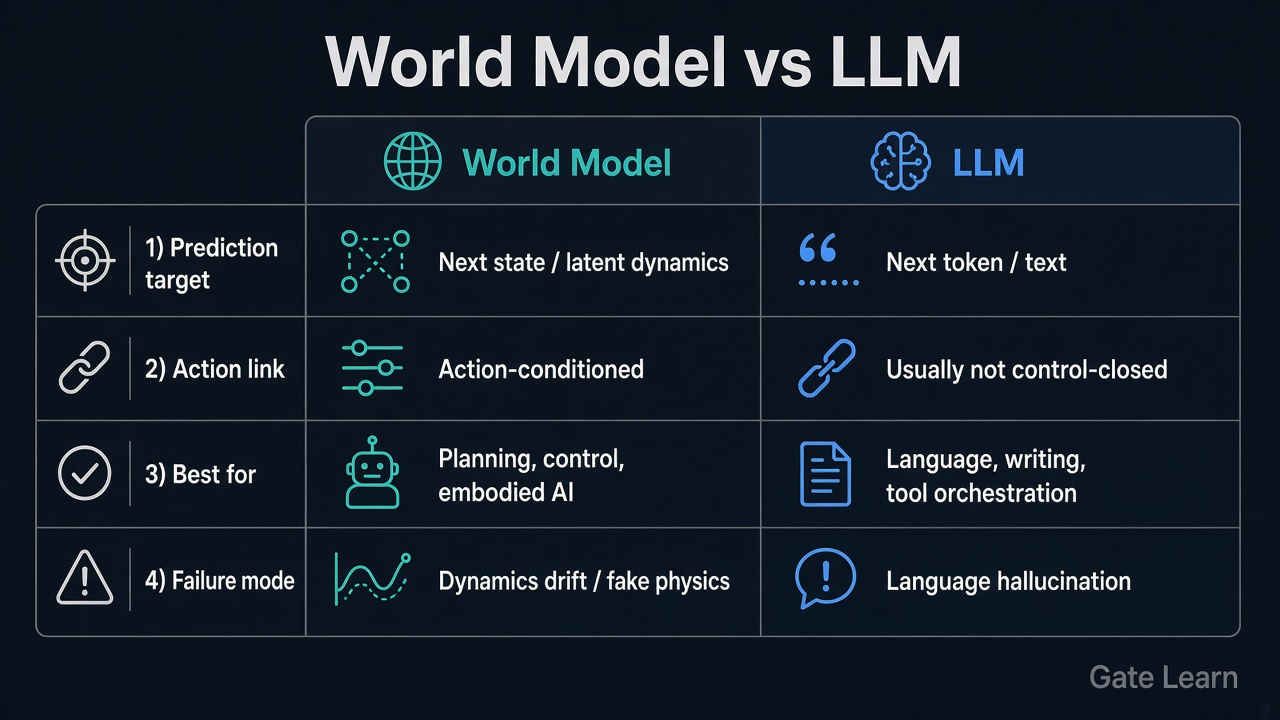
Figura 1. Comparación en cuatro aspectos entre modelos del mundo y LLM: objetivo de predicción, vínculo con la acción, tareas más adecuadas y modo de fallo.
JEPA y los LLM suelen confundirse. JEPA (por ejemplo, I-JEPA de Meta AI) predice representaciones futuras abstractas en un espacio de incrustaciones conjunto y está orientado a modelos del mundo. Los LLM siguen siendo sistemas de modelado del lenguaje. Los nombres similares no implican que sean intercambiables. Consulta el glosario de NVIDIA: modelos del mundo y el análisis de la trayectoria de LeCun (Un camino hacia la inteligencia artificial autónoma).
¿En qué se diferencian los datos, las salidas y la evaluación?
Los datos y la evaluación siguen el objetivo de predicción: los modelos del mundo se apoyan en trayectorias interactivas, transiciones de estado, señales de control y, en ocasiones, vídeo. Los LLM se apoyan en corpus, datos de instrucciones y, opcionalmente, registros de herramientas. El uso posterior determina las métricas de error.
| Dimensión |
Modelo del mundo |
Modelo de lenguaje grande |
| Datos habituales |
Trayectorias de observación-acción-siguiente observación o recompensa (a veces con vídeo) |
Texto, diálogos, código, rastros de herramientas |
| Salidas principales |
Siguiente estado, dinámica latente, trayectorias simuladas |
Texto, respuestas estructuradas, llamadas a funciones |
| Enfoque de evaluación |
Error en varios pasos, éxito de la tarea, robustez OOD |
Corrección, fidelidad, formato y seguridad |
| Problemas difíciles de detectar |
Física simulada incorrecta con apariencia fluida, crecimiento del error a largo plazo |
Alucinaciones fluidas, citas que no superan las comprobaciones |
Usar "redactar un párrafo correcto sobre física" para certificar un modelo del mundo, o "el vídeo se ve bien" para certificar un ciclo de control de un LLM, intercambia el eje de evaluación. Primero define la salida verificable y después elige la familia de modelos.
¿Qué tareas se ajustan mejor a los modelos del mundo? ¿Cuáles se ajustan mejor a los LLM?
Empieza por identificar dónde recae el coste del fallo: física y control, o semántica y comunicación. Prefiere modelos del mundo para lo primero y LLM para lo segundo. Cuando ambos deben cumplirse, usa "se deben combinar" en lugar de forzar un único ganador.
| Condición de la tarea |
Preferir modelo del mundo |
Preferir LLM |
Cuando se requiere una combinación |
| Necesita una predicción explícita de acción → siguiente estado |
Sí |
No |
— |
| Necesita una interfaz en lenguaje natural, generación de documentación o código |
No |
Sí |
— |
| Planificación en entornos físicos, filtrar trayectorias fallidas antes del contacto, como en la conducción autónoma |
Sí |
No (el LLM solo puede explicar) |
LLM para instrucciones, modelo del mundo para dinámicas simuladas |
| Preguntas y respuestas aumentadas con recuperación, redacción, coordinación de herramientas |
No |
Sí |
— |
| Entrenar una política mediante simulación (MBRL) |
Sí |
No |
El LLM puede redactar el texto de la tarea, pero la dinámica sigue necesitando un modelo del mundo |
| Diálogo para objetivos más un ciclo de control ejecutable |
Por sí solo no es suficiente |
Por sí solo no es suficiente |
Se deben combinar: el LLM analiza los objetivos → el modelo del mundo o planificador ejecuta |
"Se deben combinar" refleja una estructura habitual: el LLM se encarga de la intención y la interfaz, mientras que el modelo del mundo (o un simulador con dinámica aprendida) se encarga de predecir consecuencias y filtrar trayectorias. Eliminar cualquiera de las dos partes suele derivar en el modo de fallo de la otra.
¿Cuándo se deben combinar ambos?
Combínalos cuando una tarea incluya tanto un objetivo de la capa de lenguaje como consecuencias de la capa del entorno. No plantees una sustitución. Una cadena típica funciona así: el LLM convierte los objetivos en subobjetivos o restricciones, el modelo del mundo simula acciones candidatas, un planificador elige una trayectoria según el coste y la seguridad, y la ejecución devuelve una nueva observación que actualiza el estado.
La combinación no consiste en "concatenar dos prompts". Las interfaces deben ser explícitas: qué objetivos estructurados genera el LLM, qué acciones acepta el modelo del mundo y cómo el error en varios pasos activa una nueva planificación o una alternativa conservadora. Sin ese contrato, los sistemas parecen "habla fluida, movimiento defectuoso" o "trayectorias atractivas, instrucciones que no coinciden".
La superposición rígida tampoco es adecuada cuando las preguntas y respuestas puras sobre documentos apenas necesitan un modelo del mundo, o cuando el servocontrol de bajo nivel ya dispone de dinámicas fiables y no necesita un LLM general. El valor de la combinación procede de la división del trabajo, no de la cantidad de modelos.
¿Qué errores de juicio y riesgos aparecen al elegir?
Las interpretaciones erróneas más habituales consisten en considerar que "puede hablar sobre física" significa "puede hacer física", y que "fotogramas o trayectorias atractivos" significan "dinámicas planificables". Las familias fallan de forma distinta. Mezclar los controles de aceptación aumenta el riesgo de implementación.
| Modo de fallo |
Más común en |
Cómo se manifiesta |
Riesgo de selección |
Cómo detectarlo |
| Alucinación lingüística |
LLM |
Hechos o citas fluidos, pero incorrectos |
Única fuente de conocimiento o "manual" de control |
Exige procedencia, comprobaciones con herramientas y rechaza afirmaciones sin respaldo |
| Desviación de la dinámica |
Modelo del mundo |
Los pasos cortos funcionan, pero las simulaciones largas se deforman |
Confianza en ciclo abierto durante horizontes largos |
Representa el error frente al horizonte y comprueba la nueva planificación |
| Física simulada incorrecta |
Modelo del mundo |
Trayectorias fluidas que vulneran el contacto o la conservación |
Demostraciones visuales como aceptación de física |
Comprueba penetración, energía y restricciones de contacto |
| Tratar un LLM como simulador |
Desajuste de selección |
La descripción textual sustituye las transiciones de estado |
Tareas en entornos físicos sin ciclo condicionado por acciones |
Solicita la interfaz de acción y el estado simulable |
| Tratar un modelo del mundo como motor conversacional |
Desajuste de selección |
Forzar la predicción de estados en preguntas y respuestas de soporte |
Coste elevado y experiencia lingüística deficiente |
Pregunta si la calidad del texto es la tarea principal |
Las comprobaciones de riesgo deben vincularse a desencadenantes: si la tarea se centra principalmente en la corrección semántica, controla primero la alucinación. Si se centra principalmente en las consecuencias de control, controla primero la desviación y la física simulada incorrecta. Las narrativas sobre capacidades no sustituyen los controles de aceptación.
Resumen
Los modelos del mundo y los modelos de lenguaje grandes resuelven problemas de predicción diferentes: los primeros se centran en las consecuencias de las acciones y en dinámicas planificables, mientras que los segundos se centran en el lenguaje y la coordinación de herramientas. Para seleccionar uno, determina qué parte asume el coste del fallo y utiliza después la tabla de condiciones para un uso individual o combinado.
La predicción de representaciones al estilo JEPA está orientada a modelos del mundo y no es un LLM. En el momento de aceptación, examina la alucinación lingüística por separado de la desviación de la dinámica y la física simulada incorrecta, para que una demostración no pueda ocultar el otro modo de fallo.
Preguntas frecuentes
¿Cuál es la diferencia entre un modelo del mundo y un modelo de lenguaje grande?
Un modelo del mundo predice principalmente el siguiente estado o la dinámica latente después de una acción para la planificación y el control. Un LLM predice principalmente el siguiente token para la comprensión y generación de lenguaje, así como la coordinación de herramientas. Ambos pueden "generar", pero el éxito se mide mediante consecuencias verificables frente a semántica y formato utilizables.
¿Puede un modelo del mundo sustituir a un modelo de lenguaje grande?
Normalmente, no. Un modelo del mundo no proporciona de forma natural una interfaz lingüística sólida ni una coordinación de texto a gran escala. Un LLM no proporciona de forma natural dinámicas simulables condicionadas por acciones. Prefiere los LLM para tareas de lenguaje y añade componentes de modelo del mundo cuando la tarea necesite consecuencias en el entorno.
¿Cuándo se debe usar un modelo del mundo?
Utiliza un sistema orientado a modelos del mundo cuando la tarea deba predecir el siguiente estado a partir del estado y la acción, y después planificar, controlar o probar movimientos mediante simulación. Algunos casos habituales son la planificación en entornos físicos, el RL basado en modelos y la anticipación de consecuencias a corto plazo. La redacción pura o las preguntas y respuestas sobre documentos no suelen ser el uso principal.
¿Cómo se relacionan JEPA y los LLM?
JEPA (arquitectura predictiva de incrustaciones conjuntas) predice representaciones futuras o enmascaradas en el espacio de incrustaciones y pertenece al aprendizaje de representaciones relacionado con modelos del mundo. Los LLM se centran en la predicción del siguiente token. Ambos pueden formar parte de una arquitectura de agentes, pero sus objetivos y métricas son diferentes: JEPA no es "otro LLM".
¿Se pueden usar ambos juntos?
Sí. Para tareas que mezclan instrucciones en lenguaje natural con ejecución en un entorno, a menudo es necesario combinarlos: el LLM analiza objetivos y restricciones, mientras que el modelo del mundo o el planificador predice consecuencias y filtra trayectorias. La clave es una interfaz clara y desencadenantes para volver a planificar, no encadenar ambos en un único prompt.