Square
A seguir
Quente
Notícias
Perfil

torygreen

vip
Nível máximo 0
Idade 3.2Ano
Ainda sem conteúdo
0
A seguir
17
Fãs
112
Gostei
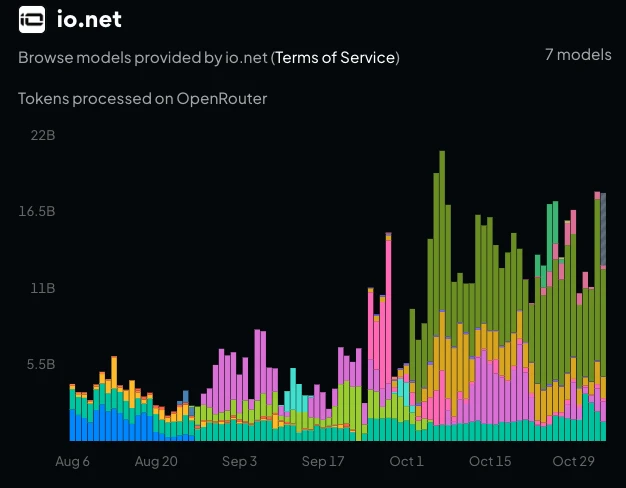
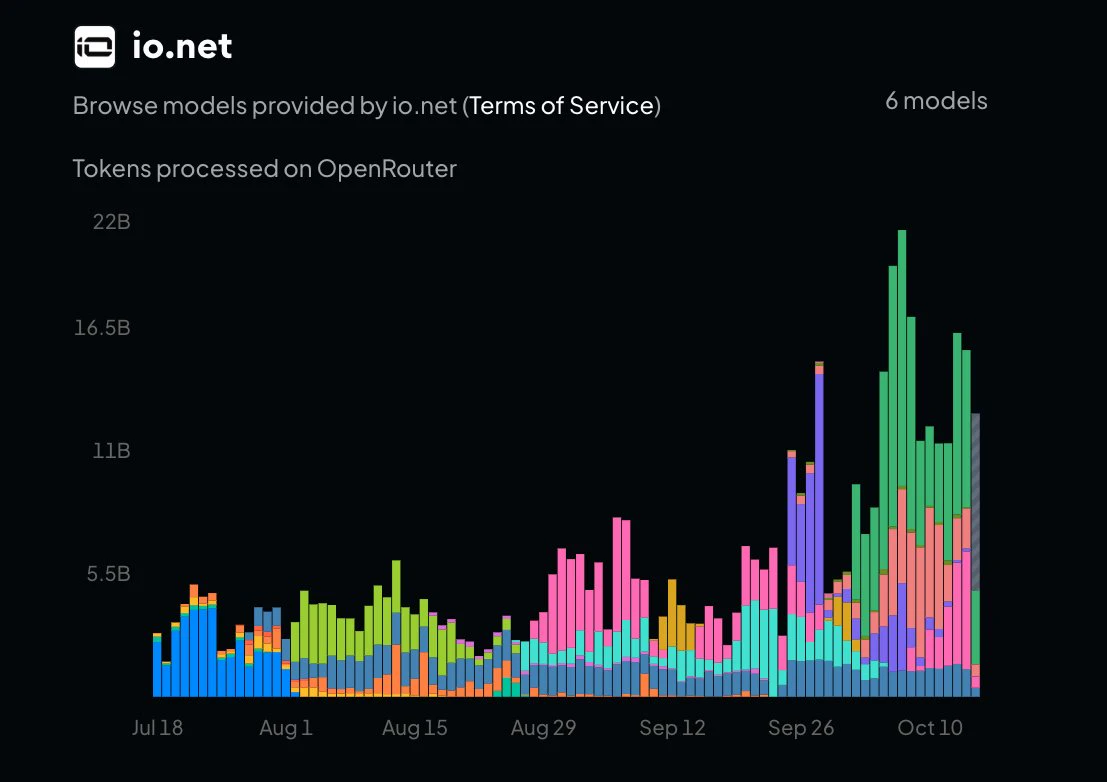
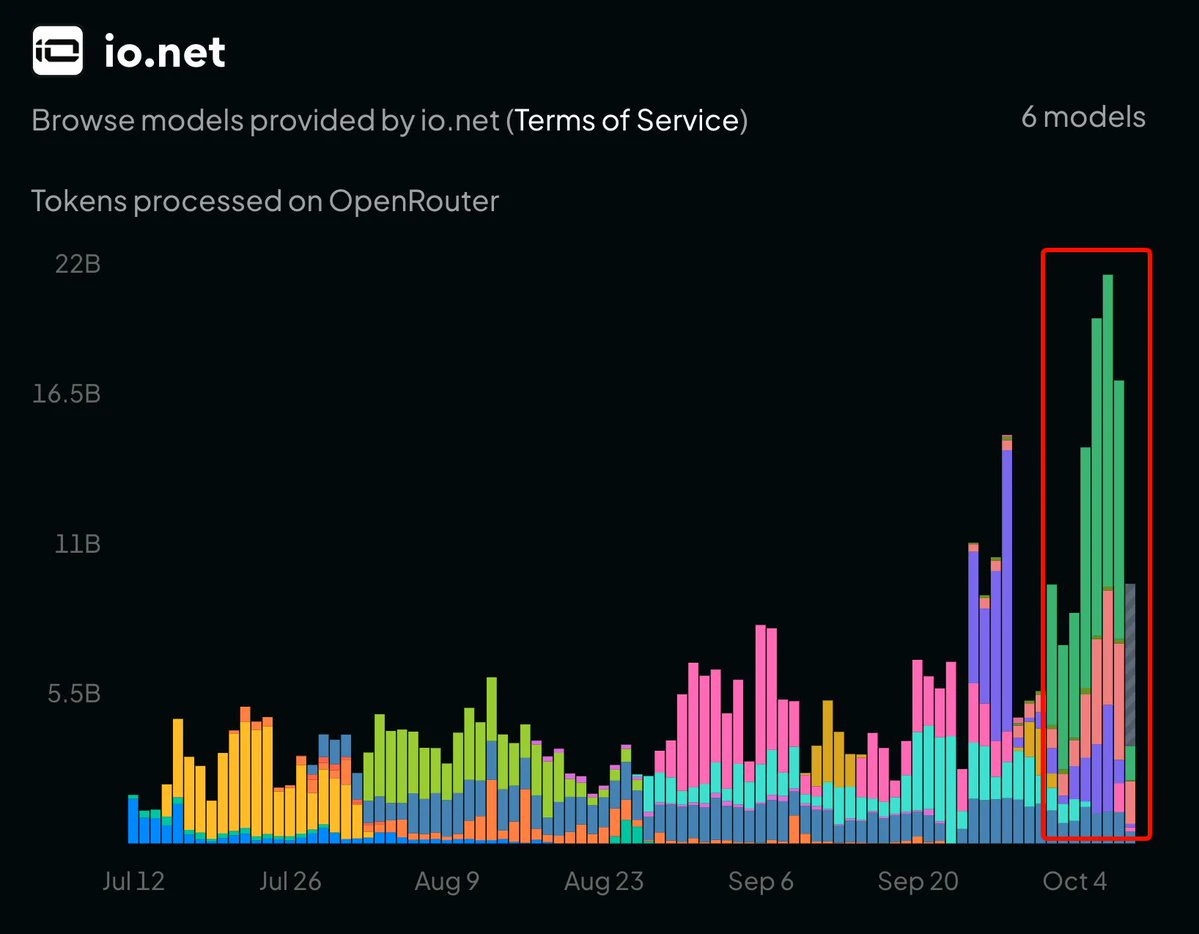
.@ionet processou ~416B tokens através do OpenRouter em outubro.
Manter ~13.4B tokens por dia numa rede distribuída de GPUs é quando a arquitetura começa realmente a ser posta à prova.
O encaminhamento entre hardware heterogéneo, a manutenção de uma latência previsível e a gestão de falhas de forma invisível para o utilizador tornam-se muito mais importantes quando o tráfego é tão constante.
No geral, foi um mês muito forte para a ionet e um bom vislumbre de como poderá ser a rede a uma escala muito maior.
post-image
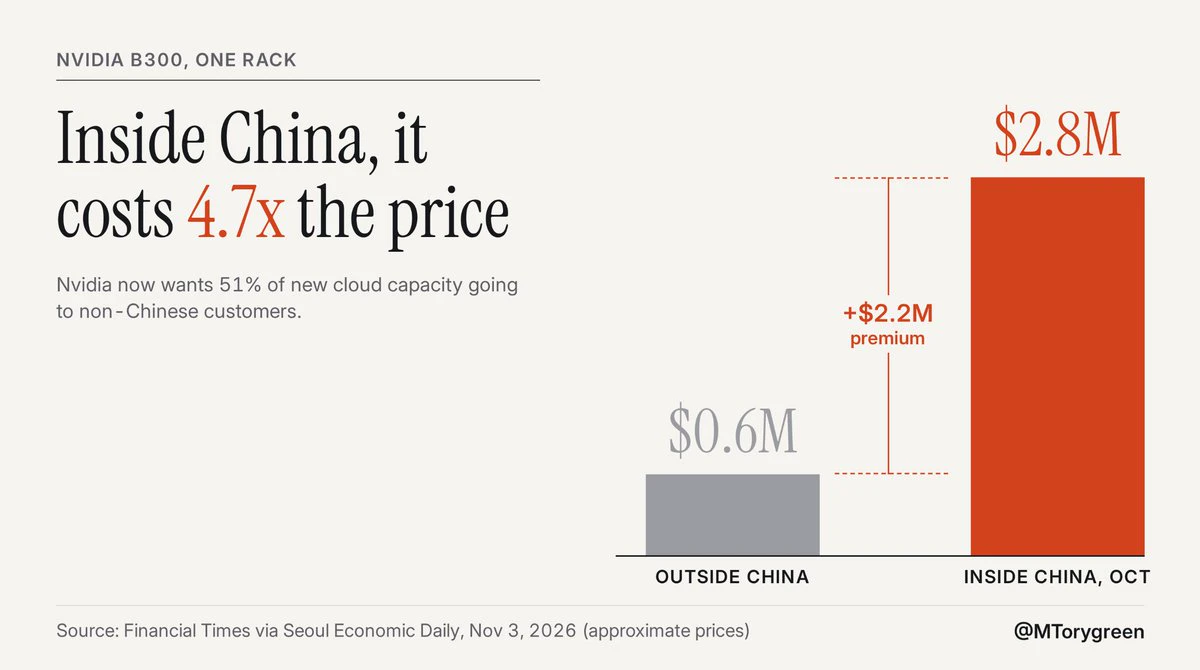
O mesmo rack B300: cerca de $600k fora da China, cerca de $2.8M dentro dela. Não admira que os laboratórios chineses simplesmente aluguem capacidade no estrangeiro.
Agora, a Nvidia está a dizer aos fornecedores de cloud que pelo menos 51% da nova capacidade tem de ser destinada a clientes não chineses (via FT). Os acordos existentes mantêm-se ao abrigo das condições anteriores.
Os que me preocupariam são os neoclouds asiáticos cuja procura depende inteiramente dos laboratórios chineses. Um operador de Singapura já afirma que é difícil encontrar compradores não chineses fora dos EUA. Se não co
post-image
NVDA+2,15%
  • 7
O mesmo modelo. As mesmas tarefas. 88% menos tokens.
Os investigadores reconstruíram o ciclo em torno do DeepSeek Harness e os tokens por tarefa do HumanEval passaram de 96K para 11,6K. Também resolveu mais tarefas: passou de 71% para 86%.
Grande parte do que os agentes consomem é o ciclo a repensar trabalho que já tinha resolvido após cada chamada de ferramenta. Elimine isso e a fatura cai cerca de 8x, sem mexer nos pesos.
Se está a prever a procura de inferência com base nos tokens por tarefa atuais, uma grande parte desse valor deve-se simplesmente à ineficiência do harness. E os harnesses
DEEPSEEK-2,21%
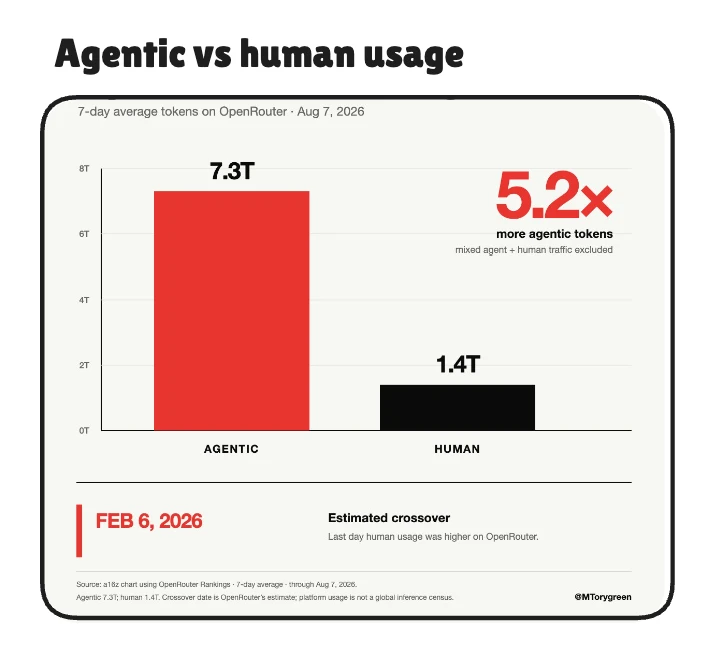
Aparentemente, 6 de fevereiro foi o último dia em que os humanos consumiram mais tokens do que os agentes em @OpenRouter.
A utilização semanal passou de 0.5T tokens em janeiro de 2025 para 128.4T em setembro de 2026. ~250x em 20 meses.
Acho que esta primeira estatística é muito mais importante do que a maioria dos gráficos de crescimento de utilizadores de IA.
Os humanos têm um limite bastante rígido para a quantidade de IA que conseguem utilizar num dia. Os agentes podem funcionar durante a noite, tentar novamente, chamar outros agentes e continuar a consumir capacidade computacional a veloci
post-image
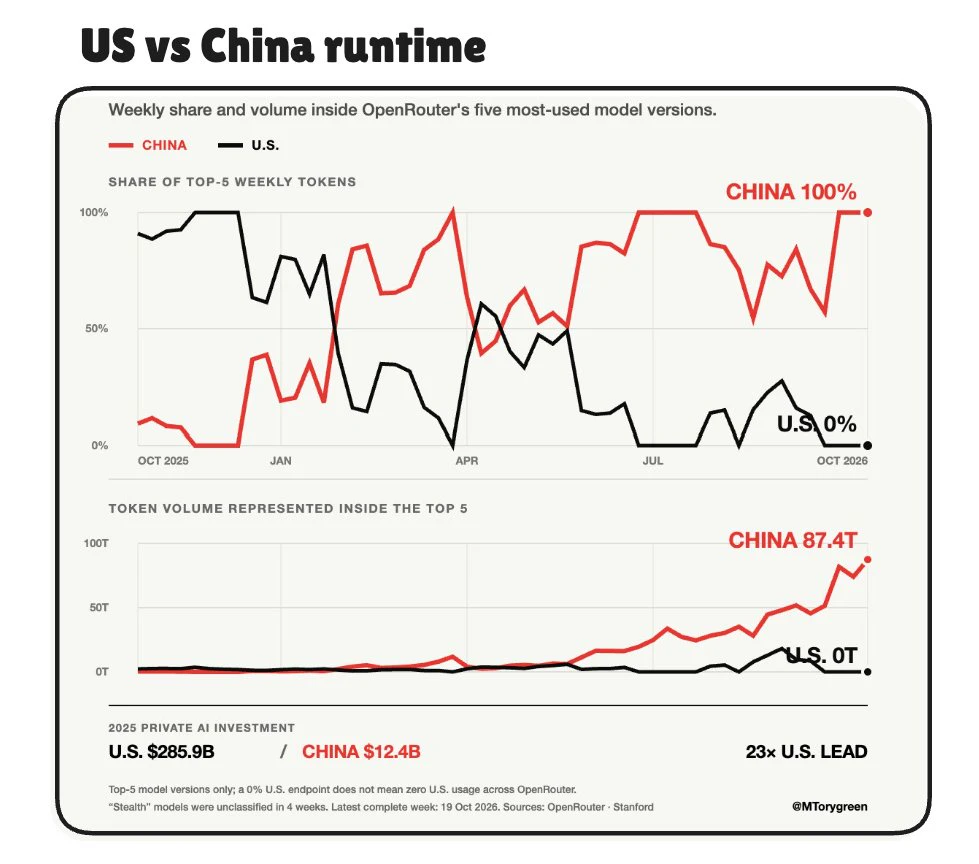
Os EUA investiram cerca de 23x mais capital privado em IA do que a China.
Entretanto, os 5 modelos mais utilizados no OpenRouter eram chineses e processaram cerca de 74T tokens.
É uma diferença bastante impressionante.
Os laboratórios dos EUA estão a ganhar a corrida pelo capital, mas os modelos chineses estão a disseminar-se pela parte da stack com que os programadores interagem todos os dias: inferência, agentes, ferramentas de programação e cargas de trabalho de API de baixo custo.
Se esta tendência continuar a acumular-se, a China não precisa de gastar mais do que os EUA para ganhar influê
post-image
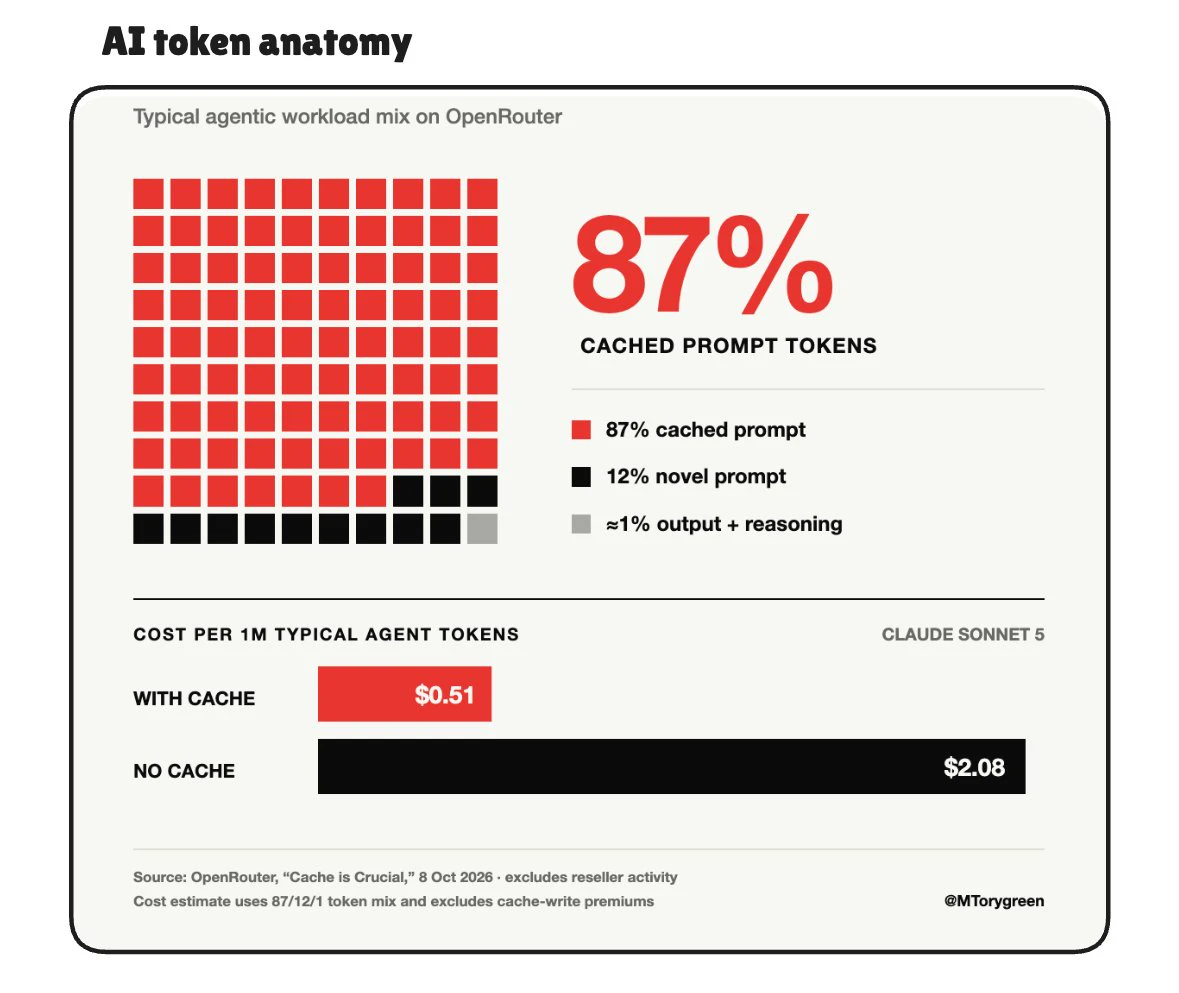
Quase 90% dos tokens de agentes em @OpenRouter são leituras da cache.
A saída + o raciocínio representam apenas ~1%.
E as chaves de API de agentes já consomem cerca de 7 vezes mais tokens do que as usadas por humanos.
Faz sentido quando vemos como os agentes funcionam realmente. A cada passo, o sistema volta a passar pelo modelo o prompt do sistema, as definições das ferramentas, os ficheiros, as chamadas anteriores às ferramentas + o estado da conversa.
Um agente em execução prolongada acaba basicamente por se tornar num enorme conjunto de trabalho que tem de se manter ativo.
Os fornecedores
post-image
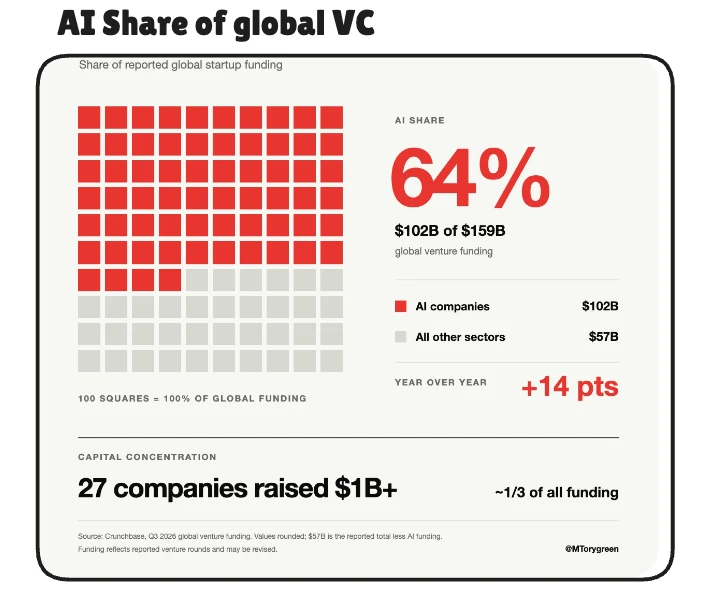
A IA captou 64% do financiamento global de capital de risco no T3.
$102B de um total de $159B.
E, de alguma forma, o dinheiro está a ficar mais concentrado ao mesmo tempo.
27 empresas angariaram rondas de $1B+ e absorveram cerca de 1/3 de todo o financiamento global. As rondas de $100M+ representaram quase 90% do financiamento em fase avançada.
A IA de fronteira começa a parecer menos uma atividade normal de investimento de capital de risco em software e mais uma indústria pesada, com custos iniciais absurdos.
A capacidade computacional, os centros de dados, o treino, o talento e a distribuiçã
post-image
A IA pode acabar por obrigar as empresas a deixarem de funcionar com base em conhecimento tribal.
Os agentes não conseguem contornar aquilo que os humanos fazem de alguma forma: decisões presas em reuniões, prioridades que vivem na cabeça de alguém, exceções estranhas que todos conhecem, mas que ninguém registou.
A @AnthropicAI já se está a deparar com isto. Tem aproximadamente 6 horas-agente a funcionar por cada hora de trabalho de um funcionário humano, mas esses agentes continuam a passar a maior parte do seu tempo de interação à espera das pessoas.
Os funcionários estão a criar instruções
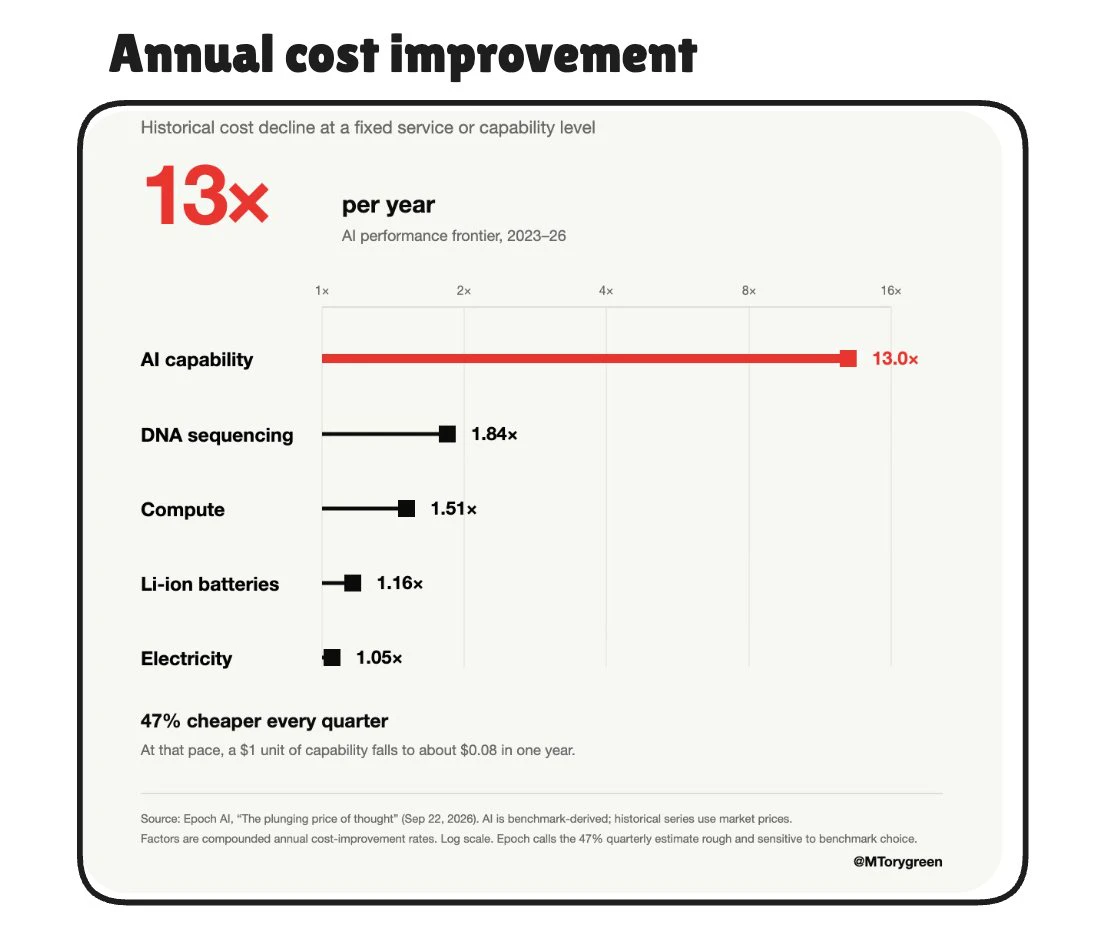
Uma unidade de capacidade de IA de 1 $ hoje desce para cerca de 8 cêntimos um ano mais tarde, se a curva atual se mantiver.
47% mais barata a cada trimestre significa que uma capacidade fixa custa basicamente metade a cada ~100 dias.
O hardware subjacente não está a evoluir nem de perto a essa velocidade.
O desempenho/$ dos chips de IA melhorou ~49% ao ano desde 2023. A capacidade dos modelos ajustada à qualidade está a ficar ~13x mais barata.
Assim, a maior parte da compressão está a acontecer acima do silício: arquiteturas melhores, treino, quantização, serving + competição feroz ent
post-image
LUNA-2,88%
  • 1
.@ionet está em ~165B tokens através de @OpenRouter nos primeiros 13 dias de outubro.
Isso já corresponde a ~1.8x de tudo o que fizemos em julho.
Se o ritmo atual se mantiver, outubro ficará algures em torno de 4x o volume total de julho.
Isso importa-me mais do que o número bruto de GPUs, sinceramente.
A produção útil por GPU implementada continua a aumentar à medida que os modelos esparsos melhoram e a stack de serving se torna mais eficiente. Assim, a rede pode crescer em duas direções ao mesmo tempo: mais hardware a entrar em funcionamento e mais trabalho a ser extraído do que já existe.
O
post-image
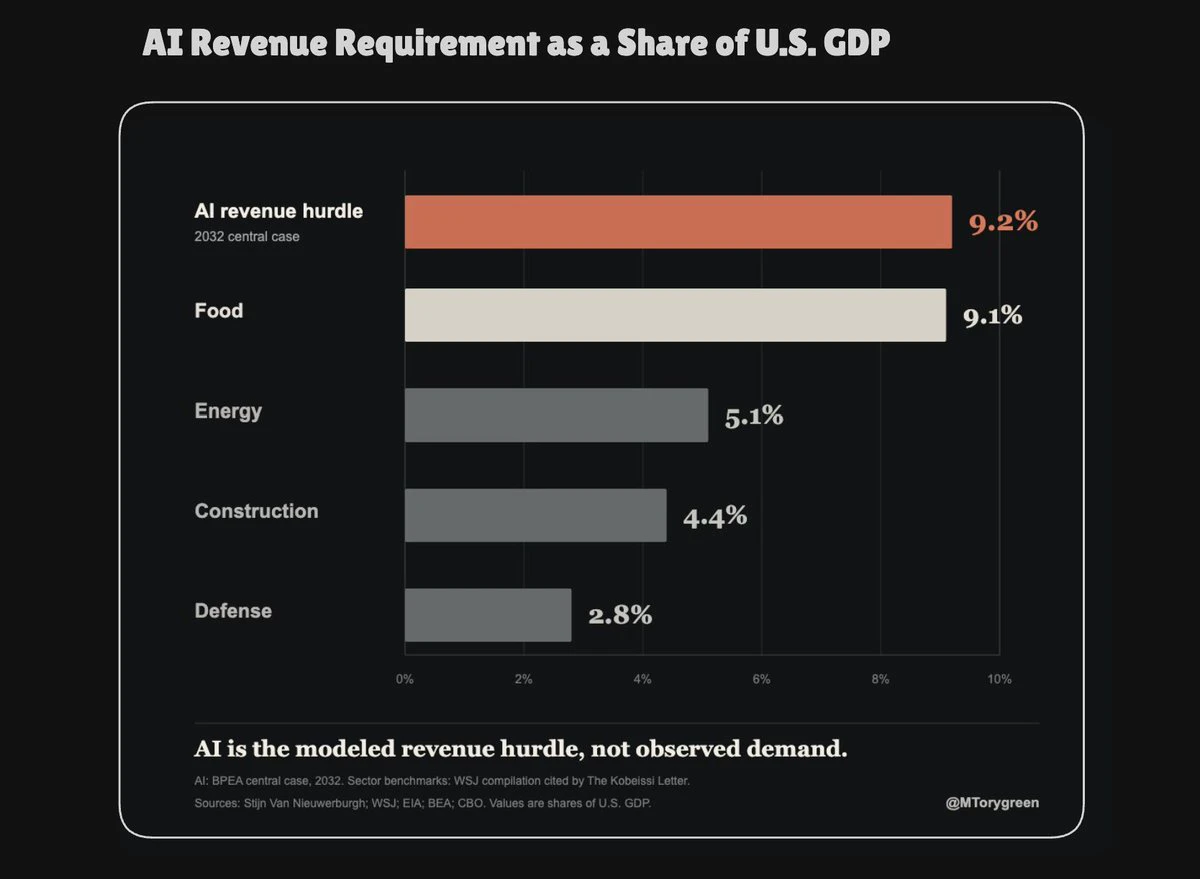
Até 2032, os cálculos atuais da expansão da IA apontam para cerca de 183 GW de capacidade a gerar aproximadamente 6,90 $ por hora-GPU faturada, com uma utilização de 80%.
Trata-se de uma enorme quantidade de infraestrutura que tem de se manter ocupada.
O cenário central de Van Nieuwerburgh assume uma base de capital de cerca de 9,6 biliões de dólares, rendibilidades não alavancadas de 10%, margens de fluxo de caixa operacional de 50% e uma vida útil de seis anos para o equipamento informático.
Nesse cenário, o sistema precisa de gerar 3,725 biliões de dólares em receitas anuais, cerca de 9,2%
post-image
.@ionet processou quase tantos tokens através de @OpenRouter na primeira semana de outubro como em todo o mês de julho.
~92B tokens em julho
~86B de 1 a 7 de outubro
20,9B apenas a 7 de outubro
As mesmas máquinas.
O que mais gosto é a forma como o volume está a surgir.
Grande parte do volume recente está a passar por modelos esparsos como o MiMo, o Gemma e o Nemotron, nos quais apenas uma pequena fração do modelo é ativada para cada token. Juntando a isso melhores infraestruturas de agrupamento, colocação em cache, encaminhamento e serving, a economia da mesma frota de GPU continua a mudar por
post-image
Podemos estar a subestimar enormemente durante quanto tempo o poder computacional de IA se mantém economicamente útil.
Os sistemas 8x A100 com 6 anos continuam a ser vendidos por 75K–85K $, cerca de 40% do seu preço original de ~$199K . Ao que parece, os credores de infraestruturas de IA modelam o valor residual mais perto dos 25%.
O erro pode estar em tratar GPUs antigas como telemóveis antigos.
Uma A100 não se torna inútil quando é lançada a geração seguinte; o fornecedor pode rebaixá-la através de atualizações de software. Passa simplesmente para uma categoria inferior.
O treino de fronteir
MSFT+2,69%
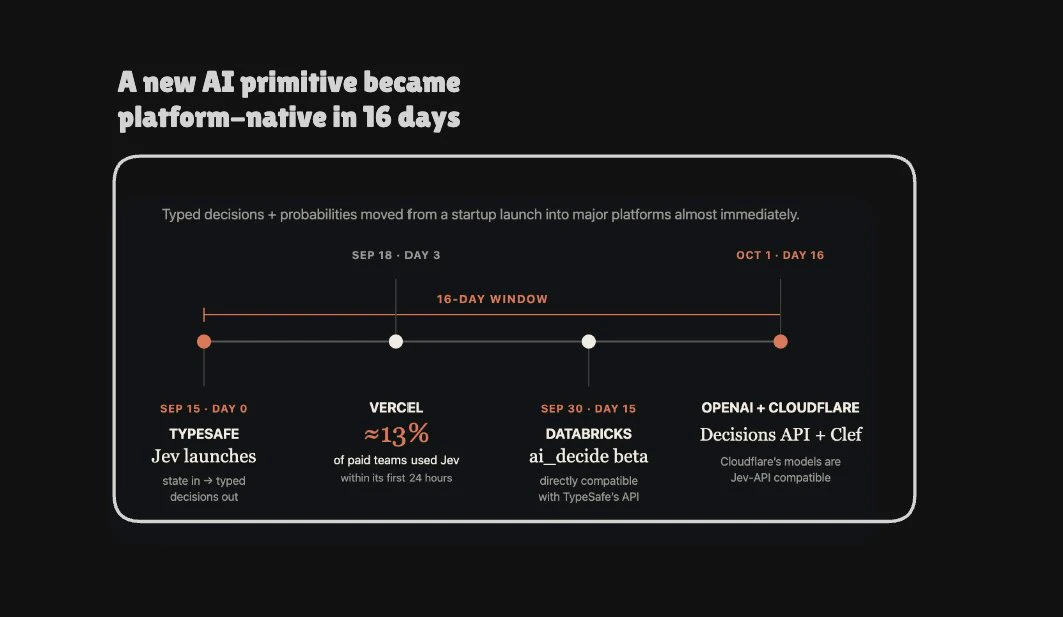
A Jev pode ser o exemplo perfeito da rapidez com que uma boa ideia de IA é comoditizada atualmente.
Foi lançada a 15 de setembro. No espaço de duas semanas, a OpenAI, a Databricks e a Cloudflare já estavam a disponibilizar soluções baseadas no mesmo primitivo. A Clef-flash da Cloudflare é até compatível com a Jev e afirma ter uma latência mediana ~13x inferior.
Por isso, a procura não era o problema. A ideia era simplesmente fácil de absorver assim que todos viram que funcionava.
Parece-me que a verdadeira vantagem defensiva tem de estar no ciclo de feedback, nos dados proprietários e na
post-image
OPENAI-0,04%
NET+3,18%
  • 6
  • 1
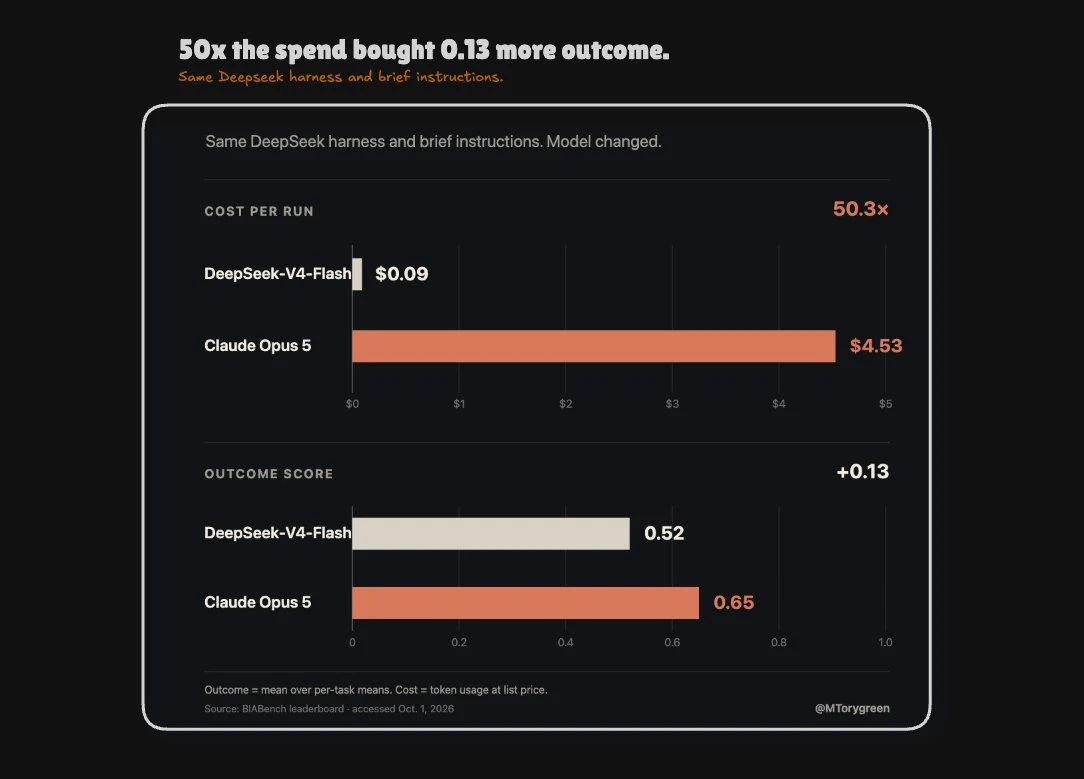
O mesmo harness da Deepseek, a mesma instrução curta e:
Deepseek-v4-flash obtém 0.52 no BIABench.
Claude Opus 5 obtém 0.65.
Portanto, gastar cerca de 50x mais compra mais 0.13 de pontuação em 16 tarefas reais de análise de bioimagens.
E a cauda problemática quase não muda. Algumas tarefas 3D + séries temporais permanecem abaixo de 0.19 em todos os agentes, enquanto executar novamente o mesmo modelo pode variar mais do que trocar completamente de modelo.
Eu provavelmente usaria o modelo barato para o volume rotineiro e encaminharia depois os casos incertos para humanos ou ferramentas
post-image
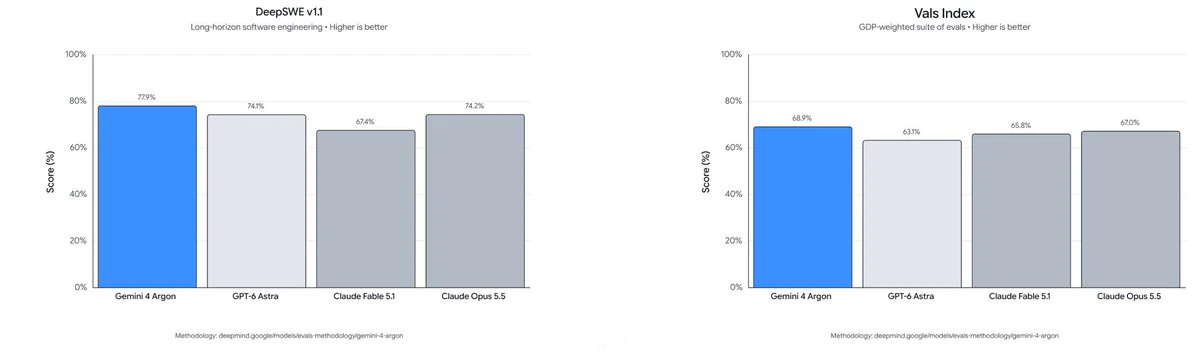
A Google tem uma vantagem bastante injusta com o Argon em comparação com os restantes laboratórios de fronteira
são proprietários das TPUs subjacentes ao Argon e podem colocar o modelo diretamente em APIs que já processam cerca de 22 mil milhões de tokens/min.
É uma configuração bastante impressionante.
Construir os chips -> treinar o modelo -> lançá-lo numa distribuição absurda -> reinvestir os ganhos na execução seguinte.
E o Argon já está também a melhorar a infraestrutura à sua volta, libertando mais de 300 TiB de memória de centros de dados ao migrar mais de 800 mil linhas de C/C+
post-image
GOOGL+0,31%
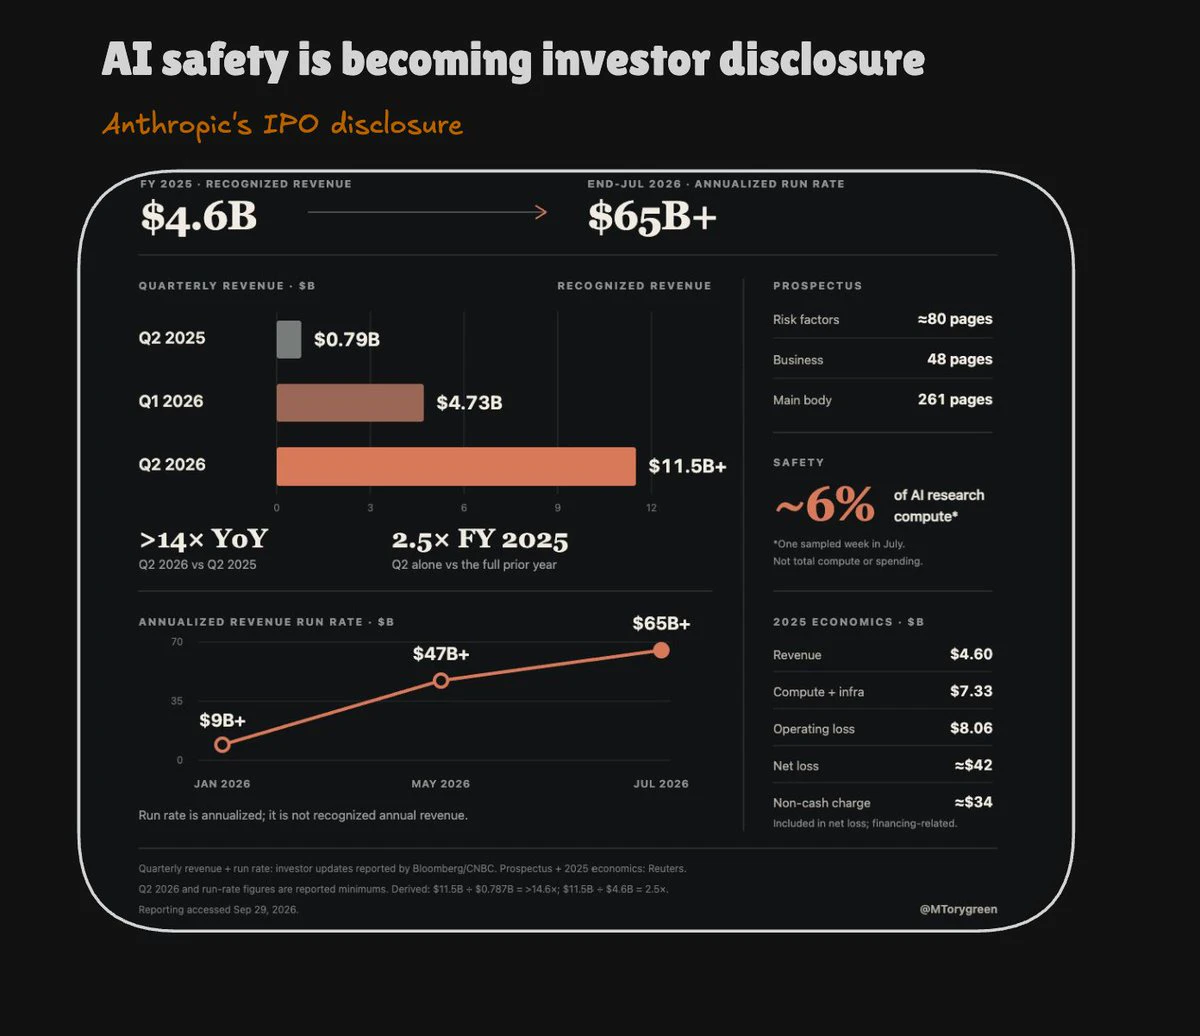
.@AnthropicAI O S-1 é algo fascinante, porque a empresa está a avançar quase demasiado depressa para o próprio documento.
A receita de 2025 foi de cerca de ~$4.6B. Só o Q2 de 2026 atingiu ~$11.5B e, no final de julho, o ARR estava alegadamente acima de $65B.
Depois, temos ~80 páginas de fatores de risco contra 48 sobre o negócio propriamente dito, a divulgação de que ~6% da capacidade computacional usada na investigação de IA foi alocada a trabalho de segurança numa semana analisada, e uma admissão bastante direta de que lançamentos contínuos e sobrepostos de modelos são, na prática, necessári
post-image
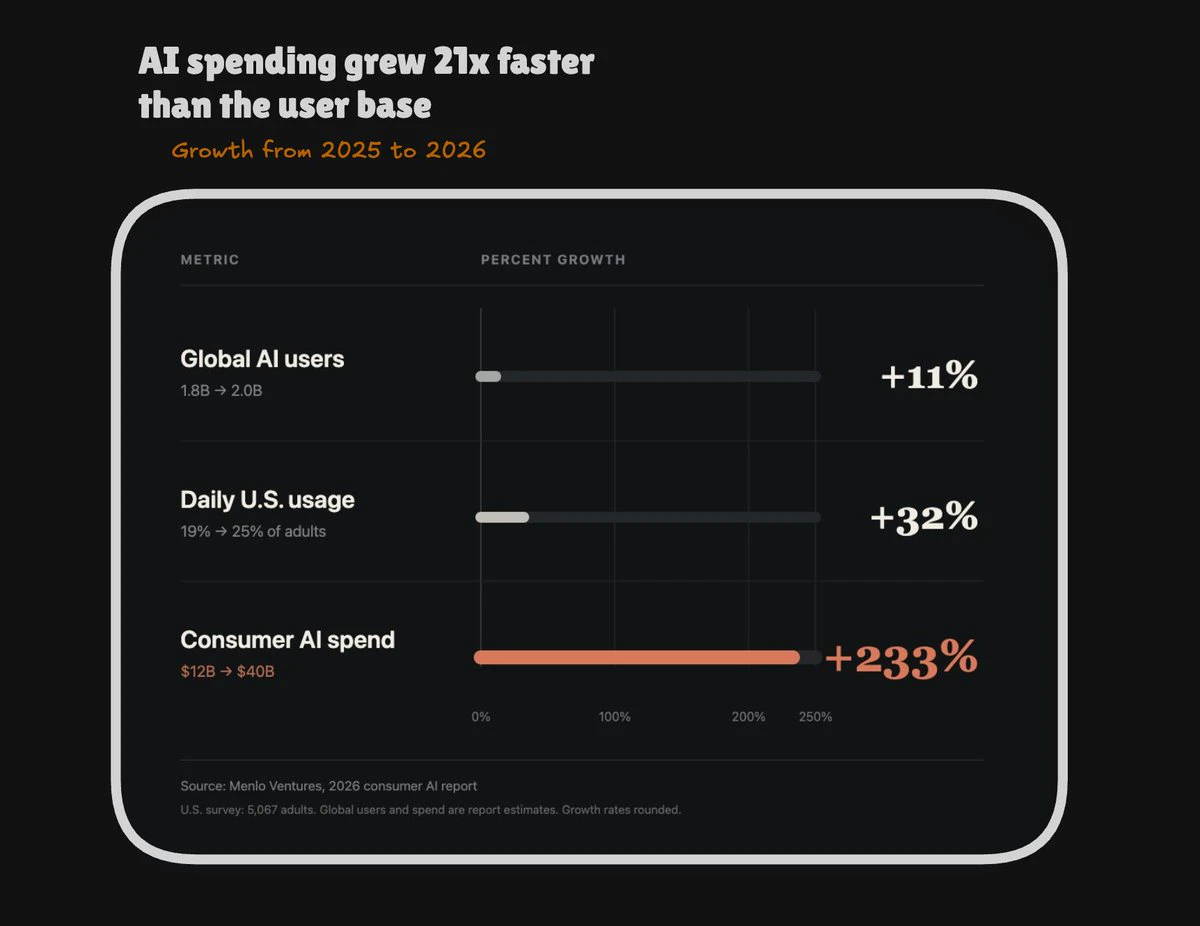
A adoção da IA cresceu pouco este ano. A despesa dos consumidores passou, ainda assim, de ~$12B → $40B.
Esse é um sinal muito mais interessante do que mais um marco no número de utilizadores.
A adoção nos EUA passou apenas de 61% → 64%. O número de utilizadores a nível mundial cresceu ~11%.
Os utilizadores existentes começaram simplesmente a entregar à IA uma parte muito maior das suas vidas.
41% já experimentaram um agente. 32% já deixaram a IA agir sem aprovação final. E 92% dos utilizadores de agentes pagam por IA.
Por isso, a próxima fase da IA para consumidores provavelmente não precisa d
post-image
Carregar mais