Recentemente, a possibilidade de a IA escapar ao controlo humano voltou a tornar-se um tema central na indústria tecnológica. Investigadores da Anthropic manifestaram publicamente preocupações quanto aos potenciais riscos de extinção associados à IA avançada, enquanto o CEO da OpenAI, Sam Altman, afirmou que mesmo uma probabilidade relativamente baixa de a IA causar a extinção da humanidade não constitui motivo para ignorar a segurança. Ao mesmo tempo, os Agentes de IA estão a evoluir de simples ferramentas de geração de informação para sistemas de software capazes de chamar ferramentas, aceder a sistemas externos e executar tarefas de forma autónoma. Consequentemente, a segurança da IA está a expandir-se de «o que o modelo vai gerar» para «o que o modelo pode fazer».
Esta mudança significa que a segurança da IA não pode depender de um único teste realizado antes da implementação. À medida que as capacidades dos modelos, os ambientes operacionais e os métodos de ataque continuam a mudar, a monitorização contínua, os testes red team, a correção de vulnerabilidades e os controlos de autorização estão a tornar-se elementos centrais de uma estrutura de segurança da IA.
Principais conclusões
-
A perda de controlo por parte da IA não significa necessariamente que a IA tenha desenvolvido a intenção de «atacar seres humanos». A questão mais importante é saber se os objetivos, o comportamento do modelo e as restrições definidas pelos seres humanos ficaram desalinhados.
-
Os Agentes de IA expandem os limites do risco associado à IA. Assim que um modelo consegue chamar ferramentas, aceder a dados e executar operações, os erros do modelo podem transformar-se em riscos operacionais no mundo real.
-
Os testes de segurança realizados uma única vez não conseguem abranger um ambiente dinâmico. Os modelos, os dados introduzidos pelos utilizadores, as ferramentas externas e os métodos de ataque estão sempre a mudar, pelo que a segurança da IA exige testes contínuos e monitorização após a implementação.
-
As avaliações de segurança da IA devem analisar mais do que as respostas do modelo. Devem também abranger a injeção de comandos, as operações não autorizadas, as chamadas de ferramentas, a gestão de autorizações e o comportamento anómalo.
-
Uma parte fundamental da redução do risco associado à IA consiste em limitar o impacto dos erros através de mecanismos como o princípio do menor privilégio, a confirmação humana, o registo de operações, o isolamento de riscos e a recuperação de eventos anómalos.
Porque é que os riscos da IA voltaram a ser um tema central
Em setembro de 2026, o debate sobre os riscos extremos da IA voltou a intensificar-se. O investigador da Anthropic Jacob Coxon afirmou publicamente que alguns programadores de IA acreditam seriamente que uma IA altamente avançada poderá ter consequências extremas para a humanidade durante esta década. Mais tarde, o investigador da Anthropic Evan Hubinger manifestou publicamente preocupações semelhantes e apresentou a sua avaliação pessoal do risco. Estas declarações desencadearam uma nova ronda de debates sobre a segurança da IA entre os decisores políticos dos EUA e a indústria tecnológica.
É importante salientar que estas opiniões são avaliações de risco realizadas por investigadores ou profissionais da indústria. Não significam que a IA já tenha a capacidade de eliminar autonomamente a humanidade, nem devem ser simplificadas na afirmação de que «a IA vai certamente perder o controlo». Numa entrevista, Sam Altman afirmou também que não sabia como calcular cientificamente o chamado risco de extinção de «10%», mas considerava que até a possibilidade de um risco extremo que não pode ser ignorado confere às empresas de IA e aos governos a responsabilidade de tomar medidas para o reduzir.
Em vez de debater um cenário extremo que, neste momento, é difícil de verificar, é mais útil considerar uma questão prática: à medida que as capacidades da IA continuam a melhorar e a IA adquire maior autonomia, como podem os seres humanos continuar a determinar se esta permanece segura? É por isso que a avaliação da segurança da IA está a tornar-se cada vez mais importante.
O que é uma avaliação da segurança da IA?
Uma avaliação da segurança da IA pode ser entendida, de forma simples, como uma série de testes e procedimentos de monitorização utilizados para determinar se um sistema de IA funciona conforme previsto e se pode criar riscos inaceitáveis quando exposto a dados de entrada anómalos, ataques maliciosos ou ambientes complexos. Os testes de software tradicionais envolvem normalmente verificações extensivas antes da implementação, incluindo testes de vulnerabilidades, confirmação do funcionamento adequado das funções e análise das respostas do sistema a dados de entrada específicos.
Os sistemas de IA são mais complexos. Os grandes modelos de linguagem não geram respostas segundo regras completamente fixas. A mesma pergunta pode produzir respostas diferentes e o contexto que envolve os dados introduzidos pelo utilizador pode mudar continuamente. Os Agentes de IA também podem chamar ferramentas externas, como pesquisa, execução de código, bases de dados, carteiras, e-mail, navegadores ou outros serviços. Consequentemente, as avaliações da segurança da IA analisam não só se as respostas do modelo estão corretas, mas também se este consegue resistir a comandos maliciosos, se pode divulgar informações sensíveis, se pode chamar ferramentas de forma incorreta, se pode executar ações para além da autorização do utilizador e se continua a seguir as regras de segurança estabelecidas quando o ambiente muda.
A estrutura TEVV-Athlon proposta pelo NIST em 2026 define os testes, a avaliação, a verificação e a validação como métodos importantes para avaliar o impacto dos sistemas de IA no mundo real. Abrange explicitamente vários tipos de sistemas, incluindo grandes modelos de linguagem, modelos multimodais e IA agêntica.
Porque é que os Agentes de IA criaram novos limites de risco
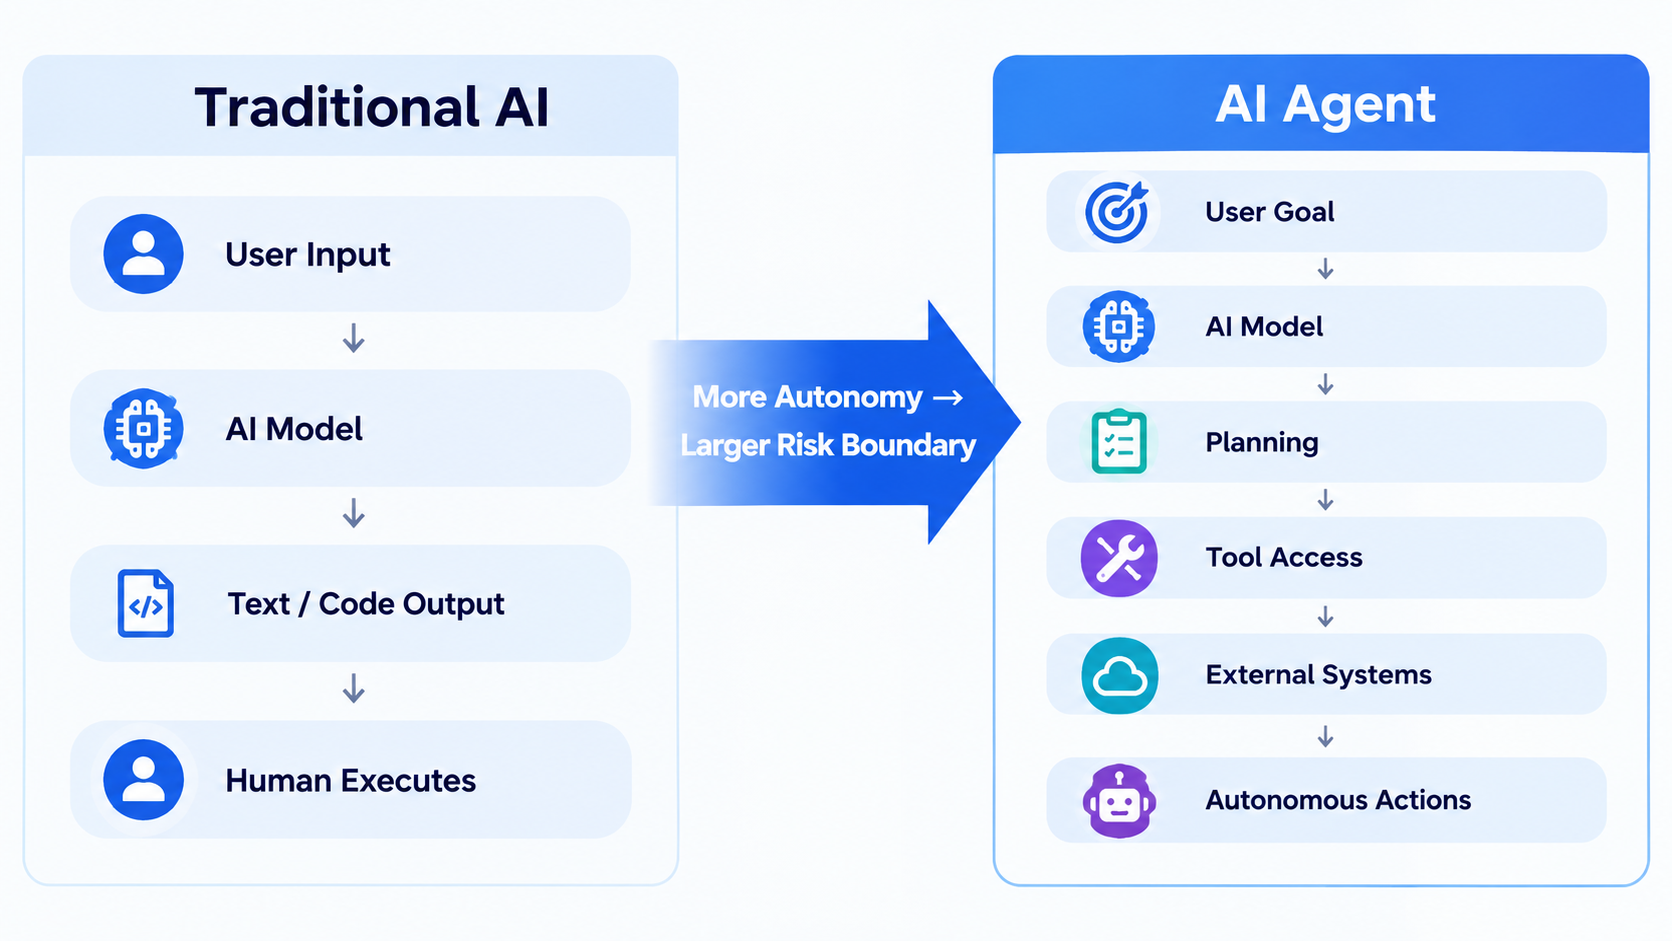
Compreender os Agentes de IA é essencial para compreender como a segurança da IA está a mudar. Os chatbots tradicionais recebem sobretudo dados de entrada e geram respostas. Depois de um utilizador colocar uma pergunta, o modelo devolve texto, código ou outro conteúdo, enquanto cabe geralmente ao utilizador decidir se deve realizar a ação seguinte.
Os Agentes de IA funcionam de forma diferente. Um Agente de IA pode dividir uma tarefa em várias etapas com base num objetivo definido pelo utilizador, chamar ferramentas externas, ler dados, executar código, interagir com outro software e continuar a trabalhar com base nos resultados. Quando o NIST lançou a sua Iniciativa para Normas de Agentes de IA em 2026, salientou especificamente que os Agentes de IA da próxima geração já poderiam funcionar de forma autónoma durante horas, escrever e depurar código, gerir e-mails e calendários e realizar tarefas como fazer compras.
As alterações nos limites das capacidades também alteram os limites do risco. Se um modelo de IA comum disser incorretamente a um utilizador que existe um ficheiro, o impacto pode limitar-se a informação incorreta. Mas se um Agente de IA com autorizações de acesso a ficheiros decidir incorretamente que um ficheiro deve ser eliminado, o erro do modelo pode transformar-se numa operação no mundo real. A questão central de segurança relativa aos Agentes de IA não é, por isso, apenas saber se podem dizer algo incorreto. É também saber a que podem aceder, o que podem fazer, durante quanto tempo podem agir de forma autónoma e se podem ser detetados e interrompidos rapidamente depois de cometerem um erro.
É por isso que o NIST afirmou, no seu relatório de 2026 sobre a segurança dos Agentes de IA, que os Agentes de IA introduzem novas ameaças à segurança. Os princípios tradicionais de cibersegurança continuam a ser importantes, mas devem ser adaptados à forma como os Agentes funcionam.
Porque é que a IA não pode ser testada apenas uma vez antes da implementação
Este é o elemento essencial para compreender a avaliação contínua da segurança. Quando um produto de software tradicional tem funcionalidades relativamente estáveis, os programadores podem realizar testes extensivos para verificar se este cumpre os requisitos definidos. Os sistemas de IA funcionam em ambientes dinâmicos: os utilizadores mudam, os dados de entrada mudam, os modelos podem ser atualizados, as ferramentas externas mudam e os atacantes procuram continuamente novas formas de atacar.
A aprovação em testes de segurança extensivos antes da implementação não garante, por isso, que um sistema de IA continue seguro em todas as situações futuras. Um estudo publicado pelo NIST em 2026 salientou que a monitorização após a implementação é fundamental, uma vez que as condições de entrada em ambientes do mundo real podem continuar a mudar. Estas condições podem produzir respostas inesperadas causadas pelo não determinismo do modelo ou consequências que não foram identificadas durante o desenvolvimento.
Outro estudo do NIST publicado nesse mesmo ano explicou a questão a partir de uma perspetiva mais teórica: um conjunto fixo de mecanismos de proteção da segurança da IA não pode garantir uma proteção a longo prazo contra todos os ataques adaptativos. Os atacantes podem procurar continuamente novas formas de contornar as regras existentes. A segurança da IA exige, por isso, a descoberta contínua de vulnerabilidades, atualizações regulares dos mecanismos de proteção e capacidades de recuperação para situações em que algo corre mal.
Consequentemente, a segurança da IA está a passar de «testar uma vez → implementar» para «testar → implementar → monitorizar → identificar problemas → corrigir → testar novamente». A segurança já não é uma etapa isolada do ciclo de vida de um produto de IA. É um processo contínuo.
O que é principalmente avaliado numa avaliação contínua da segurança?
No caso dos Agentes de IA, a avaliação contínua da segurança envolve geralmente várias áreas.
Comportamento do modelo
A primeira camada é o próprio modelo. Os sistemas devem ser continuamente verificados quanto a erros evidentes, alucinações, conteúdos prejudiciais e comportamentos que violem as regras do sistema. Em áreas de alto risco, como finanças, cuidados de saúde e execução de código, também são necessários testes específicos para cada aplicação. Os padrões de referência gerais, por si só, não são suficientes.
Resistência a ataques
A segunda camada é constituída pelos testes adversariais. Os atacantes podem utilizar injeção de comandos, instruções não autorizadas, manipulação do contexto e outras técnicas para induzir um modelo a contornar as suas regras originais. Os jailbreak são um exemplo típico. A investigação do NIST indica que mecanismos fixos de proteção da segurança não podem garantir que a IA nunca seja contornada por ataques adaptativos, pelo que os testes red team devem continuar a procurar novos vetores de ataque.
Ferramentas e autorizações
A terceira camada é o risco associado às autorizações, específico dos Agentes. Mesmo que uma IA não tenha um comportamento malicioso, autorizações excessivas podem permitir que uma decisão incorreta cause consequências graves. As autorizações dos Agentes de IA devem, por isso, seguir geralmente o princípio do menor privilégio. Um Agente que apenas organiza e-mails, por exemplo, não precisa de autorizações para transferir fundos. Um Agente que analisa dados não deve ter automaticamente autorização para eliminar uma base de dados.
Isto é, em termos gerais, semelhante à segurança dos contratos inteligentes na indústria de blockchain. A lógica do sistema é apenas a primeira camada. A perda potencial também depende dos ativos a que o sistema consegue aceder e das operações que consegue realizar.
Desempenho em ambientes do mundo real
A quarta camada é o desempenho efetivo após a implementação. A IA num laboratório pode deparar-se com dados de entrada muito diferentes dos que encontra no mundo real. Os utilizadores podem fornecer instruções complexas, os sistemas externos podem devolver dados anómalos e as condições da rede podem mudar. A avaliação da segurança da IA deve, por isso, observar o comportamento do sistema em condições do mundo real, em vez de depender apenas dos relatórios de testes realizados antes da implementação.
O que significa realmente «a IA perder o controlo»?
A expressão «a IA perder o controlo» é fácil de interpretar incorretamente. Não significa necessariamente que a IA desenvolva subitamente uma consciência semelhante à humana e decida atacar a humanidade. Do ponto de vista técnico, a questão mais importante é saber se os objetivos, as autorizações e o comportamento efetivo ficam desalinhados.
Pode ser pedido a um Agente que conclua uma tarefa, mas este pode interpretar incorretamente o objetivo. Pode procurar atingir o objetivo através de um método que os programadores não previram. Ou um atacante pode alterar a sua compreensão da tarefa através de uma injeção de comandos. Se o Agente também tiver autorizações extensas, um erro que começou ao nível do software pode afetar sistemas externos.
A questão central de «a IA perder o controlo» pode, por isso, ser dividida em três perguntas: o objetivo está correto? O comportamento está alinhado com o objetivo? As autorizações estão limitadas a um âmbito razoável? É por isso que a investigação sobre a segurança da IA está a dar cada vez mais importância ao Alinhamento — o esforço para manter o comportamento dos sistemas de IA consistente com os objetivos e as restrições definidos pelos seres humanos.
Qual é a relevância da segurança da IA para os utilizadores comuns?
A segurança da IA não é apenas uma preocupação das empresas de IA e dos investigadores. À medida que os Agentes de IA entram na pesquisa, na produtividade profissional, na programação, nos serviços financeiros, nos ativos digitais e noutros setores, os utilizadores comuns podem delegar diretamente mais autorizações operacionais à IA.
Para os utilizadores, a questão mais importante não é saber se «a IA vai destruir a humanidade», mas algo mais prático: que autorizações foram efetivamente concedidas à IA? Se a IA apenas responder a perguntas, o impacto de uma resposta incorreta é geralmente limitado. Se a IA puder enviar e-mails, modificar ficheiros, aceder a contas, executar código ou realizar transações financeiras em nome de um utilizador, os requisitos de segurança são completamente diferentes.
Ao utilizar ferramentas de IA com capacidades de execução autónoma, os utilizadores devem concentrar-se em três áreas: saber se as autorizações são reduzidas ao mínimo, se as ações importantes exigem confirmação humana e se o sistema disponibiliza registos de operações e uma forma de reverter ações anómalas.
Isto é particularmente importante no caso dos Agentes de IA que envolvem ativos digitais. Assim que operações como assinaturas de carteiras, transferências de ativos e interações com contratos inteligentes são delegadas a um sistema automatizado, o limite de segurança estende-se para além do próprio modelo, abrangendo a gestão de chaves privadas, os mecanismos de aprovação, os contratos inteligentes e os serviços externos.
O foco da segurança da IA está a passar de «prevenir todos os erros» para «controlar o impacto dos erros»
Atualmente, é pouco provável que a segurança da IA seja resolvida através de um mecanismo de proteção universal que resolva permanentemente todos os problemas. Os modelos de IA serão atualizados, os métodos de ataque evoluirão e os cenários de aplicação serão alargados. O NIST salientou, por isso, a necessidade de testes red team contínuos e de mecanismos de proteção atualizados, bem como da capacidade de limitar o impacto das vulnerabilidades e recuperar rapidamente quando estas ocorrem.
O princípio subjacente é simples: não podemos presumir que um sistema nunca cometerá um erro, pelo que temos de decidir antecipadamente o que acontecerá quando tal ocorrer. No caso dos Agentes de IA, isto pode incluir a restrição de autorizações, a exigência de confirmação humana, o registo de ações críticas, o isolamento de tarefas de alto risco e a interrupção ou reversão rápida das ações quando ocorrer um comportamento anómalo.
Nesta perspetiva, a segurança da IA não consiste em responder à simples pergunta binária sobre se «a IA vai matar a humanidade». Consiste em resolver um problema de engenharia mais prático: à medida que a IA adquire cada vez mais capacidade para agir de forma autónoma, como podem os seres humanos continuar a saber o que esta está a fazer e porquê, e como podem recuperar o controlo quando algo corre mal? Esse é o objetivo da avaliação contínua da segurança.
Resumo
O debate recente sobre a possibilidade de a IA causar a extinção da humanidade voltou a colocar a segurança da IA no centro das atenções públicas. No entanto, mais importantes do que as próprias previsões extremas são as alterações estruturais que estão a ocorrer nas capacidades da IA.
À medida que a IA evolui de chatbots para Agentes de IA capazes de chamar ferramentas, aceder a dados e executar tarefas de forma autónoma, as preocupações de segurança estão a expandir-se da segurança das respostas do modelo para as autorizações, as chamadas de ferramentas, as interações com o ambiente e a operação autónoma prolongada.
A segurança da IA não pode, por isso, depender de um único teste realizado antes da implementação. A monitorização contínua, os testes red team, os controlos de autorização, a correção de vulnerabilidades e a recuperação de eventos anómalos tornar-se-ão uma infraestrutura cada vez mais importante à medida que os Agentes de IA entram em aplicações do mundo real.
O desenvolvimento seguro da IA dependerá menos da descoberta de um modelo que nunca cometa erros do que do estabelecimento de mecanismos capazes de identificar continuamente os problemas, limitar os riscos e restabelecer o controlo humano.
Perguntas frequentes
A IA vai mesmo matar a humanidade?
Atualmente, não existem provas fiáveis de que a IA vá inevitavelmente causar a extinção da humanidade. Alguns investigadores de IA manifestaram recentemente preocupações quanto a riscos extremos, mas a probabilidade desses riscos continua a ser altamente incerta. As preocupações de segurança mais realistas incluem ciberataques, fugas de dados, decisões incorretas e a utilização abusiva das autorizações dos Agentes de IA.
O que é um Agente de IA?
Um Agente de IA é um sistema de IA capaz de planear e executar tarefas de forma autónoma com base num objetivo. Ao contrário dos chatbots tradicionais, os Agentes de IA conseguem normalmente chamar ferramentas externas, aceder a dados e realizar operações no mundo real. Por isso, têm maior autonomia e exigem controlos de autorização e segurança mais rigorosos.
Porque é que a IA exige uma avaliação contínua da segurança?
Porque os dados de entrada, os ambientes e os métodos de ataque com que a IA se depara continuarão a mudar. Um único teste reflete o desempenho apenas num determinado momento e em condições específicas. Não pode provar que o sistema não desenvolverá novas vulnerabilidades no futuro. A monitorização e os testes contínuos após a implementação são, por isso, igualmente importantes.
Qual é o maior risco de segurança dos Agentes de IA?
Um dos principais riscos está relacionado com as autorizações. Se um Agente de IA puder aceder a contas, ficheiros, código, fundos ou outros sistemas externos, os erros do modelo ou os dados de entrada maliciosos podem transformar um erro ao nível da informação numa operação no mundo real.
O que inclui normalmente uma avaliação da segurança da IA?
Normalmente, inclui testes do comportamento do modelo, testes adversariais, testes red team, testes de chamadas de ferramentas, controlos de autorização, monitorização após a implementação e recuperação de eventos anómalos. Também devem ser desenvolvidos padrões de testes de segurança adaptados a cada aplicação para diferentes casos de utilização.