Posts
Suivis
Populaire
Actualités
Profil

torygreen

vip
Âge 3.1Année
Pic de niveau 0
Aucun contenu pour l'instant
0
Suivis
16
Followers
87
Aimé
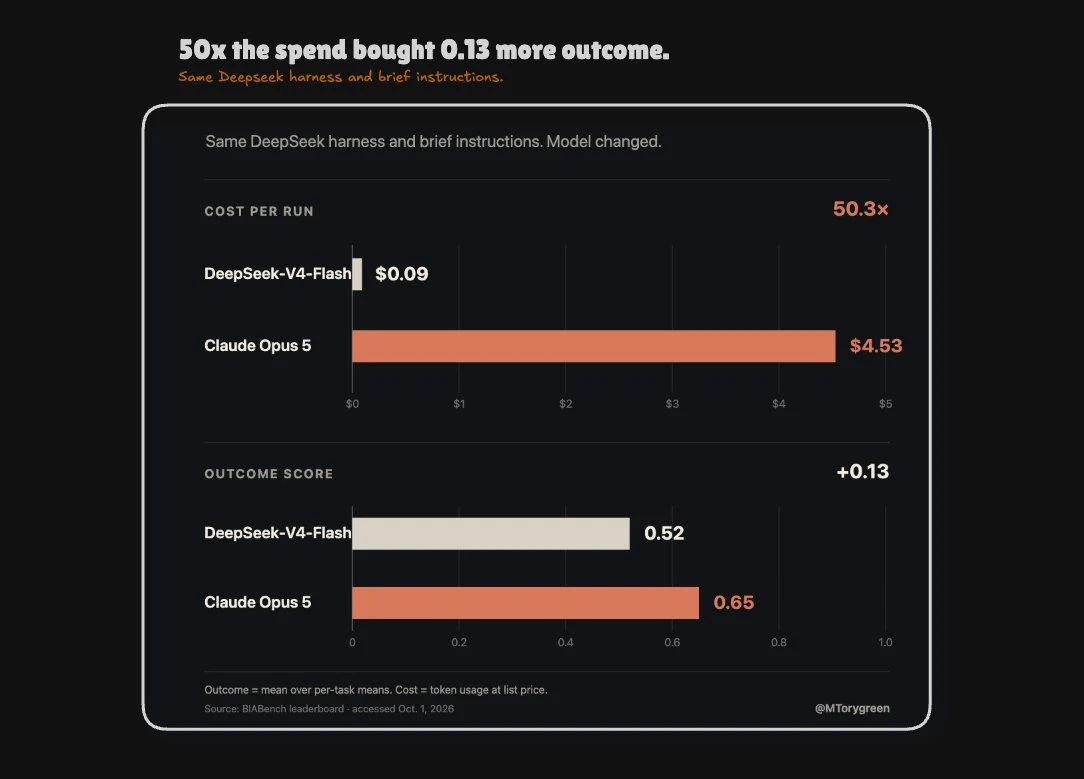
Même banc d’essai Deepseek, même instruction courte :
Deepseek-v4-flash obtient 0,52 sur BIABench.
Claude Opus 5 obtient 0,65.
Ainsi, dépenser environ 50 fois plus n’achète que 0,13 point supplémentaire sur 16 tâches réelles d’analyse d’images biologiques.
Et le bas de la distribution évolue à peine. Certaines tâches 3D + séries temporelles restent sous 0,19 avec chaque agent, tandis que relancer le même modèle peut entraîner une variation supérieure à celle observée en changeant complètement de modèle.
J’utiliserais probablement le modèle bon marché pour le volume courant, puis transmettrais
post-image
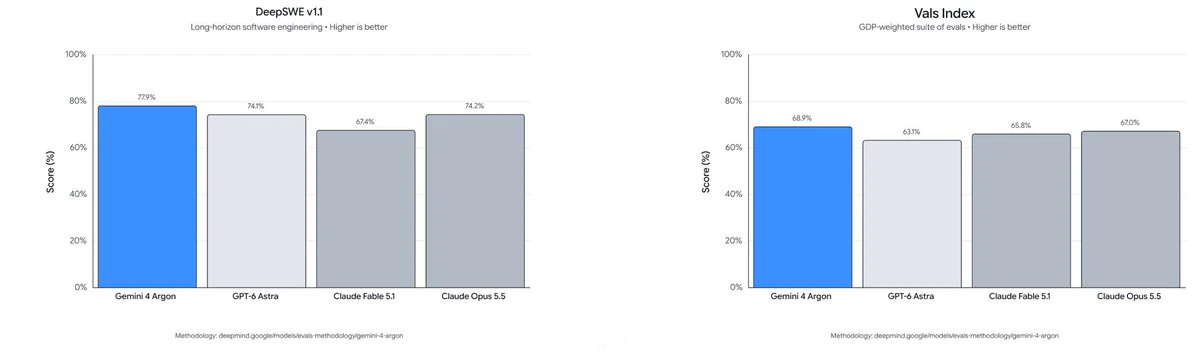
Google bénéficie d’un avantage particulièrement déloyal avec Argon par rapport au reste des laboratoires de pointe
ils possèdent les TPU sous-jacents à Argon et peuvent intégrer directement le modèle dans des API qui traitent déjà environ 22 milliards de tokens/min.
C’est une configuration particulièrement impressionnante.
Construire les puces -> entraîner le modèle -> le déployer dans une distribution démesurée -> réinjecter les gains dans l’itération suivante.
Et Argon améliore déjà la pile technologique qui l’entoure, libérant plus de 300 TiB de mémoire de centre de données en migrant plus
post-image
GOOGL-1,71%
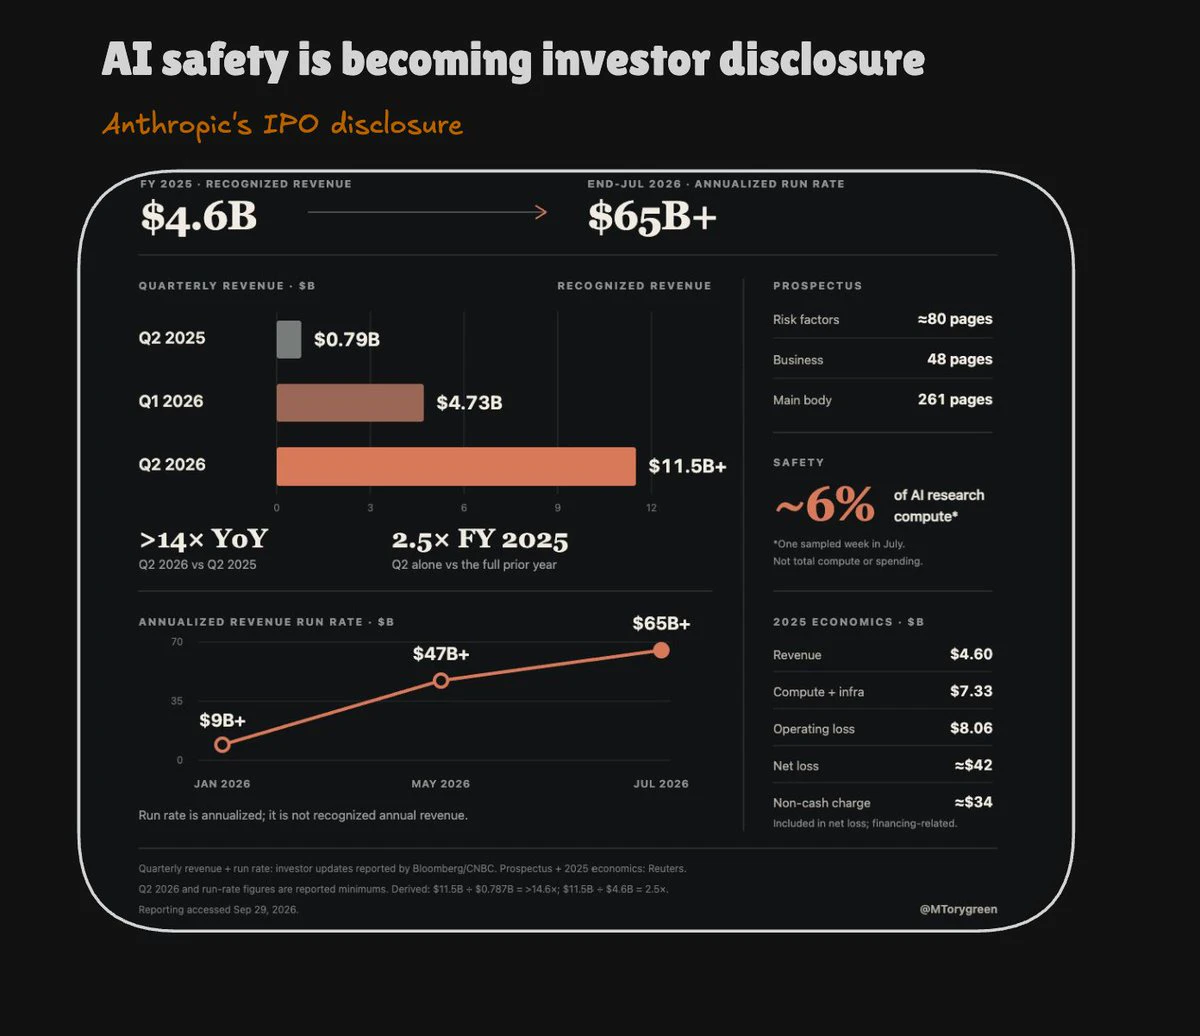
.@AnthropicAI Le S-1 est assez fascinant, car l’activité évolue presque trop vite pour le document lui-même.
Le chiffre d’affaires de 2025 s’élevait à environ 4,6 milliards de dollars. Le seul T2 2026 a atteint environ 11,5 milliards de dollars et, fin juillet, l’ARR aurait dépassé 65 milliards de dollars.
On se retrouve ensuite avec près de 80 pages de facteurs de risque contre 48 consacrées à l’activité elle-même, une déclaration indiquant qu’environ 6 % de la puissance de calcul consacrée à la recherche en IA a été affectée à la sécurité au cours d’une semaine prise comme échantillon, ainsi
post-image
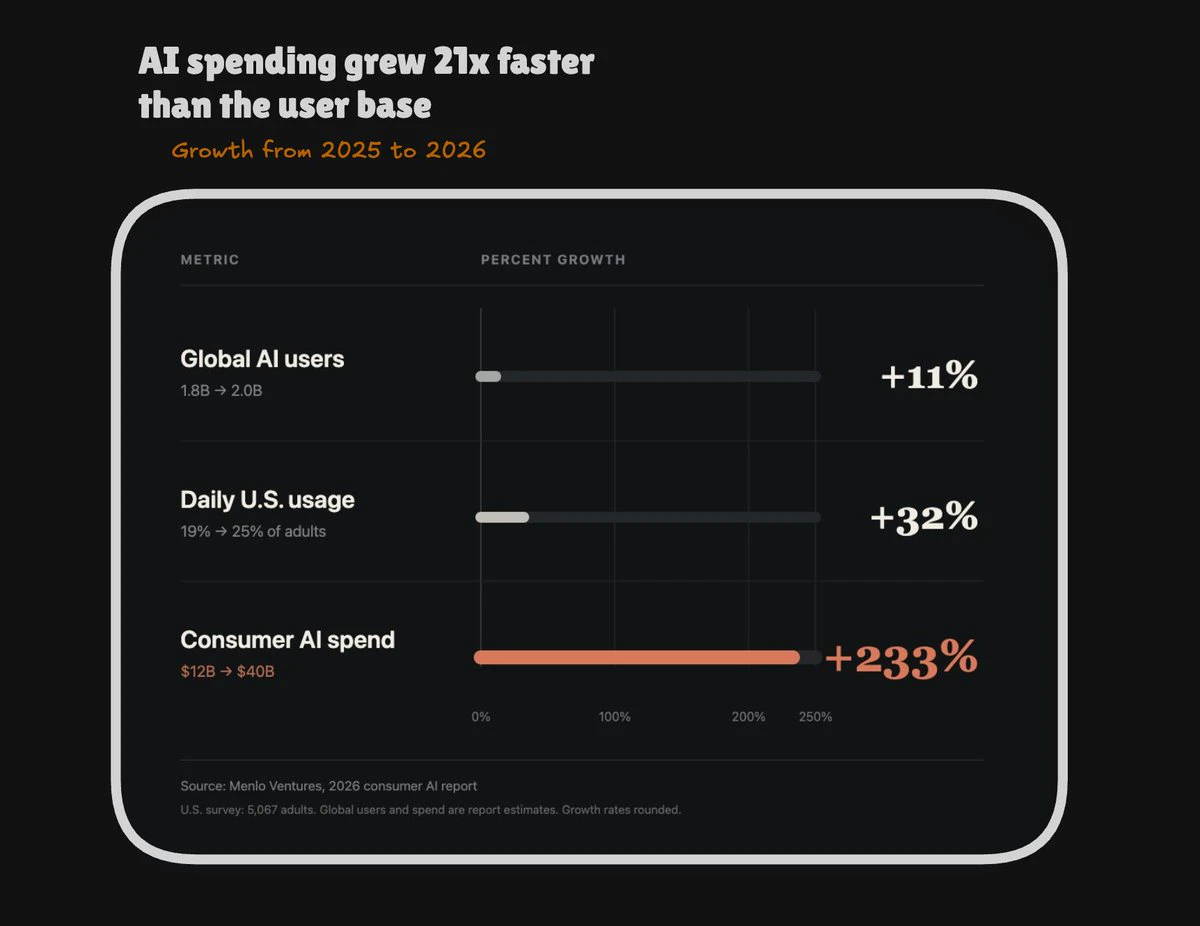
L’adoption de l’IA a à peine progressé cette année. Les dépenses des consommateurs sont tout de même passées de ~$12B → 40 milliards de dollars.
C’est un signal bien plus intéressant qu’une nouvelle étape du nombre d’utilisateurs.
L’adoption aux États-Unis n’est passée que de 61 % à 64 %. Le nombre d’utilisateurs dans le monde a augmenté d’environ 11 %.
Les utilisateurs existants ont simplement commencé à confier bien davantage de leur vie à l’IA.
41 % ont essayé un agent. 32 % ont déjà laissé l’IA agir sans approbation finale. Et 92 % des utilisateurs d’agents paient pour l’IA.
La prochaine p
post-image
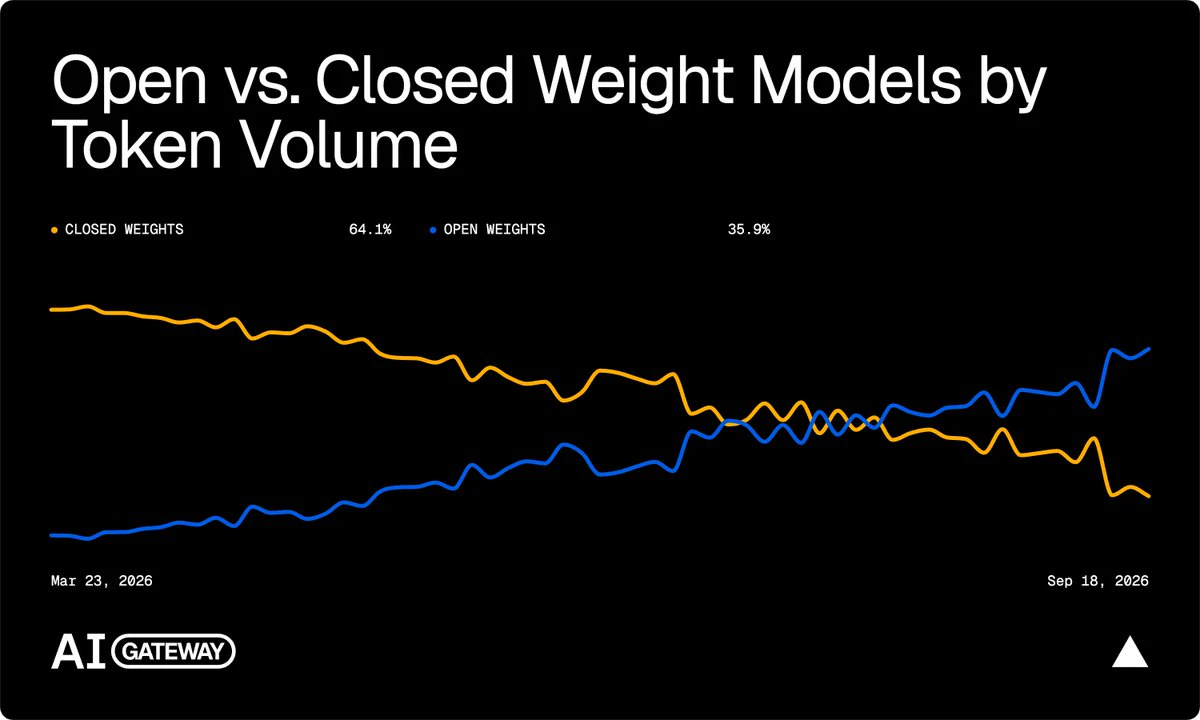
Le « flippening » que nous ne pensions pas voir arriver si tôt.
Les modèles à poids ouverts commencent à ressembler fortement à une production électrique de base pour l’IA.
Pour l’instant, ils ne surpassent pas franchement le meilleur modèle fermé. Mais ils sont suffisamment proches et performants pour l’immense quantité de tâches qui ne justifient pas les tarifs des modèles de pointe.
Astra, Opus, Fable, etc. deviennent alors davantage des centrales de pointe : une capacité coûteuse qu’on ne mobilise que lorsque la tâche le justifie réellement.
Si cela continue, les modèles à poids ouverts po
post-image
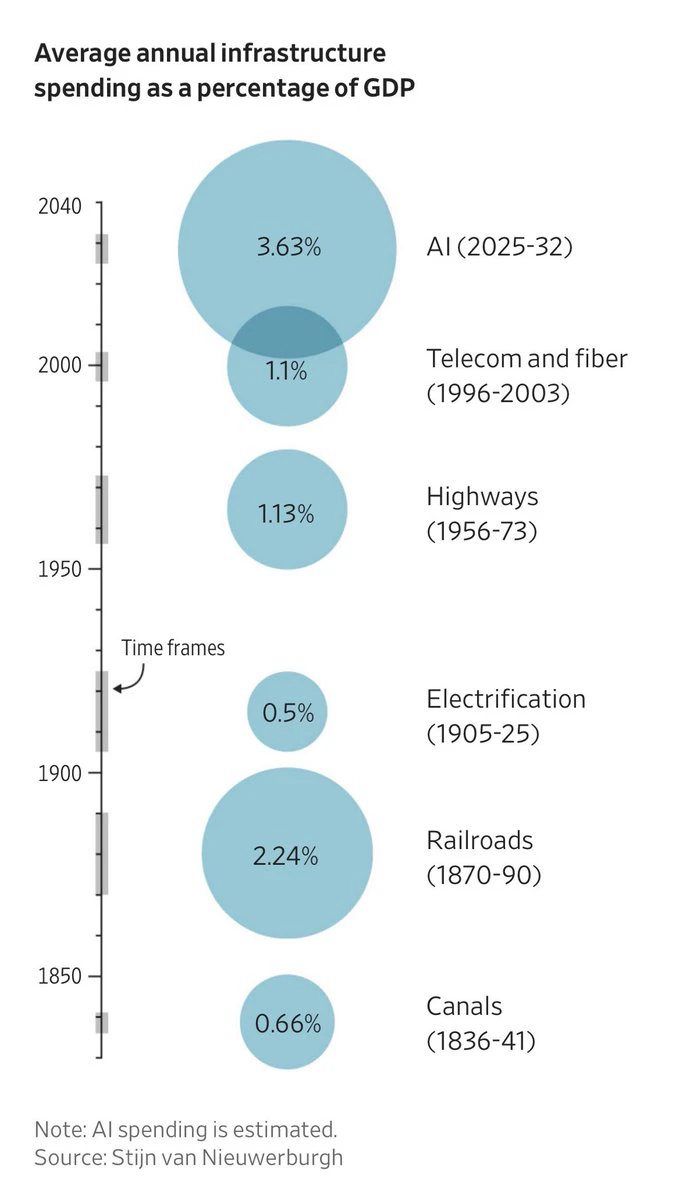
Nous avons passé des décennies à rendre les logiciels moins physiques, et l’IA est en train d’inverser rapidement la tendance.
Les estimations actuelles indiquent que le déploiement de l’IA aux États-Unis absorbera environ 3,63 % du PIB chaque année de 2025–32, soit environ 10,3 billions de dollars au total.
> Les chemins de fer représentaient en moyenne 2,24 %.
> Les autoroutes, 1,13 %.
> Les télécommunications + la fibre, 1,1 %.
Cela représente une quantité proprement démesurée de béton, de cuivre, d’énergie, de GPU et de systèmes de refroidissement construits pour l’intelligence.
La compara
post-image
XCU-0,96%
POWER-1,03%
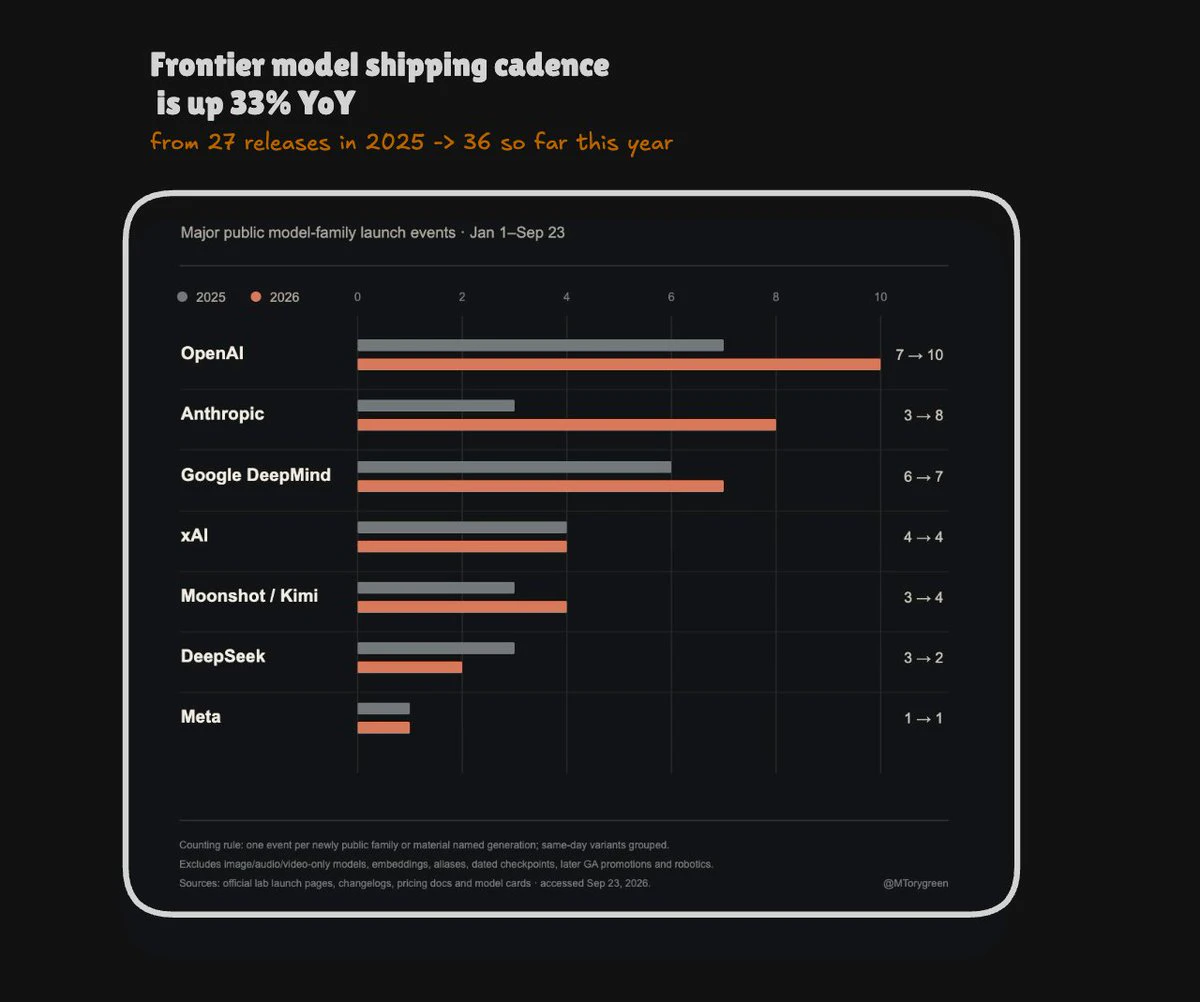
Les modèles de pointe ont à peine le temps de devenir la référence avant que leurs propres variantes moins chères n’apparaissent et ne commencent à absorber la charge de travail.
36 lancements majeurs de familles de modèles d’ici au 23 septembre de cette année, contre 27 pour les mêmes sept laboratoires l’an dernier.
Les écarts de prix s’élargissent tout aussi vite. @AnthropicAI a fait passer la tarification des modèles de classe Opus de 15/75 dollars par million de tokens à 4/20 dollars.
@OpenAI s’étend désormais de Luna à 0,10/0,50 dollar jusqu’à Astra à 10/50 dollars.
Cela produit quelque c
post-image
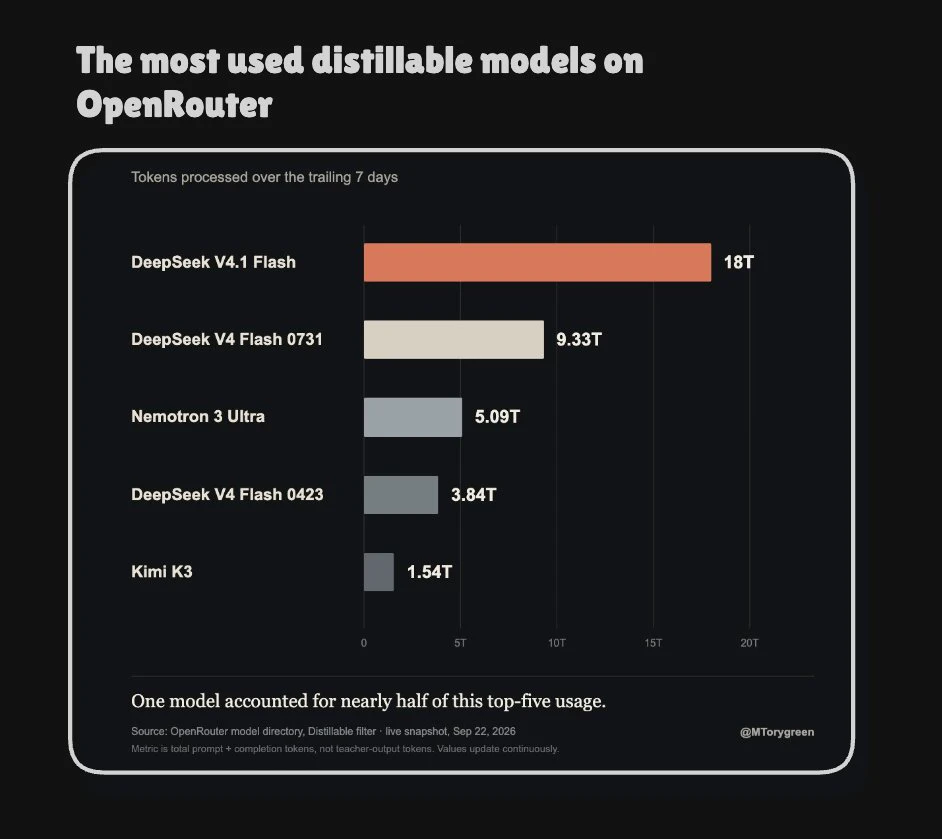
Il y a un autre moteur à « open models » dont on parle à peine.
DeepSeek V4.1 Flash a fait ~18 billions de tokens sur OpenRouter la semaine dernière, et ses sorties peuvent explicitement être utilisées pour la distillation.
Donc le modèle peut faire deux tâches en même temps :
tourner en production dès aujourd’hui, puis devenir des données de type enseignant pour tout ce que quelqu’un entraînera demain.
OpenAI + Anthropic, c’est compréhensible, bloquent cela pour les modèles concurrents.
Mais cela signifie que chaque modèle permissif largement utilisé diffuse aussi une partie de ses capacités
post-image
  • 1
Xiaomi vient de publier quelque chose que les laboratoires gardent habituellement enfoui : la véritable facture du RL.
MiMo-V2.6 Pro et Flash ont tous deux été entraînés sur 753 000 échantillons et se sont arrêtés à l'étape 30.
> Pro a coûté 2,62 millions de dollars.
> Flash a coûté 854 000 dollars.
Ces dépenses supplémentaires, 3,1 fois plus élevées, ont rapporté 6,89 points sur DeepSWE.
Puis Flash a quand même devancé Pro sur AutomationBench.
On voit déjà la même architecture de produit apparaître partout désormais : un modèle pour les tâches les plus difficiles, et un autre juste en dessous
DEEPSEEK-1,62%
  • 6
  • 1
Les heures de GPU pourraient devenir un risque contre lequel on se couvre.
La CFTC explore déjà les dérivés sur la puissance de calcul, et Liquid Compute vient de lever $15M pour créer un marché réglementé de contrats à terme, d’options et de swaps sur les GPU.
Cela a du sens si la puissance de calcul dédiée à l’IA passe réellement d’environ $360B en 2025 à environ 2,3 billions de dollars d’ici 2030.
La partie étrange, c’est la standardisation.
Une heure de H100 dans une région n’est pas le même produit qu’une heure de B200 ailleurs, avec des réseaux, des coûts énergétiques et une taille de
post-image
H100-0,37%
B200-0,77%
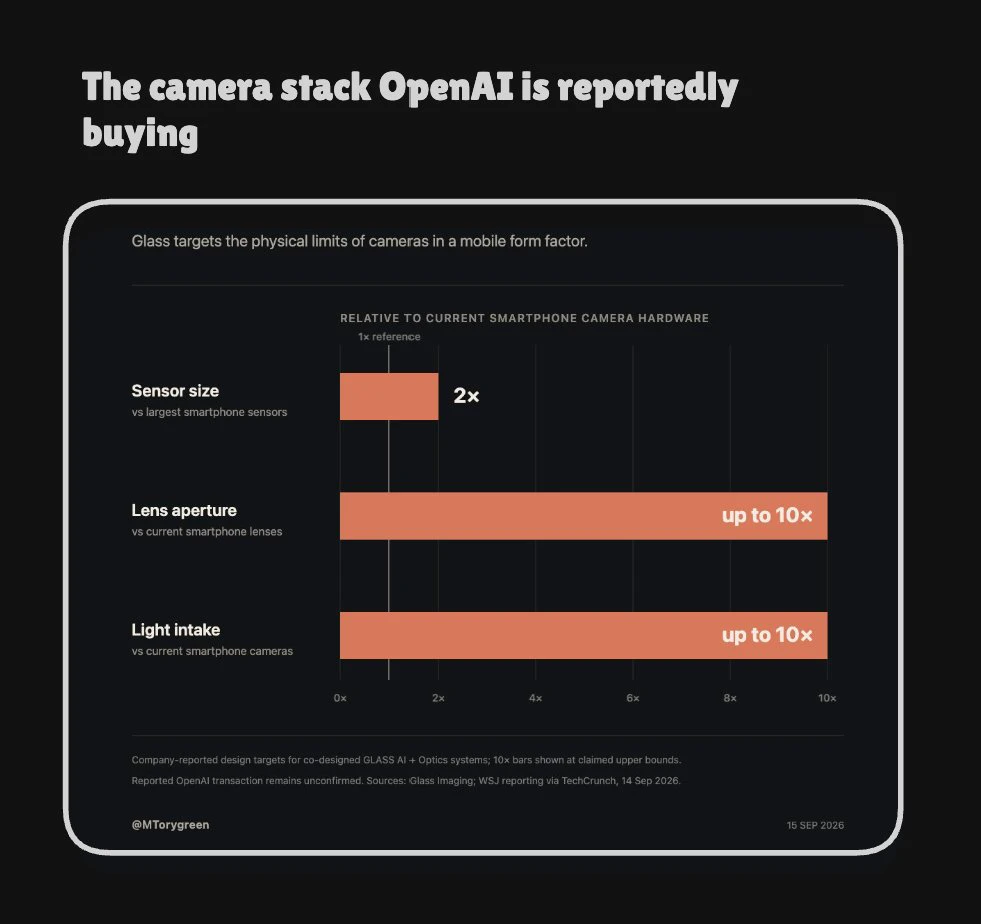
.@OpenAI a dépensé 6,5 milliards de dollars pour constituer l’équipe dédiée aux appareils et pourrait maintenant dépenser plus de 300 millions de dollars supplémentaires pour la partie qui décide de ce que le modèle peut voir en premier lieu (imagerie de Glass).
Glass fonctionne sous l’application appareil photo, directement sur les données brutes du capteur. Son système mobile proposé utilise un capteur environ 2 fois plus grand que les plus grands capteurs de smartphones actuels et promet de capter jusqu’à 10 fois plus de lumière.
Pour un assistant toujours actif, cela compte beaucoup.
Tout
post-image
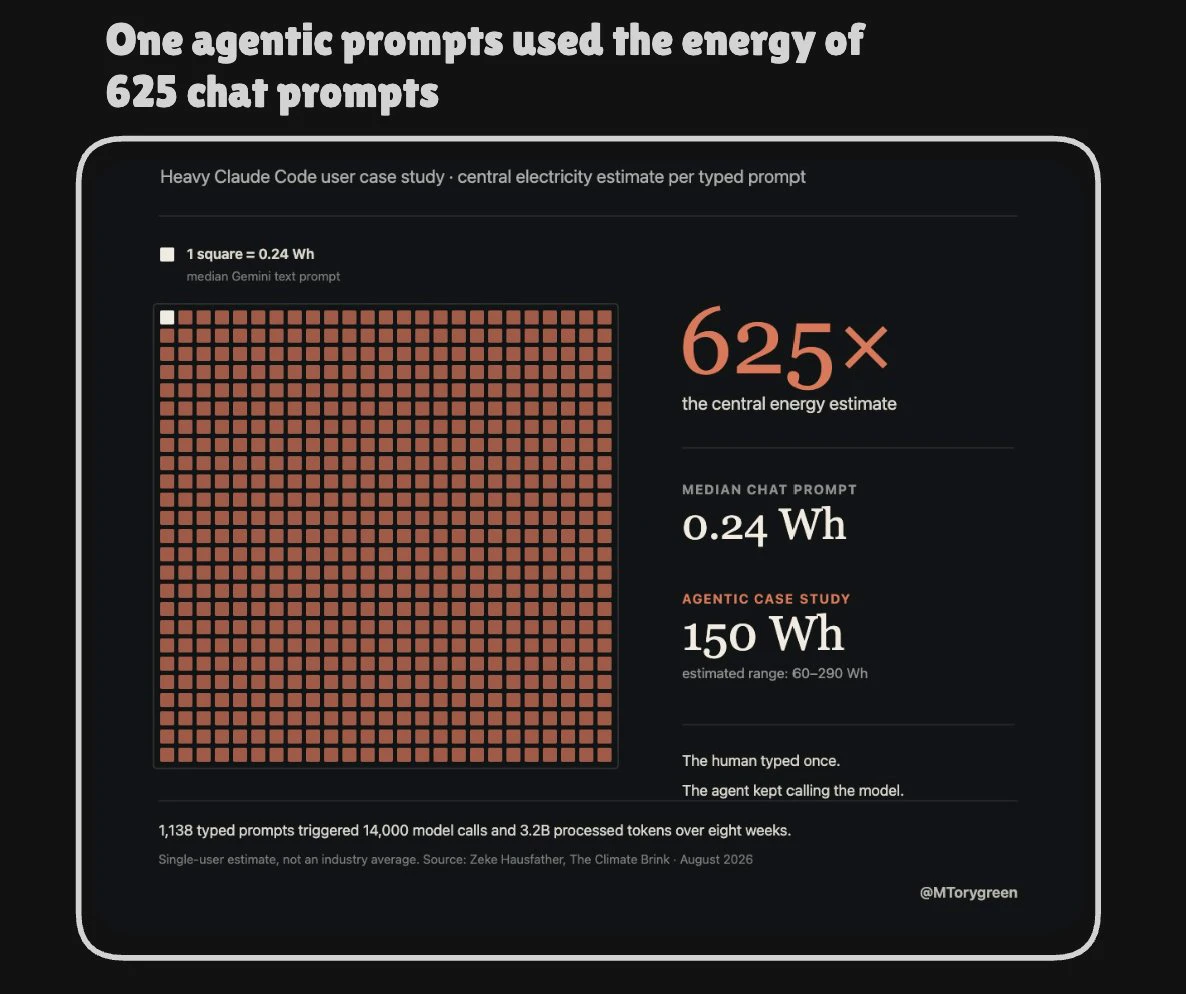
Le nombre de requêtes est sur le point de devenir un indicateur indirect assez peu fiable de la demande en IA.
En 8 semaines, un utilisateur de Claude Code a saisi 1 138 prompts. Ceux-ci ont généré environ 14 mille appels au modèle et 3,2 milliards de tokens traités. La consommation énergétique estimée s’est élevée à environ 150 Wh par prompt saisi, soit environ 625 fois celle d’un prompt texte médian de Gemini.
La majeure partie du calcul intervient après que l’utilisateur a cessé de taper. L’agent relit le contexte, appelle des outils, réessaie, crée des branches et continue à travailler en
post-image
Le marché contourne déjà l’écart entre les benchmarks.
7 des 10 premiers modèles d’OpenRouter en volume hebdomadaire de tokens sont chinois, représentant environ 75 % de l’utilisation de ces 10 premiers modèles.
Les laboratoires américains gardent l’avantage à la pointe, mais la plupart des charges de travail n’ont pas besoin du meilleur modèle absolu. Elles ont besoin d’un modèle suffisamment performant, suffisamment bon marché et réellement facile à déployer.
Les laboratoires chinois semblent avoir bien compris cet aspect et s’améliorent à chaque sortie. Rester proche de la pointe, réduire l
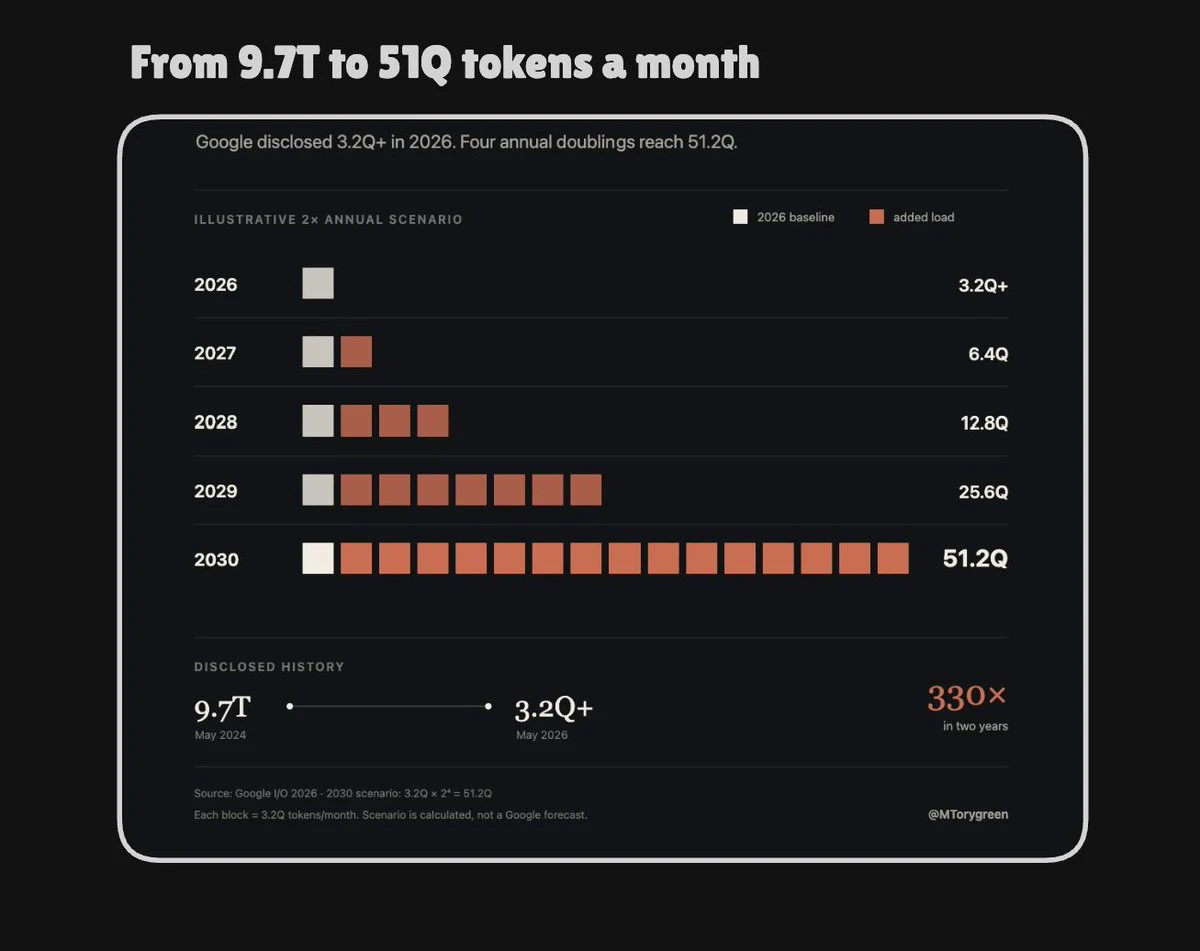
Il y a 2 ans, Google traitait 9,7 billions de jetons d’IA par mois.
Aujourd’hui, ce chiffre dépasse 3,2 billiards. Cela représente une multiplication par 330.
Il n’existe pas de décompte mondial fiable, le chiffre de Google peut donc être considéré au mieux comme un plancher communiqué.
Même si la croissance ralentit à un facteur 2 par an, Google à lui seul atteindrait 51 billiards de jetons par mois d’ici 2030.
Et cette charge de travail sera très différente de celle d’une personne qui ouvre un chatbot aujourd’hui. Des agents fonctionnant sur de longues périodes conserveront le contexte, divi
post-image
GOOGL-1,71%
Un contrat d’Anthropic ramène au présent 3,5 milliards de dollars de financement et tout un déploiement de GPU.
Nscale aurait signé avec Anthropic un accord d’environ $45B , chercherait à lever 3,5 milliards de dollars avant une introduction en bourse et aurait montré aux investisseurs $103B de revenus prévisionnels issus de baux signés. Nvidia pourrait fournir $2B de la levée.
L’engagement d’Anthropic donne aux prêteurs un élément concret sur lequel fonder leur financement, tandis que les capitaux de Nvidia contribuent à accélérer ses propres ventes de GPU. Nscale transforme les deux en cap
NVDA+1,16%
  • 3
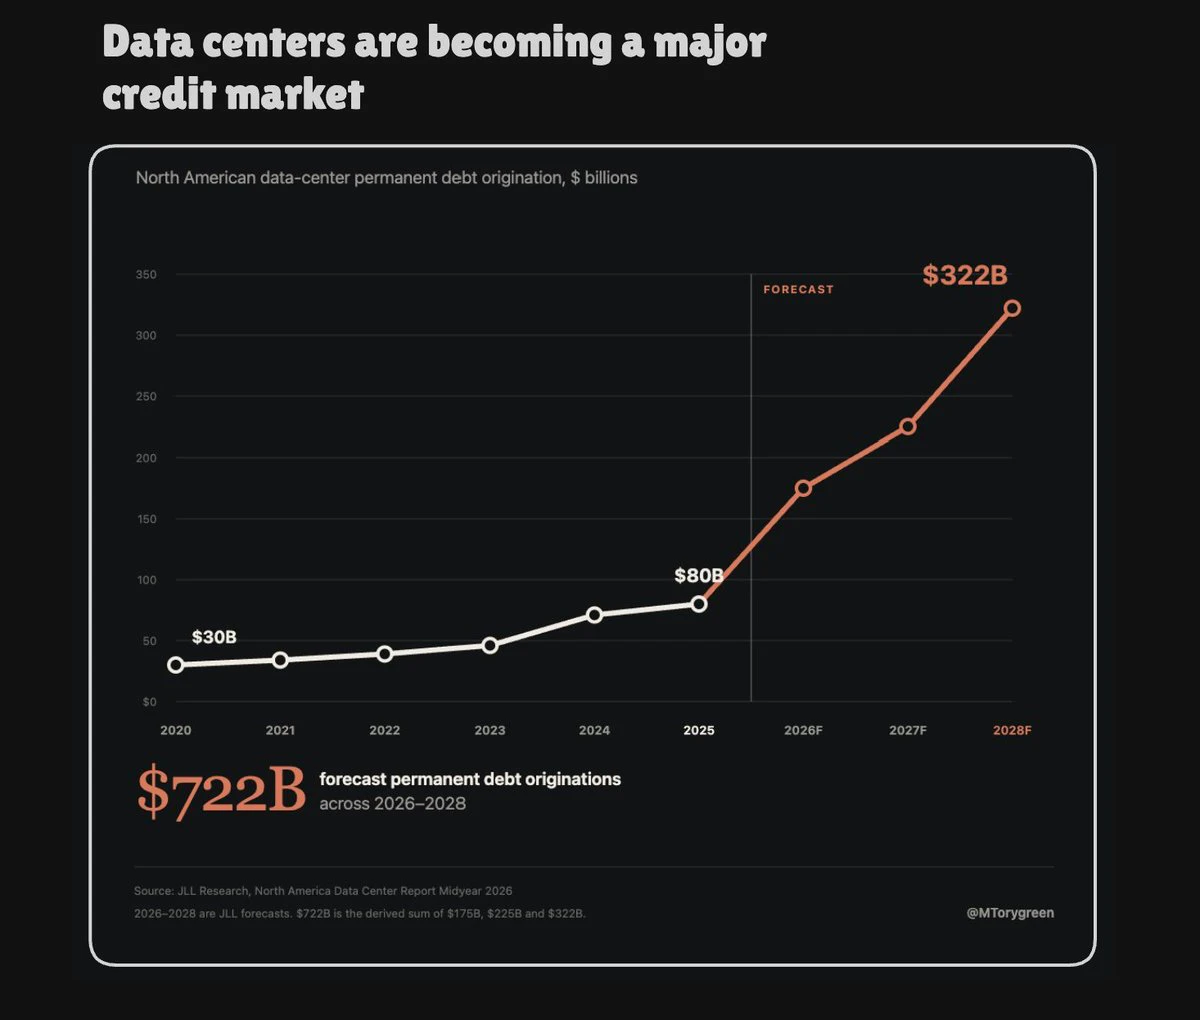
Les centres de données deviennent un marché majeur du crédit.
JLL s’attend à ce que les nouveaux financements de dette permanente en Amérique du Nord passent de $80B en 2025 à $175B cette année, puis à $322B d’ici 2028. Cela représente environ $722B sur les trois années de prévisions.
Mais le coût de ce capital commence déjà à fragmenter le marché. Les projets de construction soutenus par des hyperscalers peuvent atteindre un ratio prêt/coût d’environ 85 %, avec des spreads de l’ordre de 200 points de base, tandis que les projets liés aux laboratoires d’IA et aux néoclouds peuvent être tar
post-image
JLL+0,83%
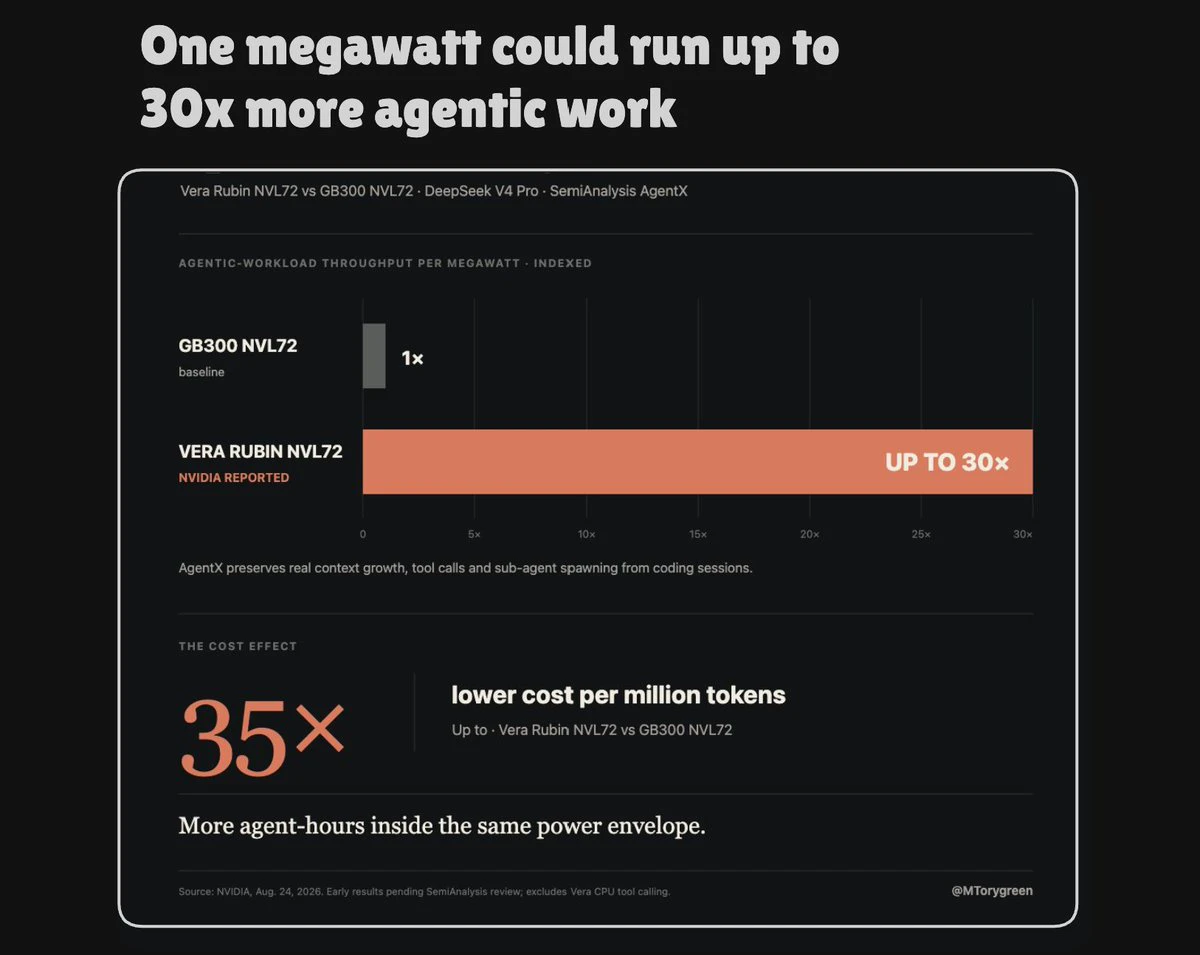
30 fois plus de travail d’agents avec le même mégawatt.
C’est ce que @nvidia affirme que Vera Rubin NVL72 a fourni par rapport à GB300 NVL72 sur DeepSeek V4 Pro, avec un coût par million de tokens jusqu’à 35 fois inférieur.
La charge de travail est ce qui en fait plus qu’un benchmark de débit classique. AgentX conserve les aspects difficiles de l’utilisation réelle d’agents : un contexte qui s’allonge, des appels répétés à des outils et des sous-agents qui se lancent en cours de tâche.
Si ces premiers chiffres résistent à l’examen de SemiAnalysis, les implications pour l’infrastructure sont co
post-image
NVDA+1,16%
DEEPSEEK-1,62%
  • 1