Le 3 novembre 2026, Binance a publié une déclaration d’enquête préliminaire concernant l’incident de sécurité du 29 octobre. Cette déclaration a révélé que des attaquants avaient compromis les appareils d’ingénieurs à l’aide de logiciels malveillants et utilisé des outils d’IA internes pour étendre davantage leur accès. Selon la déclaration, l’attaque a finalement impliqué un accès non autorisé au service interne de signature de portefeuilles, affectant environ 6,34 milliards de dollars d’actifs numériques. Toutefois, la déclaration n’a pas divulgué l’architecture complète des outils d’IA internes, ni confirmé que l’attaque exploitait des vulnérabilités d’un grand modèle de langage lui-même ou impliquait une injection de prompt.
Cet incident soulève une question importante de sécurité en entreprise : lorsqu’un Agent IA peut accéder à davantage d’outils internes et de systèmes sensibles, comment les entreprises doivent-elles distinguer les autorisations de traitement de l’information des autorisations opérationnelles réelles ? En partant de la manière dont les Agents IA appellent des outils, cet article explique les limites d’autorisation, l’injection de prompt, la gestion des identifiants et les risques de mouvement latéral, puis analyse les contrôles de sécurité que les entreprises peuvent adopter.
Points clés
-
Les Agents IA peuvent faire plus que générer du texte. Ils peuvent également exécuter du code, lire des fichiers, accéder à des API ou exploiter des systèmes internes d’entreprise via des appels d’outils.
-
La déclaration d’enquête préliminaire de Binance, publiée le 3 novembre 2026, indique que les attaquants ont utilisé les appareils compromis d’ingénieurs et des outils d’IA internes pour obtenir un accès supplémentaire aux appareils et aux autorisations d’autres ingénieurs.
-
L’un des principaux risques de sécurité liés aux Agents IA consiste à transformer des informations provenant d’environnements externes ou à faible niveau de confiance en actions bénéficiant de privilèges d’exécution réels.
-
L’injection de prompt, les sorties malveillantes d’outils, les autorisations excessives et les fuites d’identifiants peuvent se cumuler. Toutefois, toute attaque impliquant des outils d’IA n’est pas nécessairement une attaque par injection de prompt.
-
Les entreprises doivent traiter les Agents IA comme des entités d’exécution logicielle disposant d’identités et d’autorisations spécifiques, et maîtriser les risques au moyen du principe du moindre privilège, de l’isolation des outils, de l’approbation des opérations et de mécanismes d’audit.
En quoi les Agents IA diffèrent-ils des chatbots IA traditionnels ?
Les chatbots IA traditionnels accomplissent principalement des tâches en recevant des entrées utilisateur et en générant des réponses textuelles. Même si un modèle peut fournir du code, analyser des fichiers ou expliquer des étapes opérationnelles, il ne peut généralement pas modifier directement une base de données d’entreprise, déployer une application ou appeler un service interne sans être connecté à un environnement d’exécution réel.
La différence avec les Agents IA réside dans leur capacité à relier les décisions générées par le modèle à des outils externes. Par exemple, les développeurs peuvent configurer un Agent avec des outils de recherche de code, d’exécution dans un terminal, d’interrogation de bases de données et de gestion de dépôts Git. Lorsqu’un utilisateur soumet une tâche, l’Agent peut d’abord récupérer les fichiers pertinents, puis appeler des outils pour obtenir des informations et décider ensuite de la suite des actions en fonction des résultats. Avec les autorisations appropriées, un Agent peut même créer des commits de code, déclencher des tests ou exécuter des processus de déploiement.
Ce modèle transforme un Agent IA, d’un simple outil de génération d’informations, en un système logiciel doté de certaines capacités opérationnelles. L’Agent ne dispose pas nécessairement de privilèges d’administrateur indépendants, mais il peut acquérir la capacité d’accéder à des systèmes externes grâce à l’autorisation de l’utilisateur, à des comptes de service, à des jetons API ou à d’autres identifiants.
Par conséquent, la sécurité des Agents IA ne peut pas être évaluée uniquement selon l’exactitude des réponses du modèle. Même si le contenu généré par le modèle ne contient aucune erreur évidente, l’Agent peut tout de même effectuer des opérations allant au-delà des attentes de l’utilisateur si ses autorisations d’outils sont mal configurées. Les entreprises doivent se concentrer non seulement sur ce que l’IA génère, mais aussi sur ce qu’elle peut lire, sur ce qu’elle peut appeler et sur les opérations capables de modifier réellement l’état d’un système.
Comment les Agents IA appellent-ils des outils ?
L’appel d’outils est un mécanisme important permettant aux Agents IA d’interagir avec des systèmes externes. Les développeurs fournissent généralement au modèle les noms, les descriptions fonctionnelles et les structures de paramètres des outils disponibles. Le modèle détermine ensuite s’il convient d’appeler un outil particulier en fonction de la tâche en cours. L’exécution réelle est généralement assurée par l’environnement d’exécution ou l’application de l’Agent, après quoi les résultats de l’outil sont transmis au modèle pour un traitement complémentaire.
Par exemple, un Agent de développement interne peut être capable de lire des dépôts de code, d’interroger des journaux d’erreurs et d’exécuter des tests. Lorsqu’un utilisateur lui demande d’examiner un problème affectant un service, l’Agent peut appeler un outil d’interrogation des journaux pour localiser le problème, lire le code concerné, puis générer des recommandations de modification. Si l’entreprise lui accorde également des autorisations d’écriture de code ou de déploiement, l’Agent peut passer d’une assistance analytique à l’exécution d’opérations réelles.
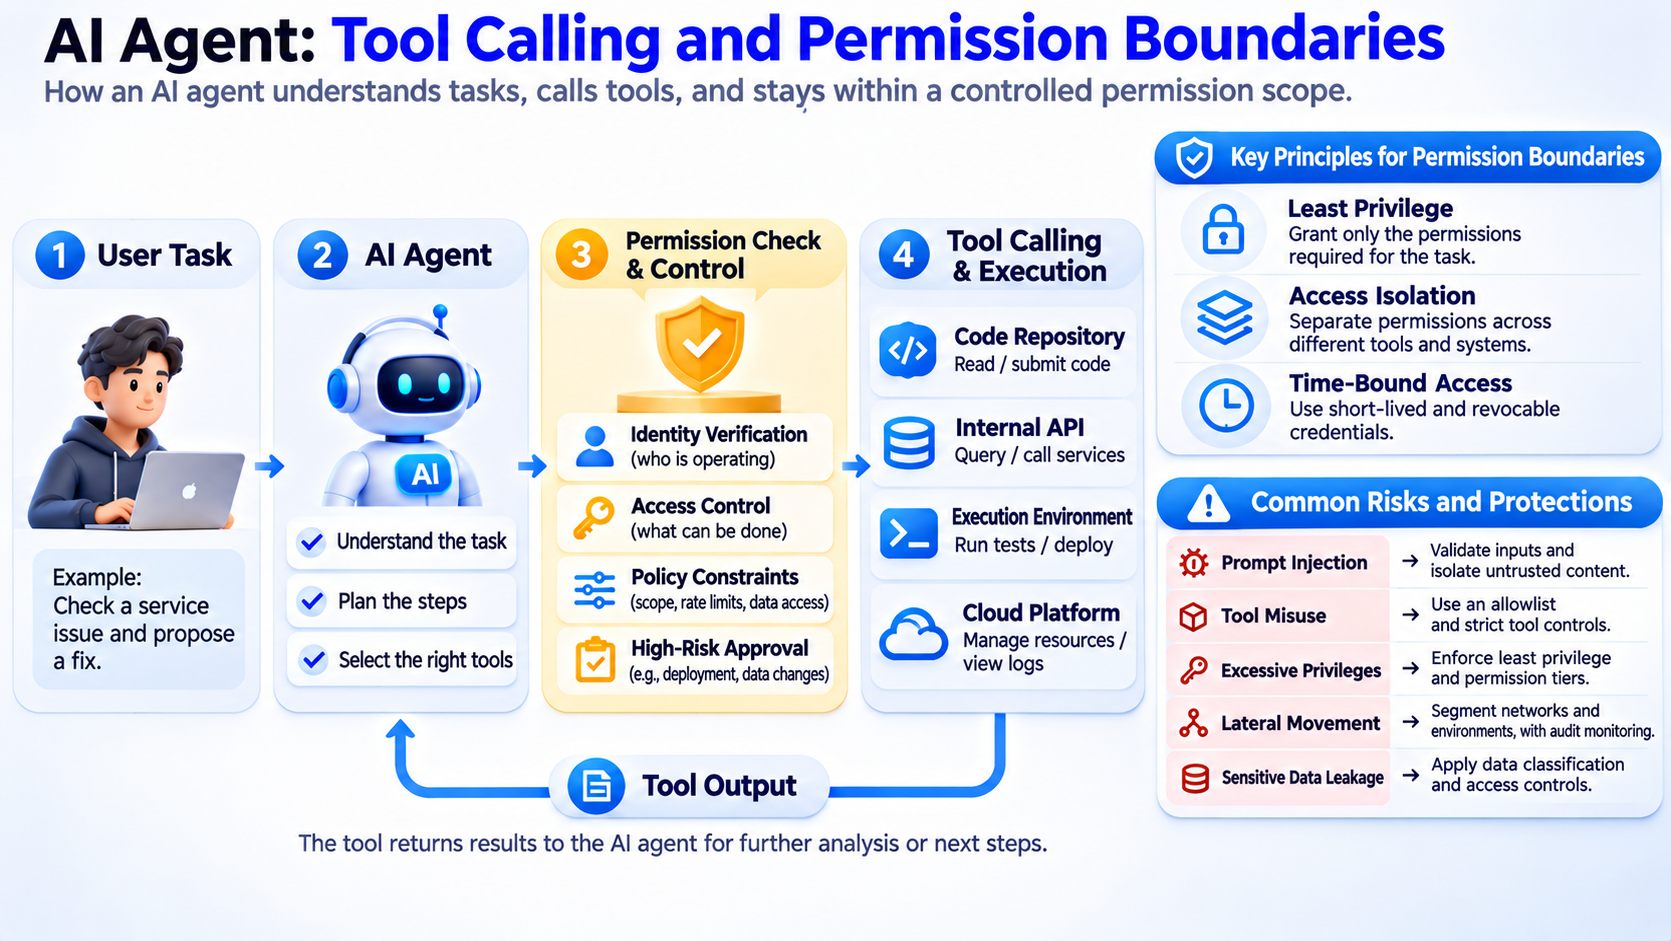
Les risques liés à l’appel d’outils proviennent principalement de deux domaines.
-
L’Agent peut recevoir des autorisations d’exécution excessives. Par exemple, il peut n’avoir besoin que de lire des journaux, tout en étant également capable de modifier les configurations de l’environnement de production.
-
L’Agent peut traiter du contenu non fiable provenant de pages web externes, de commentaires de code, d’e-mails ou de sorties d’outils. Si le système ne distingue pas correctement ce contenu de l’autorisation réelle de l’utilisateur, des informations externes peuvent influencer les appels d’outils ultérieurs.
Cela signifie que les entreprises ne peuvent pas simplement traiter les appels d’outils générés par le modèle comme des opérations fiables. Chaque appel d’outil impliquant des données sensibles ou des modifications du système nécessite une vérification indépendante des autorisations. Le modèle peut soumettre une demande d’exécution, mais l’autorisation de cette demande doit être déterminée par des politiques de sécurité explicites.
Pourquoi les Agents IA peuvent-ils étendre la surface d’attaque d’une entreprise ?
Les systèmes de sécurité traditionnels en entreprise établissent généralement des contrôles d’accès autour des identités des employés, des serveurs, des applications et des frontières réseau. Les différents employés disposent d’autorisations système différentes, tandis que les services critiques peuvent restreindre les accès grâce à des identifiants distincts et à des règles réseau. Lorsque des Agents IA se connectent aux systèmes d’entreprise, ils créent en pratique de nouveaux chemins d’accès automatisés.
Par exemple, un Agent de développement peut se connecter simultanément à un dépôt Git, à une base de connaissances interne, à une plateforme cloud et à un système de gestion des tâches. Afin d’accomplir des tâches intersystèmes, les développeurs peuvent configurer plusieurs jetons API ou comptes de service. Si ces identifiants ne sont pas strictement limités, un attaquant qui prend le contrôle de l’environnement d’exécution de l’Agent ou d’une identité associée peut utiliser ces capacités d’accès pour atteindre davantage de systèmes.
Un autre enjeu concerne la vitesse opérationnelle. Les employés doivent généralement se connecter manuellement à plusieurs plateformes pour effectuer une série d’opérations, tandis qu’un Agent IA peut appeler des outils de manière continue sur une courte période. L’automatisation n’est pas intrinsèquement non sécurisée. Toutefois, en l’absence de limites de débit, de détection des anomalies et d’approbation des opérations à haut risque, des instructions erronées ou malveillantes peuvent être exécutées rapidement.
Les Agents IA étendent donc non seulement le nombre d’interfaces logicielles, mais aussi les relations d’autorisation reliant différents systèmes. Les entreprises doivent évaluer les ressources auxquelles chaque Agent peut accéder, sa capacité à traverser différents domaines de sécurité et l’existence éventuelle de chemins reliant des outils à faible risque à des systèmes à haut risque.
Pourquoi l’injection de prompt peut-elle affecter les appels d’outils des Agents IA ?
L’injection de prompt désigne une attaque dans laquelle un attaquant place un contenu ressemblant à des instructions dans des données qu’un modèle peut lire, afin de tenter de modifier la tâche que le modèle est censé exécuter. Pour les chatbots ordinaires, de telles attaques peuvent conduire à des réponses incorrectes ou à la divulgation d’informations. Pour les Agents IA disposant de capacités d’appel d’outils, elles peuvent également affecter des opérations réelles.
Par exemple, une entreprise peut utiliser un Agent IA pour organiser automatiquement les rapports de problèmes dans un dépôt de code. Si un attaquant peut contrôler le contenu d’un rapport, il peut y insérer des instructions déguisées en exigences de maintenance du système, afin d’inciter l’Agent à lire des fichiers supplémentaires ou à appeler des outils sans rapport. Le risque réel n’est pas que l’Agent lise le rapport, mais qu’il traite le contenu non fiable du rapport comme une instruction disposant d’une autorité d’exécution.
Ces attaques sont communément appelées injections de prompt indirectes. L’attaquant n’a pas besoin d’envoyer directement des commandes à l’utilisateur de l’Agent. Il peut plutôt influencer l’Agent par l’intermédiaire de pages web, de documents, de commentaires de code, de résultats de recherche ou de sorties d’outils. OWASP répertorie l’injection de prompt, l’abus d’outils, l’élévation de privilèges et la divulgation d’informations sensibles parmi les risques de sécurité importants pour les Agents IA.
Toutefois, l’injection de prompt doit être distinguée des attaques traditionnelles par logiciels malveillants. Si un attaquant a déjà pris le contrôle de l’ordinateur d’un ingénieur au moyen de code malveillant, puis utilise des identifiants existants pour accéder à des systèmes internes, le fait que le chemin d’attaque implique un outil d’IA ne signifie pas nécessairement qu’une injection de prompt a eu lieu. Les deux mécanismes peuvent apparaître ensemble, mais ils sont techniquement différents.
Quels risques liés aux outils d’IA et à la gestion des autorisations l’incident de sécurité de Binance révèle-t-il ?
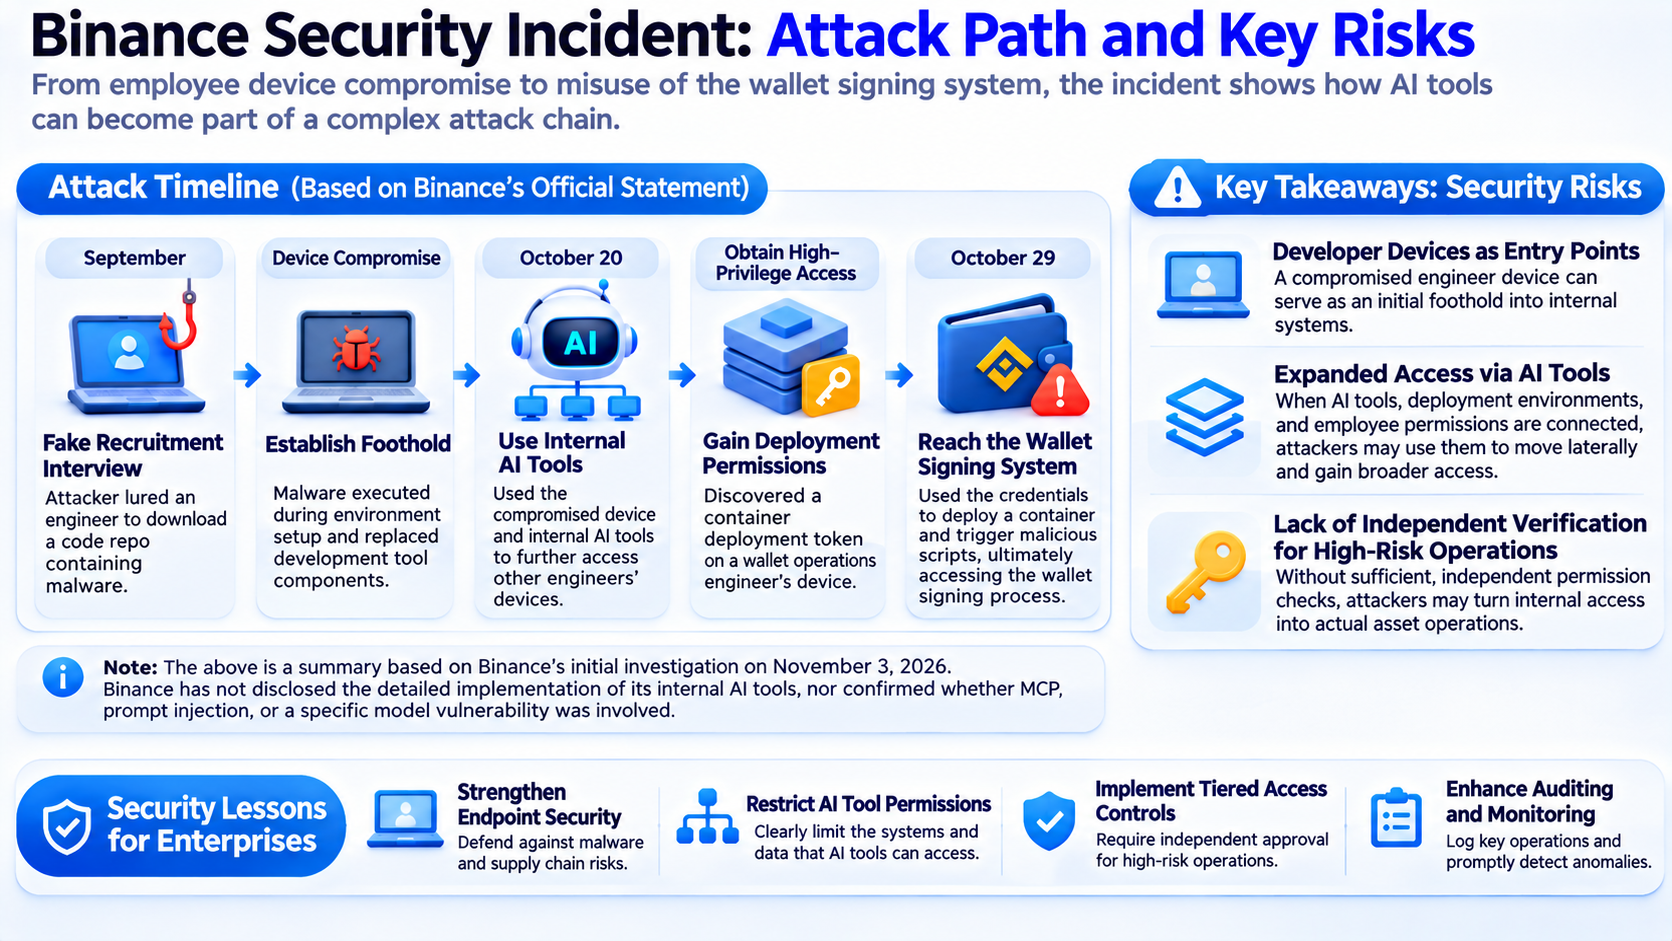
Dans sa déclaration d’enquête préliminaire publiée le 3 novembre 2026, Binance a révélé une attaque en plusieurs étapes ayant progressé de la compromission d’un appareil d’employé à l’abus du système interne de signature de portefeuilles. Selon cette déclaration, en septembre, les attaquants ont incité un ingénieur logiciel à télécharger un dépôt contenant du code malveillant dans le cadre d’un faux entretien d’embauche. Le code malveillant s’est exécuté lors de la configuration de l’environnement et a établi des canaux de communication contrôlés par les attaquants en remplaçant des composants d’outils de développement et par d’autres méthodes.
Le 20 octobre, les attaquants ont utilisé l’ordinateur compromis d’un ingénieur et des outils d’IA internes pour prendre le contrôle des appareils d’autres ingénieurs. Ils ont également découvert un jeton d’autorisation de déploiement de conteneurs sur l’appareil d’un ingénieur chargé des opérations de portefeuille. Le 29 octobre, les attaquants ont utilisé les identifiants concernés pour déployer des conteneurs et déclencher des scripts malveillants, atteignant finalement le processus d’opération de signature des portefeuilles.
Du point de vue de l’architecture de sécurité, cet incident reflète au moins trois problèmes qui méritent d’être étudiés. Premièrement, les appareils des développeurs peuvent devenir des points d’entrée vers des systèmes internes à forte valeur. Deuxièmement, lorsque des outils d’IA internes, des environnements de déploiement et les autorisations des employés sont interconnectés, des attaquants peuvent exploiter ces connexions pour étendre leur accès. Enfin, si les opérations à haut risque ne disposent pas d’une vérification indépendante suffisante des autorisations, les attaquants peuvent transformer les autorisations internes obtenues en capacité d’effectuer des opérations réelles sur des actifs.
Il est important de souligner que Binance n’a pas divulgué la mise en œuvre spécifique de ses outils d’IA internes. Il est donc impossible de confirmer si ces outils étaient des Agents IA dotés de capacités de planification autonome, ou de conclure que l’attaque impliquait MCP, une injection de prompt ou une vulnérabilité dans un modèle particulier. Cet incident montre que des outils d’IA peuvent faire partie d’un chemin d’attaque complexe, mais ne prouve pas à lui seul qu’un Agent IA était la cause première de l’attaque.
Quelle est la limite d’autorisation d’un Agent IA ? Pourquoi le moindre privilège est-il si important ?
Une limite d’autorisation définit les ressources auxquelles une entité logicielle peut accéder, les opérations qu’elle peut effectuer et les conditions dans lesquelles elle peut obtenir des autorisations supplémentaires. Pour un Agent IA, cette limite implique non seulement le modèle lui-même, mais aussi l’environnement d’exécution de l’Agent, les interfaces d’outils, l’identité utilisateur, les comptes de service et les systèmes externes.
Le principe du moindre privilège exige qu’un système n’accorde que les autorisations nécessaires à l’accomplissement de la tâche en cours. Par exemple, un Agent chargé d’analyser les journaux d’un serveur n’a généralement besoin que d’accéder à des données de journal spécifiques. Il ne devrait pas pouvoir automatiquement supprimer des bases de données, modifier des environnements de production ou transférer des actifs numériques. Si une tâche exige réellement une opération à haut risque, l’Agent devrait obtenir une autorisation temporaire via un mécanisme d’autorisation indépendant.
OWASP répertorie l’autonomie excessive parmi les risques importants des applications fondées sur de grands modèles de langage. Le problème principal n’est pas que le modèle dispose de capacités d’appel d’outils, mais que le système lui a accordé des fonctions inutiles, des autorisations excessives ou des capacités de fonctionnement autonome sans contraintes. Lorsque le modèle est influencé par une entrée incorrecte, une injection de prompt ou des résultats d’outils malveillants, ces autorisations peuvent accroître les dommages potentiels.
Les entreprises doivent donc placer les contrôles d’autorisation dans un environnement d’exécution fiable plutôt que de simplement indiquer à l’Agent, au moyen d’un prompt système, de ne pas effectuer d’opérations dangereuses. Même si un modèle demande à tort l’accès à un outil sensible, le service backend doit pouvoir rejeter cette demande non autorisée en fonction de l’identité, de la portée de la ressource et du type d’opération.
Quels nouveaux défis de sécurité les protocoles de connexion d’outils tels que MCP peuvent-ils créer ?
Le Model Context Protocol (MCP) est un protocole ouvert permettant de connecter des applications d’IA à des outils externes et à des ressources de données. Grâce à MCP, les développeurs peuvent connecter des Agents IA à des systèmes de fichiers, des bases de données, des dépôts de code et d’autres services, sans devoir concevoir une méthode d’intégration entièrement différente pour chaque outil.
Cette méthode de connexion standardisée peut améliorer l’efficacité du développement, mais elle signifie également que les Agents peuvent accéder plus facilement à plusieurs systèmes externes. Si une entreprise ne gère pas les serveurs MCP, les définitions d’outils et les autorisations d’accès, elle peut être confrontée à des problèmes tels que des autorisations d’outils excessives, des descriptions d’outils malveillantes, des services tiers compromis ou l’exposition accidentelle d’informations sensibles.
Par exemple, un Agent de développement peut avoir besoin de lire un dépôt de code, sans avoir besoin d’accéder au système de paiement de l’entreprise. Si les deux types d’outils sont configurés dans le même environnement d’exécution et utilisent des identifiants partagés dotés d’autorisations élevées, un Agent initialement destiné à assister le développement peut acquérir des capacités opérationnelles sans rapport avec sa tâche.
OWASP recommande d’établir un mécanisme d’audit pour les serveurs MCP connectés aux outils de codage IA, de limiter les outils pouvant être appelés et de vérifier si les définitions d’outils contiennent des instructions malveillantes. Les Agents qui exécutent du code devraient également recourir à des mesures telles que le sandboxing, les restrictions d’accès réseau et la gestion indépendante des identifiants.
MCP ne constitue pas en lui-même une vulnérabilité de sécurité. Les éléments à évaluer sont la mise en œuvre des outils, l’authentification, la configuration des autorisations et la manière dont le contenu externe affecte le comportement de l’Agent après la connexion du protocole.
Comment les entreprises doivent-elles protéger les identités et les autorisations d’accès des Agents IA ?
Les entreprises doivent d’abord établir un système d’identité identifiable et auditable pour les Agents IA. Les applications traditionnelles utilisent généralement des comptes de service ou des clés API pour accéder à d’autres systèmes. Toutefois, les opérations des Agents IA peuvent simultanément impliquer l’autorisation d’un utilisateur, des tâches automatisées et plusieurs outils. Les entreprises doivent donc clairement distinguer l’identité de l’utilisateur, l’identité de l’Agent et les autorisations d’exécution réelles.
Par exemple, le fait qu’un employé demande à un Agent de récupérer un rapport interne ne signifie pas que l’Agent peut utiliser son compte de service pour lire d’autres fichiers auxquels cet employé n’est pas autorisé à accéder. Une conception d’autorisation appropriée doit vérifier à la fois que l’utilisateur demandeur est autorisé à accéder à la ressource cible et que l’Agent est autorisé à effectuer l’opération correspondante. Cela permet d’éviter que l’Agent contourne les contrôles d’accès existants parce que son service proxy détient des privilèges plus élevés.
En février 2026, le National Cybersecurity Center of Excellence (NCCoE), rattaché au National Institute of Standards and Technology (NIST), a publié un document conceptuel sur l’identité et l’autorisation des logiciels et des Agents IA. Le document abordait notamment la reconnaissance de l’identité des Agents, l’authentification, l’autorisation, les identifiants temporaires, les autorisations déléguées et l’audit. Cela reflète l’évolution de la sécurité des Agents IA, qui passe du contrôle des sorties du modèle à un cadre complet de gestion des identités et des accès.
Dans les déploiements réels, les entreprises peuvent utiliser des identifiants d’accès à courte durée de vie et limiter les autorisations à des tâches, ressources et périodes précises. Une approbation indépendante et une vérification secondaire devraient également être exigées pour les activités à haut risque, telles que les déploiements en production, les opérations financières et les modifications d’autorisations. Ainsi, même si l’environnement d’exécution de l’Agent est compromis, un attaquant pourrait ne pas être en mesure d’obtenir directement des identifiants à privilèges élevés et de longue durée.
Comment les entreprises peuvent-elles réduire les risques de sécurité liés aux appels d’outils des Agents IA ?
Les entreprises peuvent établir des mesures de protection dans quatre domaines : les autorisations des outils, les environnements d’exécution, les opérations sensibles et la surveillance des comportements.
-
Les entreprises devraient limiter les outils qu’un Agent peut utiliser en fonction des besoins métier. Un Agent qui ne fait que récupérer des informations n’a pas besoin de capacités d’exécution arbitraire de code, et un Agent utilisé pour la revue de code ne devrait pas recevoir automatiquement des autorisations de déploiement en production. Pour les outils dotés de capacités d’écriture, les entreprises peuvent en outre restreindre les chemins de fichiers, les tables de bases de données, les types d’opérations API et les périmètres d’accès.
-
Les outils à haut risque devraient s’exécuter dans des environnements isolés. L’exécution de code, l’installation de packages tiers et le traitement de pages web externes peuvent introduire du contenu non fiable. Les entreprises peuvent donc utiliser des conteneurs ou d’autres technologies de sandboxing afin de limiter l’accès aux systèmes de fichiers, aux réseaux et aux ressources système. L’isolation réduit la probabilité qu’une attaque contre un seul outil affecte d’autres systèmes.
-
Les entreprises devraient exiger une approbation humaine pour les opérations irréversibles. Des opérations telles que la suppression de données importantes, la modification d’autorisations, le déploiement de services de production ou le transfert d’actifs ne devraient pas être réalisées automatiquement simplement parce que l’Agent estime la tâche raisonnable. Les recommandations de sécurité du Microsoft Agent Framework préconisent également de déterminer si une confirmation humaine est requise en fonction de l’impact, de la sensibilité des données et de la réversibilité de l’opération.
-
Enfin, les entreprises doivent établir des mécanismes d’audit continu enregistrant les outils utilisés par l’Agent, les ressources auxquelles il a accédé, l’éventuelle survenue de demandes d’autorisation anormales et la conformité des résultats d’exécution réels avec la tâche autorisée. Pour les appels d’outils échouant de manière répétée, les accès anormaux aux données et un grand nombre d’opérations effectuées sur une courte période, les entreprises peuvent associer la détection fondée sur des règles à l’analyse comportementale afin d’identifier les risques potentiels.
| Mesure de sécurité |
Fonction principale |
| Moindre privilège |
Limiter les outils et les ressources auxquels l’Agent peut accéder |
| Approbations des appels d’outils |
Empêcher l’exécution d’opérations à haut risque sans confirmation |
| Isolation par sandbox |
Réduire l’impact du code malveillant ou de l’abus d’outils |
| Identifiants d’accès temporaires |
Réduire le risque d’exposition à long terme des identifiants |
| Validation des entrées et des sorties |
Réduire le risque que du contenu malveillant affecte l’exécution des outils |
| Audit comportemental |
Détecter les appels anormaux et l’utilisation anormale des autorisations |
Ces mesures ne peuvent pas garantir l’élimination complète des risques de sécurité liés aux Agents IA. Elles peuvent toutefois réduire la portée de l’impact après une attaque réussie et accroître la probabilité que les comportements anormaux soient détectés et traités.
Pourquoi la sécurité des Agents IA devient-elle un enjeu important pour l’infrastructure Web3 ?
La combinaison des Agents IA et de l’infrastructure blockchain donne aux appels d’outils et à la gestion des autorisations des implications plus directes pour la sécurité des actifs. Dans les scénarios d’entreprise traditionnels, un Agent peut exécuter du code, envoyer des e-mails ou modifier une base de données. Dans les scénarios Web3, un Agent peut également se connecter à des portefeuilles, interroger des actifs on-chain, appeler des smart contracts ou initier des demandes de transaction.
Par exemple, un Agent utilisé pour gérer automatiquement des actifs on-chain peut avoir besoin d’interroger les soldes, d’analyser le marché et de fournir des recommandations de trading selon les paramètres de l’utilisateur. S’il reçoit également des capacités de signature de transactions ou d’appel de smart contracts, les entreprises doivent clairement définir quelles opérations peuvent être exécutées automatiquement, lesquelles nécessitent une confirmation de l’utilisateur, et comment limiter le montant par transaction, le périmètre des actifs et la durée de validité de l’autorisation.
Dans ce processus, les clés de session, les comptes intelligents et les mécanismes d’autorisation granulaires peuvent fournir différentes formes de gestion des autorisations. Toutefois, leur sécurité spécifique dépend de leur mise en œuvre. Les clés de session peuvent limiter certaines autorisations opérationnelles à une période ou un périmètre donné, tandis que les comptes intelligents peuvent restreindre le comportement des transactions par des règles contractuelles. Néanmoins, des risques de sécurité peuvent toujours apparaître si les conditions d’autorisation sont trop larges, si la logique de validation comporte des défauts ou si l’environnement d’exécution est compromis.
Le développement des Agents IA Web3 ne peut donc pas se concentrer uniquement sur l’efficacité du trading automatisé ou des paiements on-chain. Il doit également traiter la vérification d’identité, la délégation des autorisations, les approbations de transactions et la révocation des autorisations. Pour les systèmes d’IA connectés à des actifs réels, la limite de sécurité doit couvrir l’ensemble du processus, depuis les décisions du modèle jusqu’aux appels d’outils, à la construction des transactions, à la vérification des signatures et à l’exécution on-chain.
Conclusion
Les Agents IA transforment la manière dont les entreprises utilisent l’intelligence artificielle. À mesure que les modèles se connectent aux dépôts de code, aux API internes, aux bases de données et aux outils d’automatisation, les systèmes d’IA ne sont plus de simples points d’entrée pour le traitement de l’information. Ils deviennent de plus en plus des entités d’exécution logicielle dotées de capacités opérationnelles réelles.
L’enquête préliminaire de Binance sur l’incident de sécurité divulguée le 3 novembre 2026 indique que des outils d’IA internes ont pu apparaître dans un chemin d’attaque complexe. Toutefois, les informations disponibles ne suffisent pas à prouver que l’incident a été directement causé par une vulnérabilité d’Agent IA ou une injection de prompt. L’enseignement le plus important est que les entreprises doivent réévaluer les relations d’accès entre les environnements de développement, les outils d’automatisation et les systèmes à privilèges élevés.
À l’avenir, la sécurité des Agents IA dépendra non seulement de la capacité des modèles à identifier des instructions malveillantes, mais aussi de la capacité des entreprises à établir une authentification fiable des identités, le moindre privilège, l’isolation des outils et des mécanismes d’approbation indépendants. Ce n’est qu’en séparant correctement les capacités de prise de décision de l’IA des autorisations d’exécution réelles que les entreprises pourront maîtriser les risques potentiels tout en améliorant l’efficacité de l’automatisation.
FAQ
Pourquoi les Agents IA présentent-ils davantage de risques de sécurité que les chatbots ordinaires ?
Les Agents IA peuvent accéder à des données d’entreprise, exécuter du code ou modifier des systèmes via des appels d’outils. Par rapport aux chatbots qui ne génèrent que du texte, leurs erreurs ou leurs comportements manipulés peuvent avoir des conséquences opérationnelles réelles.
Qu’est-ce que l’appel d’outils d’un Agent IA ?
L’appel d’outils désigne le fait qu’un Agent IA demande à un programme ou à un service externe d’effectuer une opération selon les exigences d’une tâche, par exemple interroger une base de données, lire un fichier, appeler une API ou exécuter du code.
Une injection de prompt peut-elle toujours contrôler un Agent IA ?
Pas nécessairement. La réussite d’une injection de prompt dépend de la conception du système, du comportement du modèle et des contrôles de sécurité. Même si un attaquant influence la sortie du modèle, une vérification indépendante des autorisations peut empêcher les opérations d’outils non autorisées.
L’incident de sécurité de Binance prouve-t-il que les Agents IA présentent des vulnérabilités ?
Non. L’enquête préliminaire de Binance a confirmé que le chemin d’attaque impliquait des outils d’IA internes, mais elle n’a pas divulgué de preuves techniques suffisantes pour établir l’existence d’une vulnérabilité d’Agent IA ou d’une injection de prompt.
MCP accroît-il les risques de sécurité des Agents IA ?
MCP peut aider les applications d’IA à se connecter à des outils externes, mais les principaux risques de sécurité proviennent de la mise en œuvre des outils, des autorisations d’accès et du traitement du contenu non fiable. Une authentification adéquate, l’audit des outils et des restrictions d’autorisations peuvent réduire ces risques.
Comment les entreprises doivent-elles limiter les autorisations des Agents IA ?
Les entreprises peuvent utiliser le moindre privilège, des identifiants temporaires propres à chaque tâche, des approbations indépendantes des opérations, l’isolation par sandbox et l’audit des appels d’outils afin de garantir que les Agents ne peuvent effectuer que des opérations explicitement autorisées.







