Para principiantes que procuram delimitar as capacidades da IA, um modelo do mundo responde à questão de saber se um sistema consegue antecipar as consequências das ações, e não se redige respostas fluentes. As secções seguintes abordam a definição, o ciclo de previsão, três abordagens técnicas, a seleção de tarefas em Modelo do mundo vs. LLM, as diferenças face à geração de vídeo, os casos de utilização e os limites de avaliação; os conceitos relacionados são apresentados nos explicadores da Gate Learn sobre Superinteligência (ASI) e IA privada.
Principais conclusões
- A capacidade central é a previsão condicionada pela ação: dado um estado e uma ação, produzir o estado seguinte (ou a representação seguinte) para planeamento e controlo.
- Três abordagens comuns: RL baseado em modelos (MBRL) / treino por imaginação, simulação interativa generativa e representações preditivas ao estilo JEPA.
- Os modelos de linguagem de grande dimensão destacam-se na previsão do token seguinte, e os geradores de vídeo na continuidade visual; nenhum equivale automaticamente a um modelo do mundo passível de planeamento.
- A avaliação deve ter em atenção física simulada incorretamente, desvio em horizontes temporais longos, falhas fora da distribuição, métricas rigorosas e a fronteira com simuladores programados manualmente.
O que é um modelo do mundo e que problema resolve?
Um modelo do mundo responde a uma questão prática: antes de um agente agir, consegue estimar de forma fiável o que acontece a seguir? Sem essa capacidade, a aprendizagem depende de tentativa e erro no mundo real — muitas vezes dispendiosa, lenta ou insegura — e o planeamento offline torna-se difícil.
Na robótica, na condução autónoma, nos agentes de jogos e no treino em simulação — sobretudo para agentes incorporados em ambientes virtuais ou físicos — o feedback é dispendioso ou arriscado; por exemplo, uma política de condução inadequada pode provocar um acidente real antes de aprender. Um modelo do mundo transfere a “experimentação de ações” para dinâmicas aprendidas: projeta a evolução no espaço latente ou de observação e, em seguida, aplica uma política mais robusta ao mundo real. Este objetivo difere dos sistemas conversacionais que sobretudo reformulam conhecimento; aproxima-se mais da previsão causal num ambiente interativo.
A entrada do glossário da NVIDIA sobre modelos do mundo descreve-os como representações internas que ajudam a IA a compreender e prever a evolução do mundo físico; A Path Towards Autonomous Machine Intelligence, de Yann LeCun coloca os modelos preditivos do mundo num percurso rumo a uma inteligência mais autónoma; e o trabalho “World Models”, de David Ha, de 2018, ajudou a definir a abordagem moderna baseada em aprendizagem. Normalmente, um agente observa apenas parcialmente o ambiente, pelo que o estado completo não está disponível de forma direta. Em todas estas perspetivas, a previsão existe para apoiar decisões.
Como funciona um modelo do mundo? Estado, ação e ciclo de previsão
O teste mais consistente de um sistema orientado para modelos do mundo é a previsão condicionada pela ação: se as entradas incluem explicitamente a ação de um agente (ou sinal de controlo) e se a saída é o estado seguinte ou a representação seguinte condicionada por essa ação.
O ciclo resume-se geralmente a três passos: codificar observações num estado; condicionar esse estado a uma ação candidata; prever o estado seguinte, com o ambiente a mudar após essa ação e a devolver novas observações, podendo essa previsão ser projetada como um novo ponto de partida. Uma política ou um planeador compara trajetórias imaginadas em termos de recompensa, risco ou restrições e, em seguida, executa; uma observação recente reinicia a codificação.
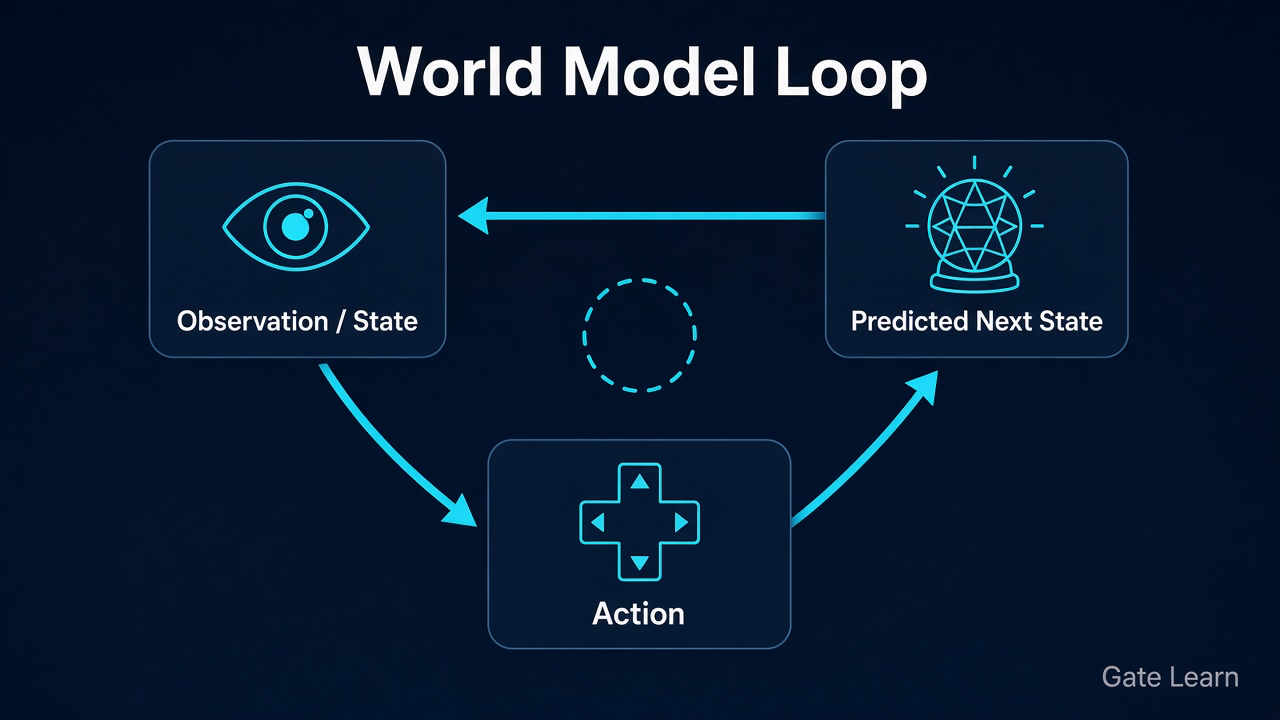
Figura 1. Ciclo do modelo do mundo: a observação/estado mais a ação resulta num estado seguinte previsto que alimenta o ciclo seguinte.
Muitos sistemas práticos evitam previsões de longo horizonte em píxeis brutos e aprendem, em vez disso, dinâmicas latentes: comprimem dados visuais de elevada dimensionalidade num estado compacto e projetam a evolução nesse espaço. As projeções latentes reduzem o ruído visual e tornam o treino por imaginação menos dispendioso; continua a ser necessário verificar, através de tarefas subsequentes e testes fora da distribuição, se o estado latente se mantém fiel à física real, sobretudo porque o ambiente físico é apenas parcialmente observado e tem de ser inferido através de feedback.
Quais são as principais abordagens técnicas para modelos do mundo?
“Modelo do mundo” é uma designação abrangente para várias famílias técnicas, não o nome de um único algoritmo. A seleção começa pela função: políticas controláveis, simulação interativa de píxeis ou representações abstratas transferíveis.
| Abordagem |
Ideia central |
Mais adequada para |
Principal custo |
| MBRL / treino por imaginação |
Aprender dinâmicas e, em seguida, treinar uma política com projeções do modelo (Dreamer) |
Controlo, jogos, RL eficiente em amostras |
O erro do modelo compromete a política; desvio |
| Simulação interativa generativa |
Aprender um ambiente interativo que gera os fotogramas/observações seguintes |
Aumento de dados, mundos de vídeo interativos |
Aparência ≠ física; avaliação dispendiosa |
| Representações preditivas JEPA |
Prever incorporações futuras/mascaradas no espaço de representação (I-JEPA) |
Aprendizagem de representações, previsão abstrata para planeamento |
Sem píxeis; requer uma pilha de controlo |
Uma abordagem pode centrar-se num modelo de vídeo que prevê fotogramas futuros, enquanto outra visa dinâmicas latentes preparadas para planeamento em vez de uma reconstrução visual completa.
As três abordagens podem coexistir: os métodos ao estilo Dreamer enfatizam o treino de políticas por imaginação; os modelos generativos de vídeo do mundo enfatizam a simulação interativa da aparência; a I-JEPA da Meta AI demonstra a previsão num espaço de incorporações conjuntas em vez de reconstruir cada píxel. Diferentes sistemas também escolhem métodos de treino distintos consoante aprendem com pares de entrada-saída, projeções de controlo ou incorporações preditivas. Primeiro, alinhar a tarefa; depois, debater as designações.
Em que diferem os modelos do mundo dos LLM e da geração de vídeo?
Todos os três “preveem”, mas, no âmbito da IA generativa, preveem objetos diferentes e distinguem-se pelo condicionamento por ação: os LLM preveem o token seguinte, os geradores de vídeo preveem a aparência do fotograma seguinte e os sistemas orientados para modelos do mundo preveem como o estado evolui após uma ação.
| Dimensão |
Modelo do mundo |
Modelo de linguagem de grande dimensão (LLM) |
Geração de vídeo |
| Alvo principal da previsão |
Estado seguinte / dinâmicas latentes (frequentemente condicionadas pela ação) |
Token seguinte / estrutura de texto |
Aparência do fotograma ou clipe seguinte |
| Ligação à ação |
A previsão condicionada pela ação é o eixo de decisão |
Normalmente, sem ciclo de controlo físico |
Pode ser condicionada por texto/primeiro fotograma, mas não é executável |
| Utilização típica |
Planeamento, controlo, IA incorporada |
Linguagem, redação, orquestração de ferramentas |
Geração de conteúdo, pré-visualizações, simulações interativas |
| Confusão comum |
Capacidade de conversar = modelo do mundo |
Escrever sobre física = competência em física |
Fotogramas fotorrealistas = dinâmicas corretas |
Assim, um gerador de vídeo semelhante ao Sora pode apresentar fotogramas coerentes, com elevada fidelidade visual e até aparente consistência espacial — e pode ser designado como um “modelo de vídeo do mundo” —, mas essas características, por si só, não comprovam compreensão física. Sem uma interface de ação estável, transições de estado verificáveis e um ciclo de planeamento, a categoria correta continua a ser vídeo generativo. Um sistema mais robusto também consegue avaliar sequências de ações para apoiar o planeamento e a tomada de decisões, não apenas apresentar passivamente perspetivas prováveis. Um LLM pode descrever “o que acontece se empurrar ligeiramente o copo”, mas isso não cria dinâmicas ambientais passíveis de projeção e avaliação.
Onde são habitualmente utilizados os modelos do mundo?
A IA incorporada é um contexto frequente: braços robóticos e robôs móveis necessitam de inteligência espacial — raciocínio sobre disposições, movimento e mudanças no mundo físico —, bem como de previsões de contacto e deslocamento antes de tocarem em objetos, pois muitas interações são difíceis de reverter depois de o movimento começar. A previsão condicionada pela ação permite que os sistemas descartem trajetórias falhadas em simulação ou no espaço latente antes de suportarem o custo de colisões reais; as demonstrações podem inicializar comportamentos, mas não substituem a aprendizagem baseada na interação.
Os jogos e a aprendizagem por reforço baseada em modelos são outra área central. Os métodos ao estilo Dreamer melhoram as políticas com base em trajetórias imaginadas, permitindo obter controlo utilizável com menos interações reais. Ideias semelhantes aplicam-se a registos de controlo industrial em que um simulador programado manualmente é incompleto, mas existe um histórico abundante de observações, porque o modelo procura captar as dinâmicas do sistema a partir desse histórico.
A condução autónoma, o agendamento de armazéns e as simulações multiagente também integram componentes de modelos do mundo — não como substituição completa das pilhas de planeamento, mas como uma camada de consequências de curto horizonte. Testes virtuais e dados de vídeo selecionados são frequentemente utilizados para treinar e avaliar esses componentes em vários cenários antes da implementação real. Qualquer sistema de controlo que tenha de “pensar antes de agir” pode incluir um módulo de modelo do mundo.
Que vantagens, riscos e limites são importantes na avaliação de modelos do mundo?
A vantagem é uma maior eficiência em amostras e uma tentativa e erro mais segura: imaginar no interior de um modelo pode reduzir a exploração perigosa, e as previsões condicionadas pela ação podem basear o planeamento em dinâmicas passíveis de inspeção. Os limites e riscos surgem frequentemente quando um modelo parece correto, mas não é fiável, pois uma representação interna sofisticada não equivale a um comportamento que resista à implementação.
| Mecanismo |
O que se observa |
Porque fica oculto |
Questões de verificação |
| Física simulada incorretamente |
Trajetórias fluidas que infringem conservação/contacto |
A visão confia na fluidez |
As quantidades essenciais conservam-se? Os objetos podem atravessar-se? |
| Desvio em horizontes temporais longos |
Projeções curtas adequadas; as longas colapsam |
As demonstrações favorecem clipes curtos |
Como cresce o erro com os passos? Existe replaneamento? |
| Falha fora da distribuição |
Falha com novos objetos, iluminação ou intervalos de ação |
As pontuações dentro da distribuição parecem robustas |
Protocolo OOD? Modos de falha públicos? |
| Avaliação rigorosa |
Não existe uma pontuação partilhada de “compreensão do mundo” |
O sucesso da tarefa absorve a métrica |
Para além da pontuação da tarefa, é comunicado o erro de previsão? |
| Fronteira face a simulações programadas manualmente |
Modelos aprendidos tratados como motores verificados |
O marketing mistura simulador / modelo do mundo |
Que restrições são codificadas? Quais são apenas ajustamentos? |
A transferência para a realidade é difícil devido à diferença entre simulação e realidade. Bons testes devem questionar se o modelo prevê resultados controláveis sob ação, e não apenas imagens plausíveis.
Utilizar a tabela como uma lista de verificação de alegações: confirmar uma interface condicionada pela ação, exigir depois evidências de longo horizonte e fora da distribuição e, por fim, separar “parece bom” de “as dinâmicas são passíveis de planeamento”. Sem essas evidências, uma formulação mais prudente é “inclui componentes de modelo do mundo ou objetivos de investigação”, e não “tem um modelo do mundo completo”. Como os agentes têm capacidade limitada, a avaliação deve centrar-se no estado relevante para o objetivo, e não na reprodução integral da cena.
Resumo
Os modelos do mundo levam a IA de “consegue falar / consegue desenhar” para “consegue antecipar as consequências das ações”, como prever que um robô vai derrubar um copo se seguir o caminho errado. O núcleo operacional é um ciclo fechado de estado, ação e previsão, sendo a previsão condicionada pela ação o eixo de decisão mais claro.
As três abordagens — MBRL/treino por imaginação, simulação interativa generativa e representações preditivas JEPA — servem objetivos diferentes e não são intermutáveis. Em comparação com os LLM e os geradores de vídeo, importa comparar os alvos de previsão e as interfaces de ação; na avaliação, dar prioridade a física simulada incorretamente, desvio, falhas OOD, métricas rigorosas e fronteiras de simuladores.
Perguntas frequentes
O que é um modelo do mundo?
Um modelo do mundo é um modelo interno de dinâmicas aprendido que representa como um ambiente pode mudar tendo em conta um estado atual (ou observação) e uma ação. O mundo em qualquer momento é mais rico do que aquilo que um agente consegue observar diretamente, pelo que o modelo resume as variáveis relevantes para o planeamento — por exemplo, onde termina um robô depois de virar à esquerda. O seu objetivo é apoiar o planeamento e a tentativa e erro por imaginação, não apenas gerar texto ou aparência de vídeo.
Em que difere um modelo do mundo de um modelo de linguagem de grande dimensão?
Os modelos de linguagem de grande dimensão preveem sobretudo o token seguinte e destacam-se na linguagem e na orquestração de conhecimento; os modelos do mundo preveem sobretudo como o estado evolui após ações para controlo e planeamento. Um LLM pode discutir física sem fornecer dinâmicas ambientais passíveis de projeção e avaliação.
Como funciona um modelo do mundo?
Um ciclo típico codifica observações num estado, condiciona esse estado a uma ação candidata, prevê o estado seguinte após essa ação e pode projetar a evolução no espaço latente. Um planeador compara projeções imaginadas, executa uma ação e, em seguida, atualiza o estado a partir de uma nova observação.
O Sora ou a geração de vídeo contam como um modelo do mundo?
Não automaticamente. Se um sistema produz sobretudo vídeo visualmente coerente sem uma interface estável condicionada pela ação, transições de estado verificáveis e utilização para planeamento, é mais correto descrevê-lo como um gerador de vídeo. Só se aproxima de um modelo do mundo quando são demonstradas previsão condicionada pela ação e um ciclo passível de planeamento.
Em que difere um modelo do mundo de um simulador tradicional?
Os simuladores tradicionais geralmente codificam regras e restrições físicas programadas manualmente, enquanto os modelos do mundo orientados por dados são frequentemente aprendidos com redes neuronais. Os modelos aprendidos podem ser mais flexíveis e aproximar-se mais do ruído dos sensores, mas também são mais propensos a física simulada incorretamente e a desvios em horizontes temporais longos, não devendo ser considerados equivalentes a um motor de física verificado.