Em 3 de novembro de 2026, a AMD divulgou os resultados financeiros do terceiro trimestre, com as receitas trimestrais a atingirem 13,377 mil milhões de dólares, um aumento de 45% em termos homólogos. As receitas do segmento de centros de dados atingiram 8,546 mil milhões de dólares, um aumento de 97% em termos homólogos. A empresa espera receitas de aproximadamente 17 mil milhões de dólares no quarto trimestre e salientou que as GPU Instinct, os CPU EPYC e os sistemas à escala de rack Helios vão impulsionar conjuntamente o crescimento do seu negócio de centros de dados. Estes desenvolvimentos aumentaram a atenção dos investidores sobre a possibilidade de a AMD captar uma maior quota do mercado de computação de IA, dominado pela NVIDIA.
No entanto, a concorrência em chips de IA não se resume à comparação do desempenho dos produtos de duas empresas. A capacidade de memória das GPU, o débito de inferência, a compatibilidade de software, as redes, o consumo de energia e o custo total de propriedade podem influenciar as decisões de aquisição dos principais fornecedores de serviços na nuvem. Este artigo analisa a dinâmica competitiva entre a AMD e a NVIDIA através das características técnicas da inferência de IA, bem como o significado destas mudanças para o setor dos chips de IA e para os investidores em ações dos EUA relacionados.
Principais conclusões
-
A concorrência nos chips de IA está a expandir-se da computação para treino para a eficiência de inferência. À medida que as aplicações de modelos de linguagem de grande dimensão aumentam de escala, os custos de computação, a velocidade de resposta e o consumo de energia durante a inferência estão a tornar-se fatores importantes nas aquisições para centros de dados.
-
A AMD está a expandir o seu negócio de IA para centros de dados. No terceiro trimestre de 2026, as receitas da AMD em centros de dados atingiram aproximadamente 8,55 mil milhões de dólares, um aumento de 97% em termos homólogos, levando as receitas totais da empresa a um novo máximo.
-
A vantagem competitiva da NVIDIA vai além do hardware GPU. O seu ecossistema de software CUDA, as redes, as ferramentas para programadores e os sistemas de rack integrados proporcionam fortes capacidades de integração de sistemas para implementações de infraestruturas de IA em grande escala.
-
A AMD procura criar uma alternativa abrangente através das GPU Instinct, do Helios e do ROCm. O seu foco competitivo está gradualmente a mudar do desempenho de chips individuais para capacidades de computação ao nível do sistema e para o custo total de propriedade.
-
O aumento da procura de inferência de IA não significa necessariamente que as ações da AMD ou da NVIDIA vão subir. Os investidores devem também acompanhar as capacidades de entrega de chips, as margens de lucro, as despesas de capital dos clientes e as avaliações de mercado.
O que é a inferência de IA? Em que difere do treino de modelos de IA?
A inferência de IA refere-se ao processo computacional no qual um modelo de inteligência artificial treinado gera previsões, texto, imagens ou outros resultados com base na introdução do utilizador. Por exemplo, quando um utilizador coloca uma pergunta a um assistente de IA e o modelo gera progressivamente uma resposta com base na introdução, esse processo é inferência. Ao contrário do treino, que ajusta continuamente os parâmetros do modelo, a inferência padrão utiliza principalmente parâmetros de modelo existentes para realizar cálculos. No entanto, alguns sistemas de inferência podem também incorporar recuperação de informação, chamadas de ferramentas e etapas computacionais adicionais.
O treino e a inferência de IA têm requisitos significativamente diferentes em termos de recursos computacionais. O treino de modelos de grande dimensão exige normalmente que muitas GPU trabalhem em conjunto durante períodos prolongados, criando requisitos elevados de desempenho computacional, capacidade de memória e interligações de alta velocidade. A inferência dá maior importância ao tempo de resposta dos pedidos, ao número de tarefas que podem ser processadas por unidade de tempo e ao custo de computação necessário para cada pedido. Em aplicações como conversas em tempo real e assistentes de voz, os utilizadores são muito sensíveis à latência de resposta. Em tarefas de processamento de texto em lote ou de análise de dados, o débito global e o custo podem ser mais importantes.
| Dimensão de comparação |
Treino de IA |
Inferência de IA |
| Objetivo principal |
Aprender e otimizar os parâmetros do modelo |
Utilizar o modelo para gerar resultados |
| Características computacionais |
Computação em grande escala e de longa duração |
Processamento contínuo e de elevada frequência de pedidos |
| Métricas principais |
Velocidade de treino, eficiência de escalabilidade |
Latência, débito, custo por unidade |
| Requisitos de memória |
Parâmetros, gradientes e estados de treino |
Pesos do modelo, cache KV e mais |
| Casos de utilização empresarial |
Desenvolvimento de modelos fundacionais |
Assistentes de IA, pesquisa, Agents, aplicações empresariais |
À medida que as aplicações de IA aumentam de escala, os pedidos de inferência podem continuar a crescer. Por exemplo, um modelo pode exigir apenas um número limitado de execuções de treino em grande escala, mas poderá servir milhões de utilizadores durante um longo período após a implementação. Isto cria a possibilidade de as despesas acumuladas com inferência se tornarem uma importante fonte de custos de infraestrutura de IA. No entanto, a proporção entre as despesas com treino e com inferência varia significativamente entre modelos e aplicações, pelo que não se pode assumir que os custos de inferência vão sempre exceder os custos de treino.
Porque está a inferência de IA a tornar-se um foco da concorrência entre a AMD e a NVIDIA?
O mercado de inferência de IA está a ganhar atenção principalmente porque os modelos de negócio de IA estão a evoluir da concorrência nas capacidades dos modelos para a concorrência nos custos reais de utilização. Para os fornecedores de serviços na nuvem e os programadores de aplicações de IA, a capacidade de um modelo concluir tarefas é apenas um requisito básico. A capacidade de prestar continuamente serviços a um grande número de utilizadores a um custo razoável também determina se o produto pode ser comercializado. À medida que o número de utilizadores e a frequência das chamadas aumentam, mesmo uma pequena redução do custo por inferência pode ter um impacto significativo nas despesas operacionais globais.
As cargas de trabalho de inferência não são idênticas. As conversas em tempo real exigem baixa latência, os modelos de raciocínio complexo podem necessitar de gerar processos de raciocínio extensos e os Agents de IA podem chamar modelos, recuperar dados e executar ferramentas várias vezes numa única tarefa. Diferentes cargas de trabalho têm requisitos distintos de precisão computacional, capacidade de memória, largura de banda de memória e interligações de sistema. Isto cria espaço para a concorrência entre diferentes arquiteturas de hardware e significa que é difícil determinar qual o chip que apresenta vantagem com base numa única métrica de desempenho.
Para a AMD, a importância do mercado de inferência reside no seu potencial para expandir a quota de mercado de GPU de IA. Os principais fornecedores de serviços na nuvem procuram normalmente evitar uma dependência excessiva de um único fornecedor, ao mesmo tempo que controlam os custos de aquisição de hardware. Se a AMD conseguir oferecer uma alternativa competitiva em desempenho, preços, compatibilidade de software e capacidades de entrega, poderá participar em mais planos de aquisição para centros de dados. No entanto, a NVIDIA também está continuamente a otimizar os seus produtos de inferência e plataformas de software, pelo que o crescimento da procura de inferência não significa necessariamente que a posição competitiva da NVIDIA vai enfraquecer.
Como tem evoluído recentemente o negócio de centros de dados da AMD?
Os resultados do terceiro trimestre da AMD, anunciados em novembro de 2026, mostram que os centros de dados se tornaram uma das fontes mais importantes de crescimento do negócio da empresa. As receitas totais atingiram 13,377 mil milhões de dólares, um aumento de 45% em termos homólogos, enquanto as receitas dos centros de dados atingiram 8,546 mil milhões de dólares, um aumento de 97% em termos homólogos. Durante o mesmo período, os lucros por ação não GAAP atingiram 2,09 $, um aumento de 74% em termos homólogos, refletindo a contribuição da expansão dos centros de dados para a rentabilidade global.
Importa salientar que o negócio de centros de dados da AMD inclui não só as GPU de IA Instinct, mas também os CPU para servidores EPYC. Por conseguinte, nem todas as receitas de centros de dados devem ser tratadas diretamente como receitas de chips de inferência de IA. O crescimento do negócio da empresa é impulsionado tanto pela procura de aceleradores de IA como pela procura de computação para servidores de uso geral. Para os investidores, determinar se a AMD está realmente a expandir a sua quota de mercado de GPU de IA exige uma observação adicional das remessas de produtos, das implementações dos clientes e da composição específica do negócio.
A AMD também espera receitas totais de aproximadamente 17 mil milhões de dólares no quarto trimestre de 2026, mantendo o crescimento face ao terceiro trimestre. A empresa está também a avançar com a implementação de sistemas à escala de rack Helios e a expandir a cooperação com os principais fornecedores de serviços na nuvem e empresas de IA. Estes desenvolvimentos indicam que a AMD procura evoluir de fornecedora de chips para fornecedora mais abrangente de infraestrutura de IA. No entanto, a possibilidade de as receitas futuras continuarem a crescer depende ainda das aquisições dos clientes, das cadeias de abastecimento e da competitividade dos produtos.
Quais são as diferenças entre as GPU AMD Instinct e NVIDIA para inferência de IA?
Tanto as GPU de IA da AMD como as da NVIDIA podem suportar tarefas de treino e inferência de modelos, mas as empresas diferem nos seus roteiros de produtos, ecossistemas de software e abordagens à integração de sistemas. A série Instinct da AMD visa principalmente a computação de alto desempenho e a aceleração de IA em centros de dados, enquanto a NVIDIA criou uma estrutura de computação de IA mais abrangente através de GPU para centros de dados, da plataforma de software CUDA e de tecnologias de rede complementares.
Para tarefas de inferência, o desempenho computacional teórico de uma GPU é apenas um critério de avaliação. Os modelos necessitam de aceder frequentemente a pesos e dados intermédios, tornando a capacidade de memória, a largura de banda de memória e a gestão de cache igualmente importantes. Uma maior capacidade de memória ajuda a acomodar os parâmetros do modelo e a cache KV gerada por mais pedidos simultâneos, enquanto uma maior largura de banda de memória pode reduzir os estrangulamentos de acesso a dados em determinadas tarefas de inferência. No entanto, os benefícios específicos dependem da dimensão do modelo, da precisão de quantização, da estratégia de processamento em lote e do nível de otimização de software.
A vantagem da NVIDIA reside nas suas capacidades de coordenação entre hardware e software. Além das GPU, a NVIDIA disponibiliza CUDA, TensorRT-LLM, estruturas de disponibilização de inferência e tecnologias de interligação de alta velocidade, permitindo aos programadores implementar cargas de trabalho de IA com base numa cadeia de ferramentas relativamente madura. Por sua vez, a AMD está a melhorar a compatibilidade e o desempenho do sistema através do ROCm, das GPU Instinct e dos sistemas Helios, procurando reduzir os custos de migração para clientes que adotem hardware alternativo.
| Dimensão de comparação |
AMD |
NVIDIA |
| Aceleradores de IA |
Série Instinct |
Série de GPU para centros de dados |
| Ecossistema de software |
ROCm |
CUDA |
| Soluções ao nível do sistema |
Helios |
Plataformas à escala de rack, como NVL |
| Foco competitivo principal |
Ecossistema aberto, custo e desempenho |
Maturidade de software, integração de sistemas |
| Foco da otimização de inferência |
Capacidade de memória, débito, adaptação de software |
Latência, débito, coordenação entre hardware e software |
| Principais desafios |
Compatibilidade do ecossistema e maturidade de implementação |
Custos de sistema e concentração de fornecedores dos clientes |
É importante salientar que a comparação acima reflete o posicionamento de produtos e ecossistemas, e não uma classificação universal de desempenho. Diferentes GPU podem apresentar desempenhos significativamente distintos em diferentes modelos, níveis de precisão e condições de implementação. A eficiência real de inferência não pode ser determinada apenas pela capacidade de memória ou pelo desempenho computacional teórico.
Porque afetam o CUDA e o ROCm o panorama competitivo dos chips de IA?
O CUDA é a plataforma de computação paralela desenvolvida há muito tempo pela NVIDIA, enquanto o ROCm é a plataforma de software da AMD para computação com GPU e cargas de trabalho de IA. Ambas fornecem ferramentas de desenvolvimento, bibliotecas de computação e ambientes de execução que permitem aos programadores utilizar GPU para tarefas computacionais complexas. Para as grandes empresas de IA, a seleção de GPU envolve mais do que a aquisição de hardware. Também diz respeito à possibilidade de o código de modelos existente, as estruturas de treino, os motores de inferência e os sistemas operacionais funcionarem de forma fiável.
A vantagem competitiva do CUDA resulta do seu ecossistema de software estabelecido há muito tempo. Muitos modelos de IA e ferramentas de desenvolvimento já foram adaptados e otimizados para GPU da NVIDIA, pelo que as empresas que utilizam hardware NVIDIA podem frequentemente reduzir parte do trabalho de migração e depuração. Especialmente em ambientes de clusters em grande escala, a estabilidade do software, as ferramentas de análise de desempenho e o apoio técnico podem afetar diretamente a utilização dos recursos computacionais.
A AMD está a melhorar a experiência dos programadores e o suporte para as principais estruturas de IA através do ROCm. No terceiro trimestre de 2026, a AMD lançou o ROCm 10, melhorando ainda mais as ferramentas de desenvolvimento relacionadas, os compiladores, as bibliotecas de computação e o suporte a modelos. Estas melhorias ajudam a expandir a gama de aplicações para GPU da AMD, mas o lançamento de uma nova versão não significa que todas as aplicações CUDA possam ser migradas para o ROCm sem modificações.
Numa perspetiva comercial, a compatibilidade de software afeta o custo total de propriedade real das GPU. Se uma empresa adquirir aceleradores de preço inferior, mas tiver de investir recursos de engenharia substanciais para reotimizar modelos, a poupança nos custos de hardware poderá ser anulada pelos custos de desenvolvimento. Por conseguinte, a concorrência entre a AMD e a NVIDIA ocorre não só ao nível dos chips, mas também nos ecossistemas de programadores, nas estruturas de inferência e na eficiência de implementação dos sistemas.
Como altera o AMD Helios a concorrência ao nível do sistema com a NVIDIA?
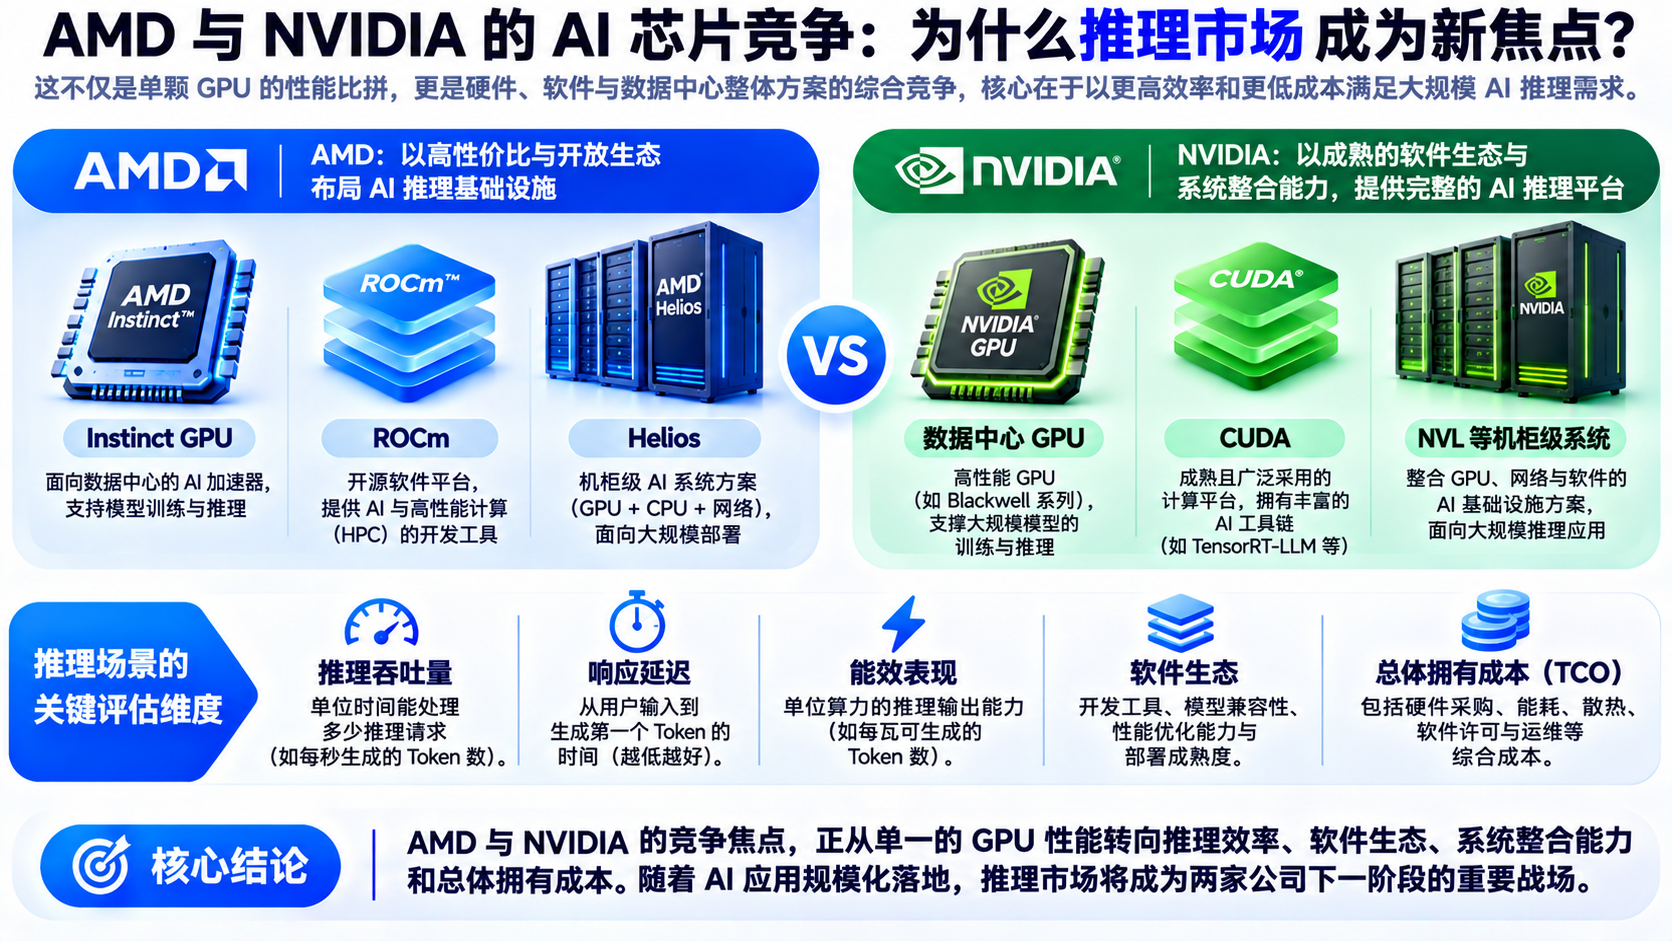
O Helios é a plataforma de computação à escala de rack da AMD para grandes centros de dados de IA. Combina GPU Instinct, CPU EPYC, interligações de rede e componentes de software relacionados para disponibilizar aos clientes um sistema de computação de IA mais completo. Em comparação com a aquisição separada de GPU e a posterior integração de sistemas, as soluções à escala de rack podem otimizar o design de computação, comunicações e implementação numa arquitetura unificada.
Esta mudança reflete a forma como a concorrência em infraestruturas de IA está a expandir-se de chips individuais para sistemas de computação completos. O treino e a inferência de modelos de grande dimensão exigem normalmente que várias GPU trabalhem em conjunto. As velocidades de transferência de dados entre GPU, as interligações nos servidores, a topologia de rede e as capacidades de arrefecimento podem afetar a eficiência global. Mesmo que um chip individual tenha elevado desempenho computacional, o débito real do cluster pode continuar limitado se a comunicação do sistema se tornar um estrangulamento.
A NVIDIA já estabeleceu uma gama de produtos relativamente completa através de sistemas de IA à escala de rack, enquanto a AMD procura oferecer outra opção através do Helios. No seu mais recente anúncio de resultados, a AMD declarou que clientes como Anthropic, Meta, Microsoft, OpenAI e Oracle Cloud Infrastructure estão a executar modelos ou cargas de trabalho baseados nas primeiras soluções Helios. Estas implementações indicam que a AMD está a avançar com a disponibilização de produtos ao nível do sistema, mas a escala de implementação, o montante de aquisição e a fase de comercialização de cada cliente ainda devem ser avaliados separadamente.
Para os principais fornecedores de serviços na nuvem, ter vários fornecedores competitivos de sistemas de IA pode aumentar a flexibilidade de aquisição e reduzir o risco de concentração na cadeia de abastecimento. No entanto, a concorrência ao nível do sistema também coloca requisitos mais elevados à AMD, incluindo o fornecimento de chips, as interligações de rede, a estabilidade do software, a implementação de racks e a manutenção a longo prazo.
Porque são os custos de inferência de IA mais importantes do que o desempenho individual das GPU?
O valor comercial da inferência de IA depende, em última análise, da possibilidade de prestar serviços continuamente a um custo aceitável. Para plataformas de IA que processam um grande número de pedidos todos os dias, os preços de aquisição das GPU são apenas uma parte do custo. A utilização dos servidores, o consumo de energia, o arrefecimento, as redes, a manutenção e a eficiência de execução dos modelos podem afetar a despesa total.
Por exemplo, suponha-se que dois sistemas de GPU têm custos de aquisição de 1 milhão de dólares e 1,2 milhões de dólares, respetivamente. Se o segundo conseguir processar mais pedidos com a mesma qualidade de serviço ou reduzir significativamente o consumo de energia de cada inferência, o sistema de preço mais elevado poderá ainda ter um custo por inferência mais baixo a longo prazo. Por outro lado, se um sistema tiver elevado desempenho teórico, mas as aplicações reais não conseguirem utilizar plenamente os seus recursos de hardware, a sua viabilidade económica poderá ficar abaixo das expectativas.
Por conseguinte, ao avaliar chips de inferência de IA, é importante considerar métricas como o número de Tokens gerados por segundo, o tempo até ao primeiro Token, a capacidade de pedidos simultâneos e o custo real de processamento por milhão de Tokens. Diferentes modelos e cargas de trabalho atribuem níveis de importância distintos a estas métricas. Por exemplo, as interações de voz em tempo real dão prioridade à latência, enquanto a análise de documentos em lote pode dar maior importância ao débito e ao custo unitário.
Esta mudança significa que a AMD não precisa necessariamente de superar a NVIDIA em todas as métricas de desempenho para obter oportunidades de mercado. Desde que os seus produtos possam proporcionar custos e desempenho competitivos para cargas de trabalho específicas, cumprindo simultaneamente os requisitos dos clientes em matéria de estabilidade e suporte de software, podem tornar-se alternativas viáveis. Do mesmo modo, a NVIDIA pode manter a competitividade através da otimização de software e da eficiência do sistema, em vez de depender apenas de um desempenho teórico superior dos chips.
Como vai afetar a concorrência no mercado de inferência de IA as avaliações das ações da AMD e da NVIDIA?
A AMD e a NVIDIA são ambas importantes empresas cotadas do setor de semicondutores dos EUA, mas os investidores não aplicam exatamente a mesma lógica de avaliação às duas empresas. A NVIDIA já criou um negócio de computação de IA em grande escala e um ecossistema relativamente maduro de hardware e software, e o mercado concentra-se geralmente na sua capacidade de manter a escala de receitas, as margens de lucro e as vantagens tecnológicas. Por sua vez, a AMD tem a oportunidade de expandir a sua quota no mercado de IA, pelo que os investidores estão mais centrados na possibilidade de as novas implementações de produtos, as encomendas de clientes e o crescimento das receitas se traduzirem em rentabilidade sustentável.
A expansão do mercado de inferência de IA pode beneficiar vários fornecedores de chips ao mesmo tempo, mas o crescimento da procura de mercado não significa que os lucros de todas as empresas vão aumentar proporcionalmente. À medida que a concorrência se intensifica, os preços dos produtos, o poder negocial dos clientes e o investimento em investigação e desenvolvimento podem mudar. Se as empresas reduzirem os preços para ganhar quota de mercado ou tiverem de dedicar mais recursos ao apoio às implementações dos clientes, o crescimento das receitas poderá não proporcionar o mesmo nível de crescimento dos lucros.
Além disso, os preços das ações dependem da proporção das expectativas de crescimento que o mercado já incorporou nos preços. Mesmo que uma empresa divulgue resultados financeiros sólidos, o preço das suas ações pode continuar sob pressão se os investidores esperassem mais. Por outro lado, se as entregas reais, as margens de lucro ou as perspetivas de uma empresa excederem as expectativas, o mercado poderá reavaliar a sua avaliação. Por conseguinte, avaliar o valor de investimento da AMD e da NVIDIA exige mais do que comparar qual GPU apresenta maior desempenho. Exige também a consideração da composição das receitas, da rentabilidade, das despesas de capital, do ambiente competitivo e dos múltiplos de avaliação.
Que indicadores do mercado de inferência de IA devem os investidores acompanhar?
Os investidores que procuram compreender os movimentos das ações de chips de IA podem observar as mudanças do mercado a partir de três perspetivas. A primeira é a procura, incluindo as despesas de capital em IA dos principais fornecedores de serviços na nuvem, a utilização de serviços de inferência e as implementações reais por clientes empresariais. Estes indicadores podem ajudar a determinar se a procura de capacidade computacional de IA continua a expandir-se, mas os planos de despesas de capital não equivalem a receitas confirmadas para os fabricantes de chips.
A segunda é a oferta, incluindo os volumes de entrega de GPU, o fornecimento de memória de elevada largura de banda (HBM), a capacidade de encapsulamento avançado e o progresso na implementação de sistemas. Mesmo quando a procura de mercado é forte, os fabricantes de chips poderão não conseguir concluir as entregas conforme planeado se o fornecimento de componentes críticos for insuficiente. Tanto a AMD como a NVIDIA dependem de cadeias de abastecimento de semicondutores complexas, pelo que as restrições de oferta podem afetar o ritmo de crescimento de ambas as empresas.
A última área inclui as métricas de rentabilidade e avaliação. Os investidores podem acompanhar as receitas dos centros de dados, a margem bruta, a margem operacional, o fluxo de caixa livre e as alterações nas expectativas do mercado e, em seguida, utilizar rácios preço-lucro ou múltiplos de lucros futuros para avaliar se o preço das ações é razoável. É particularmente importante distinguir entre os resultados financeiros já alcançados e as orientações prospetivas da administração, bem como evitar tratar encomendas não cumpridas ou previsões de crescimento como receitas certas.
Resumo
A concorrência entre a AMD e a NVIDIA em chips de IA está a expandir-se de uma comparação pura de desempenho computacional para a eficiência de inferência, os ecossistemas de software, os sistemas à escala de rack e o custo total de propriedade. À medida que as aplicações de IA entram na fase de implementação em escala, os centros de dados necessitam não só de capacidades computacionais mais fortes, mas também da capacidade de processar continuamente grandes volumes de pedidos de utilizadores a custos mais razoáveis.
O rápido crescimento do negócio de centros de dados da AMD no terceiro trimestre de 2026, juntamente com o desenvolvimento contínuo do Instinct, ROCm e Helios, indica que a empresa está a expandir o seu negócio de infraestrutura de IA. No entanto, a NVIDIA mantém vantagens importantes no CUDA, na integração de sistemas e no ecossistema de programadores. O resultado da concorrência futura vai depender das entregas de produtos, do desempenho no mundo real, da adoção pelos clientes e da rentabilidade comercial, e não de uma única métrica técnica de uma geração de chips.
Para os investidores em ações, o mercado de inferência de IA proporciona uma nova perspetiva para observar o setor dos semicondutores, mas a competitividade tecnológica e os retornos do investimento em ações não são diretamente equivalentes. Analisar em conjunto a procura do setor, a rentabilidade empresarial e as avaliações de mercado proporciona uma compreensão mais abrangente do panorama competitivo entre a AMD e a NVIDIA.
Perguntas frequentes
O que é a inferência de IA?
A inferência de IA é o processo de utilizar um modelo de inteligência artificial treinado para processar introduções e gerar resultados, como conversas de IA, geração de imagens, reconhecimento de voz e tarefas realizadas por assistentes inteligentes.
Porque está o mercado de inferência de IA a tornar-se mais importante?
À medida que o número de utilizadores de aplicações de IA e a frequência de utilização aumentam, as empresas têm de suportar continuamente custos substanciais de computação para inferência. Como resultado, a velocidade de inferência, o débito, o consumo de energia e os custos unitários estão a tornar-se mais importantes.
As GPU de IA da AMD podem substituir a NVIDIA?
Para determinados modelos e cenários de aplicação suportados, as GPU da AMD podem servir como alternativa à NVIDIA. No entanto, a viabilidade real depende da compatibilidade de software, do desempenho, dos custos de implementação e dos requisitos dos clientes. As duas não devem ser consideradas totalmente equivalentes em todos os cenários.
Qual é a diferença entre CUDA e ROCm?
O CUDA é a plataforma de computação paralela com GPU da NVIDIA, enquanto o ROCm é a plataforma de software de computação com GPU da AMD. Ambas suportam computação de IA, mas diferem nas ferramentas de desenvolvimento, na maturidade do ecossistema e na compatibilidade específica.
O que é o AMD Helios?
O Helios é a plataforma de computação de IA à escala de rack da AMD que integra GPU, CPU, interligações e componentes de software para cargas de trabalho de treino e inferência de IA em grandes centros de dados.
O crescimento da procura de inferência de IA significa que as ações da AMD vão definitivamente subir?
Não necessariamente. Os preços das ações são afetados não só pelo crescimento do negócio, mas também pela rentabilidade, pelo panorama competitivo, pelas cadeias de abastecimento, pelas expectativas do mercado e pelas avaliações das ações.







