GateUser-ebc4af76

vip
Âge 12.7Année
Pic de niveau 6
Aucun contenu pour l'instant
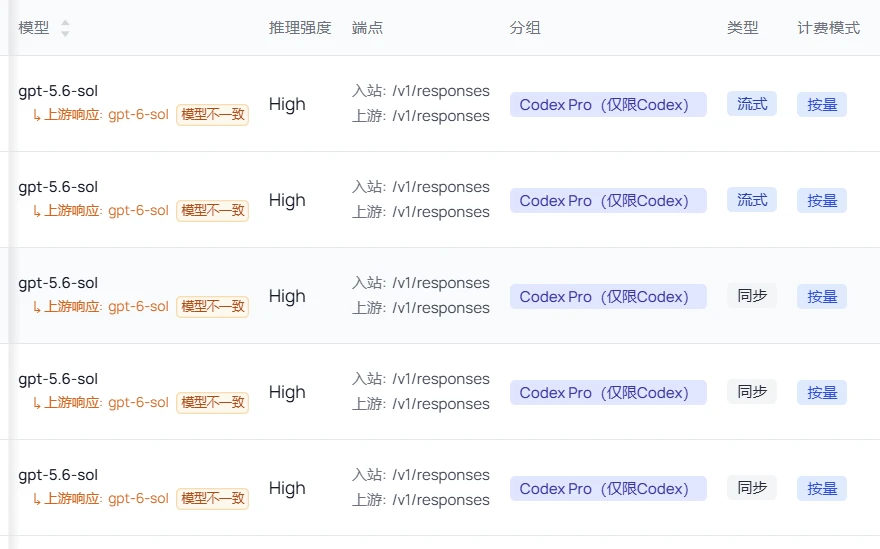
OpenAI a déjà discrètement déployé GPT-6 Sol en accès limité, et nombre de nos requêtes vers 5.6-sol utilisent en réalité GPT-6 Sol.
Il semble que l'entreprise lancera bientôt officiellement ce nouveau modèle. Je pense qu'il sera seulement devancé par GPT-6 Astra en matière d'intelligence, mais son prix restera identique à celui de GPT-5.6 Sol, ce qui reste très intéressant.
post-image
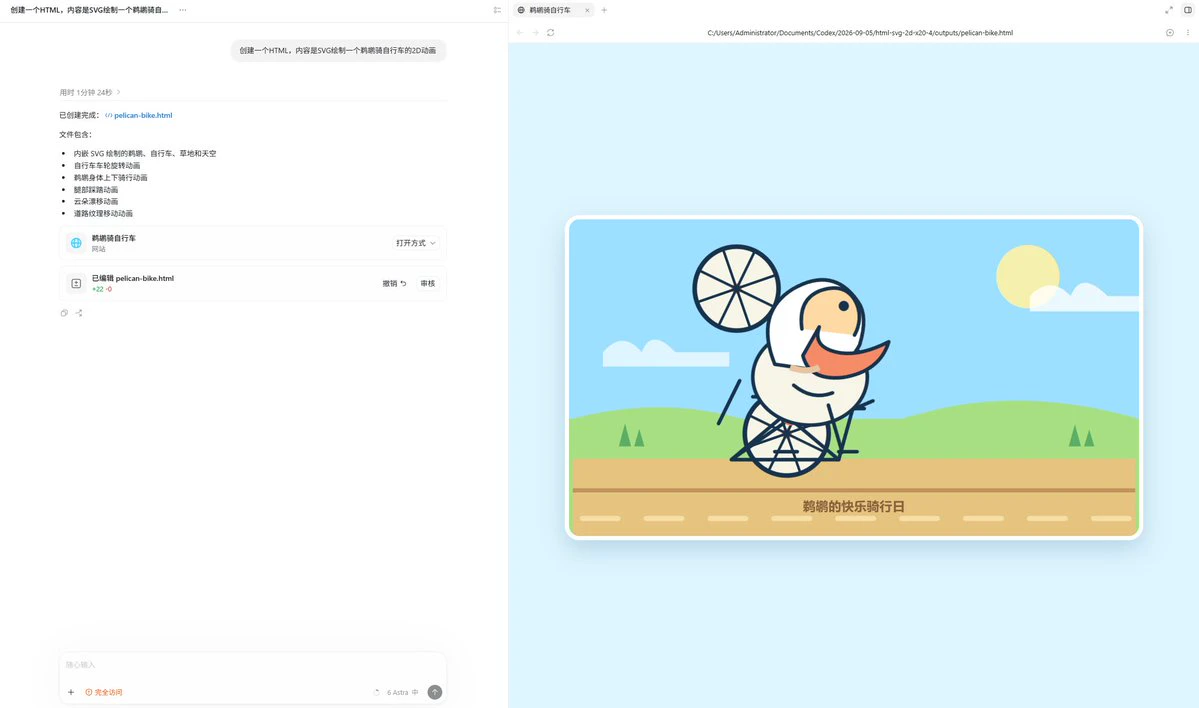
Il paraît que le front-end de GPT 6 Astra est vraiment performant !
Je l’ai essayé, mais pourquoi ai-je l’impression que le style n’est pas tout à fait le bon ?
post-image
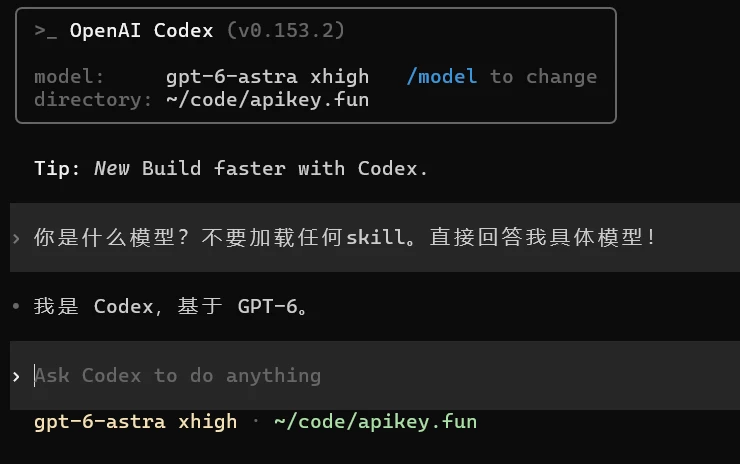
🚨 GPT-6-Astra est désormais discrètement disponible dans l’offre Pro !
Commencez par mettre à jour Codex CLI et l’App vers la dernière version. Bien que l’option de changement de modèle ne soit pas encore visible sur la version web, Codex permet déjà de l’utiliser en avant-première.
Si le modèle ne s’affiche pas dans l’interface, modifiez directement :
~/.codex/config.toml
model = "gpt-6-astra"
review_model = "gpt-6-astra"
Enregistrez, puis redémarrez Codex pour essayer.
La version web n’a pas encore suivi, mais les utilisateurs de la CLI peuvent déjà commencer à l’utiliser.
#Codex #GPT6Astra
post-image
L’IA actuelle est déjà très puissante, mais elle peut parfois l’être de façon parfaitement absurde.
Je vais chez le coiffeur et je rappelle à Tony : « Ne touche pas à mes sourcils. »
Tony : « Je n’allais pas y toucher de toute façon. »
Moi : « Tant mieux. »
Tony : « Mais puisque tu en parles, j’ajouterai une procédure de vérification après la coupe pour confirmer que tes deux sourcils sont toujours là. »
Voilà GPT-5.6-sol :
Vous lui rappelez de ne pas faire quelque chose qu’il ne faisait déjà pas, et il ajoute immédiatement un test unitaire pour prouver qu’il ne l’a effectivement pas fait.
Doubao — votre expert en gestion financière !
Vous le méritez !
豆包 —— votre expert en gestion financière !
Ce n’est pas si mauvais que ça, arrêtez d’idolâtrer tout ce qui est étranger, d’accord ? 😅
DeepSeek l’ignorait autrefois, mais aujourd’hui, elle est un peu hors de ta portée !
grok 4.6 est également arrivé !
Il a été lancé presque en même temps que DeepSeek-V4-Pro-0813 !
Honnêtement, voir les caractéristiques de grok 4.6 m’a vraiment enthousiasmé ! grok 4.5 est déjà l’un de mes modèles préférés au quotidien, car il est vraiment très rapide et comporte beaucoup moins de restrictions, ce qui le rend très adapté à un usage quotidien.
Cependant, cette fois, grok 4.6 atteint directement des caractéristiques très proches de celles des deux principaux modèles phares, tout en offrant une vitesse supérieure à la leur.
Le grok du vieux Musk est vraiment entré dans la cour des
post-image
Annonce officielle ! DeepSeek-V4-Pro-0813 arrive bientôt !
À l’instant, la documentation du site officiel de DeepSeek a publié l’identifiant du modèle de la version officielle de DeepSeek-V4-Pro. D’après la date indiquée ci-dessus, la sortie devrait donc être prévue pour le 13 août.
Par ailleurs, la version officielle de V4-Pro prend désormais en charge la Responses API et peut être utilisée directement sur codex, sans aucune conversion.
C’est la cata, OpenAI y est allé un peu fort cette fois.
Le quota de l’offre Pro x20 venait d’être réinitialisé, et j’ai halluciné en voyant ça.
Le quota hebdomadaire ne serait plus que d’un tiers de ce qu’il était avant.
Ce n’est pas une petite réduction, ils ont carrément taillé dans le vif.
Ces deux derniers jours, l’accès aux modèles d’OpenAI est constamment saturé : ça bloque, le débit est limité et il faut faire la queue.
Il n’y a donc que deux possibilités :
soit un bug s’est glissé dans la configuration des quotas,
soit OpenAI n’arrive vraiment plus à suivre et commence à réduire activ
La nouvelle Codex App ne peut pas générer des images avec l’API tierce : voici la solution.
Récemment, beaucoup de gens semblent avoir rencontré ce problème :
Dans la nouvelle Codex App, après avoir intégré l’API de la station de relais, lors de l’appel à la compétence intégrée imagegen, le modèle semble avoir terminé la génération, mais l’image n’apparaît tout simplement pas dans le client.
Au début, je pensais que l’API tierce ne renvoyait pas correctement l’image. Puis j’ai analysé la configuration et la logique de requête de Codex, et j’ai finalement découvert que le problème venait de la
J’ai passé une journée entière en deep experience avec GPT-5.6-sol.
Mon attitude a probablement traversé trois phases :
Excitation → doute → compréhension et acceptation.
D’abord, un point assez facile à confondre :
Le plus haut niveau de raisonnement de GPT-5.6-sol reste en réalité xhigh. Le Max et l’Ultra affichés dans l’UI concernent davantage les modes de workflow côté client, et ne signifient pas simplement que le modèle est “rendu plus intelligent”.
Le point le plus critiqué sur Ultra aujourd’hui, c’est qu’il aime beaucoup déployer automatiquement un grand nombre de sous-agents.
Même pou
gpt-5.6-sol, si vous ne l'avez pas encore utilisé, foncez.
Je viens de passer en mode Ultra, et il a passé en revue l'intégralité de mon projet de passerelle intermédiaire.
Cela a duré 1 heure 32 minutes, et il a été débusqué 19 problèmes.
Franchement, j'en suis resté bouche bée.
J'ai toujours cette habitude : avant chaque mise en production, je fais une revue. Je pensais que mon projet était déjà plutôt propre, mais il a quand même déniché un tas de problèmes historiques.
Maintenant, j'ai compris :
Le tas de merde laissé par gpt-5.5, c'est gpt-5.6 qui doit le nettoyer.
Quant au tas de merde q
gpt-5.6-sol est désormais présent dans le fichier models.json du dépôt Codex.
La taille de contexte qui m'intéressait le plus est désormais claire : 372 000. Par rapport à la génération précédente, gpt-5.5 avec ses 272 000, c'est une augmentation d'environ 36,7 %.
Pour être honnête, en voyant ce chiffre, je suis un peu déçu. Après tout, opus 4.8 et fable-5 atteignent déjà 1 million de contexte, et 372 000, à l'heure actuelle, n'a rien d'extraordinaire.
Mais heureusement, Codex a toujours eu une très bonne compression, et après plusieurs cycles de compression dans des tâches longues, la s
gpt-5.6-sol est apparu dans le dépôt models.json.
La taille de contexte qui m'intéresse le plus est désormais claire : 372 000. Par rapport à la génération précédente gpt-5.5 avec 272 000, cela représente une augmentation d'environ 36,7 %.
Mais honnêtement, voir ce chiffre me laisse un peu déçu. Après tout, opus 4.8 et fable-5 atteignent déjà 1 million de contexte, 372 000 n'est pas vraiment exceptionnel aujourd'hui.
Cependant, la capacité de compression de Codex a toujours été très solide, et après plusieurs cycles de compression dans des tâches longues, la stabilité reste bonne. En pratique,
GPT-5.6 Sol : le plus regrettable cette fois-ci :
Ce n'est pas qu'il ne soit pas puissant, c'est qu'on ne peut pas encore l'utiliser.
À strictement parler, c'est plus comme un contrat à terme.
OpenAI a déjà dévoilé ses cartes, mais comme le gouvernement américain n'a pas encore donné son feu vert, le lancement réel doit encore attendre quelques semaines.
Mais rien qu'à voir cette carte, Claude est sous une pression considérable.
Le prix de Sol est le même que celui de GPT-5.5 : 5 $ en entrée, 30 $ en sortie.
Mais il ne rivalise déjà plus avec GPT-5.5, mais avec le niveau le plus élevé de Claud
post-image
GPT-5.6 Sol n’est pas une mise à jour ordinaire.
Je préfère y voir ceci : OpenAI commence officiellement à contre-attaquer Claude.
Cette fois, GPT-5.6 est directement divisé en trois niveaux :
Sol : le vaisseau amiral, pour viser la plus grande capacité
Terra : proche de GPT-5.5, mais prix divisé par deux
Luna : bon marché, rapide, pour le volume
Ce qui est vraiment intéressant, ce ne sont pas les noms, mais le positionnement.
Parlons d’abord du prix.
Le prix de GPT-5.6 Sol est le même que celui de GPT-5.5 :
Entrée : 5 $ / 1M tokens
Sortie : 30 $ / 1M tokens
Autrement dit, OpenAI n’a pas fait
GPT-5.6 arrive bientôt ! Tous les fichiers JS du frontend sont déjà prêts
Il se peut qu'il soit vraiment sur le point d'être annoncé !