Posts
Suivis
Populaire
Actualités
Profil

runesleo

vip
Âge 8.8Année
Pic de niveau 6
Aucun contenu pour l'instant
0
Suivis
15
Followers
119
Aimé
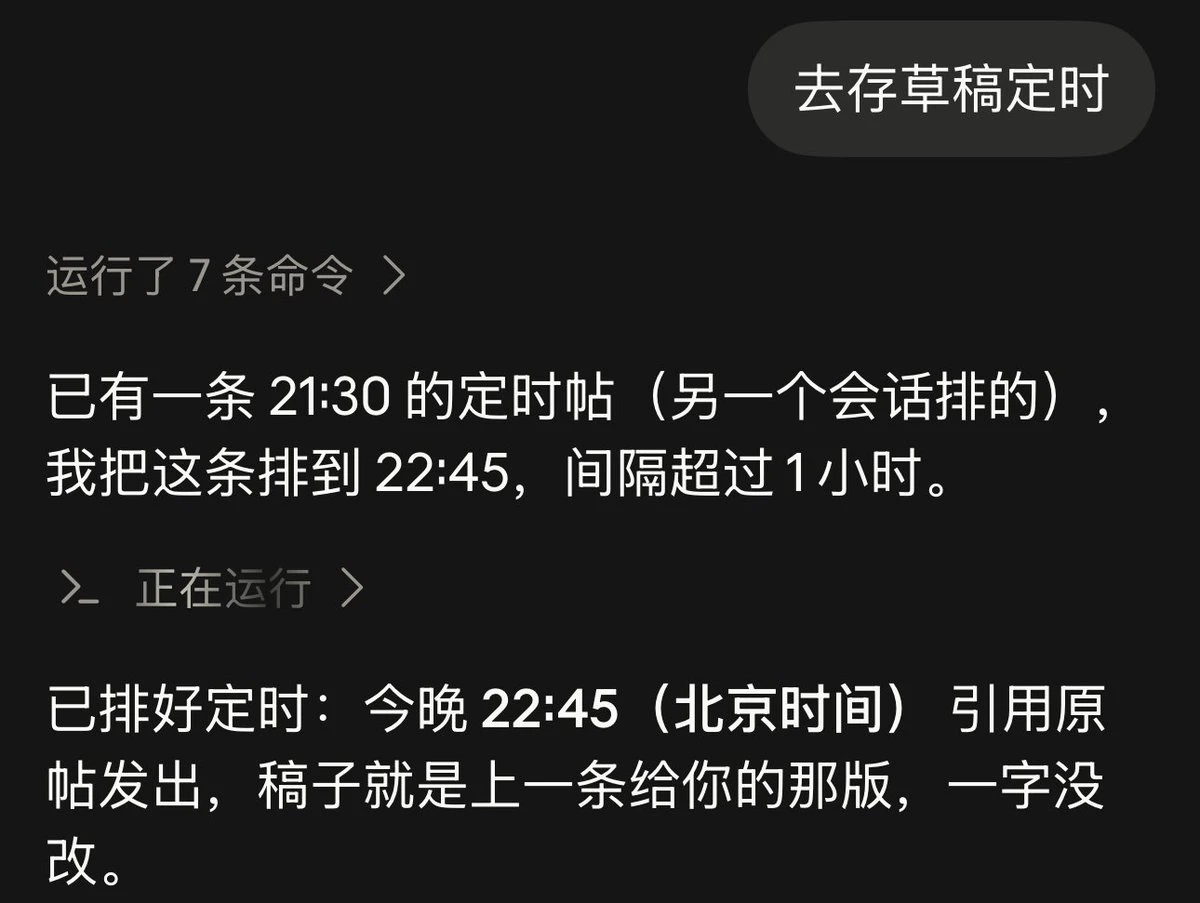
Je publie maintenant : il me suffit de dire à Claude sur mon téléphone « va enregistrer en brouillon et programmer ».
Il s’occupe du reste :
1. Il vérifie d’abord quels posts sont déjà programmés aujourd’hui, en les espaçant d’au moins 1 heure. J’ai analysé mes posts originaux des deux derniers mois : ceux espacés de moins de 15 minutes n’ont eu qu’une médiane de 35 impressions ; ceux espacés de 1 à 3 heures, 2 395
2. Il les publie automatiquement à l’heure prévue, les posts cités aussi
3. Avant la publication, il vérifie que le texte est identique au caractère près et que la carte de citation
post-image
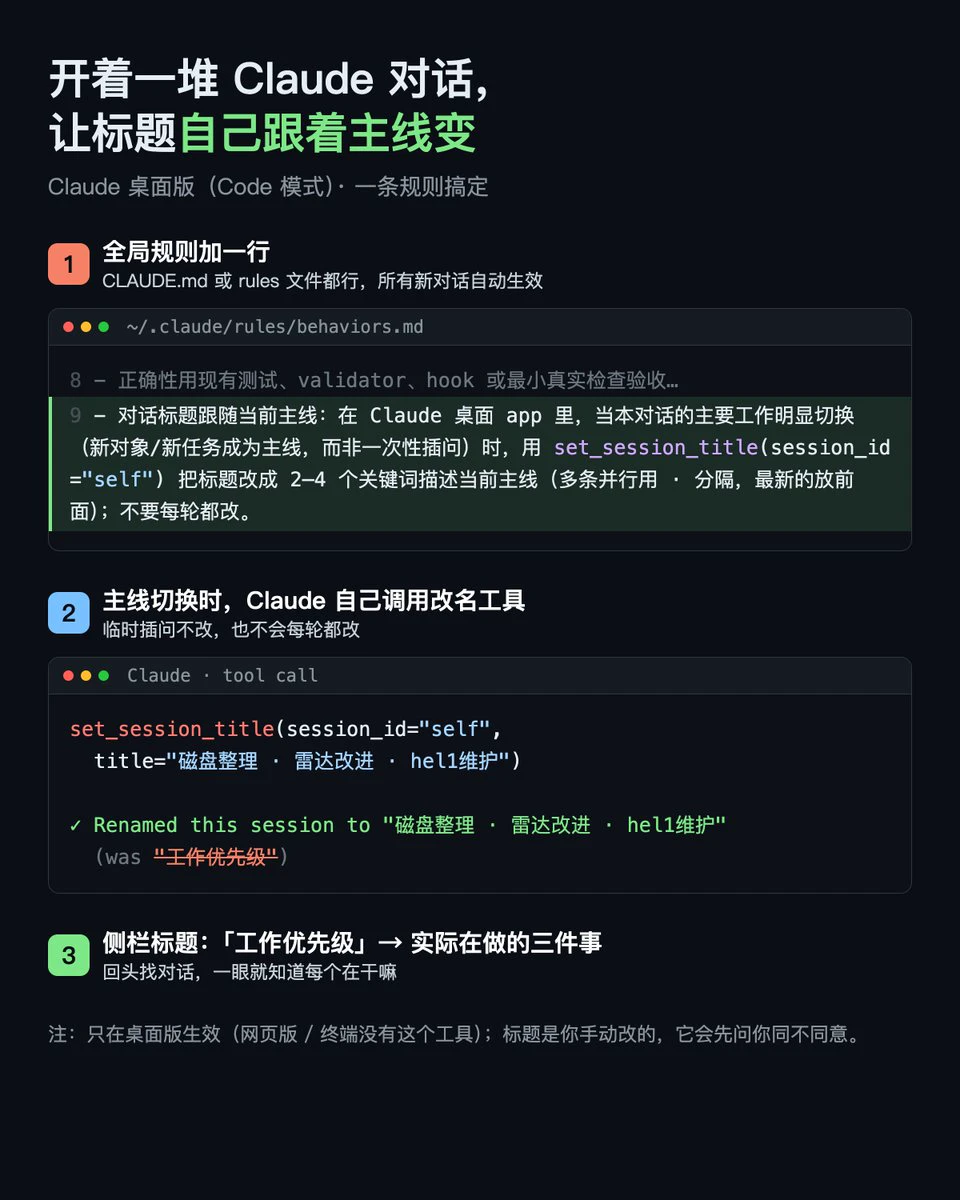
Quand on a une tonne de conversations Claude ouvertes, le plus agaçant, ce sont les titres : on commence par « Priorités professionnelles », puis on finit par réparer un radar et nettoyer le disque, sans plus retrouver la conversation.
Une petite astuce : demander à Claude de renommer lui-même les conversations.
La version de bureau de Claude (en mode Code) dispose déjà d’un outil pour renommer les conversations, mais il ne l’utilise pas spontanément par défaut. Ajoutez une ligne dans les règles globales (voir le texte original sur l’image) : dès que le sujet principal change, il renomme lui-m
post-image
La tokenomics de $AXIS a été publiée aujourd’hui ; pour ceux qui n’ont pas encore participé @axisrobotics, l’accès est ici :
La plupart des publications parlent de « Le TGE arrive », mais je m’intéresse davantage à une autre question : est-ce que cela vaut encore le coup de commencer maintenant ?
Commençons par les chiffres officiels :
• Offre totale de 1 milliard, dont 16,5 % en circulation au TGE. Parmi eux, 8 % sont destinés au fonds de l’écosystème et 6 % à la liquidité ; la part revenant réellement à la communauté (première vague de l’airdrop S1 + Sonar + Kaito) ne représente que 2,5 %
•
KAITO+0,47%
À l’extérieur, avec seulement votre téléphone, vous voulez ouvrir une nouvelle session locale Claude Code sur le Mac de chez vous ?
Méthode : faites tourner en permanence sur le Mac
claude remote-control --spawn=same-dir
et configurez aussi un lancement automatique au démarrage (launchd) : dans l’app Claude sur le téléphone → Code, vous pourrez directement sélectionner cet ordinateur pour créer une nouvelle session. La session s’exécute en local, avec accès aux fichiers locaux et à MCP.
Deux pièges :
1. Sans paramètre, le programme reste bloqué sur une option interactive et, en arrière-plan, s
Le GPT 6 et le 6.1 de ChatGPT sont vraiment devenus inutilisables, je suis retourné dans les bras de Claude Max🤦
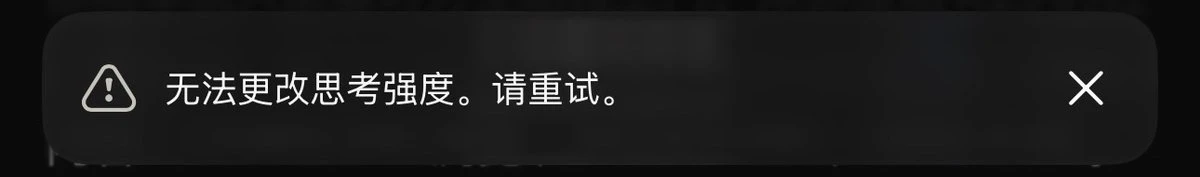
Petit rapport de bug @claudeai : lorsque j’utilise Remote Control sur mobile pour une session Claude Code exécutée sur mon Mac, le niveau d’effort affiché sur mobile est « Moyen », tandis que la version de bureau affiche « Très élevé » (et l’exécute réellement). Toute tentative de modification depuis mobile échoue avec le message « Impossible de modifier le niveau d’effort. Veuillez réessayer. » Dernière version de l’application. Résultat attendu : afficher le niveau réel ou me permettre de le modifier à distance.
post-image
Le contrôle à distance iPhone → Mac fonctionne enfin.
J’utilise MCPX / AI Agent pour exécuter des tâches, et je crains surtout de rester bloqué au niveau de l’autorisation de l’interface graphique. J’ai donc utilisé le contrôle à distance de NetEase UU pour assurer une intervention manuelle de secours.
Après avoir rencontré trois problèmes — Clash TUN, les délais d’expiration des interfaces et les autorisations de contrôle avec le même compte — j’ai vérifié sur mon téléphone qu’il pouvait bien piloter le Mac.
L’Agent exécute, la surveillance détecte une anomalie, le téléphone prend le relais.
Putain, cette vague de mises à jour de l’IA aujourd’hui m’a vraiment sidéré !
La nouvelle forme de sortie intelligente de ChatGPT, l’amélioration des capacités de Grokbot à lire les contenus de X, sans parler de l’évolution fulgurante des grands modèles ces derniers temps…
J’ai soudain ressenti quelque chose de très fort :
Pour une personne ordinaire, il se pourrait qu’à l’avenir une simple fenêtre de dialogue ChatGPT suffise réellement à devenir l’ensemble de son portail de travail numérique.
On entend souvent dire en ligne que ChatGPT ne vaut plus rien, qu’OpenAI ne vaut plus rien et qu’Opus
Une suggestion de produit importante :
@OpenAI @ChatGPT Pourriez-vous augmenter la limite de tâches actives de ChatGPT Scheduled Tasks à 100+ ? En particulier pour les utilisateurs Pro.
Lorsque ChatGPT devient la porte d’entrée vers le travail de l’IA personnelle, une dizaine de tâches planifiées est vraiment loin d’être suffisante.
J’aimerais qu’il puisse gérer simultanément des dizaines, voire des centaines, de workflows d’agents fonctionnant en continu : surveillance de l’information, recherche, suivi de projets, exécution automatisée…
C’est là que les agents IA deviennent vraiment passionn
Putain, la vague de mises à jour de l’IA d’aujourd’hui m’a vraiment sidéré ! Le nouveau format de sortie intelligente de ChatGPT, l’amélioration de la capacité de Grokbot à lire les contenus de X, sans parler de l’évolution complètement folle des grands modèles ces derniers temps… J’ai soudain eu une intuition très forte : pour une personne ordinaire, il suffira peut-être réellement à l’avenir d’une seule fenêtre de dialogue ChatGPT pour constituer l’intégralité de son point d’entrée numérique professionnel. On entend souvent dire en ligne que ChatGPT est fini, qu’OpenAI est fini, et qu’Opus 5
OPENAI-1,02%
GROK0,00%
1/7
Ces deux derniers jours, j’ai migré l’ensemble de mon infrastructure de données / stratégies Polymarket vers la V2.
Je pensais au départ qu’il suffirait principalement de remplacer quelques endpoints d’API, mais ce n’est qu’une fois le travail terminé que j’ai découvert :
le plus dangereux, ce ne sont pas les erreurs directes, mais les défaillances silencieuses où les programmes continuent de fonctionner, les données continuent d’être produites, mais les résultats sont déjà calculés de travers sans qu’on s’en aperçoive.
J’ai rencontré quelques pièges, alors je laisse une trace pour ceux qu
Aujourd’hui, je me suis soudain retrouvé à envier ce genre de situation :
avoir une position et l’énergie de s’investir durablement dans une communauté, pour construire avec tout le monde.
Cela me rappelle la période des inscriptions. Beaucoup de gens détenaient, étudiaient, créaient du contenu et attiraient de nouvelles personnes en même temps, pour faire avancer ensemble un projet.
Avec le recul, ce sentiment de participation est en réalité assez rare.
D’abord, il faut être entré suffisamment tôt.
Ensuite, votre position doit avoir suffisamment de valeur à vos yeux. Si elle est trop faible,
Je réfléchis depuis quelque temps à une question :
Dans un marché haussier, est-il vraiment pertinent de consacrer presque toute son énergie de recherche aux marchés prédictifs ?
Ce n’est pas que je sois baissier sur les marchés prédictifs.
Au contraire, je continue de penser qu’ils constitueront un secteur très important à long terme, et que les stratégies, l’automatisation et les avantages informationnels valent toujours la peine d’être développés.
Mais je le pense de plus en plus :
l’environnement de marché a changé, et l’allocation de l’attention devrait changer avec lui.
Lors d’un marché
J’ai une impression assez contre-intuitive :
Dernièrement, j’utilise alternativement GPT-5.6 et GPT-6 dans le Chat de ChatGPT, et pourtant je trouve constamment que le 5.6 est plus pratique.
Ce n’est pas une question de scores ou de savoir « lequel est le plus intelligent », mais plutôt de l’impression d’obtenir un résultat réellement exploitable.
Voici ce que me donne comme impression le 5.6 :
Il comprend mieux ce que je veux, offre une plus grande densité d’informations, contient davantage de concret et produit des réponses plus proches de ce que je vais réellement utiliser au final.
À l’inv
Si un jour un « écart de classe lié à l’IA » apparaît réellement, je pense qu’il ne se limitera finalement pas à « qui peut ou non accéder aux modèles les plus puissants ».
La différenciation continuera à s’opérer selon plusieurs axes :
qui dispose de davantage de puissance de calcul
qui possède des données plus complètes
qui bénéficie de permissions plus étendues sur les outils
qui peut permettre à l’IA d’accéder en continu à son contexte à long terme
qui a déjà intégré un Agent à ses activités et systèmes d’exécution réels
À ce stade, le modèle lui-même ne sera peut-être qu’une couche parmi
Suis-je le seul à prendre mon pied tous les jours avec le GPT 5.6 dans ce chat ChatGPT ? 👀
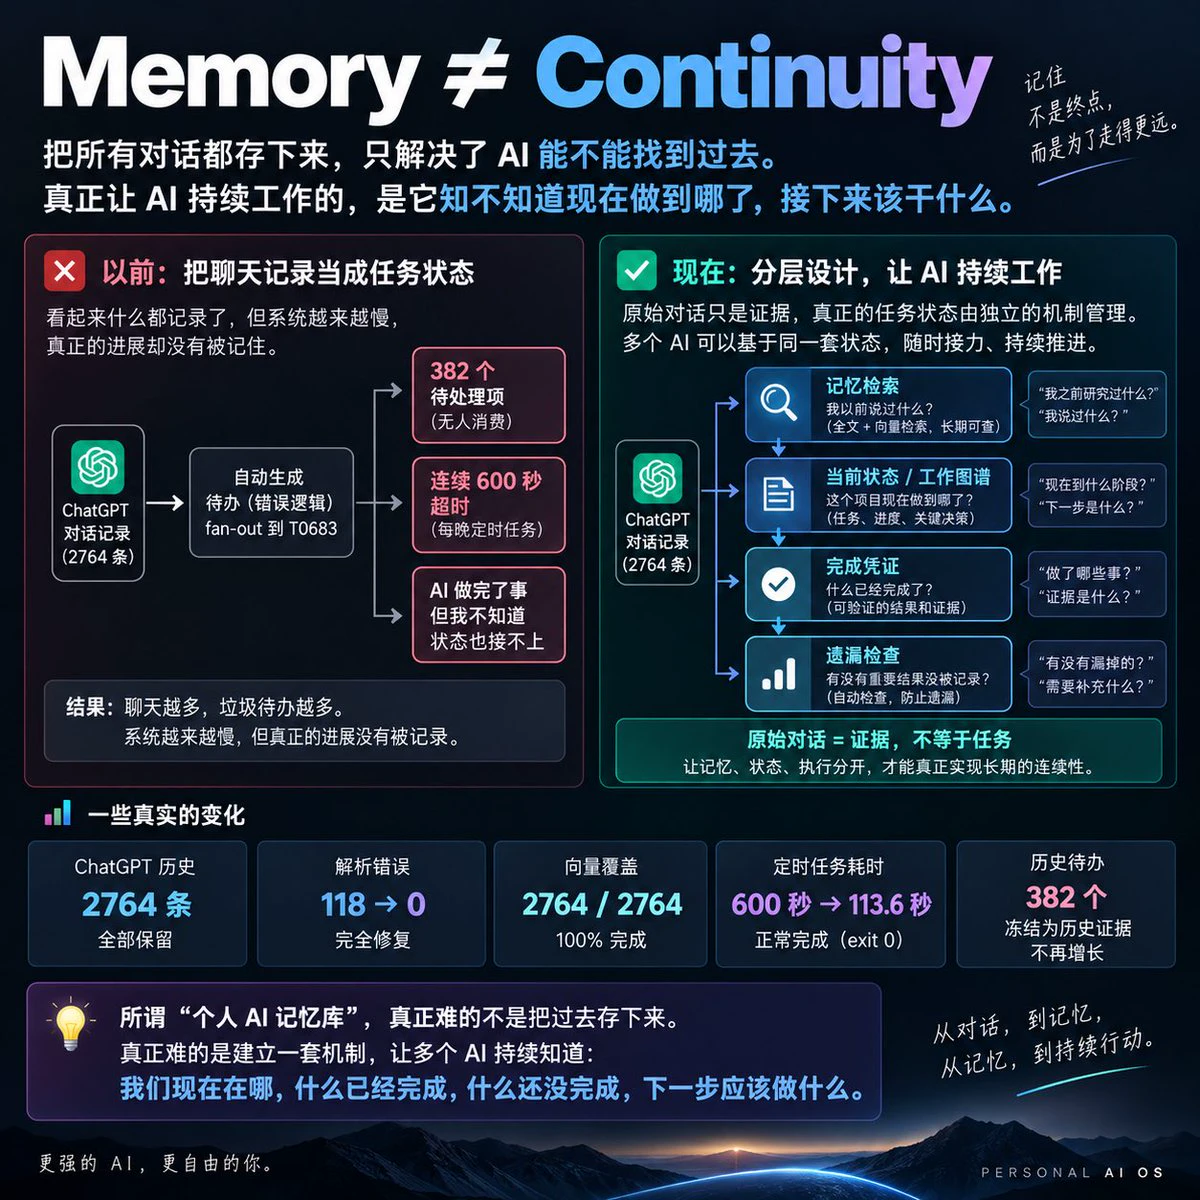
Il y a quelques jours, je disais que ce dont l’IA personnelle a réellement besoin n’est pas d’un document Memory, mais d’une couche de mémoire à long terme.
Ces deux derniers jours, je l’ai réellement restructuré de fond en comble.
Et j’ai finalement découvert :
que Memory n’était même pas le plus difficile.
Le vrai défi, c’est Continuity.
J’ai déjà 2 764 historiques ChatGPT, avec recherche plein texte et recherche vectorielle en local.
En théorie, l’IA peut désormais retrouver à tout moment :
« Qu’ai-je dit auparavant ? »
« Qu’ai-je étudié ? »
« Qu’ai-je fait ? »
Mais dans la réalité, un prob
post-image
J’ai demandé à mon Dot de concevoir une apparence personnalisée pour lui-même et d’utiliser directement cette image comme avatar.
Je lui ai seulement donné un prompt : tu es le centre de contrôle IA qui m’accompagne sur le long terme ; tu dois coordonner plusieurs Agents et workflows et détecter rapidement les signaux importants. Ton apparence doit être calme, perspicace et fiable, identifiable même en petite taille ; pas de texte, pas de robot générique et pas de mignonnerie gratuite.
Il a choisi une chouette bleu foncé aux yeux ambrés, avec sur la poitrine un motif de voies représentant plus