Pour les débutants qui cherchent à définir les limites des capacités de l’IA, un modèle du monde permet de déterminer si un système peut anticiper les conséquences de ses actions, et non s’il produit des réponses fluides. Les sections ci-dessous abordent la définition, la boucle de prédiction, trois approches techniques, le choix des tâches entre modèle du monde et LLM, les différences avec la génération vidéo, les cas d’utilisation et les limites de l’évaluation. Des concepts connexes sont présentés dans les guides Gate Learn sur la superintelligence (ASI) et l’IA privée.
Points clés
- La capacité centrale est la prédiction conditionnée par l’action : à partir d’un état et d’une action, produire l’état suivant (ou la représentation suivante) afin de planifier et de contrôler.
- Trois approches courantes : l’apprentissage par renforcement fondé sur un modèle (MBRL) / l’entraînement par imagination, la simulation interactive générative et les représentations prédictives de type JEPA.
- Les grands modèles de langage excellent dans la prédiction du token suivant, tandis que les générateurs vidéo excellent dans la continuité visuelle ; aucun des deux n’est automatiquement un modèle du monde utilisable pour la planification.
- L’évaluation doit surveiller la physique simulée erronée, la dérive à long horizon, les échecs hors distribution, les métriques rigoureuses et la frontière avec les simulateurs écrits manuellement.
Qu’est-ce qu’un modèle du monde et quel problème résout-il ?
Un modèle du monde répond à une question pratique : avant qu’un agent agisse, peut-il estimer de manière fiable ce qui se produira ensuite ? Sans cette capacité, l’apprentissage repose sur des essais et erreurs réels, souvent coûteux, lents ou dangereux, et la planification hors ligne devient difficile.
En robotique, dans la conduite autonome, les agents de jeu et l’entraînement par simulation — en particulier pour les agents incarnés dans des environnements virtuels ou physiques — le retour d’information est coûteux ou risqué. Par exemple, une mauvaise politique de conduite peut provoquer un véritable accident avant d’avoir appris. Un modèle du monde déplace les « essais d’actions » vers une dynamique apprise : il projette l’évolution dans un espace latent ou d’observation, puis applique une politique plus performante au monde réel. Cet objectif diffère de celui des systèmes conversationnels, qui reformulent principalement des connaissances ; il se rapproche davantage d’une anticipation causale au sein d’un environnement interactif.
L’entrée du glossaire NVIDIA sur les modèles du monde les présente comme des représentations internes qui aident l’IA à comprendre et à prédire l’évolution du monde physique. A Path Towards Autonomous Machine Intelligence de Yann LeCun inscrit les modèles du monde prédictifs dans une trajectoire vers une intelligence plus autonome. Les travaux « World Models » de David Ha, publiés en 2018, ont contribué à définir l’approche moderne fondée sur l’apprentissage. Un agent ne perçoit généralement que des observations partielles, de sorte que l’état complet n’est pas directement disponible. Selon toutes ces perspectives, la prédiction sert à soutenir la prise de décision.
Le test le plus fiable pour un système orienté modèle du monde est la prédiction conditionnée par l’action : les entrées incluent-elles explicitement l’action d’un agent, ou un signal de contrôle, et la sortie correspond-elle à l’état suivant ou à la représentation suivante conditionnée par cette action ?
La boucle se résume généralement en trois étapes : encoder les observations dans un état ; conditionner le système avec une action candidate ; prédire l’état suivant, l’environnement évoluant après cette action et renvoyant de nouvelles observations. Cette prédiction peut ensuite être projetée vers l’avant en tant que nouveau point de départ. Une politique ou un planificateur compare les trajectoires imaginées selon la récompense, le risque ou les contraintes, puis exécute une action ; une nouvelle observation relance l’encodage.
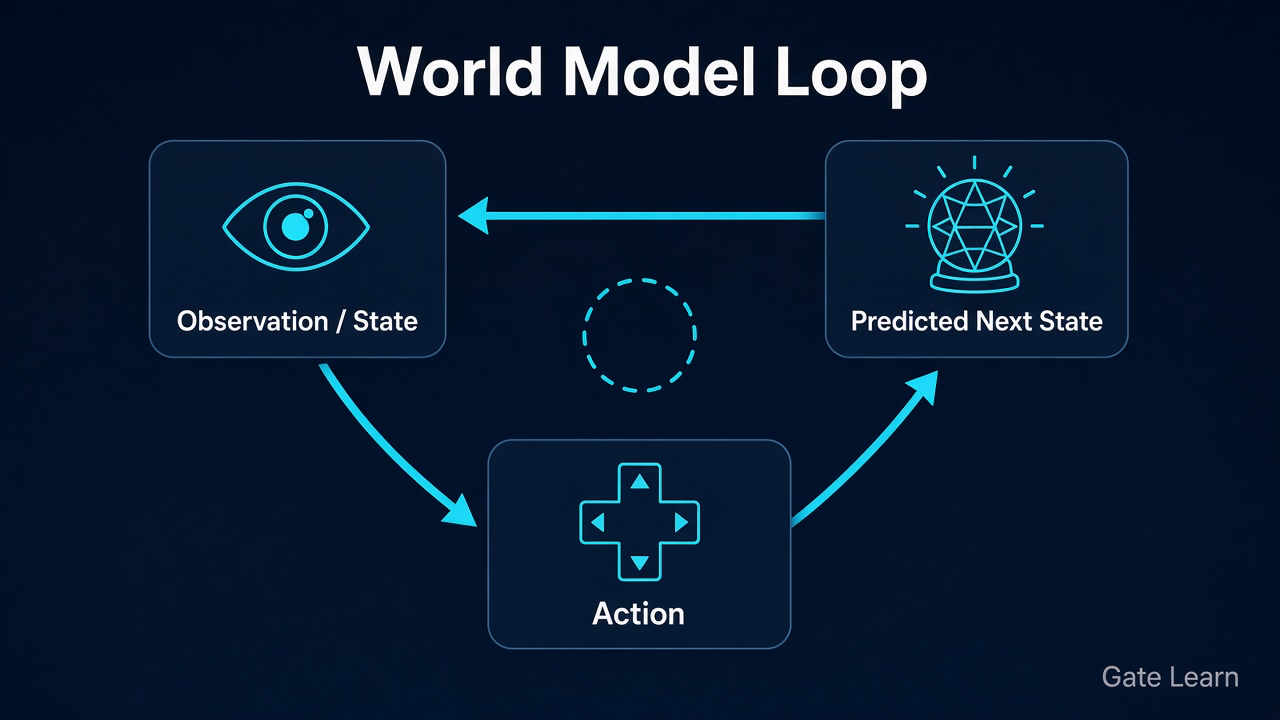
Figure 1. Boucle de modèle du monde : une observation ou un état, associé à une action, produit un état suivant prédit qui alimente le cycle suivant.
De nombreux systèmes pratiques évitent les prédictions à long horizon sur des pixels bruts et apprennent plutôt des dynamiques latentes : ils compressent des données visuelles à haute dimension dans un état compact, puis projettent l’évolution dans cet espace. Les projections latentes réduisent le bruit visuel et rendent l’entraînement par imagination moins coûteux. Il reste toutefois nécessaire de vérifier, au moyen de tâches en aval et de contrôles hors distribution, si l’état latent reste fidèle à la physique réelle, notamment parce que l’environnement physique n’est observé que partiellement et doit être inféré à partir du retour d’information.
Quelles sont les principales approches techniques des modèles du monde ?
« Modèle du monde » est une appellation générale couvrant plusieurs familles techniques, et non le nom d’un algorithme unique. Le choix commence par l’objectif : politiques contrôlables, simulation interactive en pixels ou représentations abstraites transférables.
| Approche |
Idée centrale |
Cas d’usage le plus adapté |
Coût principal |
| MBRL / entraînement par imagination |
Apprendre les dynamiques, puis entraîner une politique sur des projections du modèle (Dreamer) |
Contrôle, jeux, apprentissage par renforcement efficace en données |
Les erreurs du modèle dégradent la politique ; dérive |
| Simulation interactive générative |
Apprendre un environnement interactif qui génère les images ou observations suivantes |
Augmentation des données, mondes vidéo interactifs |
Apparence ≠ physique ; évaluation coûteuse |
| Représentations prédictives JEPA |
Prédire des embeddings futurs ou masqués dans un espace de représentation (I-JEPA) |
Apprentissage de représentations, prédiction abstraite pour la planification |
Pas de pixels ; nécessite une pile de contrôle |
Une approche peut se concentrer sur un modèle vidéo qui prédit les images futures, tandis qu’une autre vise des dynamiques latentes prêtes pour la planification plutôt qu’une reconstruction visuelle complète.
Les trois approches peuvent coexister : les méthodes de type Dreamer mettent l’accent sur l’entraînement de politiques par imagination ; les modèles du monde vidéo génératifs privilégient la simulation interactive de l’apparence ; I-JEPA de Meta AI illustre la prédiction dans un espace d’embeddings commun au lieu de reconstruire chaque pixel. Les systèmes adoptent également différentes méthodes d’entraînement selon qu’ils apprennent à partir de paires entrée-sortie, de trajectoires de contrôle ou d’embeddings prédictifs. Il faut d’abord aligner la tâche, puis discuter des appellations.
En quoi les modèles du monde diffèrent-ils des LLM et de la génération vidéo ?
Les trois types de systèmes « prédisent », mais, dans l’IA générative, ils prédisent des objets différents et se distinguent par le conditionnement par l’action : les LLM prédisent le token suivant, les générateurs vidéo prédisent l’apparence de l’image suivante et les systèmes orientés modèle du monde prédisent l’évolution de l’état après une action.
| Dimension |
Modèle du monde |
Grand modèle de langage (LLM) |
Génération vidéo |
| Cible de prédiction principale |
État suivant / dynamiques latentes, souvent conditionnés par l’action |
Token suivant / structure du texte |
Apparence de l’image ou du clip suivant |
| Lien avec l’action |
La prédiction conditionnée par l’action est l’axe décisionnel |
Généralement pas de boucle de contrôle physique |
Peut être conditionnée par un texte ou une première image, sans être exécutable |
| Utilisation typique |
Planification, contrôle, IA incarnée |
Langage, rédaction, orchestration d’outils |
Génération de contenu, aperçus, simulations interactives |
| Confusion fréquente |
Capacité conversationnelle = modèle du monde |
Écrire sur la physique = compétence physique |
Images photoréalistes = dynamiques correctes |
Ainsi, un générateur vidéo de type Sora peut produire des images cohérentes avec une grande fidélité visuelle et même une apparente cohérence spatiale — et être qualifié de « modèle du monde vidéo » — mais ces caractéristiques seules ne démontrent pas une compréhension physique. Sans interface d’action stable, transitions d’état vérifiables et boucle de planification, la catégorie appropriée reste celle de la vidéo générative. Un système plus avancé peut également évaluer des séquences d’actions afin de soutenir la planification et la prise de décision, au lieu de se limiter à générer passivement des vues probables. Un LLM peut expliquer « ce qui se passerait si vous poussiez légèrement la tasse », mais cela ne crée pas de dynamiques environnementales pouvant être projetées et évaluées.
Où les modèles du monde sont-ils couramment utilisés ?
L’IA incarnée est un contexte fréquent : les bras robotiques et les robots mobiles ont besoin d’intelligence spatiale — la capacité de raisonner sur les agencements, les mouvements et les changements dans le monde physique — ainsi que de prévisions de contact et de déplacement avant de toucher des objets, car de nombreuses interactions sont difficiles à inverser une fois le mouvement commencé. La prédiction conditionnée par l’action permet aux systèmes d’écarter les trajectoires défaillantes dans une simulation ou un espace latent avant de payer le coût de collisions réelles. Les démonstrations peuvent initialiser un comportement, mais ne remplacent pas l’apprentissage fondé sur l’interaction.
Les jeux et l’apprentissage par renforcement fondé sur un modèle constituent un autre domaine essentiel. Les méthodes de type Dreamer améliorent les politiques à partir de trajectoires imaginées, de sorte qu’un contrôle utilisable peut émerger avec moins d’interactions réelles. Des idées similaires s’appliquent aux journaux de contrôle industriel lorsqu’un simulateur écrit manuellement est incomplet, mais que l’historique d’observations est abondant, car le modèle tente de capturer les dynamiques du système à partir de cet historique.
La conduite autonome, la planification des entrepôts et les simulations multi-agents intègrent également des composants de modèle du monde, non pas comme un remplacement complet des piles de planification, mais comme une couche de conséquences à court horizon. Les tests virtuels et les données vidéo sélectionnées sont souvent utilisés pour entraîner et évaluer ces composants dans différents scénarios avant un déploiement réel. Tout système de contrôle qui doit « réfléchir avant d’agir » peut intégrer un module de modèle du monde.
Quels avantages, risques et limites importent lors de l’évaluation des modèles du monde ?
L’avantage réside dans une meilleure efficacité en données et des essais et erreurs plus sûrs : imaginer au sein d’un modèle peut réduire l’exploration dangereuse, et les prévisions conditionnées par l’action peuvent fonder la planification sur des dynamiques vérifiables. Les limites et risques apparaissent souvent lorsqu’un modèle semble correct sans être fiable, car une représentation interne soignée n’est pas la même chose qu’un comportement qui résiste au déploiement.
| Mécanisme |
Ce que vous observez |
Pourquoi cela passe inaperçu |
Questions de vérification |
| Physique simulée erronée |
Trajectoires fluides qui violent la conservation ou les contacts |
La vision fait confiance à la fluidité |
Les grandeurs clés sont-elles conservées ? Les objets peuvent-ils se traverser ? |
| Dérive à long horizon |
Les projections courtes sont correctes ; les longues s’effondrent |
Les démonstrations favorisent les clips courts |
Comment l’erreur évolue-t-elle avec le nombre d’étapes ? Une replanification est-elle prévue ? |
| Échec hors distribution |
Échec avec de nouveaux objets, éclairages ou plages d’actions |
Les scores en distribution semblent élevés |
Protocole OOD ? Modes d’échec publics ? |
| Évaluation rigoureuse |
Aucun score partagé de « compréhension du monde » |
La réussite de la tâche absorbe la métrique |
Au-delà du score de tâche, l’erreur de prédiction est-elle communiquée ? |
| Frontière avec les simulations écrites manuellement |
Les modèles appris sont traités comme des moteurs vérifiés |
Le marketing mélange simulateur et modèle du monde |
Quelles contraintes sont codées en dur ? Lesquelles ne sont que des ajustements ? |
Le transfert vers la réalité est difficile en raison de l’écart entre simulation et réalité. De bons tests doivent déterminer si le modèle prédit des résultats contrôlables sous l’effet d’une action, et non seulement des visuels plausibles.
Utilisez ce tableau comme liste de vérification des affirmations : confirmez une interface conditionnée par l’action, exigez ensuite des preuves à long horizon et hors distribution, puis distinguez « l’apparence est bonne » de « les dynamiques sont planifiables ». En l’absence de ces éléments, il est plus prudent d’indiquer qu’un système « inclut des composants de modèle du monde ou des objectifs de recherche », plutôt que d’affirmer qu’il « possède un modèle du monde complet ». Les agents disposant de capacités limitées, l’évaluation doit se concentrer sur l’état pertinent pour l’objectif plutôt que sur la reproduction intégrale de la scène.
Résumé
Les modèles du monde font évoluer l’IA de « peut parler / peut dessiner » vers « peut anticiper les conséquences de ses actions », par exemple en prédisant qu’un robot renversera une tasse s’il emprunte une mauvaise trajectoire. Le principe opérationnel est une boucle fermée d’état, d’action et de prédiction, la prédiction conditionnée par l’action constituant l’axe décisionnel le plus clair.
Les trois approches — MBRL/entraînement par imagination, simulation interactive générative et représentations prédictives JEPA — répondent à des objectifs différents et ne sont pas interchangeables. Par rapport aux LLM et aux générateurs vidéo, il convient de comparer les cibles de prédiction et les interfaces d’action. Lors de l’évaluation, il faut prioriser la physique simulée erronée, la dérive, les échecs OOD, les métriques rigoureuses et les frontières avec les simulateurs.
FAQ
Qu’est-ce qu’un modèle du monde ?
Un modèle du monde est un modèle appris de dynamiques internes qui représente la manière dont un environnement peut évoluer à partir d’un état actuel, ou d’une observation, et d’une action. Le monde, à chaque instant, est plus riche que ce qu’un agent peut observer directement. Le modèle résume donc les variables importantes pour la planification — par exemple, l’endroit où un robot se retrouve après avoir tourné à gauche. Son objectif est de soutenir la planification et les essais et erreurs par imagination, et non seulement de générer du texte ou une apparence vidéo.
En quoi un modèle du monde diffère-t-il d’un grand modèle de langage ?
Les grands modèles de langage prédisent principalement le token suivant et excellent dans le langage et l’orchestration des connaissances. Les modèles du monde prédisent principalement l’évolution de l’état après des actions, à des fins de contrôle et de planification. Un LLM peut discuter de physique sans fournir de dynamiques environnementales pouvant être projetées et évaluées.
Une boucle typique encode les observations dans un état, conditionne le système avec une action candidate, prédit l’état suivant après cette action, puis peut projeter l’évolution dans un espace latent. Un planificateur compare les projections imaginées, exécute une action, puis met à jour l’état à partir d’une nouvelle observation.
Sora ou la génération vidéo comptent-ils comme un modèle du monde ?
Pas automatiquement. Si un système produit principalement des vidéos visuellement cohérentes sans interface stable conditionnée par l’action, transitions d’état vérifiables ni utilisation pour la planification, il est préférable de le décrire comme un générateur vidéo. Il ne se rapproche d’un modèle du monde que lorsque la prédiction conditionnée par l’action et une boucle planifiable sont démontrées.
En quoi un modèle du monde diffère-t-il d’un simulateur traditionnel ?
Les simulateurs traditionnels encodent généralement des règles et contraintes physiques écrites manuellement, tandis que les modèles du monde fondés sur les données sont souvent appris avec des réseaux neuronaux. Les modèles appris peuvent être plus flexibles et plus proches du bruit des capteurs, mais ils sont aussi davantage sujets à une physique simulée erronée et à la dérive à long horizon. Ils ne doivent pas être considérés comme équivalents à un moteur physique vérifié.