Alors que l’IA générative passe de l’entraînement des modèles à des applications commerciales à grande échelle, la concurrence sur le marché du calcul pour l’IA évolue également. Les entreprises doivent non seulement entraîner des modèles plus performants, mais aussi traiter en continu les requêtes des utilisateurs à un coût maîtrisé, exécuter des agents d’IA, générer de la voix et fournir des services interactifs en temps réel. Dans ce contexte, l’architecture spécialisée d’accélération de l’inférence représentée par Groq attire une attention croissante. Cet article examine le positionnement de Groq, sa technologie LPU, le modèle économique de GroqCloud et la concurrence du secteur afin d’analyser son rôle dans l’infrastructure d’inférence pour l’IA, ainsi que les défis techniques et commerciaux auxquels est confrontée l’approche fondée sur les puces spécialisées.
Points clés
- Groq est une entreprise de technologies de calcul axée sur l’inférence pour l’IA. Ses technologies clés comprennent les puces LPU, les compilateurs et l’infrastructure d’inférence associée.
- L’entraînement et l’inférence de l’IA présentent des besoins de calcul différents. L’inférence en temps réel accorde une importance particulière au délai avant le premier token, à la vitesse de génération et à la stabilité du service.
- Les LPU de Groq optimisent certaines charges de travail d’inférence pour l’IA grâce à la SRAM intégrée, à l’exécution déterministe et à la co-conception matérielle et logicielle.
- GroqCloud transforme les capacités de calcul sous-jacentes en API cloud, permettant aux développeurs d’appeler des modèles d’IA pris en charge.
- Les LPU et les GPU diffèrent par leur architecture et leurs cas d’usage. Les performances globales ne peuvent pas être évaluées uniquement sur la base de la vitesse de génération d’un seul token.
- La compétitivité commerciale à long terme de Groq dépend de l’évolutivité de ses puces, de son écosystème logiciel, des coûts d’inférence, de la demande des clients et du retour sur investissement de l’infrastructure.
Qu’est-ce que Groq et quel rôle joue-t-il dans la chaîne de valeur du calcul pour l’IA ?
Groq est une entreprise technologique axée sur le calcul d’inférence pour l’IA. Elle a été fondée en 2016 par Jonathan Ross, qui avait auparavant participé au projet Google TPU. L’entreprise développe principalement des puces spécialisées d’accélération de l’IA, des compilateurs et des systèmes de calcul d’inférence, et fournit des capacités d’inférence de modèles aux développeurs et aux entreprises via des services tels que GroqCloud.
Il est important de noter que Groq et Grok ne désignent pas le même produit. Groq est un nom technologique lié à l’infrastructure de calcul pour l’IA, tandis que Grok est un modèle d’intelligence artificielle et un produit d’assistant développé par xAI. Bien que leurs noms soient similaires, ils appartiennent à des entreprises différentes et présentent des positionnements techniques et des modèles économiques distincts.
Dans la chaîne de valeur de l’IA, Groq se positionne principalement au niveau de l’infrastructure de calcul. Une application complète d’IA générative implique généralement le développement de modèles, le calcul d’entraînement, le déploiement de l’inférence, les interfaces applicatives et les services destinés aux utilisateurs finaux. L’activité principale de Groq ne consiste pas à développer des modèles conversationnels généralistes pour les consommateurs. L’entreprise vise plutôt à fournir des environnements d’inférence haute performance pour différents modèles.
Par exemple, lors de la création d’un assistant d’IA en temps réel, les développeurs peuvent sélectionner un modèle déjà entraîné et utiliser un service d’inférence pour traiter les données saisies par les utilisateurs. Le modèle comprend les questions et génère du contenu, tandis que la plateforme de calcul sous-jacente détermine la vitesse d’exécution du modèle et les ressources de calcul consommées par chaque requête.
L’optimisation de ce processus de calcul est au cœur de la proposition de valeur de Groq. Grâce à des processeurs et des systèmes logiciels spécialement conçus, Groq réduit la surcharge d’exécution de certaines tâches d’inférence, permettant aux modèles de générer des réponses plus rapidement.
Ce positionnement signifie que l’opportunité de marché de Groq dépend non seulement de la popularité éventuelle d’un modèle d’IA particulier, mais aussi de la demande d’inférence dans l’ensemble du secteur de l’IA générative, des architectures de modèles et de l’évolution des coûts de calcul.
Pourquoi le secteur de l’IA accorde-t-il davantage d’attention au calcul d’inférence ?
Le calcul pour l’IA peut généralement être divisé en deux étapes : l’entraînement et l’inférence. L’entraînement consiste à utiliser de grandes quantités de données pour ajuster les paramètres d’un modèle afin qu’il puisse acquérir des capacités telles que la compréhension du langage et la reconnaissance d’images. L’inférence désigne le processus par lequel un modèle entraîné reçoit de nouvelles données en entrée et génère une sortie à partir de ses paramètres existants.
Les deux nécessitent des ressources de calcul, mais leurs charges de travail diffèrent considérablement. L’entraînement d’un modèle implique généralement le traitement de grands ensembles de données, le calcul des gradients et la mise à jour des paramètres. Il met l’accent sur le calcul parallèle à grande échelle, la capacité mémoire et la coordination entre plusieurs appareils. À l’inverse, l’inférence doit générer rapidement des résultats en réponse aux requêtes des utilisateurs. Cela est particulièrement important dans les applications de conversation, de voix et d’automatisation, où les temps de réponse affectent directement l’expérience utilisateur.
Pour les grands modèles de langage, le processus d’inférence comprend généralement deux étapes : Prefill et Decode. Prefill traite le prompt d’entrée et établit l’état de calcul pertinent, tandis que Decode génère les tokens suivants un par un. Étant donné que les modèles de langage autorégressifs doivent généralement prédire le token suivant en fonction du contenu déjà généré, le processus de génération continue impose des exigences importantes en matière d’efficacité d’accès à la mémoire et de planification des calculs.
Les utilisateurs d’applications de conversation ordinaires peuvent tolérer une courte attente. Toutefois, dans les assistants vocaux en temps réel, le service client automatisé et les scénarios d’IA interactifs, la latence de réponse peut directement affecter le caractère naturel d’une conversation. Si un modèle met trop de temps à générer la première partie d’une réponse, ou si sa vitesse de sortie est insuffisante pour une communication en temps réel, il peut avoir du mal à répondre aux exigences pratiques d’une activité, même si le modèle lui-même est très performant.
Le développement des agents d’IA a encore accru la demande d’inférence. Contrairement aux interactions ponctuelles sous forme de questions-réponses, un agent d’IA peut devoir appeler plusieurs modèles, analyser des données externes, exécuter des opérations sur des outils et vérifier les résultats. Une seule tâche utilisateur peut générer plusieurs cycles de raisonnement interne et plusieurs requêtes API, ce qui augmente la consommation totale de calcul.
Par conséquent, la concurrence dans l’infrastructure d’IA ne se limite plus à rechercher de plus grandes capacités d’entraînement des modèles. Elle porte désormais également sur la fourniture de services d’inférence présentant une latence plus faible, un débit plus élevé et des coûts plus raisonnables.
Toutefois, l’augmentation de la demande d’inférence ne signifie pas que le calcul d’entraînement devient moins important. L’entraînement de nouveaux modèles, l’ajustement fin de modèles et la fourniture de services d’inférence peuvent tous continuer à croître simultanément. La différence est que les exigences matérielles pour les différentes tâches de calcul deviennent plus spécialisées.
Quelles sont les principales caractéristiques de l’approche technologique LPU de Groq ?
LPU est le terme technique utilisé par Groq pour décrire son processeur d’inférence spécialisé. Par rapport aux GPU généralistes conçus pour un large éventail de tâches de calcul, la conception des LPU se concentre davantage sur le calcul, le déplacement des données et le contrôle de la latence pour certaines charges de travail d’IA.
La technologie LPU de Groq peut être comprise sous trois angles : la mémoire intégrée, l’exécution déterministe et les compilateurs.
Comment la SRAM intégrée affecte-t-elle l’efficacité de l’accès aux données ?
Le calcul moderne pour l’IA est limité non seulement par les capacités arithmétiques d’une puce, mais aussi par la vitesse d’accès et de transfert des données. Lors de l’inférence d’un grand modèle de langage, les unités de calcul doivent accéder en continu aux poids du modèle et aux données intermédiaires. Si les données ne peuvent pas être fournies à temps, le processeur peut ne pas être en mesure d’utiliser pleinement ses ressources, même s’il possède une capacité de calcul théorique élevée.
Une caractéristique importante des LPU de Groq est l’accent mis sur la SRAM intégrée (mémoire statique à accès aléatoire). La SRAM offre généralement une latence d’accès plus faible et peut aider les processeurs à lire rapidement les données requises. Par rapport aux conceptions reposant sur une mémoire externe à large bande passante de plus grande capacité, cette architecture cherche à réduire la surcharge d’accès aux données pour certaines tâches de calcul.
La SRAM présente également des limites en matière de coût et de capacité. À surface de puce égale, la SRAM ne peut généralement pas fournir la même capacité de stockage qu’une mémoire externe de grande capacité. Par conséquent, le déploiement de modèles comportant davantage de paramètres peut nécessiter une coordination entre plusieurs puces, un partitionnement des modèles et une optimisation au niveau du système afin de répondre aux exigences de capacité.
Cela signifie que la SRAM intégrée n’est pas intrinsèquement supérieure à toutes les autres architectures de mémoire. Sa valeur dépend du modèle et de la charge de travail concernés, ainsi que de la capacité du système de calcul à coordonner efficacement le stockage et le transfert des données.
Pourquoi l’exécution déterministe est-elle importante ?
Un autre élément clé de la conception de Groq est l’exécution déterministe. Dans cette approche architecturale, le compilateur peut planifier à l’avance un grand nombre d’opérations de calcul et de transferts de données, permettant au processeur de fonctionner selon un calendrier d’exécution prédéfini.
Les GPU traditionnels doivent généralement prendre en charge diverses tâches de calcul, une planification dynamique et des environnements logiciels complexes, ce qui leur confère une forte polyvalence. À l’inverse, Groq cherche à réduire une partie de l’incertitude liée à la planification à l’exécution et à la coordination des ressources grâce à des plans d’exécution plus explicites.
Pour l’inférence à faible latence, un temps d’exécution prévisible présente une valeur pratique. Lorsque les entreprises fournissent des services d’IA en temps réel, elles s’intéressent non seulement à la vitesse de réponse moyenne, mais aussi aux variations de latence entre les différentes requêtes. Si un service connaît occasionnellement des retards de réponse importants, l’expérience utilisateur peut être affectée même si ses performances moyennes sont élevées.
L’exécution déterministe ne signifie pas que chaque requête aura exactement le même temps de réponse. La latence réelle peut encore être affectée par des facteurs tels que la longueur des entrées, la longueur des sorties, les stratégies de regroupement par lots, la charge du système et les conditions réseau.
Comment le compilateur contribue-t-il à l’optimisation des performances des LPU ?
L’approche technologique de Groq ne repose pas uniquement sur le matériel pour améliorer les performances. Elle met l’accent sur la co-conception matérielle et logicielle. Le compilateur doit analyser le graphe de calcul du modèle et associer les opérations pertinentes aux ressources de calcul et de stockage de la puce.
Dans ce processus, le compilateur est responsable non seulement de la conversion du modèle en instructions exécutables, mais aussi de l’organisation des transferts de données, des séquences de calcul et de l’utilisation des ressources afin que les différentes unités de calcul puissent fonctionner ensemble selon un plan prédéfini.
Cette conception permet une optimisation approfondie des modèles pris en charge, mais elle impose également des exigences importantes à la chaîne d’outils logiciels. Lorsque les structures de modèles, les types d’opérateurs ou les exigences d’inférence évoluent, la plateforme doit continuellement améliorer son compilateur et son environnement d’exécution.
Par conséquent, la compétitivité technologique de Groq provient non seulement de la puce LPU elle-même, mais aussi de son compilateur, de ses capacités d’adaptation aux modèles et de l’efficacité coordonnée de son système global d’inférence.
Comment GroqCloud transforme-t-il le calcul LPU en service commercial ?
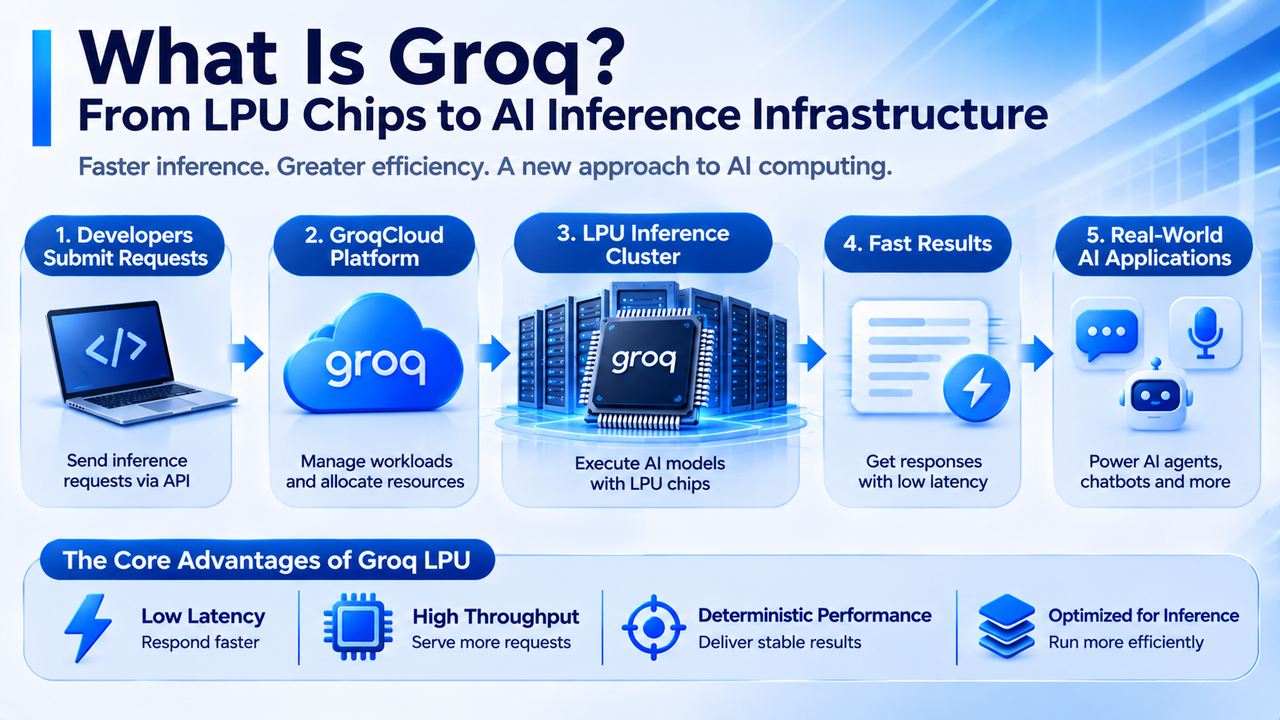
GroqCloud est le service cloud d’inférence pour l’IA de Groq destiné aux développeurs et aux entreprises. Il intègre les puces sous-jacentes, les clusters de calcul et les environnements d’exécution des modèles dans des services accessibles via des API. Les clients peuvent ainsi utiliser l’infrastructure d’inférence de Groq sans avoir à acheter ni déployer eux-mêmes des puces spécialisées.
Dans une application typique, les développeurs sélectionnent d’abord un modèle pris en charge par la plateforme, puis envoient du texte ou d’autres types d’entrées via une API. GroqCloud reçoit la requête, attribue la tâche de calcul concernée au système d’inférence sous-jacent et renvoie le résultat généré à l’application. Ce processus implique la planification des requêtes, l’exécution du modèle, la gestion des ressources et la transmission des résultats.
Pour les entreprises clientes, la principale valeur d’un service cloud d’inférence réside dans un obstacle réduit au déploiement de l’infrastructure. La construction indépendante d’un cluster de calcul pour l’IA nécessite généralement l’achat de matériel, la configuration des réseaux, le déploiement des modèles et la maintenance de l’environnement d’exécution. L’utilisation d’un service d’inférence via une API transforme une partie des investissements fixes en infrastructure en dépenses de service qui varient selon l’usage professionnel.
La plateforme de Groq évolue également d’une API d’inférence unique vers des services d’infrastructure d’entreprise plus complets. Son portefeuille de produits comprend une infrastructure de calcul spécialisée, une pile logicielle d’inférence ainsi que des capacités de gouvernance et de contrôle de niveau entreprise afin de répondre aux différents besoins des clients en matière de performances, de méthodes de déploiement et d’autorisations de gestion.
Toutefois, la valeur commerciale d’un service cloud d’inférence ne dépend pas entièrement de la vitesse des puces. Les entreprises doivent également tenir compte de la prise en charge des modèles, de la stabilité des API, de la disponibilité du service, de la sécurité des données et des coûts par requête. Si une plateforme ne prend en charge qu’un éventail limité de modèles ou d’opérateurs, elle peut ne pas répondre à tous les besoins applicatifs des entreprises, même si elle offre une faible latence pour certaines tâches.
En matière de modèles de revenus, les services cloud d’inférence peuvent généralement facturer selon l’utilisation des modèles, le nombre de tokens traités ou la capacité de calcul réservée. Les différentes méthodes de tarification créent des exigences différentes en matière de gestion des ressources. La facturation à l’usage dépend davantage du volume réel de requêtes, tandis que les services de capacité réservée exigent une attention particulière aux contrats clients, à la fourniture des ressources et au taux d’utilisation des équipements.
Par conséquent, la capacité de GroqCloud à commercialiser sa technologie dépend en définitive de sa faculté à transformer les avantages de performance sous-jacents des LPU en services d’inférence stables, évolutifs et compétitifs en matière de coûts.
Comment le partenariat de Groq avec NVIDIA modifie-t-il son positionnement dans le secteur ?
La relation entre Groq et NVIDIA constitue un élément important pour comprendre le positionnement actuel de l’entreprise dans le secteur.
En décembre 2025, Groq et NVIDIA ont conclu un accord non exclusif de licence de technologie d’inférence pour l’IA. Selon les informations publiées par les deux parties, NVIDIA a obtenu une licence sur la technologie d’inférence concernée de Groq, tandis que le fondateur de Groq, Jonathan Ross, le président de l’époque, Sunny Madra, et certains membres de l’équipe ont rejoint NVIDIA. Groq a continué à opérer en tant qu’entreprise indépendante sous la direction du PDG Simon Edwards, et son activité GroqCloud est restée opérationnelle.
Cette transaction signifie que la valeur technologique de Groq se reflète non seulement dans la vente indépendante de services d’inférence, mais aussi dans son intégration à l’écosystème plus vaste du calcul pour l’IA par le biais de licences technologiques.
En mars 2026, NVIDIA a également présenté l’architecture d’accélération de l’inférence Groq 3 LPX et l’a combinée à la plateforme Vera Rubin. La solution associée vise à répartir les charges de travail entre les GPU et les LPU selon les caractéristiques de calcul des différentes étapes de l’inférence pour l’IA, afin d’améliorer l’efficacité de l’inférence à faible latence. Cette évolution reflète la complexité croissante de la concurrence sur le marché des puces d’IA. Par le passé, les puces d’inférence spécialisées étaient souvent considérées comme des substituts potentiels aux GPU. Dans les architectures de calcul hétérogène, différents types de processeurs peuvent toutefois également effectuer des tâches complémentaires.
Par exemple, les GPU peuvent traiter le calcul parallèle à grande échelle et certains calculs d’attention adaptés à leur architecture, tandis que les LPU peuvent traiter des tâches de calcul plus sensibles au temps d’exécution et à la latence des transferts de données. Grâce à une planification au niveau du système, les deux types de processeurs peuvent fonctionner ensemble sur la même charge de travail d’inférence.
Toutefois, les architectures hétérogènes introduisent également une complexité d’ingénierie supplémentaire. Les systèmes doivent coordonner les transferts de données, l’allocation des tâches et la gestion de la mémoire entre différents appareils. Si la surcharge de communication entre appareils est trop élevée, les avantages théoriques du matériel peuvent ne pas se traduire pleinement en performances pratiques.
En août 2026, Groq a également annoncé avoir rejoint le programme NVIDIA Cloud Partner, renforçant davantage son positionnement en tant qu’opérateur d’infrastructure cloud pour l’IA. Par conséquent, Groq ne peut plus être décrit simplement comme une entreprise de puces entièrement indépendante de l’écosystème NVIDIA et exclusivement axée sur la concurrence avec les GPU. Son activité actuelle comprend des services cloud d’inférence indépendants, une technologie de puces spécialisées et une coopération en matière d’infrastructure avec NVIDIA.
Comment le modèle économique de Groq s’adapte-t-il à la croissance du marché de l’inférence pour l’IA ?
La demande commerciale sur le marché de l’inférence pour l’IA provient principalement des applications d’entreprise, des services destinés aux développeurs et des produits d’IA qui fonctionnent en continu. Contrairement à l’entraînement des modèles, qui est généralement fondé sur des projets et se déroule par étapes, les services d’inférence doivent fournir en continu des capacités de calcul à mesure que le trafic utilisateur évolue. Ils accordent donc davantage d’importance à l’utilisation des ressources, aux coûts unitaires et à la stabilité du service.
Le modèle économique de Groq peut être compris à trois niveaux.
-
Construction de l’infrastructure d’inférence. Groq doit créer une capacité de calcul utilisable au moyen de puces, de serveurs, de réseaux et de centres de données. Ces actifs ne peuvent prendre en charge les requêtes des clients et générer des revenus qu’une fois le déploiement des équipements, l’adaptation des modèles et le lancement du service achevés.
-
Services cloud d’inférence. GroqCloud transforme la capacité de calcul en API que les développeurs peuvent appeler, sans que les clients aient à gérer directement les puces sous-jacentes. Pour le fournisseur de services, la croissance des revenus dépend du nombre de clients, du volume de requêtes, de la tarification des services et de la fidélisation des clients.
-
Services d’infrastructure pour les entreprises. Certaines entreprises peuvent avoir besoin de ressources de calcul dédiées, de méthodes de déploiement spécifiques ou d’exigences de gouvernance plus strictes. Ces besoins peuvent créer des relations clients plus stables à long terme, mais ils nécessitent également des investissements plus importants dans l’ingénierie, les opérations et l’assistance client.
En juin 2026, Groq a annoncé avoir obtenu $650 millions de financement de croissance afin d’étendre son activité mondiale de cloud d’inférence pour l’IA, avec pour objectif d’atteindre environ 200 MW de capacité d’infrastructure d’ici 2027. À cette date, l’entreprise a indiqué exploiter 13 centres de données dans plusieurs régions, servir plus de 5 millions de développeurs et traiter chaque semaine des dizaines de milliers de milliards de tokens d’IA.
Ces chiffres peuvent être utilisés pour observer le rythme d’expansion de l’activité, mais ils ne démontrent pas directement la rentabilité. Le nombre de développeurs, le volume de tokens et le nombre de centres de données reflètent respectivement la portée auprès des utilisateurs, l’activité du service et l’échelle de l’infrastructure. Ils ne correspondent pas aux revenus réels, aux bénéfices ou aux flux de trésorerie disponibles.
Par exemple, supposons que le nombre de tokens traités chaque mois par une plateforme d’inférence augmente de 100 %, mais que le prix par token baisse de 40 % en raison de la concurrence sur le marché. La croissance de ses revenus pourrait alors être inférieure à celle de son utilisation. Si les coûts de construction et d’exploitation de l’infrastructure augmentent également au cours de la même période, les marges bénéficiaires pourraient être davantage affectées.
Par conséquent, l’analyse du potentiel de commercialisation de Groq exige de prendre simultanément en compte la croissance de la demande d’inférence, la tarification des services, l’utilisation des équipements et les dépenses d’investissement. La valeur de marché ne peut pas être évaluée uniquement sur la base de la vitesse d’exécution des modèles.
Quels défis techniques et de mise à l’échelle Groq doit-il relever ?
Bien que les puces d’inférence spécialisées puissent être optimisées pour des charges de travail spécifiques, Groq reste confronté à des défis liés aux évolutions des modèles, à la mise à l’échelle du matériel et à la concurrence sur le marché.
Adaptation des modèles. Les architectures de modèles d’IA continuent d’évoluer rapidement. Différents modèles peuvent utiliser des mécanismes d’attention, des échelles de paramètres, des précisions de calcul et des stratégies d’inférence distincts. Si un processeur spécialisé doit prendre en charge davantage de modèles, son compilateur, son environnement d’exécution et ses outils logiciels associés doivent être mis à jour en continu.
Cela signifie également qu’un avantage de performance obtenu par une génération de puces pour un modèle donné peut ne pas s’appliquer directement à chaque nouveau modèle. Avec le développement de l’inférence à long contexte, des modèles de mélange d’experts et du calcul multimodal, les systèmes de calcul sous-jacents doivent continuellement s’adapter à de nouvelles charges de travail.
Mise à l’échelle multi-puces. Les LPU de Groq mettent l’accent sur la SRAM intégrée et l’exécution déterministe, mais les grands modèles nécessitent souvent des ressources de stockage et de calcul supérieures à la capacité d’une seule puce. Lorsqu’un modèle est réparti sur plusieurs puces, le système doit coordonner les transferts de données et les séquences de calcul entre les appareils.
Si la communication multi-puces est inefficace, l’avantage de faible latence d’une seule puce peut être réduit. Par conséquent, les interconnexions entre puces, la bande passante du système et les capacités de planification du compilateur sont des facteurs importants pour déterminer si une architecture d’inférence spécialisée peut évoluer.
Coûts de construction de l’infrastructure. Même si les puces offrent une efficacité de calcul élevée, la construction d’un centre de données pour l’IA nécessite toujours des raccordements électriques, de l’espace, des systèmes de refroidissement et une infrastructure réseau. À mesure que ses services d’inférence se développent, Groq devra également supporter les coûts d’investissement et d’exploitation correspondants.
Concurrence sur le marché. Les GPU NVIDIA, les GPU AMD, les TPU Google et d’autres accélérateurs d’IA spécialisés se disputent tous la demande en calcul d’inférence. Les différentes plateformes peuvent chacune présenter des avantages en matière de compatibilité avec les modèles, de débit, de latence, de coûts et d’écosystèmes logiciels.
Pour les entreprises clientes, le choix final n’est généralement pas déterminé par une seule métrique de performance. Il dépend du coût total des services, de la compatibilité des applications et de la fiabilité opérationnelle à long terme. Par conséquent, la capacité de l’approche technologique de Groq à établir une compétitivité durable dépend non seulement de l’architecture LPU elle-même, mais aussi de la capacité de l’entreprise à continuer d’étendre la prise en charge logicielle, à améliorer l’utilisation des ressources de calcul et à maîtriser le coût de l’expansion de son infrastructure.
Que signifie Groq pour les puces d’IA et le secteur du calcul ?
L’approche technologique représentée par Groq reflète l’évolution progressive du secteur du calcul pour l’IA, qui passe d’architectures centrées sur des accélérateurs généralistes à des systèmes de calcul hétérogène optimisés pour différentes charges de travail. Aux premiers stades du développement de l’IA générative, les capacités d’entraînement constituaient un moteur important des progrès du secteur. À mesure que davantage de modèles entrent dans des applications pratiques, les services d’inférence commencent à créer une demande continue de calcul, renforçant les exigences des entreprises en matière de faible latence, d’efficacité des coûts et de stabilité des services.
Cela crée un espace de développement pour les puces d’inférence spécialisées. En optimisant le matériel et les logiciels pour des processus de calcul spécifiques, les architectures spécialisées peuvent offrir des avantages en termes de performances ou de coûts pour certaines tâches.
Toutefois, cela ne signifie pas que les GPU seront entièrement remplacés par des puces d’inférence spécialisées. Les GPU bénéficient de vastes écosystèmes logiciels, d’une prise en charge étendue des modèles et de capacités de calcul généralistes, ce qui leur permet de s’adapter à diverses charges de travail d’entraînement et d’inférence. Les accélérateurs spécialisés peuvent plutôt jouer un rôle dans certains modèles, certaines étapes de calcul ou certains scénarios à faible latence.
La coopération technologique entre NVIDIA et Groq suggère en outre que les futurs centres de données pour l’IA pourraient déployer simultanément différents types d’appareils de calcul et les coordonner par le biais de systèmes logiciels de planification. Cette approche pourrait améliorer l’utilisation des ressources de calcul, mais elle augmenterait également la complexité de la conception et de la gestion des systèmes.
Pour le secteur des infrastructures d’IA, la concurrence pourrait progressivement passer des performances théoriques des puces individuelles à la capacité de fournir des systèmes de calcul complets. Les performances des puces, la bande passante mémoire, les interconnexions entre appareils, les compilateurs, l’efficacité énergétique et les opérations des services cloud peuvent tous influer sur le rendement commercial final.
L’évolution de Groq montre également que l’infrastructure d’inférence pour l’IA n’est pas uniquement une question de fabrication de puces. Il s’agit d’un secteur intégré couvrant l’architecture matérielle, l’optimisation logicielle, la construction de centres de données et la fourniture de services commerciaux.
Conclusion
Groq est une entreprise technologique axée sur le calcul d’inférence pour l’IA. Son architecture LPU utilise des éléments de conception tels que la SRAM intégrée, l’exécution déterministe et la planification par compilateur pour améliorer l’efficacité d’exécution de certaines charges de travail d’IA. GroqCloud transforme les capacités de calcul sous-jacentes en services cloud d’inférence, permettant aux développeurs et aux entreprises d’utiliser l’infrastructure concernée via des API.
À mesure que les applications d’IA dépassent le cadre de l’entraînement des modèles pour s’étendre aux interactions en temps réel, aux agents d’IA et aux services d’entreprise fonctionnant en continu, la latence d’inférence, le débit et le coût deviennent des métriques techniques de plus en plus importantes. L’architecture d’inférence spécialisée représentée par Groq offre au secteur du calcul pour l’IA une approche alternative aux GPU généralistes.
Dans le même temps, les licences technologiques de Groq et sa coopération en matière d’infrastructure avec NVIDIA montrent que les puces d’inférence spécialisées et les GPU ne doivent pas nécessairement être purement concurrents. Les futurs centres de données pour l’IA pourraient adopter de plus en plus des architectures de calcul hétérogène dans lesquelles différents processeurs traitent les tâches adaptées à leurs caractéristiques respectives.
Toutefois, les avantages techniques des puces spécialisées ne se traduisent pas automatiquement par un succès commercial. Groq doit encore relever les défis liés à l’adaptation des modèles, à la mise à l’échelle multi-puces, aux coûts d’infrastructure et à la rentabilité des services cloud. Son développement à long terme dépendra de sa capacité à transformer ses avantages de performances d’inférence en une demande client stable, des revenus durables et des rendements raisonnables sur le capital.
FAQ
Quel type d’entreprise est Groq ?
Groq est une entreprise technologique axée sur le calcul d’inférence pour l’IA. Ses principaux domaines d’activité comprennent les processeurs spécialisés LPU, les systèmes de calcul d’inférence et les services cloud d’inférence GroqCloud.
Groq et Grok sont-ils le même produit ?
Non. Groq est une entreprise technologique liée à l’infrastructure d’inférence pour l’IA, tandis que Grok est un modèle d’intelligence artificielle et un produit d’assistant développé par xAI.
Qu’est-ce que le LPU de Groq ?
Le LPU est un processeur spécialisé d’inférence pour l’IA conçu par Groq. Il met l’accent sur la SRAM intégrée, l’exécution déterministe, la planification par compilateur et le calcul à faible latence.
En quoi le LPU de Groq diffère-t-il d’un GPU NVIDIA ?
Les LPU accordent davantage d’importance à l’optimisation du calcul et du transfert de données pour des tâches d’inférence spécifiques, tandis que les GPU offrent des capacités de calcul parallèle et des écosystèmes logiciels plus étendus. Les performances réelles dépendent du modèle, de la taille des lots, des exigences de latence et de l’environnement de déploiement.
Groq a-t-il été acquis par NVIDIA ?
En novembre 2026, Groq continue d’opérer en tant qu’entreprise indépendante. Les deux parties ont conclu un accord non exclusif de licence technologique en décembre 2025, et certains membres de l’équipe de Groq ont rejoint NVIDIA. Cela ne signifie pas que NVIDIA a finalisé une acquisition globale de Groq.
Qu’est-ce que GroqCloud ?
GroqCloud est le service cloud d’inférence pour l’IA de Groq. Il permet aux développeurs d’appeler des modèles pris en charge par la plateforme via des API, sans acheter ni déployer eux-mêmes le matériel de calcul sous-jacent.
Pourquoi Groq a-t-il attiré l’attention sur le marché du calcul pour l’IA ?
L’approche technologique de Groq optimise la latence, le transfert de données et l’efficacité d’exécution dans l’inférence pour l’IA. Cela correspond aux exigences d’efficacité de calcul des applications d’IA en temps réel, des agents d’IA et des services d’inférence pour les entreprises.
Groq dispose-t-il de sa propre cryptomonnaie ?
Groq est une entreprise d’infrastructure de calcul pour l’IA. Ses activités LPU et GroqCloud ne reposent pas sur un token de cryptomonnaie natif. Les tokens tiers portant des noms similaires ne doivent pas être considérés directement comme des actifs émis ou approuvés par Groq.