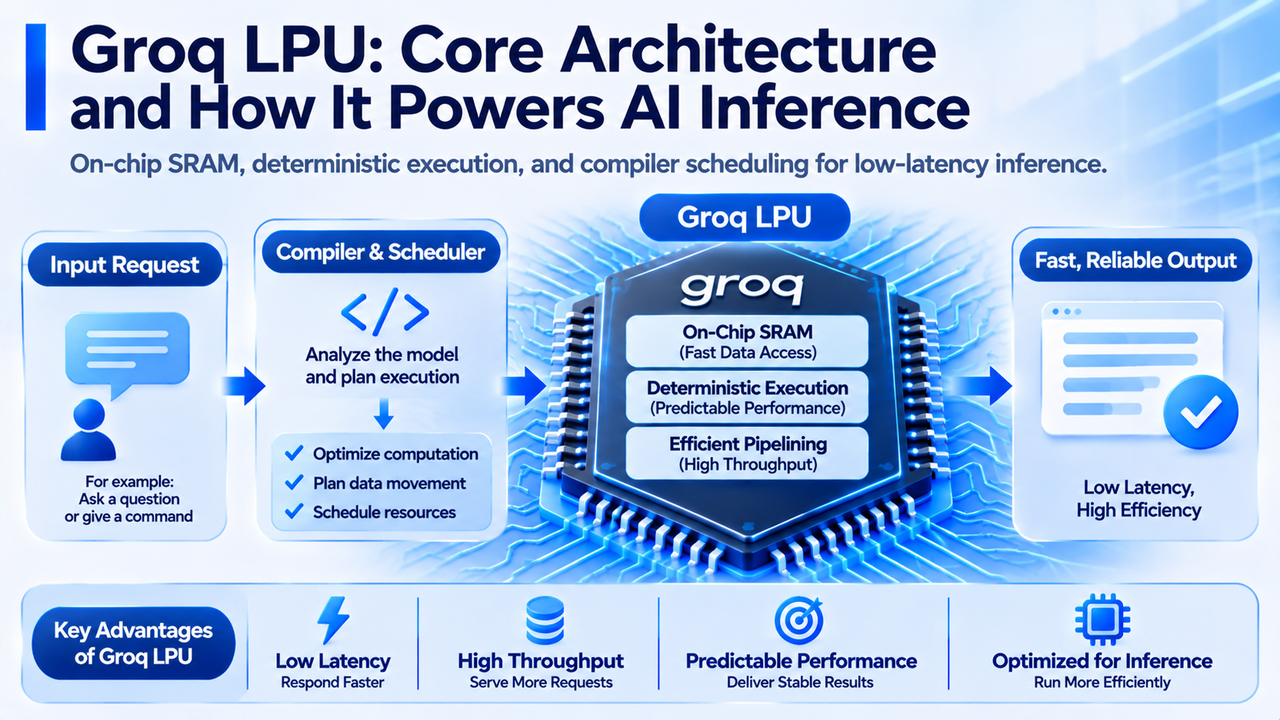
Contrairement aux GPU, conçus pour un large éventail de tâches de calcul massivement parallèles, les LPU de Groq utilisent une architecture qui met l’accent sur la SRAM sur puce, l’ordonnancement statique par compilateur et l’exécution déterministe. Cette approche vise à réduire les transferts de données et la surcharge d’ordonnancement à l’exécution lors de l’inférence, afin de fournir des capacités de calcul plus ciblées pour les applications d’IA en temps réel.
À mesure que les grands modèles de langage sont davantage utilisés dans le service client intelligent, les interactions vocales, les agents d’IA et l’automatisation des entreprises, les exigences en matière d’inférence ne se limitent plus à maximiser la vitesse de traitement. Elles incluent également la latence de réponse, la stabilité du service et les coûts de calcul unitaires. L’approche des accélérateurs dédiés, représentée par les LPU de Groq, offre à l’infrastructure d’IA une option technique distincte des architectures de calcul généralistes traditionnelles. Cet article présente en détail le fonctionnement des LPU de Groq, analyse l’effet de la SRAM, de l’exécution déterministe et des compilateurs sur les performances d’inférence, et examine leurs cas d’usage ainsi que leurs limites techniques.
Points clés
-
Le Groq LPU est un processeur dédié conçu pour les charges de travail d’inférence d’IA, qui met l’accent sur une faible latence, une exécution prévisible et des transferts de données efficaces.
-
L’inférence des grands modèles de langage se compose généralement de deux étapes : Prefill et Decode. Ces étapes ont des exigences différentes en matière de puissance de calcul et de bande passante mémoire.
-
Les LPU de Groq utilisent de la SRAM sur puce pour raccourcir certains chemins d’accès aux données, mais leur capacité de stockage sur puce relativement limitée impose également des contraintes pour le déploiement des modèles et la mise à l’échelle sur plusieurs puces.
-
L’exécution déterministe et l’ordonnancement statique par compilateur peuvent réduire une partie de la surcharge d’ordonnancement à l’exécution, mais ils ne signifient pas que chaque requête aura exactement le même temps de réponse.
-
Les LPU présentent des avantages potentiels pour les applications à faible latence, telles que la génération de texte en temps réel et les interactions vocales. Leurs performances réelles dépendent toujours du modèle, de la charge de travail, de la configuration du système et de la tarification du service.
Qu’est-ce que le Groq LPU ? En quoi diffère-t-il des accélérateurs d’IA traditionnels ?
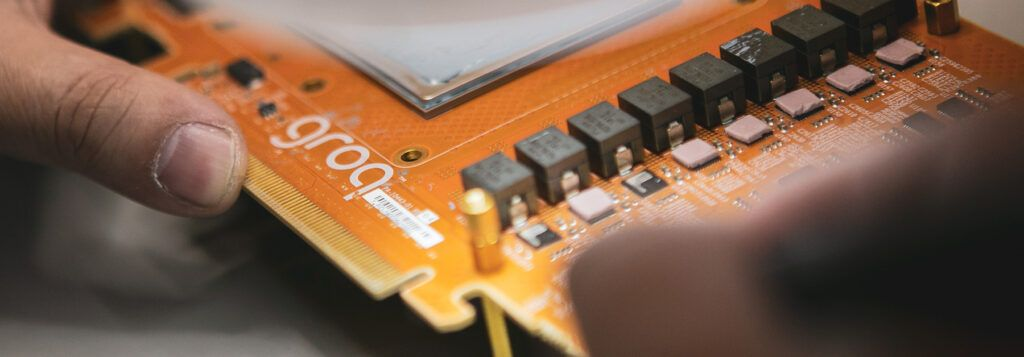
Le Groq LPU est un processeur d’inférence d’IA dédié conçu par Groq. LPU signifie Language Processing Unit. Sa conception vise à optimiser le déplacement des données, l’exécution des calculs et le contrôle de la latence lors de l’inférence de modèles de langage, plutôt qu’à fournir des capacités de calcul généralistes pour tous les types de tâches.
Pour comprendre le positionnement technique des LPU, il est d’abord nécessaire de reconnaître les différentes approches de conception utilisées par les accélérateurs d’IA. Les GPU ont été initialement conçus principalement pour le traitement graphique. Ils ont ensuite été largement adoptés pour l’entraînement et l’inférence de deep learning grâce à leurs capacités de calcul parallèle à grande échelle et à leur écosystème logiciel mature. Les accélérateurs dédiés tels que les TPU améliorent l’efficacité d’exécution de tâches de calcul spécifiques en optimisant les opérations d’apprentissage automatique.
Les LPU de Groq mettent davantage l’accent sur la coordination entre le compilateur et le matériel. Leur architecture vise à planifier les calculs et les transferts de données avant l’exécution d’un modèle, permettant à la puce d’effectuer les tâches selon un calendrier prédéfini et de réduire ainsi une partie de la surcharge générée par l’ordonnancement dynamique.
Cette approche de conception est étroitement liée à l’orientation technologique Tensor Streaming Processor (TSP) introduite par Groq au début de son développement. En organisant les ressources de calcul, le stockage sur puce et les chemins de transfert de données, le processeur permet aux opérations du modèle de s’exécuter dans la séquence organisée par le compilateur.
Il est important de noter que LPU n’est pas une catégorie industrielle normalisée pour l’ensemble des processeurs de modèles de langage. Il s’agit d’un nom technique utilisé par Groq. Différents fabricants peuvent utiliser différentes conceptions de puces ou obtenir une inférence à faible latence au moyen de GPU, d’ASIC ou d’autres accélérateurs dédiés.
Par conséquent, évaluer la valeur technique des LPU de Groq exige davantage que de considérer le nom du processeur. Il faut analyser la manière dont ils gèrent l’accès aux données, l’ordonnancement des calculs et la communication entre plusieurs puces lors de l’inférence.
Pourquoi les grands modèles de langage ont-ils besoin de calculs à faible latence ?
L’inférence d’un grand modèle de langage désigne le processus par lequel un modèle reçoit une entrée et utilise ses paramètres entraînés pour générer une sortie. Pour les modèles de langage autorégressifs courants, l’inférence se compose généralement de deux étapes : Prefill et Decode. L’étape Prefill traite principalement le prompt de l’utilisateur et établit l’état de calcul nécessaire à la génération ultérieure. Comme cette étape peut traiter simultanément plusieurs tokens d’entrée, elle présente généralement de fortes caractéristiques de calcul parallèle.
L’étape Decode génère les tokens de sortie un par un. Le modèle doit généralement prédire le token suivant à partir de l’entrée existante et du contenu précédemment généré, ce qui crée des dépendances entre plusieurs étapes de génération. Par conséquent, ces étapes ne peuvent pas être entièrement parallélisées aussi facilement que certains calculs d’entraînement.
Cette distinction signifie que les performances d’inférence ne peuvent pas être mesurées à l’aide d’un seul indicateur.
Le délai avant le premier token (TTFT) mesure le temps écoulé entre le début d’une requête et la génération du premier token de sortie. Il détermine principalement le temps d’attente que les utilisateurs perçoivent avant d’obtenir une réponse.
La vitesse de génération des tokens mesure le nombre de tokens qu’un modèle peut générer par unité de temps après avoir commencé à produire une sortie. Elle affecte directement la fluidité de la génération continue de texte. Le débit porte sur le nombre de requêtes ou de tokens qu’un système peut traiter sur une période donnée et reflète la capacité globale de traitement d’un service d’inférence sous une charge concurrente relativement élevée.
Par exemple, deux plateformes d’inférence peuvent toutes deux exécuter le même modèle de langage, mais la plateforme A peut offrir une génération de tokens plus rapide pour une requête d’utilisateur unique, tandis que la plateforme B peut atteindre un débit global plus élevé lors du traitement simultané de centaines de requêtes.
Cela signifie qu’une faible latence et un débit élevé ne constituent pas exactement le même objectif de performance. Un système optimisé pour l’interaction en temps réel avec un seul utilisateur ne présente pas nécessairement les mêmes avantages dans tous les scénarios de traitement par lots ou de forte concurrence.
Pour les assistants vocaux, la traduction en temps réel et les applications d’IA interactives, le TTFT et la vitesse de génération continue sont particulièrement importants. Les utilisateurs s’attendent généralement à ce que le système commence à répondre rapidement et continue de produire un contenu naturel et fluide.
Pour des tâches telles que l’analyse de documents hors ligne et le traitement de données par lots, le temps de réponse immédiat d’une requête individuelle peut être moins important. Les entreprises peuvent plutôt accorder davantage d’importance au débit global et aux coûts de traitement unitaires.
L’une des priorités de conception des LPU de Groq consiste à optimiser l’efficacité d’exécution pour les charges de travail d’inférence sensibles au temps de réponse.
Comment les LPU de Groq utilisent-ils la SRAM pour améliorer l’efficacité de l’accès aux données ?
Les performances des processeurs d’IA modernes dépendent non seulement du nombre d’opérations que leurs unités de calcul peuvent effectuer, mais aussi de la capacité des données à atteindre ces unités à temps.
Lors de l’inférence de grands modèles de langage, les processeurs lisent de manière répétée les poids du modèle, accèdent aux résultats intermédiaires et maintiennent les données liées au contexte. Si les données ne peuvent pas être lues suffisamment rapidement, même une puce disposant d’une puissance de calcul théorique élevée peut ne pas fonctionner à pleine capacité, car elle attend les données.
Ce problème est couramment appelé le goulot d’étranglement de la mémoire.
L’une des principales caractéristiques architecturales des LPU de Groq est l’importance accordée à l’utilisation de SRAM sur puce (Static Random-Access Memory) pour le stockage et l’accès aux données.
La SRAM offre généralement une faible latence d’accès et peut être intégrée directement à la puce du processeur. Par rapport aux données accessibles via une interface mémoire externe, le stockage sur puce peut raccourcir les chemins de transfert de données et réduire une partie de la surcharge d’accès.
Pour comprendre cette conception, il est utile de comparer les caractéristiques fondamentales de la SRAM et de la mémoire à haute bande passante (HBM).
| Dimension de comparaison |
SRAM |
HBM |
| Emplacement habituel |
À l’intérieur de la puce du processeur |
Empilement de mémoire indépendant au sein du boîtier du processeur |
| Principaux avantages |
Faible latence d’accès et intégration étroite |
Capacité plus élevée et bande passante globale importante |
| Principales limites |
Coût élevé en surface et capacité limitée |
L’accès aux données nécessite toujours une interface mémoire |
| Utilisations typiques |
Cache et mémoire de travail sur puce |
Données à grande échelle telles que les poids de modèle et les activations |
| Importance pour l’inférence |
Optimise certains chemins d’accès aux données |
Prend en charge des modèles et des états de calcul plus volumineux |
Toutefois, il ne faut pas simplement supposer que la SRAM est plus rapide que la HBM dans toutes les situations ou que l’utilisation de SRAM élimine le goulot d’étranglement de la mémoire. Les performances réelles dépendent également de la disposition des données, des schémas d’accès parallèle, de la bande passante mémoire et de l’architecture du modèle.
Les principales limites de la SRAM sont sa densité de stockage et son coût en surface de puce. Pour les modèles de langage comportant un grand nombre de paramètres, la SRAM d’un seul processeur est généralement insuffisante pour contenir tous les poids du modèle et les états d’exécution.
Groq doit donc utiliser une coordination entre plusieurs puces et une allocation des données à l’échelle du système afin d’exécuter les modèles sur des systèmes de calcul plus vastes. Cela signifie que les avantages des LPU ne proviennent pas uniquement de la SRAM d’une puce individuelle. Ils résultent plutôt de la conception globale du stockage sur puce, des pipelines de calcul, des interconnexions entre puces et des compilateurs.
Comment l’exécution déterministe et l’ordonnancement par compilateur influencent-ils les performances d’inférence ?
L’exécution déterministe est un autre concept clé pour comprendre l’architecture des LPU de Groq. Son idée centrale consiste à déterminer autant que possible l’ordre d’exécution des opérations de calcul, les chemins de transfert de données et l’allocation des ressources avant l’exécution d’un programme, afin de réduire la nécessité de prendre des décisions d’ordonnancement ponctuelles pendant l’exécution.
Dans les architectures de calcul généralistes traditionnelles, les processeurs doivent s’adapter à différents types de programmes et de charges de travail. Afin d’améliorer l’utilisation des ressources, les systèmes incluent généralement l’ordonnancement dynamique des tâches, la gestion du cache et d’autres mécanismes d’exécution. Ces conceptions offrent une flexibilité considérable, mais peuvent également introduire une surcharge d’ordonnancement supplémentaire.
Les LPU de Groq utilisent une approche de conception différente. Avant l’exécution d’un modèle, le compilateur analyse son graphe de calcul et crée un plan d’exécution pour les opérations de calcul et les mouvements de données. Le processeur fonctionne ensuite conformément à ce plan, ce qui permet aux données de circuler de manière ordonnée entre les différentes unités de calcul. Par exemple, un modèle de langage peut devoir effectuer en continu des opérations matricielles, des fonctions d’activation et d’autres calculs. Le compilateur peut organiser à l’avance l’exécution de ces tâches sur différentes ressources de calcul et coordonner les transferts de données requis.
Cette approche s’apparente à la planification préalable de chaque étape d’une chaîne de production, afin que les différentes étapes puissent fonctionner ensemble selon un rythme prédéfini.
Pour l’inférence d’IA, l’exécution déterministe a trois implications principales.
-
Elle peut réduire une partie de la surcharge d’ordonnancement à l’exécution. Le processeur n’a pas besoin de redéterminer l’ordre d’exécution de chaque tâche à chaque étape de calcul, ce qui peut contribuer à améliorer l’efficacité d’exécution pour des charges de travail spécifiques.
-
Elle peut rendre les temps d’exécution des calculs plus prévisibles. Pour les services d’IA en temps réel, la constance des performances de réponse est aussi importante qu’une faible latence moyenne. L’exécution déterministe ne signifie pas que le temps de réponse des requêtes API réelles sera totalement fixe. La longueur des entrées, le nombre de tokens de sortie, la mise en file d’attente des requêtes, la transmission réseau et la charge du service peuvent toujours entraîner des variations de latence de bout en bout.
-
L’ordonnancement statique peut également réduire la flexibilité de certaines tâches de calcul. Si un modèle comporte un flux de contrôle dynamique complexe ou si le chemin d’exécution doit fréquemment changer en fonction de résultats en temps réel, le compilateur peut devoir utiliser des stratégies de traitement supplémentaires.
Ainsi, la valeur de l’exécution déterministe ne réside pas dans l’élimination de toute incertitude. Elle améliore plutôt, pour les tâches de calcul adaptées, l’efficacité d’utilisation des ressources matérielles grâce à une planification d’exécution plus explicite.
Pourquoi les LPU de Groq sont-ils adaptés à l’inférence d’IA à faible latence ?
La conception à faible latence des LPU de Groq ne repose pas sur une seule technologie. Elle résulte des effets combinés de la SRAM sur puce, de l’exécution déterministe, de l’optimisation par compilateur et des interconnexions à l’échelle du système. Lors de la génération par un grand modèle de langage, le modèle doit effectuer continuellement des calculs et générer les tokens suivants à partir des résultats existants. Si un processeur peut réduire certains délais d’accès aux données et une partie de la surcharge d’ordonnancement à l’exécution, il peut raccourcir le temps nécessaire aux étapes successives de génération.
Cela est particulièrement pertinent pour l’étape Decode. Étant donné que les modèles autorégressifs doivent généralement générer les tokens un par un, la latence de chaque étape de génération s’accumule et affecte finalement la vitesse de sortie du texte perçue par les utilisateurs. Toutefois, les goulots d’étranglement de performance des différentes tâches d’inférence ne sont pas toujours les mêmes. Le traitement de prompts longs peut dépendre davantage des capacités de calcul parallèle à grande échelle, tandis que la génération continue peut être davantage influencée par l’accès à la mémoire et la latence d’exécution étape par étape.
Par conséquent, les performances réelles des LPU de Groq doivent être évaluées en tenant compte du type de modèle, de la longueur des entrées, de la longueur des sorties et du nombre de requêtes simultanées.
Du point de vue des applications, les types de services suivants sont particulièrement sensibles à l’inférence à faible latence.
Interactions vocales en temps réel. Un assistant vocal doit convertir la parole de l’utilisateur en texte, appeler un modèle de langage pour générer une réponse, puis produire le résultat au moyen de la synthèse vocale. Si le modèle de langage génère les réponses lentement, la conversation peut connaître des pauses perceptibles.
Agents d’IA interactifs. Lors de l’exécution de tâches, un agent d’IA peut devoir appeler plusieurs fois un modèle de langage afin de déterminer l’action suivante. Chaque délai d’inférence affecte le temps global d’exécution de la tâche. Réduire le temps d’attente des inférences individuelles peut donc améliorer l’expérience utilisateur.
Service client intelligent et applications en temps réel. Les services en ligne destinés à un grand nombre d’utilisateurs doivent non seulement répondre rapidement, mais aussi contrôler les variations de latence entre les requêtes afin de maintenir une qualité de service stable.
Toutefois, une faible latence ne signifie pas nécessairement le coût de calcul unitaire le plus bas. Par exemple, une plateforme d’inférence peut traiter une requête individuelle à grande vitesse, mais si son coût d’acquisition du matériel est élevé ou si des ressources importantes restent inutilisées sous faible charge, son coût réel de service par million de tokens peut tout de même dépasser celui d’autres solutions. À l’inverse, une autre plateforme peut générer les tokens plus lentement pour des requêtes individuelles, tout en servant de nombreux utilisateurs simultanément grâce au traitement par lots et en atteignant finalement un coût moyen inférieur.
Par conséquent, lors du choix d’une plateforme d’inférence, les entreprises doivent équilibrer latence, débit, coût et compatibilité des modèles, plutôt que de prendre une décision fondée uniquement sur le nombre de tokens par seconde.
Quelles sont les limites techniques des LPU de Groq ?
Bien que les LPU de Groq soient spécifiquement optimisés pour l’inférence d’IA, une architecture dédiée ne signifie pas qu’ils surpasseront les autres solutions dans toutes les tâches de calcul. Leurs principales limites techniques concernent la capacité mémoire, la mise à l’échelle sur plusieurs puces, la compatibilité des modèles et le coût du système.
Limites de capacité de la SRAM sur puce. La SRAM ayant une densité de stockage relativement faible, la quantité de stockage sur puce disponible sur une seule puce est limitée. Lorsque les paramètres du modèle et les états d’exécution dépassent la capacité d’une seule puce, les calculs et les données doivent être répartis sur un système à plusieurs puces.
Par exemple, un grand modèle de langage peut nécessiter des dizaines de gigaoctets de stockage ou davantage. Il est généralement difficile de stocker l’ensemble de ces données en utilisant uniquement la SRAM sur puce d’une seule puce. Le système doit donc répartir le modèle entre plusieurs processeurs et utiliser des interconnexions entre puces pour effectuer les échanges de données nécessaires.
Cette approche peut accroître la taille des modèles déployables, mais elle augmente également la complexité de conception du système.
Surcharge de communication entre plusieurs puces. Même si un LPU individuel peut exécuter rapidement les calculs, la vitesse globale d’inférence peut toujours être affectée par la bande passante des interconnexions, la latence de communication et les stratégies d’allocation des données lorsque le modèle nécessite de fréquents transferts de données entre puces. Dans les systèmes d’inférence à grande échelle, les performances dépendent non seulement de la puissance de calcul d’un processeur individuel, mais aussi du fonctionnement coordonné de l’ensemble du cluster de puces.
Compatibilité des modèles. Les LPU de Groq s’appuient sur des compilateurs pour mapper les calculs des modèles vers du matériel dédié et nécessitent donc un support logiciel correspondant. Lorsque de nouveaux modèles d’IA introduisent des opérateurs de calcul, des mécanismes d’attention ou des méthodes d’exécution dynamique différents, la plateforme peut devoir mettre à jour son compilateur et son environnement d’exécution. Par rapport aux GPU généralistes, qui disposent d’écosystèmes logiciels étendus, les processeurs d’inférence dédiés nécessitent un développement logiciel continu pour s’adapter à l’évolution rapide des technologies de modèles.
Coûts d’infrastructure et commerciaux. Les avantages de performance des LPU nécessitent un système de calcul complet. Le déploiement réel implique toujours des coûts liés à la fabrication des puces, aux serveurs, au réseau, à l’alimentation électrique et aux installations de refroidissement. Pour les fournisseurs de services d’inférence dans le cloud, l’utilisation des équipements et la demande des clients déterminent également le retour sur investissement.
Les LPU de Groq doivent donc être évalués en tenant compte de leurs conditions de déploiement réelles. Une vitesse de génération de tokens élevée dans un test particulier ne démontre pas directement une meilleure efficacité des coûts dans tous les modèles et scénarios commerciaux.
Que représentent les LPU de Groq pour l’avenir de l’infrastructure d’inférence d’IA ?
Le développement des LPU de Groq reflète la spécialisation croissante du marché du calcul d’IA. À mesure que les applications d’IA générative se développent, les entreprises commencent à sélectionner des architectures de calcul plus spécialisées selon les différentes charges de travail, plutôt que de se concentrer uniquement sur les performances de pointe théoriques d’un processeur individuel.
Dans l’entraînement des modèles, le calcul parallèle à grande échelle, la capacité mémoire et la communication entre plusieurs dispositifs restent importants. Dans l’inférence, le TTFT, la vitesse de génération continue, le débit concurrent et le coût par token sont devenus des indicateurs commerciaux plus directs.
Les différences entre les tâches de calcul créent un espace de développement pour les puces d’inférence dédiées. Dans le même temps, les processeurs dédiés et les GPU n’ont pas nécessairement une relation purement substitutive. En mars 2026, NVIDIA a introduit une architecture d’inférence combinant Groq 3 LPX et la plateforme Vera Rubin, explorant la manière dont différents types de dispositifs de calcul peuvent prendre en charge des tâches d’inférence adaptées à leurs caractéristiques respectives.
Cette orientation reflète la tendance de développement du calcul hétérogène. À l’avenir, les centres de données d’IA pourraient déployer simultanément des GPU, des accélérateurs d’inférence dédiés et d’autres dispositifs de calcul, les systèmes logiciels coordonnant l’exécution des différentes tâches.
Par exemple, des ressources GPU adaptées peuvent être utilisées pour les charges de travail nécessitant un traitement parallèle à grande échelle, tandis que les processeurs d’inférence dédiés peuvent offrir des avantages pour certaines tâches de génération très sensibles à la latence. Toutefois, le calcul hétérogène ne signifie pas que l’ajout de davantage de types de puces améliorera simplement l’efficacité. Les systèmes doivent également traiter les questions de communication entre dispositifs, d’ordonnancement des tâches, de compatibilité logicielle et de coûts d’infrastructure.
Pour le secteur des puces d’IA, cela signifie que la concurrence s’étend des performances des composants matériels individuels à l’efficacité de systèmes de calcul complets. L’architecture des processeurs, les compilateurs, les systèmes de mémoire, les technologies d’interconnexion et l’exploitation des services cloud peuvent tous devenir des facteurs déterminant les performances finales et la valeur commerciale.
L’approche technologique représentée par les LPU de Groq constitue un exemple concret de cette évolution. Leur valeur à long terme dépendra non seulement de la vitesse d’inférence d’une génération de puce particulière, mais aussi de leur capacité à continuer de s’adapter à l’évolution des modèles et à transformer les performances techniques en services de calcul stables et évolutifs.
Conclusion
Le Groq LPU est un processeur dédié conçu pour l’inférence d’IA. Il utilise des technologies telles que la SRAM sur puce, l’exécution déterministe et l’ordonnancement statique par compilateur afin d’optimiser l’accès aux données et l’exécution des calculs pour certaines charges de travail de grands modèles de langage.
Par rapport aux GPU généralistes, les LPU de Groq mettent davantage l’accent sur la faible latence et la prévisibilité de l’exécution pour des tâches d’inférence spécifiques. Cette conception convient à l’exploration de l’optimisation des performances dans des applications telles que la génération de texte en temps réel, les interactions vocales et les agents d’IA, mais elle ne signifie pas que les LPU peuvent remplacer les GPU dans tous les modèles et scénarios de calcul.
Dans le même temps, la capacité de SRAM, la communication entre plusieurs puces, l’adaptation des modèles et les coûts d’infrastructure restent des enjeux importants auxquels les architectures d’inférence dédiées doivent répondre.
À mesure que le secteur de l’IA passe du développement de modèles aux applications à grande échelle, la concurrence dans le calcul d’inférence se déplace de la simple maximisation de la puissance de calcul vers l’optimisation de la latence, du débit, du coût et de l’efficacité globale du système. Le développement des LPU de Groq montre que les accélérateurs dédiés peuvent jouer un rôle plus important dans les futures infrastructures d’IA, mais leur valeur réelle doit encore être validée par des charges de travail spécifiques et des résultats de déploiement commercial.
FAQ
Qu’est-ce que le Groq LPU ?
Le Groq LPU est un processeur d’inférence d’IA dédié conçu par Groq. Il utilise principalement des technologies telles que la SRAM sur puce, l’exécution déterministe et l’ordonnancement par compilateur pour optimiser des tâches spécifiques d’inférence de modèles de langage.
Quelles sont les principales différences entre les LPU et les GPU ?
Les LPU mettent davantage l’accent sur l’optimisation de l’exécution et du transfert de données pour des tâches d’inférence spécifiques, tandis que les GPU offrent de vastes capacités de calcul parallèle et un écosystème logiciel mature. Leurs différences de performances dépendent du modèle spécifique et de l’environnement d’exécution.
Pourquoi les LPU de Groq utilisent-ils de la SRAM ?
La SRAM fournit un accès aux données sur puce à faible latence, ce qui peut aider à réduire la surcharge de lecture des données dans certaines tâches d’inférence. Toutefois, la capacité de la SRAM est limitée. Le déploiement de grands modèles nécessite donc généralement une coordination entre plusieurs puces.
Que signifie l’exécution déterministe ?
L’exécution déterministe consiste à planifier autant que possible l’ordre des calculs, les transferts de données et l’allocation des ressources avant l’exécution d’un programme. Cela peut réduire une partie de la surcharge d’ordonnancement à l’exécution et rendre l’exécution des calculs plus prévisible.
Les LPU de Groq peuvent-ils être utilisés pour l’entraînement de modèles d’IA ?
Les LPU de Groq sont principalement conçus pour les charges de travail d’inférence et ne sont pas principalement destinés à l’entraînement généraliste de modèles à grande échelle. Leur prise en charge réelle dépend de l’architecture matérielle et de la chaîne d’outils logiciels.
Les LPU de Groq sont-ils toujours plus rapides que les GPU NVIDIA pour l’inférence ?
Pas nécessairement. Différents modèles, longueurs d’entrée, longueurs de sortie, niveaux de concurrence et environnements de test peuvent tous affecter les résultats. Une vitesse de génération de tokens plus élevée pour un utilisateur unique ne signifie pas nécessairement un meilleur débit global ou des coûts par token inférieurs.
Pourquoi les LPU de Groq sont-ils adaptés aux agents d’IA ?
Les agents d’IA peuvent devoir effectuer plusieurs appels d’inférence en séquence. Réduire la latence de réponse de chaque requête peut raccourcir le temps d’exécution de la tâche globale, mais le résultat final dépend également des appels d’outils, de la transmission réseau et d’autres étapes de traitement.