Pour les lecteurs qui choisissent selon la tâche à accomplir, l’essentiel n’est pas de savoir « quel camp est le plus performant », mais de déterminer si un échec est plus dommageable sous la forme d’un non-sens fluide ou d’une dérive des dynamiques. Les sections ci-dessous comparent un modèle du monde à un LLM selon les cibles de prédiction, les données et l’évaluation, les tâches adaptées, les règles de combinaison et les erreurs d’interprétation. Les plafonds de capacités sont abordés avec la superintelligence (ASI) ; les limites de déploiement avec l’IA privée.
Points clés
- Les modèles du monde optimisent les dynamiques du prochain état ou les dynamiques latentes conditionnées par l’action ; les LLM optimisent le token suivant et la structure du texte.
- Privilégiez les modèles du monde pour la planification et le contrôle incarnés ; privilégiez les LLM pour la rédaction, les questions-réponses enrichies par récupération et l’appel d’outils.
- Lorsqu’une tâche nécessite à la fois une interface linguistique et des dynamiques d’environnement pouvant être simulées, combinez-les au lieu de les considérer comme des substituts.
- Les modes de défaillance diffèrent : les LLM échouent souvent par hallucination linguistique ; les modèles du monde par dérive des dynamiques et physique fictive.
Qu’est-ce qu’un modèle du monde ?
Un modèle du monde est un système de dynamiques appris : à partir d’un état actuel (ou d’une observation) et d’une action candidate, il prédit l’évolution de l’environnement afin qu’un agent puisse tester des actions en imagination avant de planifier. L’axe de décision le plus clair est la prédiction conditionnée par l’action, et non la fluidité conversationnelle.
Contrairement aux systèmes qui ne produisent que du texte ou une apparence visuelle, les piles technologiques orientées modèle du monde relient les prédictions à des boucles de planification, de contrôle ou d’entraînement par imagination. Les approches courantes comprennent l’apprentissage par renforcement fondé sur un modèle (par exemple Dreamer), la simulation interactive générative et la prédiction de représentations de type JEPA ; leurs objectifs diffèrent, donc les noms de marque ne sont pas interchangeables.
Qu’est-ce qu’un grand modèle de langage ?
Un grand modèle de langage (LLM) est un modèle génératif entraîné sur de vastes corpus textuels, dont l’objectif principal est la prédiction du token suivant. Un LLM est performant pour la compréhension du langage, le résumé, la traduction, l’assistance au codage et l’orchestration de texte en plusieurs étapes au moyen de prompts et d’interfaces d’outils.
Un LLM peut décrire le monde physique ou rédiger les étapes de « ce qui se passe si vous poussez une tasse », mais une description ne constitue pas des dynamiques d’environnement simulables et évaluables. Sans interface action-état ni vérifications en boucle fermée, traiter un LLM comme un contrôleur ou un moteur physique est une erreur de sélection, et non un problème de « modèle trop petit ».
En quoi les cibles de prédiction diffèrent-elles ?
La différence fondamentale réside dans l’objet prédit : un modèle du monde prédit l’état suivant ou les dynamiques latentes après une action ; un LLM prédit le token suivant et la structure du texte. Tous deux « prédisent », mais ne partagent pas le même critère de réussite.
| Caractéristique |
Modèle du monde |
LLM |
| Cible de prédiction |
État suivant / dynamiques latentes, souvent conditionnés par l’action |
Token suivant / texte et suivi des instructions |
| Lien avec l’action |
La prédiction conditionnée par l’action est l’axe de décision |
Ne modélise généralement pas de boucle de contrôle physique |
| Forme de sortie |
États, représentations, trajectoires ou observations interactives |
Texte, code, arguments d’appel d’outils |
| Critères de réussite |
Conséquences vérifiables, capacité de planification, erreur traçable |
Exactitude sémantique, format exploitable, citations vérifiables |
| Défaillance typique |
Dérive des dynamiques, physique fictive |
Hallucination linguistique, citations inventées |
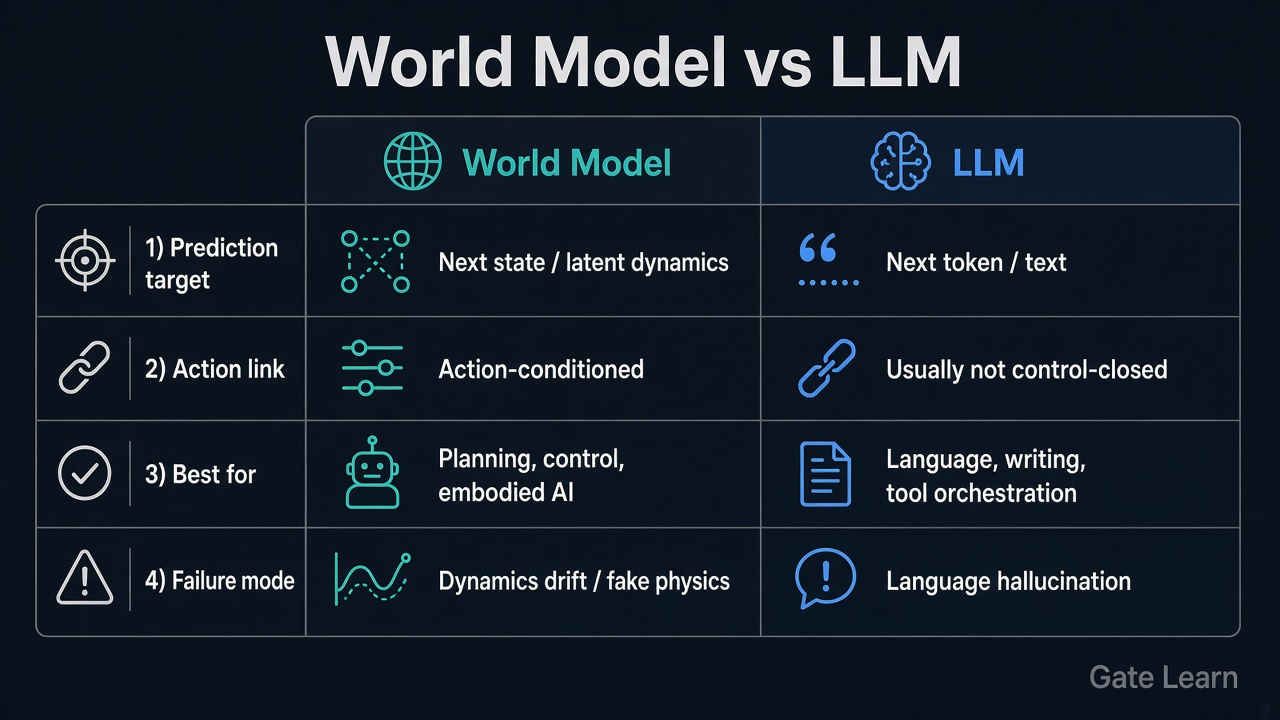
Figure 1. Comparaison selon quatre axes entre les modèles du monde et les LLM : cible de prédiction, lien avec l’action, tâches les mieux adaptées et mode de défaillance.
JEPA et les LLM sont souvent confondus. JEPA (par exemple I-JEPA de Meta AI) prédit des représentations futures abstraites dans un espace d’incorporation conjoint et est orienté modèle du monde ; les LLM restent des systèmes de modélisation du langage. Des noms similaires n’impliquent pas qu’ils soient interchangeables. Consultez le glossaire NVIDIA : modèles du monde et la réflexion de LeCun sur cette voie (Vers une intelligence machine autonome).
En quoi les données, les sorties et l’évaluation diffèrent-elles ?
Les données et l’évaluation découlent de la cible de prédiction : les modèles du monde s’appuient sur des trajectoires interactives, des transitions d’état, des signaux de contrôle et parfois des vidéos ; les LLM s’appuient sur des corpus, des données d’instructions et, éventuellement, des journaux d’outils. L’utilisation en aval détermine les métriques d’erreur.
| Dimension |
Modèle du monde |
Grand modèle de langage |
| Données typiques |
Trajectoires observation–action–observation suivante / récompense, incluant parfois des vidéos |
Texte, dialogues, code, traces d’outils |
| Sorties principales |
État suivant, dynamiques latentes, trajectoires imaginées |
Texte, réponses structurées, appels de fonction |
| Priorité d’évaluation |
Erreur sur plusieurs étapes, réussite de tâche, robustesse hors distribution |
Exactitude, fidélité, format et sécurité |
| Problèmes difficiles à détecter |
Physique fictive à l’apparence fluide ; amplification à long horizon |
Hallucinations fluides ; citations qui échouent aux vérifications |
Utiliser « rédiger un paragraphe correct sur la physique » pour certifier un modèle du monde, ou « la séquence vidéo est réussie » pour certifier une boucle de contrôle LLM, revient à inverser l’axe d’évaluation. Définissez d’abord la sortie vérifiable, puis choisissez la famille de modèles.
Quelles tâches conviennent mieux aux modèles du monde ? Lesquelles conviennent mieux aux LLM ?
Commencez par identifier où se situe le coût d’un échec : dans la physique et le contrôle, ou dans la sémantique et la communication. Privilégiez les modèles du monde dans le premier cas et les LLM dans le second. Lorsque les deux dimensions doivent être assurées, utilisez « combinaison obligatoire » au lieu de désigner un unique gagnant.
| Condition de la tâche |
Préférer un modèle du monde |
Préférer un LLM |
Lorsqu’une combinaison est requise |
| Nécessite une prédiction explicite action → état suivant |
Oui |
Non |
— |
| Nécessite une interface en langage naturel, la génération de documentation ou de code |
Non |
Oui |
— |
| Planification incarnée ; filtrer les trajectoires défaillantes avant le contact, comme dans la conduite autonome |
Oui |
Non, le LLM peut seulement expliquer |
LLM pour les instructions ; modèle du monde pour les dynamiques simulées |
| Questions-réponses enrichies par récupération, rédaction, orchestration d’outils |
Non |
Oui |
— |
| Entraîner une politique en imagination (MBRL) |
Oui |
Non |
Le LLM peut rédiger le texte de la tâche ; les dynamiques requièrent toujours un modèle du monde |
| Dialogue relatif aux objectifs, avec une boucle de contrôle exécutable |
Ne suffit pas seul |
Ne suffit pas seul |
Combinaison obligatoire : le LLM analyse les objectifs → le modèle du monde / planificateur exécute |
La « combinaison obligatoire » correspond à une architecture fréquente : le LLM gère l’intention et l’interface ; le modèle du monde, ou un simulateur associé à des dynamiques apprises, gère la prédiction des conséquences et le filtrage des trajectoires. Supprimer l’un des deux composants fait souvent basculer le système vers le mode de défaillance de l’autre.
Quand faut-il combiner les deux ?
Combinez-les lorsqu’une tâche comprend à la fois un objectif au niveau du langage et des conséquences au niveau de l’environnement : ne les présentez pas comme substituables. Une chaîne typique fonctionne ainsi : le LLM transforme les objectifs en sous-objectifs ou en contraintes ; le modèle du monde simule des actions candidates ; un planificateur sélectionne une trajectoire selon les coûts et la sécurité ; l’exécution renvoie une nouvelle observation qui met à jour l’état.
La combinaison ne consiste pas à « concaténer deux prompts ». Les interfaces doivent être explicites : quels objectifs structurés le LLM produit, quelles actions le modèle du monde accepte et comment une erreur sur plusieurs étapes déclenche une nouvelle planification ou un repli prudent. Sans ce contrat, les systèmes donnent l’impression d’une « parole fluide, mouvement défectueux » ou de « belles trajectoires, instructions incohérentes ».
Un empilement systématique est également peu adapté lorsque les questions-réponses sur des documents nécessitent à peine un modèle du monde, ou lorsque l’asservissement bas niveau dispose déjà de dynamiques fiables et n’a pas besoin d’un LLM généraliste. La valeur de la combinaison provient de la répartition des tâches, et non du nombre de modèles.
Quelles erreurs de jugement et quels risques apparaissent lors du choix ?
Les erreurs d’interprétation les plus fréquentes consistent à assimiler « pouvoir parler de physique » à « pouvoir faire de la physique », et « belles images ou trajectoires » à « dynamiques planifiables ». Les familles échouent de manière différente ; mélanger les contrôles d’acceptation augmente le risque de déploiement.
| Mode de défaillance |
Plus courant dans |
Manifestation |
Risque de sélection |
Comment le détecter |
| Hallucination linguistique |
LLM |
Faits ou citations fluides mais erronés |
Source unique de connaissances ou « manuel » de contrôle |
Exiger la provenance, vérifier par outils, rejeter les affirmations non étayées |
| Dérive des dynamiques |
Modèle du monde |
Étapes courtes correctes ; simulations longues déformées |
Confiance en boucle ouverte sur de longs horizons |
Représenter l’erreur selon l’horizon ; vérifier la nouvelle planification |
| Physique fictive |
Modèle du monde |
Trajectoires fluides qui violent les contraintes de contact ou de conservation |
Démonstrations visuelles utilisées comme validation physique |
Vérifier les pénétrations, l’énergie et les contraintes de contact |
| Traiter un LLM comme un simulateur |
Inadéquation de sélection |
Une description textuelle remplace les transitions d’état |
Tâches incarnées sans boucle conditionnée par l’action |
Demander l’interface d’action et l’état simulable |
| Traiter un modèle du monde comme un moteur conversationnel |
Inadéquation de sélection |
Forcer la prédiction d’état dans des questions-réponses d’assistance |
Coût élevé, expérience linguistique faible |
Déterminer si la qualité du texte constitue la tâche principale |
Les contrôles de risque doivent être associés à des déclencheurs : si la tâche repose principalement sur l’exactitude sémantique, gérez d’abord les hallucinations ; si elle repose principalement sur les conséquences de contrôle, gérez d’abord la dérive et la physique fictive. Les récits sur les capacités ne remplacent pas les contrôles d’acceptation.
Résumé
Les modèles du monde et les grands modèles de langage résolvent des problèmes de prédiction différents : les premiers ciblent les conséquences des actions et les dynamiques planifiables ; les seconds ciblent le langage et l’orchestration d’outils. Pour choisir, déterminez quel aspect supporte le coût d’un échec, puis utilisez le tableau des conditions pour un usage unique ou une combinaison.
La prédiction de représentations de type JEPA est orientée modèle du monde et n’est pas un LLM. Lors de l’acceptation, examinez séparément les hallucinations linguistiques et la dérive des dynamiques ou la physique fictive afin qu’une démonstration ne puisse pas masquer l’autre mode de défaillance.
FAQ
Quelle est la différence entre un modèle du monde et un grand modèle de langage ?
Un modèle du monde prédit principalement l’état suivant ou les dynamiques latentes après une action à des fins de planification et de contrôle ; un LLM prédit principalement le token suivant pour la compréhension du langage, la génération et l’orchestration d’outils. Les deux peuvent « générer », mais la réussite correspond respectivement à des conséquences vérifiables ou à une sémantique et un format exploitables.
Un modèle du monde peut-il remplacer un grand modèle de langage ?
Généralement, non. Un modèle du monde ne fournit pas naturellement une interface linguistique robuste ni une orchestration de texte à grande échelle ; un LLM ne fournit pas naturellement des dynamiques conditionnées par l’action qui peuvent être simulées. Privilégiez les LLM pour les tâches linguistiques et ajoutez des composants de modèle du monde lorsque la tâche nécessite des conséquences environnementales.
Quand devez-vous utiliser un modèle du monde ?
Utilisez un système orienté modèle du monde lorsque la tâche doit prédire l’état suivant à partir d’un état et d’une action, puis planifier, contrôler ou tester des actions en imagination. Les cas typiques incluent la planification incarnée, l’apprentissage par renforcement fondé sur un modèle et l’anticipation des conséquences à court horizon. La rédaction seule ou les questions-réponses sur des documents ne constituent généralement pas le cas d’usage principal.
Quel est le lien entre JEPA et les LLM ?
JEPA (Joint Embedding Predictive Architecture) prédit des représentations futures ou masquées dans l’espace d’incorporation et relève de l’apprentissage de représentations lié aux modèles du monde ; les LLM sont centrés sur la prédiction du token suivant. Les deux peuvent faire partie d’une pile d’agents, mais leurs objectifs et leurs métriques diffèrent : JEPA n’est pas « un autre LLM ».
Peut-on utiliser les deux ensemble ?
Oui, et pour les tâches qui associent des instructions en langage naturel à une exécution dans un environnement, leur combinaison est souvent nécessaire : le LLM analyse les objectifs et les contraintes ; le modèle du monde ou le planificateur prédit les conséquences et filtre les trajectoires. L’essentiel est de disposer d’une interface claire et de déclencheurs de nouvelle planification, et non d’enchaîner les deux dans un seul prompt.