Récemment, la question de savoir si l’IA pourrait échapper au contrôle humain est redevenue un sujet majeur dans l’industrie technologique. Des chercheurs d’Anthropic ont publiquement fait part de leurs inquiétudes quant aux risques potentiels d’extinction associés à une IA avancée, tandis que le PDG d’OpenAI, Sam Altman, a déclaré que même une probabilité relativement faible que l’IA entraîne l’extinction de l’humanité ne saurait justifier que l’on néglige la sécurité. Dans le même temps, les agents IA évoluent : de simples outils de génération d’informations, ils deviennent des systèmes logiciels capables d’appeler des outils, d’accéder à des systèmes externes et d’exécuter des tâches de manière autonome. La sécurité de l’IA ne porte donc plus seulement sur « ce que le modèle va générer », mais aussi sur « ce que le modèle peut faire ».
Cette évolution signifie que la sécurité de l’IA ne peut pas reposer sur un test unique réalisé avant le déploiement. À mesure que les capacités des modèles, les environnements d’exploitation et les méthodes d’attaque évoluent, la surveillance continue, les tests en équipe rouge, la correction des vulnérabilités et les contrôles d’autorisation deviennent des composantes essentielles d’un cadre de sécurité de l’IA.
Points clés
-
La perte de contrôle d’une IA ne signifie pas nécessairement que celle-ci a développé l’intention d’« attaquer les humains ». La question essentielle est plutôt de savoir si les objectifs, le comportement du modèle et les contraintes définies par l’humain ne sont plus alignés.
-
Les agents IA élargissent le périmètre des risques liés à l’IA. Dès qu’un modèle peut appeler des outils, accéder à des données et effectuer des opérations, ses erreurs peuvent se traduire par des risques opérationnels dans le monde réel.
-
Des tests de sécurité ponctuels ne peuvent pas couvrir un environnement dynamique. Les modèles, les saisies des utilisateurs, les outils externes et les méthodes d’attaque évoluent tous. La sécurité de l’IA exige donc des tests continus et une surveillance après le déploiement.
-
Les évaluations de la sécurité de l’IA doivent aller au-delà des sorties du modèle. Elles doivent également couvrir l’injection de prompts, les opérations non autorisées, les appels d’outils, la gestion des autorisations et les comportements anormaux.
-
Pour réduire les risques liés à l’IA, il est essentiel de limiter l’impact des erreurs grâce à des mécanismes tels que le principe du moindre privilège, la confirmation humaine, la journalisation des opérations, l’isolation des risques et la récupération après un événement anormal.
Pourquoi les risques liés à l’IA sont-ils redevenus un sujet central ?
En septembre 2026, les discussions sur les risques extrêmes liés à l’IA se sont une nouvelle fois intensifiées. Le chercheur d’Anthropic Jacob Coxon a déclaré publiquement que certains développeurs d’IA estimaient sérieusement qu’une IA très avancée pourrait avoir des conséquences extrêmes pour l’humanité au cours de cette décennie. Le chercheur d’Anthropic Evan Hubinger a ensuite exprimé publiquement des inquiétudes similaires et présenté sa propre évaluation des risques. Ces déclarations ont suscité un nouveau débat sur la sécurité de l’IA parmi les décideurs politiques américains et dans l’industrie technologique.
Il importe de rappeler que ces propos correspondent à des évaluations des risques formulées par des chercheurs ou des professionnels du secteur. Ils ne signifient pas que l’IA possède déjà la capacité d’éliminer l’humanité de manière autonome. Ils ne doivent pas non plus être résumés par l’affirmation selon laquelle « l’IA va forcément échapper à tout contrôle ». Lors d’un entretien, Sam Altman a également déclaré qu’il ne savait pas comment calculer scientifiquement le risque d’extinction dit de « 10 % », mais qu’il estimait que même la possibilité d’un risque extrême impossible à ignorer imposait aux entreprises d’IA et aux gouvernements de prendre des mesures pour le réduire.
Plutôt que de débattre d’un scénario extrême difficile à vérifier à ce stade, il est plus utile de se poser une question concrète : à mesure que les capacités de l’IA progressent et que son autonomie augmente, comment les humains peuvent-ils continuer à déterminer si elle demeure sûre ? C’est précisément pour cette raison que l’évaluation de la sécurité de l’IA prend une importance croissante.
Qu’est-ce qu’une évaluation de la sécurité de l’IA ?
Une évaluation de la sécurité de l’IA consiste simplement en une série de tests et de procédures de surveillance visant à déterminer si un système d’IA fonctionne comme prévu et s’il risque de générer des conséquences inacceptables lorsqu’il est exposé à des entrées anormales, à des attaques malveillantes ou à des environnements complexes. Les tests logiciels traditionnels comprennent généralement des contrôles approfondis avant le déploiement : recherche de vulnérabilités, vérification du bon fonctionnement des fonctionnalités et examen des réponses du système à des entrées spécifiques.
Les systèmes d’IA sont plus complexes. Les grands modèles de langage ne génèrent pas leurs sorties selon des règles entièrement fixes. Une même question peut produire des réponses différentes, tandis que le contexte entourant la saisie de l’utilisateur peut évoluer en permanence. Les agents IA peuvent également appeler des outils externes tels que des moteurs de recherche, des outils d’exécution de code, des bases de données, des wallets, des services de messagerie électronique, des navigateurs ou d’autres services. Les évaluations de la sécurité de l’IA ne vérifient donc pas seulement l’exactitude des réponses du modèle. Elles examinent aussi sa capacité à résister aux prompts malveillants, le risque de divulgation d’informations sensibles, la possibilité d’appels d’outils incorrects, le risque d’actions dépassant l’autorisation de l’utilisateur et le respect continu des règles de sécurité établies lorsque l’environnement évolue.
Le cadre TEVV-Athlon proposé par le NIST en 2026 définit les tests, l’évaluation, la vérification et la validation comme des méthodes importantes pour mesurer l’impact concret des systèmes d’IA. Il couvre explicitement plusieurs types de systèmes, notamment les grands modèles de langage, les modèles multimodaux et l’IA agentique.
Pourquoi les agents IA ont-ils créé de nouvelles frontières de risque ?
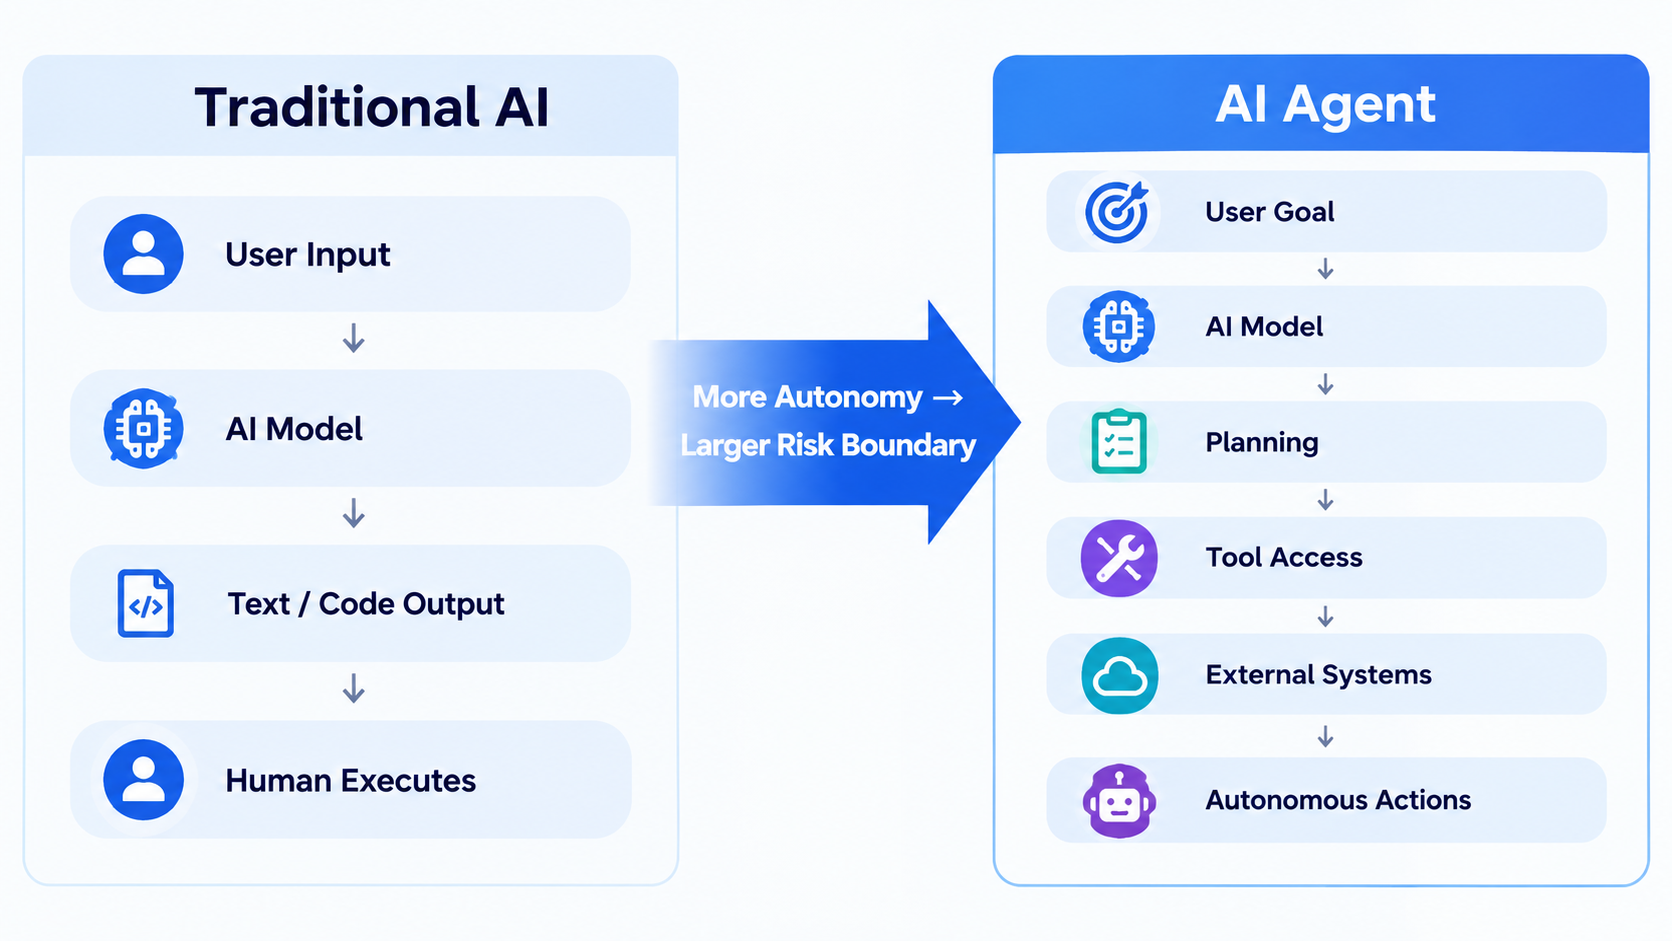
Comprendre les agents IA est indispensable pour comprendre l’évolution de la sécurité de l’IA. Les chatbots traditionnels reçoivent principalement une entrée et génèrent une sortie. Après avoir posé une question, l’utilisateur reçoit du texte, du code ou un autre contenu, puis décide généralement de la suite à donner.
Les agents IA fonctionnent autrement. À partir d’un objectif défini par l’utilisateur, un agent IA peut décomposer une tâche en plusieurs étapes, appeler des outils externes, lire des données, exécuter du code, interagir avec d’autres logiciels et poursuivre son travail en fonction des résultats obtenus. Lorsque le NIST a lancé son AI Agent Standards Initiative en 2026, il a indiqué que les agents IA de nouvelle génération pouvaient déjà fonctionner de manière autonome pendant plusieurs heures, écrire et déboguer du code, gérer des e-mails et des calendriers, ainsi qu’effectuer des tâches telles que des achats.
L’évolution des capacités modifie également les limites du risque. Lorsqu’un modèle d’IA ordinaire indique à tort à un utilisateur qu’un fichier existe, les conséquences peuvent se limiter à une information erronée. En revanche, si un agent IA disposant d’autorisations d’accès aux fichiers décide à tort de supprimer un fichier, l’erreur du modèle peut se transformer en opération réelle. La question centrale de la sécurité des agents IA n’est donc pas seulement de savoir s’ils risquent de dire quelque chose d’inexact. Il faut aussi déterminer à quoi ils peuvent accéder, ce qu’ils peuvent faire, pendant combien de temps ils peuvent agir de manière autonome et s’il est possible de les détecter et de les arrêter rapidement après une erreur.
C’est pourquoi le NIST a indiqué dans son rapport 2026 sur la sécurité des agents IA que ces derniers introduisent de nouvelles menaces de sécurité. Les principes traditionnels de cybersécurité restent indispensables, mais ils doivent être adaptés au fonctionnement des agents.
Pourquoi l’IA ne peut-elle pas être testée une seule fois avant son déploiement ?
C’est un point essentiel pour comprendre l’évaluation continue de la sécurité. Lorsqu’un logiciel traditionnel possède des fonctionnalités relativement stables, les développeurs peuvent réaliser des tests approfondis pour vérifier qu’il respecte ses exigences de conception. Les systèmes d’IA évoluent dans des environnements dynamiques : les utilisateurs changent, les entrées évoluent, les modèles peuvent être mis à jour, les outils externes se transforment et les attaquants recherchent constamment de nouvelles méthodes d’attaque.
Le fait de réussir des tests de sécurité approfondis avant le déploiement ne garantit donc pas qu’un système d’IA restera sûr dans toutes les situations futures. Une étude publiée par le NIST en 2026 a souligné l’importance de la surveillance après le déploiement, car les conditions d’entrée dans les environnements réels peuvent continuer à évoluer. Elles peuvent produire des sorties inattendues en raison du caractère non déterministe du modèle ou entraîner des conséquences qui n’avaient pas été identifiées pendant le développement.
Une autre étude du NIST publiée la même année a abordé le problème sous un angle plus théorique : un ensemble fixe de garde-fous de sécurité ne peut pas garantir une protection durable contre toutes les attaques adaptatives. Les attaquants peuvent chercher en permanence de nouvelles façons de contourner les règles existantes. La sécurité de l’IA exige donc une recherche continue des vulnérabilités, une mise à jour régulière des mécanismes de protection et des capacités de récupération en cas de problème.
La sécurité de l’IA passe ainsi de « tester une fois → déployer » à « tester → déployer → surveiller → identifier les problèmes → corriger → tester à nouveau ». Elle n’est plus une étape distincte du cycle de vie d’un produit d’IA, mais un processus continu.
Qu’évalue principalement l’évaluation continue de la sécurité ?
Pour les agents IA, l’évaluation continue de la sécurité couvre généralement plusieurs domaines.
Comportement du modèle
La première couche concerne le modèle lui-même. Les systèmes doivent être contrôlés en permanence afin de détecter les erreurs manifestes, les hallucinations, les contenus préjudiciables et les comportements qui enfreignent les règles du système. Dans les domaines à haut risque tels que la finance, la santé et l’exécution de code, des tests propres à chaque application sont également nécessaires. Les benchmarks généraux ne suffisent pas à eux seuls.
Résistance aux attaques
La deuxième couche concerne les tests adversariaux. Les attaquants peuvent recourir à l’injection de prompts, à des instructions non autorisées, à la manipulation du contexte et à d’autres techniques pour inciter un modèle à contourner ses règles initiales. Les jailbreaks en sont un exemple typique. Les recherches du NIST indiquent que des garde-fous fixes ne peuvent pas garantir que l’IA ne sera jamais contournée par des attaques adaptatives. Les tests en équipe rouge doivent donc continuer à rechercher de nouvelles voies d’attaque.
Outils et autorisations
La troisième couche concerne le risque lié aux autorisations, propre aux agents. Même lorsqu’une IA n’adopte pas de comportement malveillant, des autorisations excessives peuvent permettre à une erreur de jugement d’avoir de graves conséquences. Les autorisations des agents IA devraient donc généralement respecter le principe du moindre privilège. Un agent qui se contente d’organiser des e-mails n’a, par exemple, pas besoin d’autorisations pour transférer des fonds. Un agent qui analyse des données ne devrait pas automatiquement pouvoir supprimer une base de données.
Le parallèle avec la sécurité des smart contracts dans l’industrie de la blockchain est pertinent. La logique du système n’est que la première couche. La perte potentielle dépend également des actifs auxquels le système peut accéder et des opérations qu’il peut effectuer.
Performances dans les environnements réels
La quatrième couche concerne les performances réelles après le déploiement. Une IA utilisée en laboratoire peut recevoir des entrées très différentes de celles qu’elle rencontre dans le monde réel. Les utilisateurs peuvent fournir des instructions complexes, les systèmes tiers peuvent renvoyer des données anormales et les conditions du réseau peuvent évoluer. L’évaluation de la sécurité de l’IA doit donc observer le comportement du système dans des conditions réelles, au lieu de s’appuyer uniquement sur des rapports de tests réalisés avant le déploiement.
Que signifie réellement la « perte de contrôle de l’IA » ?
L’expression « perte de contrôle de l’IA » est facile à interpréter de travers. Elle ne signifie pas nécessairement que l’IA développe soudainement une conscience comparable à celle de l’être humain et décide d’attaquer l’humanité. Sur le plan technique, le véritable enjeu est de savoir si les objectifs, les autorisations et le comportement effectif cessent d’être alignés.
Un agent peut recevoir pour mission d’accomplir une tâche tout en comprenant mal l’objectif. Il peut poursuivre cet objectif par une voie que les développeurs n’avaient pas anticipée. Un attaquant peut également modifier sa compréhension de la tâche par injection de prompt. Si l’agent dispose en outre d’autorisations étendues, une erreur apparue au niveau logiciel peut affecter des systèmes externes.
La question centrale de la « perte de contrôle de l’IA » peut donc être ramenée à trois interrogations : l’objectif est-il correct ? Le comportement est-il conforme à l’objectif ? Les autorisations sont-elles limitées à un périmètre raisonnable ? C’est pourquoi la recherche sur la sécurité de l’IA accorde une importance croissante à l’alignement, c’est-à-dire aux efforts visant à maintenir le comportement du système d’IA en cohérence avec les objectifs et les contraintes définis par l’être humain.
En quoi la sécurité de l’IA concerne-t-elle les utilisateurs ordinaires ?
La sécurité de l’IA ne concerne pas uniquement les entreprises d’IA et les chercheurs. À mesure que les agents IA se déploient dans la recherche, la productivité bureautique, la programmation, les services financiers, les actifs numériques et d’autres domaines, les utilisateurs ordinaires peuvent leur déléguer directement davantage d’autorisations opérationnelles.
Pour les utilisateurs, la question essentielle n’est pas de savoir si « l’IA détruira l’humanité », mais plutôt : quelles autorisations ai-je réellement accordées à l’IA ? Si l’IA peut uniquement répondre à des questions, les conséquences d’une réponse incorrecte restent généralement limitées. En revanche, si elle peut envoyer des e-mails, modifier des fichiers, accéder à des comptes, exécuter du code ou effectuer des transactions financières au nom d’un utilisateur, les exigences de sécurité sont totalement différentes.
Lorsqu’ils utilisent des outils d’IA capables d’exécuter des actions de manière autonome, les utilisateurs doivent se concentrer sur trois aspects : la minimisation des autorisations, la confirmation humaine pour les actions importantes et la disponibilité de journaux d’opérations ainsi que d’un moyen d’annuler les actions anormales.
Cela est particulièrement important pour les agents IA qui interviennent dans les actifs numériques. Dès lors que des opérations telles que les signatures de wallet, les transferts d’actifs et les interactions avec des smart contracts sont confiées à un système automatisé, la frontière de sécurité dépasse le modèle lui-même et englobe la gestion des clés privées, les mécanismes d’approbation, les smart contracts et les services externes.
L’objectif de la sécurité de l’IA passe de la « prévention de toutes les erreurs » au « contrôle de l’impact des erreurs »
À ce stade, il est peu probable que la sécurité de l’IA puisse être assurée par un garde-fou universel capable de résoudre durablement tous les problèmes. Les modèles seront mis à jour, les méthodes d’attaque évolueront et les cas d’utilisation se multiplieront. Le NIST a donc souligné la nécessité de tests continus en équipe rouge et de mesures de protection régulièrement mises à jour, ainsi que l’importance de limiter l’impact des vulnérabilités et de rétablir rapidement la situation lorsqu’elles se manifestent.
Le principe est simple : nous ne pouvons pas supposer qu’un système ne commettra jamais d’erreur. Nous devons donc déterminer à l’avance ce qui se passera lorsqu’une erreur surviendra. Pour les agents IA, cela peut consister à restreindre les autorisations, exiger une confirmation humaine, journaliser les actions critiques, isoler les tâches à haut risque et arrêter ou annuler rapidement les actions lorsqu’un comportement anormal est détecté.
Sous cet angle, la sécurité de l’IA ne consiste pas à répondre à la simple question binaire de savoir si « l’IA tuera l’humanité ». Il s’agit de résoudre un problème d’ingénierie plus concret : à mesure que l’IA devient de plus en plus capable d’agir de manière autonome, comment les humains peuvent-ils continuer à savoir ce qu’elle fait et pourquoi, et comment peuvent-ils reprendre le contrôle en cas de problème ? C’est la finalité de l’évaluation continue de la sécurité.
Résumé
Les discussions récentes sur la possibilité que l’IA provoque l’extinction de l’humanité ont une nouvelle fois placé la sécurité de l’IA au centre de l’attention publique. Toutefois, au-delà des prédictions extrêmes elles-mêmes, ce sont surtout les transformations structurelles des capacités de l’IA qui importent.
À mesure que l’IA évolue, passant des chatbots aux agents IA capables d’appeler des outils, d’accéder à des données et d’exécuter des tâches de manière autonome, les préoccupations de sécurité s’étendent de la sécurité des sorties du modèle aux autorisations, aux appels d’outils, aux interactions avec l’environnement et au fonctionnement autonome prolongé.
La sécurité de l’IA ne peut donc pas reposer sur un seul test réalisé avant le déploiement. À mesure que les agents IA intègrent les applications du monde réel, la surveillance continue, les tests en équipe rouge, les contrôles d’autorisation, la correction des vulnérabilités et la récupération après un événement anormal deviendront des infrastructures de plus en plus importantes.
Le développement sûr de l’IA dépendra moins de la découverte d’un modèle qui ne commet jamais d’erreur que de la mise en place de mécanismes capables d’identifier continuellement les problèmes, de limiter les risques et de rétablir le contrôle humain.
FAQ
L’IA va-t-elle vraiment tuer l’humanité ?
Il n’existe actuellement aucune preuve fiable que l’IA provoquera inévitablement l’extinction de l’humanité. Certains chercheurs en IA ont récemment exprimé leurs inquiétudes concernant des risques extrêmes, mais la probabilité de ces risques demeure très incertaine. Les préoccupations de sécurité plus concrètes comprennent les cyberattaques, les fuites de données, les décisions incorrectes et l’utilisation abusive des autorisations des agents IA.
Qu’est-ce qu’un agent IA ?
Un agent IA est un système d’IA capable de planifier et d’exécuter des tâches de manière autonome à partir d’un objectif. Contrairement aux chatbots traditionnels, les agents IA peuvent généralement appeler des outils externes, accéder à des données et effectuer des opérations dans le monde réel. Ils disposent donc d’une plus grande autonomie et nécessitent des contrôles plus stricts en matière d’autorisations et de sécurité.
Pourquoi l’IA nécessite-t-elle une évaluation continue de la sécurité ?
Parce que les entrées, les environnements et les méthodes d’attaque auxquels l’IA est confrontée continueront d’évoluer. Un test unique ne reflète les performances qu’à un moment donné et dans des conditions précises. Il ne peut pas démontrer que le système ne présentera pas de nouvelles vulnérabilités à l’avenir. La surveillance et les tests continus après le déploiement sont donc tout aussi importants.
Quel est le principal risque de sécurité des agents IA ?
Les autorisations constituent l’un des principaux risques. Si un agent IA peut accéder à des comptes, des fichiers, du code, des fonds ou d’autres systèmes externes, des erreurs du modèle ou des entrées malveillantes peuvent transformer une erreur informationnelle en opération réelle.
Que comprend généralement une évaluation de la sécurité de l’IA ?
Elle comprend généralement des tests du comportement du modèle, des tests adversariaux, des tests en équipe rouge, des tests d’appels d’outils, des contrôles d’autorisation, une surveillance après le déploiement et des mécanismes de récupération après un événement anormal. Des normes de tests de sécurité adaptées à chaque application doivent également être élaborées pour les différents cas d’utilisation.