Dgrid AI est mieux adapté lorsque la priorité est une inférence IA routée et vérifiable ; Render et Akash sont davantage indiqués lorsque la priorité est de trouver une capacité GPU décentralisée pour le rendu ou des charges de travail générales. Tous trois s’inscrivent dans les narratifs crypto × IA / DePIN, mais ils proposent des couches différentes : une passerelle d’inférence accompagnée de preuves de qualité, d’un côté, et des marchés de calcul bruts ou adaptés à certaines charges de travail, de l’autre. Les lecteurs à visée éducative devraient également comparer les structures de frais, les hypothèses de conservation et le fait que le produit renvoie les résultats des modèles ou mette seulement des machines louées à disposition. Cette grille permet de comparer Dgrid AI, Render et Akash en fonction de la conception du workflow, plutôt qu’à partir du seul marketing des tickers.
Cette comparaison est proposée à des fins éducatives. Elle ne constitue pas un classement des tokens à des fins d’investissement. Pour une présentation de Dgrid AI, commencez par Qu’est-ce que Dgrid AI (DGAI) ?. Le fonctionnement du marché Spot de DGAI sur Gate est détaillé dans Comment trader DGAI en Spot sur Gate.
Points clés
-
Dgrid AI met l’accent sur l’agrégation de modèles, le routage intelligent et la Proof of Quality pour la fourniture de services d’inférence.
-
Render Network met l’accent sur une capacité GPU décentralisée, souvent associée au rendu et aux tâches de calcul connexes.
-
Akash Network met l’accent sur un marché ouvert du cloud computing, comprenant des instances GPU attribuées par le biais d’ordres d’achat et de fournisseurs.
-
Choisissez en fonction de la tâche à accomplir : un accès à une API d’inférence avec vérification ou la location de GPU distribués, et non en fonction du seul narratif du ticker.
Qu’est-ce que Dgrid AI ?
La comparaison entre Dgrid AI et Render dépend de la couche de produit examinée : Dgrid AI est un réseau décentralisé d’inférence IA fondé sur l’agrégation de modèles, le routage intelligent et une vérification de type Proof of Quality, tandis que Render est un réseau GPU décentralisé axé sur la mise en relation d’une capacité GPU distribuée pour le rendu et d’autres tâches de calcul. Pour les développeurs et les spécialistes de l’infrastructure qui comparent l’inférence IA décentralisée aux marchés GPU décentralisés, cette distinction modifie généralement la logique tarifaire, les hypothèses de confiance et de sécurité, ainsi que le workflow associé à la stack. En bref : privilégiez une approche de type Dgrid AI lorsque la tâche consiste à accéder à des modèles via une API, avec vérification et routage ; privilégiez une approche de type Render lorsque la tâche consiste principalement à disposer d’une capacité GPU brute plutôt qu’à utiliser une inférence vérifiée.
Dgrid AI agrège des modèles et route les demandes de services IA par l’intermédiaire d’une couche unifiée de marché intelligent et de planification. Les documents du projet décrivent l’accès à un vaste catalogue multi-modèles via un point d’entrée de type passerelle. Les documents publics décrivent également les connexions entre les fournisseurs de modèles, les opérateurs de nœuds et les développeurs, avec des objectifs de vérification on-chain. Le ticker du token natif est DGAI, avec un contrat BSC publié et référencé dans l’annonce de cotation de Gate.
Le produit vise à rendre l’accès à l’inférence moins coûteux et plus facile à auditer que dans le cadre d’une confiance aveugle envers une seule API centralisée, notamment grâce à des moyens plus clairs de payer l’accès à l’inférence ou son règlement. DGAI peut remplir des fonctions de règlement, d’incitation, de staking ou de dépôt de service conformément aux règles du réseau. Proof of Quality (PoQ) est le nom du mécanisme de référence utilisé pour évaluer et contester les résultats, afin de décourager économiquement les travaux de mauvaise qualité. Dans une comparaison entre Dgrid AI et Render, cette couche d’inférence et de vérification constitue le principal facteur de différenciation par rapport aux marchés de location de GPU lorsque la priorité est une inférence vérifiable plutôt qu’une capacité de calcul brute. Les solutions de calcul décentralisé adjacentes, comme Akash, doivent être intégrées au même ensemble de comparaison pour les workflows des développeurs, les modèles de confiance et les différences de rôle des tokens, mais ne doivent pas être considérées comme des substituts interchangeables.
Qu’est-ce que Render Network ?
Render Network est généralement présenté comme un réseau GPU décentralisé qui met en relation des artistes, des studios et d’autres acheteurs de puissance de calcul avec des opérateurs de GPU distribués pour des tâches de rendu et de la puissance de calcul à la demande. Les charges de travail ont historiquement mis l’accent sur le rendu et les pipelines graphiques associés, même si les discussions plus larges sur le calcul IA apparaissent souvent parallèlement aux narratifs DePIN. Les équipes qui ont besoin de nombreux GPU pour le rendu d’images, de GPU pour la génération de scènes ou de GPU pour des tâches graphiques par lots évaluent souvent Render comme une offre de capacité abordable plutôt que comme une passerelle d’inférence.
Le parcours utilisateur par défaut de Render consiste davantage à trouver de la puissance GPU pour une tâche qu’à sélectionner des points d’accès LLM routés bénéficiant d’une marque de preuve de qualité au niveau du réseau. Les détails relatifs au token et au règlement relèvent de la documentation propre à Render ; ici, Render sert uniquement de point de référence pour un marché du calcul à des fins de comparaison. Render convient lorsque l’objectif est de créer des images, des animations ou d’autres ressources fortement dépendantes des GPU, et que l’acheteur sait déjà quelle stack logicielle lancer sur ces GPU.
Qu’est-ce qu’Akash Network ?
Akash Network est généralement présenté comme une plateforme décentralisée et un marché mondial du cloud computing. Il s’agit d’un protocole de couche 1 fondé sur le Cosmos SDK, qui utilise un mécanisme de consensus Delegated Proof-of-Stake, une conception qui contribue à la sécurité et à la scalabilité lorsque la demande sur le réseau augmente. Les fournisseurs annoncent leur capacité et les locataires placent des ordres d’achat pour leurs charges de travail sur un marché pair à pair pouvant inclure des instances CPU et GPU. L’objectif est de fournir une infrastructure cloud sans permission. Akash a ainsi développé un marché cloud ouvert plutôt qu’une passerelle d’inférence dotée d’une marque unique. Les fournisseurs Akash peuvent proposer des GPU, des GPU supplémentaires pour les tâches ponctuelles et une capacité de nœud que les locataires utilisent pour lancer des conteneurs ou des images.
Le parcours par défaut d’Akash est plus proche de « louer du calcul et exécuter sa propre stack » que de « faire appel à un marché de modèles agrégés avec des contrôles PoQ ». Akash constitue donc un interlocuteur pertinent pour Render dans les discussions sur les DePIN GPU et un contrepoint clair au positionnement de Dgrid AI centré sur le routage de l’inférence. Sa technologie repose sur le déploiement d’une infrastructure cloud plutôt que sur une couche de points d’accès IA gérés, tout en mettant également l’accent sur le chiffrement et les Smart Contracts auditables pour la sécurité, avec AKT à l’appui des incitations de sécurité du réseau. Les outils open source et les manifestes communautaires jouent souvent un rôle dans le déploiement des locataires sur Akash. La plateforme permet également le déploiement anonyme d’applications, ce qui rend Akash intéressant lorsque l’équipe souhaite une approche abordable au niveau des nœuds plutôt qu’une API d’inférence hébergée. Akash prend également en charge des catégories de GPU haut de gamme telles que H100, H200 et A100 dans ses annonces de marché, les stocks disponibles et les tarifs horaires évoluant au fil du temps. Les lecteurs doivent donc vérifier les catalogues actuels des fournisseurs plutôt que de considérer un Snapshot donné comme définitif. Les conteneurs open source, les poids de modèles open source et les exemples d’orchestration open source conviennent bien aux locations de type Akash lorsque les acheteurs savent déjà comment lancer des charges de travail sur des GPU loués, notamment pour le déploiement de modèles IA avec AkashML et les clusters Ray.
Dgrid AI vs Render vs Akash : tableau comparatif
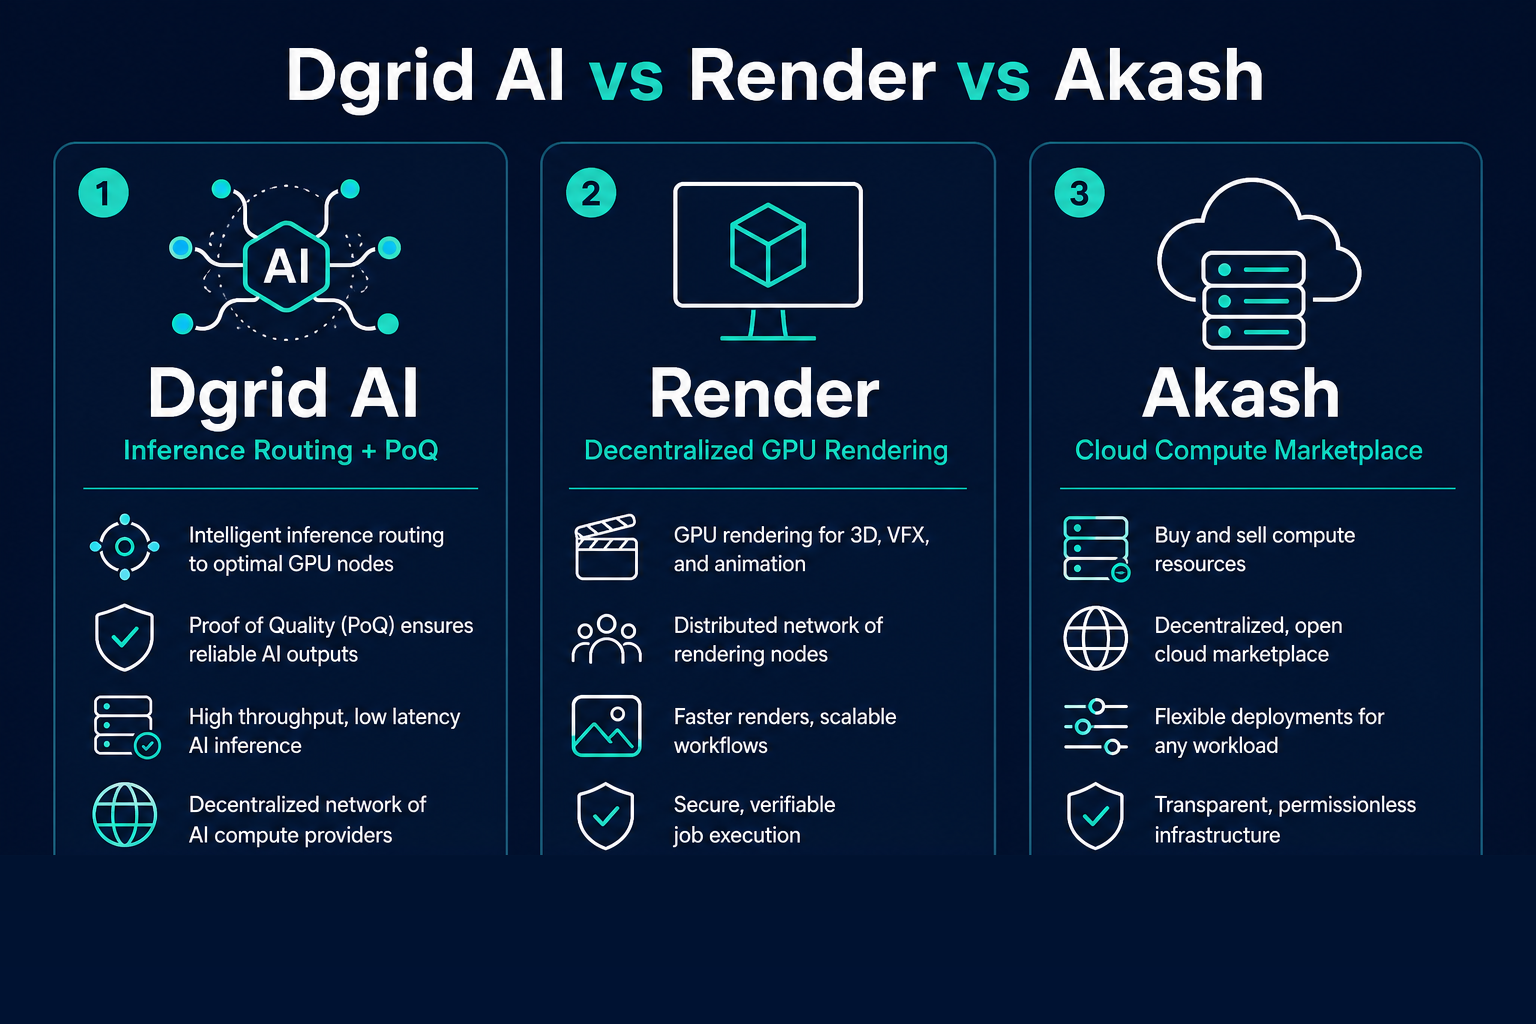
Figure 1. Dgrid AI vs Render vs Akash : routage de l’inférence et PoQ, par rapport au rendu GPU et aux marchés du cloud computing.
| Dimension |
Dgrid AI |
Render Network |
Akash Network |
| Positionnement principal |
Agrégation et routage décentralisés de l’inférence pour le déploiement et le raisonnement des modèles |
Calcul GPU / rendu décentralisé conçu pour prendre en charge des charges de travail plus importantes |
Marché ouvert du cloud computing |
| Confiance / qualité |
Proof of Quality (PoQ) pour les résultats |
Exécution des tâches et performances des fournisseurs sur le marché du calcul |
SLA des fournisseurs via les incitations et les locations du marché |
| Point d’entrée habituel pour les développeurs |
Demander une inférence via un marché / une passerelle agrégés |
Soumettre des tâches de rendu ou de calcul GPU au réseau |
Enchérir pour des instances, assurer la gestion et déployer sa stack |
| Analogue centralisé le plus proche |
Passerelle d’API IA multi-modèles |
Ferme de rendu / cloud GPU pour les ressources graphiques |
Marché cloud de type AWS sans permission |
| Actif natif (fréquemment cité) |
DGAI |
Narratifs liés au token de l’écosystème RNDR / Render |
AKT |
Les tableaux condensent le langage marketing ; vérifiez toujours la documentation à jour avant de construire.
Accès, outils pour développeurs et expérience développeur
Le parcours présenté par Dgrid AI ressemble davantage à « soumettre un prompt ou une demande d’inférence, recevoir une réponse de modèle routée et s’appuyer sur des signaux PoQ ». Cela correspond à la manière dont les développeurs envisagent déjà les API IA et permet d’intégrer Dgrid AI à un workflow de type API, avec l’ajout d’étapes de règlement crypto et de vérification.
Le parcours présenté par Render ressemble davantage à « préparer une tâche de rendu ou de calcul GPU, être mis en relation avec des fournisseurs et récupérer le résultat final ». Celui d’Akash ressemble davantage à « sélectionner des ressources par le biais d’ordres d’achat sur le marché, déployer des conteneurs ou des images et mettre soi-même en œuvre la charge de travail ».
Aucun des deux marchés du calcul ne fournit automatiquement le cadre PoQ de Dgrid AI. À l’inverse, Dgrid AI ne remplace pas le besoin de GPU bruts lorsqu’une équipe souhaite affiner des modèles ou exécuter des clusters d’entraînement privés pour l’apprentissage automatique. Les équipes combinent souvent plusieurs couches : elles louent des GPU sur des réseaux de type Akash ou Render pour des charges de travail personnalisées, puis consomment ailleurs une inférence routée. Des comparaisons telles que io.net vs Akash vs Render Network cherchent à déterminer quelle plateforme décentralisée fournit réellement des GPU de manière fiable ; la comparaison Dgrid AI vs Render cherche plutôt à déterminer si vous avez besoin de services d’inférence appelables, vérifiables et réglés, ou d’une offre de GPU et d’heures de nœud. Une bonne approche consiste à définir clairement la tâche avant de comparer le nombre de GPU entre Akash et Render.
Vérification, Smart Contracts, incitations et modes de défaillance
Dgrid AI met en avant Proof of Quality : échantillonnage, évaluation de la qualité et processus de vérification avec pénalités de staking en cas d’échec de la vérification. L’objectif est de rendre l’inférence auditable dans le cadre d’un service multi-nœuds. Certaines analyses approfondies publiques décrivent l’infrastructure IA décentralisée comme permettant de fournir des services appelables, vérifiables et réglés. Cette formulation correspond davantage à l’approche déclarée de Dgrid AI qu’à un pur marché de GPU.
Render et Akash s’appuient sur les incitations du marché, les performances et la sécurité : les fournisseurs qui échouent dans l’exécution des tâches, se déconnectent ou offrent de mauvaises performances risquent de voir leur réputation et leur demande future diminuer. Ces mécanismes encadrent davantage la fourniture de calcul que la qualité sémantique d’une réponse de LLM. Si des GPU renvoient une image rendue ou terminent un traitement d’images par lots, la question de la « qualité » diffère de celle de savoir si une hallucination produite par un chatbot a été validée par un évaluateur PoQ. L’expression de type ISO Proof of Quality est parfois utilisée de manière générale pour désigner l’assurance des processus ; la marque PoQ de Dgrid AI concerne spécifiquement les contrôles des résultats d’inférence, et non le nombre de GPU proposés par un nœud.
Des risques communs subsistent : les Smart Contracts, la volatilité du marché des tokens, une documentation inégale et l’écart entre le langage de la feuille de route et les modules disponibles, ainsi que la confiance accordée à la vérification des données. Les tokens contrefaits et les sites de phishing constituent des risques opérationnels dans les trois narratifs.
Rôle des tokens et contexte du marché
DGAI est associé à des rôles du réseau Dgrid AI tels que les incitations, le règlement et le collatéral de vérification, et constitue une composante de son modèle économique déclaré, tel qu’il est décrit dans les communications du projet. Les tokens associés à Render et Akash sont liés à leurs marchés du calcul respectifs. Les plateformes de cotation et la liquidité relèvent de la structure du marché et de faits commerciaux lorsqu’ils sont datés et sourcés ; elles ne prouvent pas la supériorité d’un produit.
Gate propose DGAI sur le marché Spot DGAI/USDT, mais une cotation ou une liquidité négociable ne doit pas être confondue avec l’adoption du produit ou une base d’utilisateurs payants. Les utilisateurs qui comparent des actifs à des fins éducatives doivent tout de même vérifier séparément les contrats et les pages des produits.
Lequel choisir ?
Choisissez une conception de type Dgrid AI si votre besoin principal est de fournir ou de consommer une inférence IA par l’intermédiaire d’un marché agrégé et routable, avec des contrôles explicites de la qualité des résultats. Pour les décideurs, choisissez une capacité de type Render si votre besoin principal est d’effectuer des tâches GPU décentralisées souvent associées aux pipelines de rendu. Choisissez des locations de type Akash si votre besoin principal est d’enchérir pour des instances cloud ou GPU générales afin d’exécuter votre propre stack. Une bonne règle générale est qu’une offre de GPU abordable ne remplace pas une bonne approche du routage de l’inférence lorsque le produit doit fournir des réponses aux utilisateurs finaux plutôt que simplement mettre des machines à disposition. Les réseaux conçus pour le calcul et ceux conçus pour l’accès aux modèles doivent être évalués selon des grilles différentes.
De nombreuses notes de recherche regroupent ces projets sous les appellations « crypto IA » ou « DePIN ». L’adéquation du mécanisme compte davantage que les catégories narratives. Les développeurs peuvent également conserver des API ou des clouds centralisés pour les environnements de production sensibles à la latence, tout en utilisant des réseaux décentralisés lorsqu’ils apportent davantage de flexibilité ou de soutien opérationnel. Ces choix sont opérationnels et ne constituent pas des évaluations d’investissement.
Résumé
Dgrid AI, Render et Akash se recoupent dans les discussions sur l’infrastructure crypto, mais divergent au niveau des produits : routage d’inférence vérifiable, d’une part, et marchés décentralisés de GPU et de cloud computing, d’autre part. Les modes d’accès, la logique de vérification et les rôles des tokens découlent de cette distinction. Comparez-les en fonction de la tâche à accomplir : une inférence routée avec PoQ ou la location d’un calcul distribué. Considérez les marchés de tokens comme un risque distinct. Les listes d’« outils de calcul décentralisé les plus performants » mélangent souvent les marchés GPU et les passerelles d’inférence ; conserver Dgrid AI, Render et Akash sur des grilles d’évaluation distinctes permet d’éviter cette confusion.
FAQ
Quelle est la principale différence entre Dgrid AI et Render ?
Dgrid AI se concentre sur l’agrégation et le routage d’une inférence IA vérifiable. Render est généralement présenté comme un réseau GPU décentralisé destiné au rendu et aux tâches de calcul connexes. La différence pour l’utilisateur est donc l’accès à l’inférence, d’une part, et à une capacité GPU brute, d’autre part. Le premier repose sur une passerelle d’inférence offrant une visibilité plus claire sur le chemin de modèle appelé ; le second repose sur un marché de capacité GPU.
En quoi Akash diffère-t-il de Dgrid AI ?
Akash est un marché ouvert du calcul sur lequel les locataires enchérissent pour des ressources cloud, notamment des GPU, et exécutent leurs propres charges de travail, souvent à l’aide d’environnements préconfigurés pour des modèles tels que Stable Diffusion. De nombreux opérateurs considèrent Akash comme une infrastructure qu’ils configurent eux-mêmes. Dgrid AI met l’accent sur l’agrégation des modèles, le routage et la Proof of Quality des résultats d’inférence, plutôt que sur la location d’instances brutes.
Dgrid AI est-il un cloud GPU décentralisé ?
Pas au même sens qu’Akash ou Render. Le positionnement public de Dgrid AI est centré sur l’accès à l’inférence et la vérification des résultats, plutôt que sur le courtage d’une puissance GPU mondiale. Les réseaux DePIN GPU se concentrent sur la fourniture et la mise en relation de capacités de calcul.
Render ou Akash peuvent-ils remplacer une API de type ChatGPT ?
Ils peuvent fournir des GPU afin qu’une équipe héberge ses propres modèles, y compris dans le cadre de déploiements autogérés tels que des clusters distribués de type Ray. Cependant, ils ne fournissent pas automatiquement un marché d’inférence multi-modèles routé avec PoQ. L’expérience utilisateur de type API est plus proche de la conception déclarée de Dgrid AI, ou des API IA centralisées.
Quels risques s’appliquent à Dgrid AI, Render et Akash ?
Les risques liés aux Smart Contracts, l’évolution de l’utilité des tokens, l’inégalité de la documentation, la fiabilité des marchés ou des nœuds, les variables de gouvernance communautaire et la volatilité des marchés concernent les réseaux crypto de calcul et d’IA. Vérifiez toujours les contrats et la documentation officiels avant de transférer des fonds. Cette comparaison est proposée à des fins éducatives et ne constitue pas un conseil en investissement.