Le 3 novembre 2026, AMD a publié ses résultats financiers du troisième trimestre, avec un chiffre d’affaires trimestriel atteignant 13,377 milliards de dollars, en hausse de 45 % sur un an. Le chiffre d’affaires des centres de données a atteint 8,546 milliards de dollars, en hausse de 97 % sur un an. L’entreprise prévoit un chiffre d’affaires d’environ 17 milliards de dollars au quatrième trimestre et a souligné que les GPU Instinct, les CPU EPYC et les systèmes à l’échelle du rack Helios stimuleront conjointement la croissance de son activité de centres de données. Ces évolutions ont renforcé l’attention des investisseurs quant à la capacité d’AMD à capter une part plus importante du marché du calcul pour l’IA dominé par NVIDIA.
Toutefois, la concurrence dans les puces d’IA ne se résume pas à comparer les performances des produits de deux entreprises. La capacité mémoire des GPU, le débit d’inférence, la compatibilité logicielle, la mise en réseau, la consommation électrique et le coût total de possession peuvent tous influencer les décisions d’approvisionnement des grands fournisseurs de services cloud. Cet article analyse la dynamique concurrentielle entre AMD et NVIDIA à travers les caractéristiques techniques de l’inférence par IA, ainsi que les implications de ces évolutions pour le secteur des puces d’IA et les investisseurs liés aux actions américaines.
Points clés
-
La concurrence dans les puces d’IA s’étend de la puissance de calcul dédiée à l’entraînement à l’efficacité de l’inférence. À mesure que les applications fondées sur les grands modèles de langage se développent, les coûts de calcul, la vitesse de réponse et la consommation électrique lors de l’inférence deviennent des facteurs importants dans les achats des centres de données.
-
AMD développe son activité d’IA pour les centres de données. Au troisième trimestre 2026, le chiffre d’affaires d’AMD dans les centres de données a atteint environ 8,55 milliards de dollars, en hausse de 97 % sur un an, portant le chiffre d’affaires total de l’entreprise à un nouveau sommet.
-
L’avantage concurrentiel de NVIDIA va au-delà du matériel GPU. Son écosystème logiciel CUDA, ses technologies de mise en réseau, ses outils pour développeurs et ses systèmes intégrés en rack offrent de solides capacités d’intégration système pour les déploiements d’infrastructures d’IA à grande échelle.
-
AMD cherche à construire une alternative complète grâce aux GPU Instinct, à Helios et à ROCm. Son approche concurrentielle évolue progressivement des performances de puces individuelles vers les capacités de calcul au niveau du système et le coût total de possession.
-
La hausse de la demande d’inférence par IA ne signifie pas nécessairement que les actions AMD ou NVIDIA progresseront. Les investisseurs devraient également suivre les capacités de livraison des puces, les marges bénéficiaires, les dépenses d’investissement des clients et les valorisations de marché.
Qu’est-ce que l’inférence par IA ? En quoi diffère-t-elle de l’entraînement des modèles d’IA ?
L’inférence par IA désigne le processus de calcul par lequel un modèle d’intelligence artificielle entraîné génère des prédictions, du texte, des images ou d’autres résultats à partir d’une entrée utilisateur. Par exemple, lorsqu’un utilisateur pose une question à un assistant d’IA et que le modèle génère progressivement une réponse à partir de cette entrée, ce processus relève de l’inférence. Contrairement à l’entraînement, qui ajuste continuellement les paramètres du modèle, l’inférence standard utilise principalement les paramètres existants du modèle pour effectuer des calculs. Certains systèmes d’inférence peuvent toutefois également intégrer la récupération d’informations, des appels d’outils et des étapes de calcul supplémentaires.
L’entraînement et l’inférence par IA présentent des besoins très différents en ressources de calcul. L’entraînement de grands modèles nécessite généralement que de nombreux GPU fonctionnent ensemble pendant de longues périodes, ce qui impose des exigences élevées en matière de performances de calcul, de capacité mémoire et d’interconnexions à haut débit. L’inférence accorde davantage d’importance au temps de réponse aux requêtes, au nombre de tâches pouvant être traitées par unité de temps et au coût de calcul requis pour chaque requête. Pour les applications telles que le chat en temps réel et les assistants vocaux, les utilisateurs sont très sensibles à la latence de réponse. Pour les tâches de traitement par lots de textes ou d’analyse de données, le débit global et le coût peuvent être plus importants.
| Dimension de comparaison |
Entraînement de l’IA |
Inférence par IA |
| Objectif principal |
Apprendre et optimiser les paramètres du modèle |
Utiliser le modèle pour générer des résultats |
| Caractéristiques de calcul |
Calcul à grande échelle et de longue durée |
Traitement continu de requêtes à haute fréquence |
| Indicateurs clés |
Vitesse d’entraînement, efficacité de mise à l’échelle |
Latence, débit, coût unitaire |
| Exigences en mémoire |
Paramètres, gradients et états d’entraînement |
Poids du modèle, cache KV, etc. |
| Cas d’usage métier |
Développement de modèles fondamentaux |
Assistants d’IA, recherche, agents, applications d’entreprise |
À mesure que les applications d’IA se développent, les requêtes d’inférence peuvent continuer à augmenter. Par exemple, un modèle peut ne nécessiter qu’un nombre limité de cycles d’entraînement à grande échelle, mais servir des millions d’utilisateurs pendant une longue période après son déploiement. Cela ouvre la possibilité que les dépenses cumulées d’inférence deviennent une source majeure des coûts d’infrastructure d’IA. Toutefois, le ratio entre les dépenses d’entraînement et d’inférence varie considérablement selon les modèles et les applications. Il ne faut donc pas supposer que les coûts d’inférence dépasseront toujours les coûts d’entraînement.
Pourquoi l’inférence par IA devient-elle un enjeu de concurrence entre AMD et NVIDIA ?
Le marché de l’inférence par IA attire principalement l’attention parce que les modèles économiques de l’IA évoluent d’une concurrence sur les capacités des modèles vers une concurrence sur les coûts d’utilisation réels. Pour les fournisseurs de services cloud et les développeurs d’applications d’IA, la capacité d’un modèle à accomplir des tâches n’est qu’une exigence de base. Sa capacité à fournir continuellement des services à un grand nombre d’utilisateurs à un coût raisonnable détermine également si le produit peut être commercialisé. À mesure que le nombre d’utilisateurs et la fréquence des appels augmentent, même une légère réduction du coût par inférence peut avoir une incidence importante sur les dépenses d’exploitation globales.
Les charges de travail d’inférence ne sont pas identiques. Les conversations en temps réel exigent une faible latence, les modèles de raisonnement complexes peuvent devoir générer de longs processus de raisonnement, et les agents d’IA peuvent appeler des modèles, récupérer des données et exécuter des outils à plusieurs reprises dans le cadre d’une même tâche. Les différentes charges de travail ont des exigences distinctes en matière de précision de calcul, de capacité mémoire, de bande passante mémoire et d’interconnexions système. Cela crée un espace de concurrence entre différentes architectures matérielles et signifie qu’il est difficile de déterminer quelle puce présente un avantage à partir d’un seul indicateur de performance.
Pour AMD, l’importance du marché de l’inférence réside dans son potentiel d’augmentation de sa part de marché des GPU d’IA. Les grands fournisseurs de services cloud cherchent généralement à éviter une dépendance excessive à un fournisseur unique tout en maîtrisant les coûts d’approvisionnement matériel. Si AMD peut proposer une alternative compétitive en matière de performances, de prix, de compatibilité logicielle et de capacités de livraison, l’entreprise pourra participer à davantage de plans d’approvisionnement pour les centres de données. Toutefois, NVIDIA optimise également en continu ses produits d’inférence et ses plateformes logicielles. Une demande croissante d’inférence ne signifie donc pas nécessairement que la position concurrentielle de NVIDIA s’affaiblira.
Comment l’activité d’AMD dans les centres de données a-t-elle récemment évolué ?
Les résultats du troisième trimestre d’AMD, annoncés en novembre 2026, montrent que les centres de données sont devenus l’une des sources les plus importantes de croissance de l’entreprise. Le chiffre d’affaires total a atteint 13,377 milliards de dollars, en hausse de 45 % sur un an, tandis que le chiffre d’affaires des centres de données a atteint 8,546 milliards de dollars, en hausse de 97 % sur un an. Au cours de la même période, le bénéfice par action non conforme aux principes comptables généralement admis (non-GAAP) a atteint 2,09 dollars, en hausse de 74 % sur un an, reflétant la contribution de l’expansion des centres de données à la rentabilité globale.
Il convient de noter que l’activité d’AMD dans les centres de données comprend non seulement les GPU d’IA Instinct, mais aussi les CPU de serveur EPYC. Par conséquent, l’intégralité du chiffre d’affaires des centres de données ne doit pas être directement considérée comme du chiffre d’affaires provenant des puces d’inférence par IA. La croissance de l’entreprise est portée à la fois par la demande d’accélérateurs d’IA et par celle de capacités de calcul généralistes pour serveurs. Pour les investisseurs, déterminer si AMD accroît réellement sa part du marché des GPU d’IA nécessite d’observer davantage les expéditions de produits, les déploiements clients et la composition précise de l’activité.
AMD prévoit également un chiffre d’affaires total d’environ 17 milliards de dollars au quatrième trimestre 2026, poursuivant la croissance observée au troisième trimestre. L’entreprise fait aussi progresser les déploiements de systèmes à l’échelle du rack Helios et élargit sa coopération avec les principaux fournisseurs de services cloud et les entreprises d’IA. Ces évolutions indiquent qu’AMD cherche à passer du statut de fournisseur de puces à celui de fournisseur plus complet d’infrastructures d’IA. Toutefois, la capacité des revenus futurs à continuer de croître dépendra encore des achats des clients, des chaînes d’approvisionnement et de la compétitivité des produits.
Quelles sont les différences entre les GPU AMD Instinct et NVIDIA pour l’inférence par IA ?
Les GPU d’IA d’AMD et de NVIDIA peuvent tous deux prendre en charge les tâches d’entraînement et d’inférence de modèles, mais les entreprises diffèrent par leurs feuilles de route produits, leurs écosystèmes logiciels et leurs approches d’intégration système. La série Instinct d’AMD cible principalement le calcul haute performance et l’accélération de l’IA dans les centres de données, tandis que NVIDIA a construit un cadre de calcul d’IA plus complet à travers ses GPU pour centres de données, la plateforme logicielle CUDA et les technologies de mise en réseau associées.
Pour les tâches d’inférence, les performances théoriques de calcul d’un GPU ne constituent qu’un critère d’évaluation. Les modèles doivent accéder fréquemment aux poids et aux données intermédiaires, ce qui rend la capacité mémoire, la bande passante mémoire et la gestion du cache tout aussi importantes. Une capacité mémoire plus élevée aide à héberger les paramètres du modèle et le cache KV généré par un plus grand nombre de requêtes simultanées, tandis qu’une bande passante mémoire plus élevée peut réduire les goulots d’étranglement liés à l’accès aux données dans certaines tâches d’inférence. Toutefois, les avantages précis dépendent de la taille du modèle, de la précision de quantification, de la stratégie de traitement par lots et du niveau d’optimisation logicielle.
L’avantage de NVIDIA réside dans ses capacités de coordination matériel-logiciel. Outre les GPU, NVIDIA fournit CUDA, TensorRT-LLM, des frameworks de service d’inférence et des technologies d’interconnexion à haut débit, permettant aux développeurs de déployer des charges de travail d’IA autour d’une chaîne d’outils relativement mature. AMD, de son côté, améliore la compatibilité et les performances système grâce à ROCm, aux GPU Instinct et aux systèmes Helios, afin de réduire les coûts de migration pour les clients adoptant du matériel alternatif.
| Dimension de comparaison |
AMD |
NVIDIA |
| Accélérateurs d’IA |
Série Instinct |
Série de GPU pour centres de données |
| Écosystème logiciel |
ROCm |
CUDA |
| Solutions au niveau du système |
Helios |
Plateformes à l’échelle du rack telles que NVL |
| Principal axe concurrentiel |
Écosystème ouvert, coût et performances |
Maturité logicielle, intégration système |
| Axe d’optimisation de l’inférence |
Capacité mémoire, débit, adaptation logicielle |
Latence, débit, coordination matériel-logiciel |
| Principaux défis |
Compatibilité de l’écosystème et maturité des déploiements |
Coûts des systèmes et concentration des fournisseurs chez les clients |
Il est important de souligner que la comparaison ci-dessus reflète le positionnement des produits et des écosystèmes, plutôt qu’un classement universel des performances. Différents GPU peuvent afficher des performances très différentes selon les modèles, les niveaux de précision et les conditions de déploiement. L’efficacité réelle de l’inférence ne peut pas être déterminée uniquement à partir de la capacité mémoire ou des performances théoriques de calcul.
Pourquoi CUDA et ROCm influencent-ils le paysage concurrentiel des puces d’IA ?
CUDA est la plateforme de calcul parallèle développée de longue date par NVIDIA, tandis que ROCm est la plateforme logicielle d’AMD pour le calcul sur GPU et les charges de travail d’IA. Toutes deux fournissent des outils de développement, des bibliothèques de calcul et des environnements d’exécution permettant aux développeurs d’utiliser les GPU pour des tâches de calcul complexes. Pour les grandes entreprises d’IA, sélectionner des GPU ne se limite pas à l’approvisionnement en matériel. Cela concerne également la capacité du code des modèles existants, des frameworks d’entraînement, des moteurs d’inférence et des systèmes d’exploitation à fonctionner de manière fiable.
L’avantage concurrentiel de CUDA provient de son écosystème logiciel établi de longue date. De nombreux modèles d’IA et outils de développement sont déjà adaptés et optimisés pour les GPU NVIDIA. Les entreprises utilisant du matériel NVIDIA peuvent donc souvent réduire une partie du travail de migration et de débogage. En particulier dans les environnements de clusters à grande échelle, la stabilité logicielle, les outils d’analyse des performances et le support technique peuvent affecter directement l’utilisation des ressources de calcul.
AMD améliore l’expérience des développeurs et la prise en charge des principaux frameworks d’IA grâce à ROCm. Au troisième trimestre 2026, AMD a publié ROCm 10, renforçant davantage les outils de développement, les compilateurs, les bibliothèques de calcul et la prise en charge des modèles associés. Ces améliorations contribuent à élargir l’éventail d’applications des GPU AMD, mais la publication d’une nouvelle version ne signifie pas que toutes les applications CUDA peuvent être migrées vers ROCm sans modification.
D’un point de vue commercial, la compatibilité logicielle affecte le coût total de possession réel des GPU. Si une entreprise achète des accélérateurs moins chers, mais doit investir d’importantes ressources d’ingénierie pour réoptimiser ses modèles, les économies réalisées sur le matériel peuvent finalement être compensées par les coûts de développement. Par conséquent, la concurrence entre AMD et NVIDIA ne se joue pas uniquement au niveau des puces, mais également au sein des écosystèmes de développeurs, des frameworks d’inférence et de l’efficacité du déploiement des systèmes.
Comment AMD Helios modifie-t-il la concurrence au niveau des systèmes avec NVIDIA ?
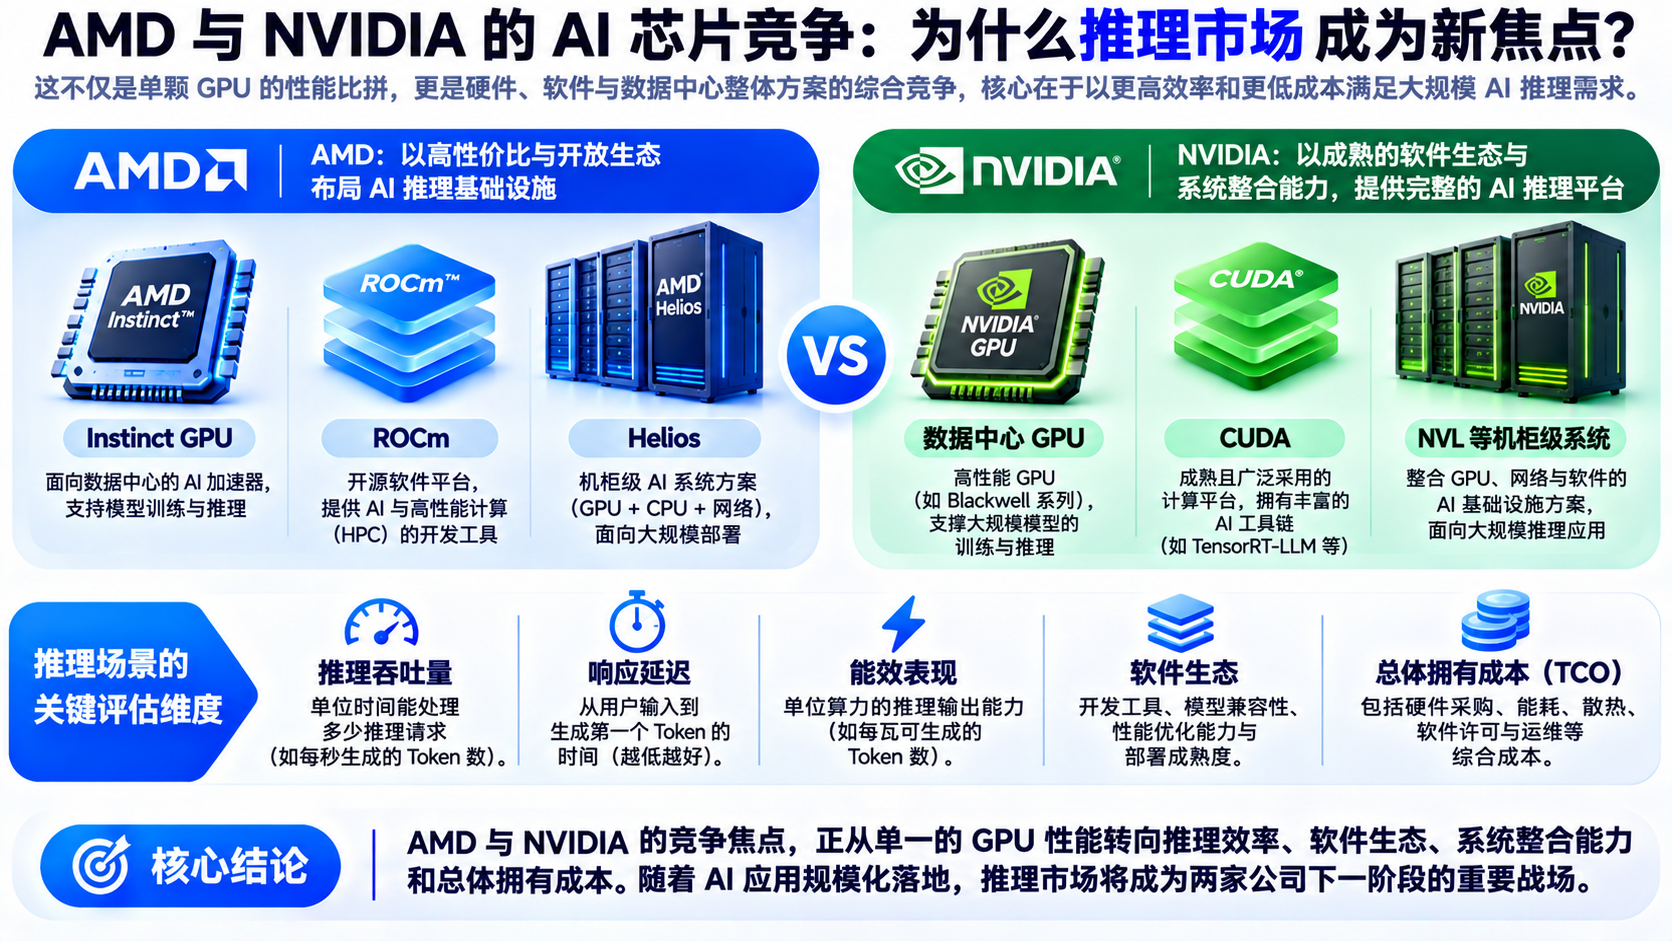
Helios est la plateforme de calcul à l’échelle du rack d’AMD destinée aux grands centres de données d’IA. Elle combine des GPU Instinct, des CPU EPYC, des interconnexions réseau et des composants logiciels associés afin d’offrir aux clients un système de calcul d’IA plus complet. Comparées à l’achat séparé de GPU suivi de l’intégration des systèmes, les solutions à l’échelle du rack peuvent optimiser la conception du calcul, des communications et du déploiement dans une architecture unifiée.
Cette évolution reflète l’élargissement de la concurrence dans les infrastructures d’IA, qui passe des puces individuelles aux systèmes de calcul complets. L’entraînement et l’inférence de grands modèles exigent généralement que plusieurs GPU fonctionnent ensemble. Les vitesses de transfert de données entre les GPU, les interconnexions au sein des serveurs, la topologie réseau et les capacités de refroidissement peuvent tous affecter l’efficacité globale. Même si une puce individuelle offre de hautes performances de calcul, le débit réel du cluster peut rester limité si la communication du système devient un goulot d’étranglement.
NVIDIA a déjà établi une gamme de produits relativement complète grâce à ses systèmes d’IA à l’échelle du rack, tandis qu’AMD vise à proposer une autre option avec Helios. Dans sa dernière annonce de résultats, AMD a indiqué que des clients tels qu’Anthropic, Meta, Microsoft, OpenAI et Oracle Cloud Infrastructure exécutent des modèles ou des charges de travail basés sur les premières solutions Helios. Ces déploiements indiquent qu’AMD fait progresser le lancement de produits au niveau du système, mais l’échelle de déploiement, le montant des achats et le stade de commercialisation de chaque client doivent encore être évalués séparément.
Pour les grands fournisseurs de services cloud, disposer de plusieurs fournisseurs compétitifs de systèmes d’IA peut accroître la flexibilité des achats et réduire le risque de concentration de la chaîne d’approvisionnement. Toutefois, la concurrence au niveau des systèmes impose également des exigences plus élevées à AMD, notamment concernant l’approvisionnement en puces, les interconnexions réseau, la stabilité logicielle, le déploiement en rack et la maintenance à long terme.
Pourquoi les coûts d’inférence par IA sont-ils plus importants que les performances individuelles des GPU ?
La valeur commerciale de l’inférence par IA dépend en définitive de la capacité à fournir continuellement des services à un coût acceptable. Pour les plateformes d’IA qui traitent un grand nombre de requêtes chaque jour, les prix d’achat des GPU ne représentent qu’une partie des coûts. L’utilisation des serveurs, la consommation électrique, le refroidissement, la mise en réseau, la maintenance et l’efficacité d’exécution des modèles peuvent tous influencer les dépenses totales.
Par exemple, supposons que deux systèmes de GPU aient des coûts d’approvisionnement respectifs de 1 million de dollars et de 1,2 million de dollars. Si le second peut traiter davantage de requêtes avec la même qualité de service ou réduire considérablement la consommation énergétique de chaque inférence, le système plus cher peut tout de même présenter un coût à long terme par inférence inférieur. À l’inverse, si un système affiche des performances théoriques élevées, mais que les applications réelles ne peuvent pas exploiter pleinement ses ressources matérielles, son intérêt économique peut être inférieur aux attentes.
Par conséquent, lors de l’évaluation des puces d’inférence par IA, il est important de prendre en compte des indicateurs tels que le nombre de tokens générés par seconde, le délai jusqu’au premier token, la capacité de requêtes simultanées et le coût réel de traitement par million de tokens. Les différents modèles et charges de travail accordent une importance différente à ces indicateurs. Par exemple, les interactions vocales en temps réel privilégient la latence, tandis que l’analyse de documents par lots peut davantage mettre l’accent sur le débit et le coût unitaire.
Cette évolution signifie qu’AMD n’a pas nécessairement besoin de surpasser NVIDIA sur chaque indicateur de performance pour saisir des opportunités de marché. Tant que ses produits peuvent offrir des coûts et des performances compétitifs pour des charges de travail spécifiques tout en répondant aux exigences des clients en matière de stabilité et de support logiciel, ils peuvent devenir des alternatives viables. De même, NVIDIA peut maintenir sa compétitivité grâce à l’optimisation logicielle et à l’efficacité des systèmes, plutôt qu’en s’appuyant uniquement sur des performances théoriques de puces plus élevées.
Comment la concurrence sur le marché de l’inférence par IA affectera-t-elle les valorisations boursières d’AMD et NVIDIA ?
AMD et NVIDIA sont toutes deux des entreprises cotées importantes du secteur américain des semi-conducteurs, mais les investisseurs n’appliquent pas exactement la même logique de valorisation aux deux entreprises. NVIDIA a déjà construit une activité de calcul d’IA à grande échelle ainsi qu’un écosystème matériel-logiciel relativement mature. Le marché se concentre généralement sur sa capacité à maintenir l’ampleur de ses revenus, ses marges bénéficiaires et ses avantages technologiques. AMD, de son côté, a l’opportunité d’accroître sa part du marché de l’IA. Les investisseurs s’intéressent donc davantage à la capacité des nouveaux déploiements de produits, des commandes clients et de la croissance des revenus à se traduire par une rentabilité durable.
L’expansion du marché de l’inférence par IA peut profiter simultanément à plusieurs fournisseurs de puces, mais une demande de marché croissante ne signifie pas que les bénéfices de chaque entreprise augmenteront proportionnellement. À mesure que la concurrence s’intensifie, les prix des produits, le pouvoir de négociation des clients et les investissements en recherche et développement peuvent tous évoluer. Si les entreprises réduisent leurs prix pour gagner des parts de marché ou doivent consacrer davantage de ressources au soutien des déploiements clients, la croissance des revenus peut ne pas entraîner le même niveau de croissance des bénéfices.
En outre, les cours des actions dépendent du niveau d’anticipation de croissance déjà intégré par le marché. Même si une entreprise publie de solides résultats financiers, le cours de son action peut rester sous pression si les investisseurs attendaient davantage. À l’inverse, si les livraisons réelles, les marges bénéficiaires ou les perspectives d’une entreprise dépassent les attentes, le marché peut réévaluer sa valorisation. Par conséquent, évaluer la valeur d’investissement d’AMD et de NVIDIA exige plus que de comparer quel GPU offre les meilleures performances. Cela nécessite également de prendre en compte la composition des revenus, la rentabilité, les dépenses d’investissement, l’environnement concurrentiel et les multiples de valorisation.
Quels indicateurs du marché de l’inférence par IA les investisseurs devraient-ils surveiller ?
Les investisseurs qui cherchent à comprendre les mouvements des actions liées aux puces d’IA peuvent observer les évolutions du marché sous trois angles. Le premier concerne la demande, notamment les dépenses d’investissement dans l’IA des grands fournisseurs de services cloud, l’utilisation des services d’inférence et les déploiements réels par les clients professionnels. Ces indicateurs peuvent aider à déterminer si la demande de puissance de calcul pour l’IA continue de s’étendre, mais les plans de dépenses d’investissement ne constituent pas des revenus confirmés pour les fabricants de puces.
Le deuxième concerne l’offre, notamment les volumes de livraison de GPU, l’approvisionnement en mémoire à haute bande passante (HBM), la capacité de packaging avancé et l’avancement des déploiements de systèmes. Même lorsque la demande du marché est forte, les fabricants de puces peuvent ne pas être en mesure d’effectuer les livraisons comme prévu si l’approvisionnement en composants essentiels est insuffisant. AMD et NVIDIA dépendent toutes deux de chaînes d’approvisionnement complexes dans les semi-conducteurs. Les contraintes d’approvisionnement peuvent donc affecter le rythme de croissance des deux entreprises.
Le dernier domaine concerne les indicateurs de rentabilité et de valorisation. Les investisseurs peuvent surveiller le chiffre d’affaires des centres de données, la marge brute, la marge opérationnelle, les flux de trésorerie disponibles et l’évolution des attentes du marché, puis utiliser les ratios cours/bénéfices ou les multiples de bénéfices prévisionnels pour évaluer si le prix des actions est raisonnable. Il est particulièrement important de distinguer les résultats financiers déjà réalisés des prévisions prospectives de la direction et d’éviter de considérer les commandes non exécutées ou les prévisions de croissance comme des revenus certains.
Résumé
La concurrence entre AMD et NVIDIA dans les puces d’IA s’étend d’une simple comparaison des performances de calcul à l’efficacité de l’inférence, aux écosystèmes logiciels, aux systèmes à l’échelle du rack et au coût total de possession. À mesure que les applications d’IA entrent dans une phase de déploiement à grande échelle, les centres de données ont besoin non seulement de capacités de calcul plus élevées, mais aussi de la capacité à traiter continuellement de grands volumes de requêtes utilisateurs à des coûts plus raisonnables.
La croissance rapide de l’activité d’AMD dans les centres de données au troisième trimestre 2026, ainsi que le développement continu d’Instinct, ROCm et Helios, indiquent que l’entreprise étend son activité d’infrastructure d’IA. Toutefois, NVIDIA conserve des avantages importants dans CUDA, l’intégration système et l’écosystème des développeurs. L’issue de la concurrence future dépendra des livraisons de produits, des performances en conditions réelles, de l’adoption par les clients et de la rentabilité commerciale, plutôt que d’un seul indicateur technique issu d’une génération de puces.
Pour les investisseurs en actions, le marché de l’inférence par IA offre une nouvelle perspective d’observation du secteur des semi-conducteurs, mais la compétitivité technologique et les rendements des investissements en actions ne sont pas directement équivalents. L’analyse conjointe de la demande du secteur, de la rentabilité des entreprises et des valorisations de marché permet de mieux comprendre le paysage concurrentiel entre AMD et NVIDIA.
FAQ
Qu’est-ce que l’inférence par IA ?
L’inférence par IA est le processus qui consiste à utiliser un modèle d’intelligence artificielle entraîné pour traiter des entrées et générer des résultats, notamment pour le chat par IA, la génération d’images, la reconnaissance vocale et les tâches effectuées par des assistants intelligents.
Pourquoi le marché de l’inférence par IA devient-il plus important ?
À mesure que le nombre d’utilisateurs d’applications d’IA et la fréquence d’utilisation augmentent, les entreprises doivent supporter continuellement des coûts de calcul d’inférence importants. Par conséquent, la vitesse d’inférence, le débit, la consommation électrique et les coûts unitaires deviennent plus importants.
Les GPU d’IA d’AMD peuvent-ils remplacer NVIDIA ?
Pour certains modèles et scénarios d’application pris en charge, les GPU AMD peuvent servir d’alternative à NVIDIA. Toutefois, la faisabilité réelle dépend de la compatibilité logicielle, des performances, des coûts de déploiement et des exigences des clients. Les deux ne doivent pas être considérés comme totalement équivalents dans tous les scénarios.
Quelle est la différence entre CUDA et ROCm ?
CUDA est la plateforme de calcul parallèle sur GPU de NVIDIA, tandis que ROCm est la plateforme logicielle de calcul sur GPU d’AMD. Toutes deux prennent en charge le calcul d’IA, mais elles diffèrent par leurs outils de développement, la maturité de leur écosystème et leur compatibilité spécifique.
Qu’est-ce qu’AMD Helios ?
Helios est la plateforme de calcul d’IA à l’échelle du rack d’AMD, qui intègre des GPU, des CPU, des interconnexions et des composants logiciels pour les charges de travail d’entraînement et d’inférence de l’IA dans les grands centres de données.
La hausse de la demande d’inférence par IA signifie-t-elle que les actions AMD augmenteront nécessairement ?
Pas nécessairement. Les cours des actions sont influencés non seulement par la croissance de l’activité, mais aussi par la rentabilité, le paysage concurrentiel, les chaînes d’approvisionnement, les attentes du marché et les valorisations boursières.